Google เปิดตัว Gemini 4 Hydrogen? เมื่อวันที่ 12 พฤศจิกายน 2026 Google DeepMind ได้เปิดตัว Gemini 4 Hydrogen อย่างเป็นทางการ โดยวางตำแหน่งโมเดลนี้ให้เป็นระบบที่มีความคุ้มค่าและมีปริมาณการประมวลผลสูง สำหรับงานวิศวกรรมซอฟต์แวร์ประจำวันและเวิร์กโฟลว์เอเจนต์แบบหลายขั้นตอน ตามรายละเอียดใน ประกาศอย่างเป็นทางการจาก Google DeepMind ในขณะที่ทีมพัฒนาซอฟต์แวร์หันมาใช้งานเอเจนต์อัตโนมัติเพื่อสำรวจคลังเก็บโค้ดและรันการทดสอบมากขึ้น การพึ่งพาโมเดลการให้เหตุผลระดับแนวหน้า (Frontier models) เพียงอย่างเดียวทำให้เกิดความหน่วงที่สังเกตเห็นได้และค่าใช้จ่ายด้าน API ที่สะสมเพิ่มขึ้น แม้ว่าการให้เหตุผลเชิงสถาปัตยกรรมลึกจะยังคงเป็นสิ่งสำคัญสำหรับการออกแบบระบบที่ซับซ้อน แต่งานวิศวกรรมประจำวัน เช่น การเขียนการแก้ไขแบบเฉพาะจุด การรันชุดทดสอบ และการแยกวิเคราะห์บันทึกการคอมไพล์ กลับต้องการการทำงานที่รวดเร็ว Hydrogen จึงถูกออกแบบมาให้ทำหน้าที่เป็นทั้งเครื่องมือเดี่ยวสำหรับการพัฒนาที่มีปริมาณมาก และเป็นเอนจิ้นการทำงานที่จับคู่กับโมเดลระดับแนวหน้าในไปป์ไลน์การกำหนดเส้นทางแบบหลายโมเดล (Multi-model routing)
การปรับทิศทางครั้งสำคัญของอุตสาหกรรม: Google เปิดตัว Gemini 4 Hydrogen สำหรับเวิร์กโฟลว์ปริมาณงานสูง
สรุปสั้นๆ
- Google DeepMind เปิดตัว Gemini 4 Hydrogen เป็นโมเดลที่มีปริมาณงานสูง ออกแบบมาเพื่อจัดการกับการเขียนโค้ดประจำวัน การตอบคำถามในคลังโค้ด และเวิร์กโฟลว์เอเจนต์ ด้วยความหน่วงที่ต่ำกว่าระดับแนวหน้า
- โมเดลทำงานภายในหน้าต่างบริบท (Context window) แบบรวมขนาด 1,048,576 โทเค็นที่แชร์ร่วมกันระหว่างอินพุตและเอาต์พุต โดยมีราคาอยู่ที่ $1.50 ต่อหนึ่งล้านโทเค็นอินพุต และ $7.50 ต่อหนึ่งล้านโทเค็นเอาต์พุต
- ความพร้อมในการใช้งานครอบคลุม Google AI Studio, Gemini API, Android Studio, Google Search และแพลตฟอร์มสำหรับองค์กร โดยระดับการเข้าถึงจะแตกต่างกันไปตามแผนการใช้งานฟรีสำหรับผู้บริโภคและพื้นที่ทำงานสำหรับนักพัฒนาแบบชำระเงิน
ความต้องการเชิงปฏิบัติการของเวิร์กโฟลว์วิศวกรรมซอฟต์แวร์ได้พัฒนาไปไกลกว่าการเติมเต็มโค้ดด้วยพรอมต์เดียวแล้ว ตั้งค่าเอเจนต์สมัยใหม่มักจะทริกเกอร์ขั้นตอนอัตโนมัติหลายสิบขั้นตอน ซึ่งรวมถึงการอ่านโครงสร้างไดเรกทอรี การตรวจสอบแผนผังการพึ่งพา การเสนอแพตช์ และการรันการทดสอบรีเกรสชัน เมื่อนักพัฒนาส่งทุกการดำเนินการประจำผ่านโมเดลการให้เหตุผลระดับแนวหน้า การทำงานจะช้าลงอย่างเห็นได้ชัด ในสภาพแวดล้อมแบบวนซ้ำ แม้แต่ความหน่วงระดับปานกลางในการเรียกใช้เครื่องมือแต่ละครั้งก็สามารถสะสมกลายเป็นความล่าช้าในรอบการพัฒนาอัตโนมัติได้
การอภิปรายในอุตสาหกรรมเกี่ยวกับการเปิดตัวครั้งนี้สะท้อนให้เห็นถึงการยอมรับที่เพิ่มขึ้นว่าความเชี่ยวชาญเฉพาะด้านของโมเดลเป็นสิ่งสำคัญสำหรับการปรับขนาดในระดับการผลิต แทนที่จะปฏิบัติกับโมเดลอเนกประสงค์ตัวเดียวว่าเป็นตัวเลือกเริ่มต้นสำหรับทุกงานพัฒนา ทีมงานกำลังประเมินสถาปัตยกรรมแบบแบ่งชั้น ในการกำหนดค่าเหล่านี้ โมเดลการให้เหตุผลที่มีความจุสูงจะจัดการการออกแบบระบบและการกำหนดกรอบปัญหาที่คลุมเครือ ในขณะที่โมเดลการทำงานเฉพาะทางจะจัดการกับการดำเนินการซ้ำๆ ในคลังโค้ด Google ออกแบบ Hydrogen มาเพื่อตอบสนองระดับการปฏิบัตินี้ โดยให้บริการนักพัฒนาได้ทันทีผ่านจุดสิ้นสุด API มาตรฐานและสภาพแวดล้อมแบบโปรแกรม
การวิเคราะห์เบนช์มาร์กและขอบเขตทางเทคนิคของ Gemini 4 Hydrogen
Google อธิบายว่า Hydrogen ได้รับการปรับแต่งมาจาก Gemini 4 Carbon อย่างไรก็ตาม เอกสารทางเปิดเผยทางเทคนิคไม่ได้เปิดเผยรายละเอียดภายในเฉพาะเจาะจงเกี่ยวกับกลไกการถ่ายโอนน้ำหนัก สถาปัตยกรรมโทเค็นไนเซอร์ หรือไปป์ไลน์การกลั่น ดังนั้น การประเมินทางเทคนิคจึงต้องมุ่งเน้นไปที่ข้อมูลเบนช์มาร์กที่สังเกตได้ ขอบเขตบริบทที่มีเอกสารประกอบ และข้อจำกัดในการดำเนินงานที่มีการรายงาน แทนที่จะอนุมานกลไกภายใน
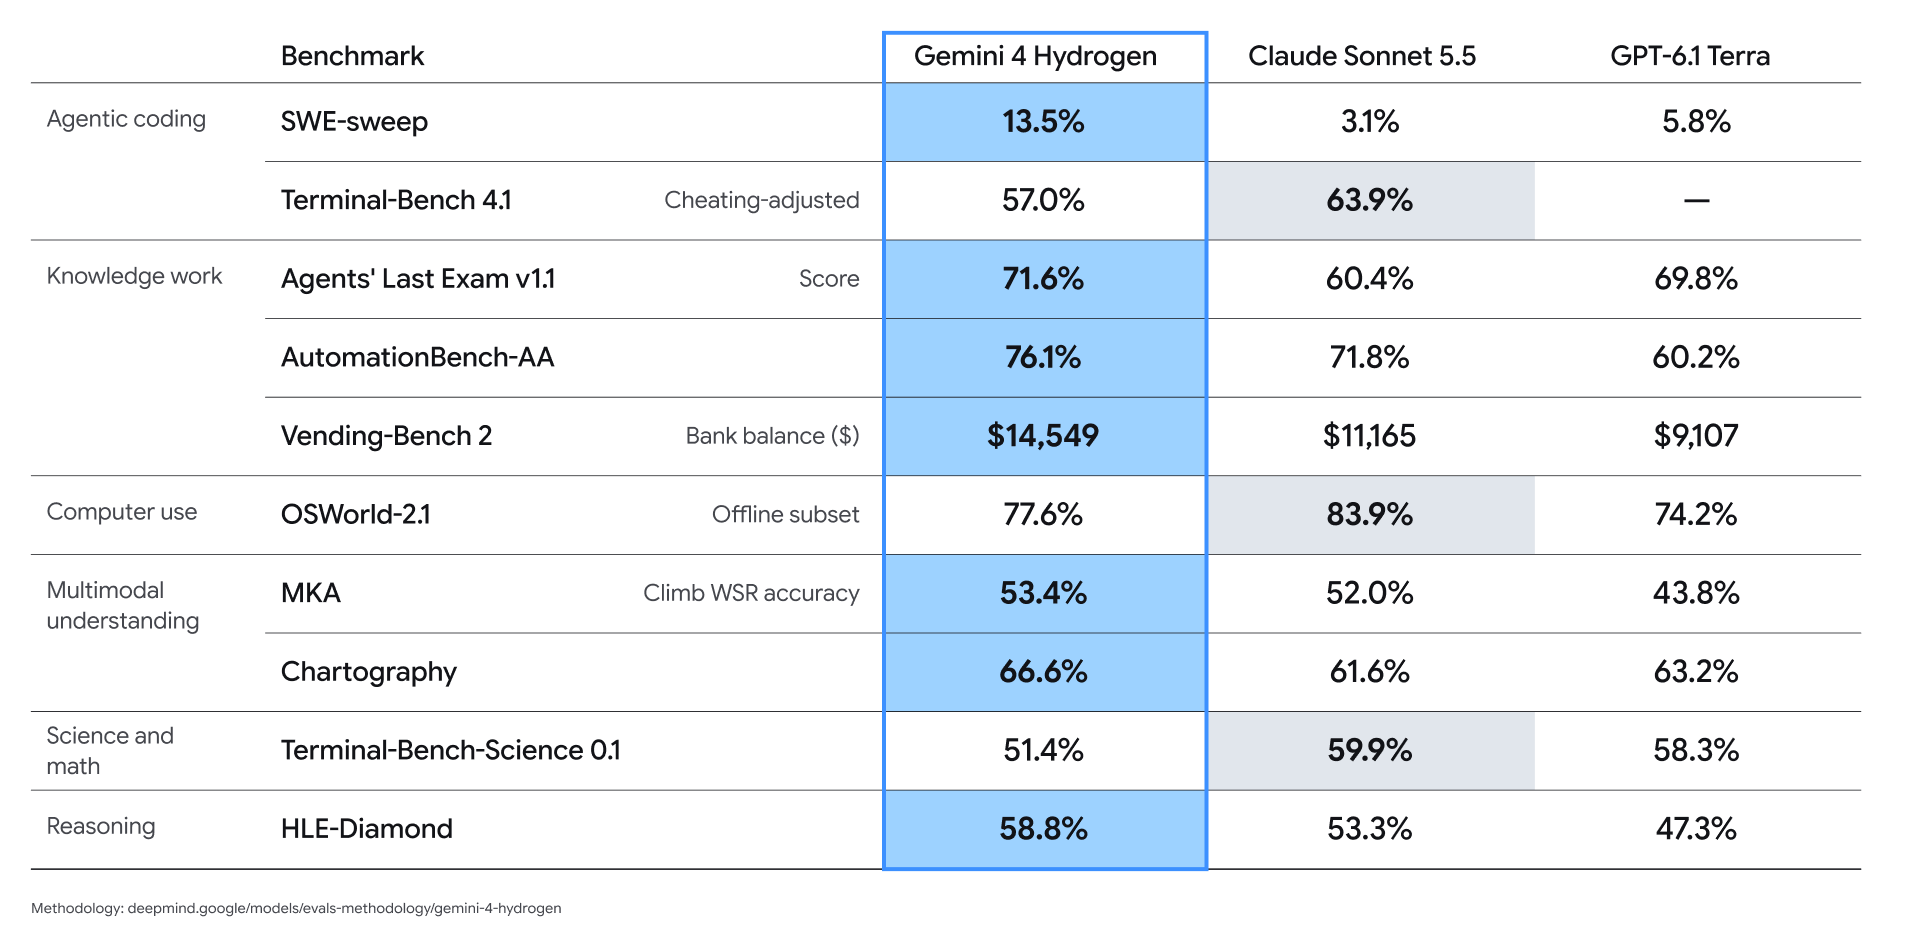
ในการประเมินมาตรฐานที่รายงานใน การ์ดโมเดล Gemini 4 Hydrogen, Hydrogen แสดงให้เห็นถึงความแตกต่างด้านประสิทธิภาพอย่างชัดเจนในแต่ละประเภทงาน บนเบนช์มาร์ก SWE-sweep สำหรับการแก้ปัญหา Google รายงานอัตราการแก้ปัญหาที่ 13.5% สำหรับ Hydrogen เทียบกับ 3.1% สำหรับ Claude Sonnet 5.5 และ 5.8% สำหรับ GPT-6.1 Terra ภายใต้เงื่อนไขการประเมินที่กำหนด ในทางตรงกันข้าม บน Terminal-Bench 4.1 ภายใต้พารามิเตอร์ที่ปรับการโกง Hydrogen ทำคะแนนได้ 57.0% ซึ่งปรับปรุงขึ้นอย่างมากจาก Gemini 3.8 Flash (18.2%) แต่ตามหลัง Claude Sonnet 5.5 ที่บันทึกไว้ที่ 63.9% บนดัชนีสติปัญญาอิสระ Artificial Analysis, Hydrogen ทำคะแนนได้ 51 ในการตั้งค่าการคิดระดับสูงเริ่มต้น และ 54 ในการตั้งค่า xhigh เทียบกับ 50 สำหรับโมเดลเรือธง Gemini 4 Argon
ข้อพิจารณาด้านสถาปัตยกรรมที่สำคัญคือความจุบริบทของโมเดล ตามที่ระบุไว้ใน เอกสารประกอบโมเดล Google Cloud Hydrogen มีขีดจำกัดบริบทแบบรวมที่ 1,048,576 โทเค็น ซึ่งแชร์ร่วมกันในอินพุตและเอาต์พุตทั้งหมด ซึ่งหมายความว่าไฟล์อินพุตที่มีขนาดใหญ่จะลดความจุโทเค็นที่เหลืออยู่สำหรับเอาต์พุตของโมเดล ส่วนหน้า (Foreground segment) เดี่ยวรองรับโทเค็นเอาต์พุตสูงสุด 65,536 โทเค็น การสร้างที่ยาวขึ้นจะใช้กลไกการต่อเนื่องที่รองรับ ซึ่งรวมถึงการต่อเนื่องที่จัดการโดย SDK, ลูปโทเค็นการต่อเนื่องแบบกำหนดเอง หรือการดำเนินการเบื้องหลังที่จัดการโดยเซิร์ฟเวอร์ตามความเหมาะสม ส่วนทั้งหมดจะยังคงอยู่ภายใต้ขีดจำกัดบริบทที่ใช้ร่วมกัน โทเค็นเอาต์พุตประกอบด้วยโทเค็นการให้เหตุผลภายใน คำขอเครื่องมือที่สร้างขึ้น และข้อความที่มองเห็นได้
[สถาปัตยกรรมตัวประสานงานหลายโมเดลใน Google Antigravity]
                         ┌────────────────────────┐
                         │  Gemini 4 Carbon/Argon │ (การวางแผนสถาปัตยกรรมและการให้เหตุผลที่ซับซ้อน)
                         └───────────┬────────────┘
                                     │ การมอบหมายงานและการตรวจสอบแผน
                                     ▼
                         ┌────────────────────────┐
                         │   Gemini 4 Hydrogen    │ (การสร้างโค้ดแบบขนานและการเรียกใช้เครื่องมือ)
                         └───────────┬────────────┘
                                     │ การเรียกใช้เครื่องมือที่มีโครงสร้าง
                                     ▼
                [ รันไทม์ภายในเครื่อง / ชุดทดสอบ / ระบบไฟล์ ]
เพื่อสร้างความสมดุลระหว่างความหน่วงและความลึกในการวิเคราะห์ Hydrogen จึงรวมระดับการให้เหตุผลที่กำหนดค่าได้สี่ระดับ ได้แก่ ต่ำ (low), ปานกลาง (medium), สูง (high - ค่าเริ่มต้น) และสูงมาก (xhigh) การตั้งค่าที่ต่ำกว่าจะช่วยลดความหน่วงของการตอบสนองสำหรับการปรับเปลี่ยนไวยากรณ์อย่างง่าย ในขณะที่ระดับที่สูงขึ้นจะจัดสรรโทเค็นการให้เหตุผลภายในมากขึ้นเพื่อประเมินกรณีมุม (Edge cases) นักพัฒนาควรทราบว่าข้อจำกัดที่มีเอกสารกำกับยังคงอยู่: โมเดลมีจุดตัดของความรู้ถึงเดือนมีนาคม 2026 อาจประสบปัญหาหมดเวลาเป็นครั้งคราวระหว่างการประมวลผลเบื้องหลังหนักๆ และอาจสร้างภาพหลอน (Hallucinations) หรือปฏิเสธมากเกินไปต่อพรอมต์ที่คลุมเครือ
ระบบที่แยกออกจากกันและข้อแลกเปลี่ยนในการประสานงานหลายโมเดล
การประสานงานแบบหลายโมเดลช่วยให้แพลตฟอร์มการพัฒนาสามารถแบ่งเวิร์กโฟลว์ทางวิศวกรรมออกเป็นระดับโมเดลที่แตกต่างกัน ในรูปแบบนี้ การสร้างแบบจำลองระบบที่ซับซ้อนและการประเมินความปลอดภัยจะถูกมอบหมายให้กับโมเดลการให้เหตุผลระดับแนวหน้า ในขณะที่การแก้ไขโค้ดที่เป็นรูปธรรมและการยืนยันการทดสอบจะถูกกำหนดให้กับโมเดลการทำงานที่รวดเร็ว
Google ได้ประเมินแนวทางนี้โดยใช้ตัวประสานงานทดลองใน Google Antigravity ในการทดสอบบน Terminal-Bench 4.0, Google รายงานว่าการสลับแบบไดนามิกไประหว่าง Carbon และ Hydrogen ทำให้อัตราความสำเร็จของงานใกล้เคียงกับ Carbon ในขณะที่ใช้โควตาน้อยลง 24% และทำงานเสร็จเร็วกว่าการรัน Carbon เพียงอย่างเดียว 19% นอกจากนี้ Google ยังรายงานการทดสอบเบื้องต้นกับพาร์ทเนอร์ซึ่งแสดงให้เห็นการทำงานที่เร็วขึ้น 2×–2.8× และการใช้โทเค็นน้อยลง 12%–23% เมื่อเทียบกับ Gemini 3.8 Flash ในเวิร์กโฟลว์ที่เลือก ตัวอย่างเช่น Box รายงานว่าการทำงานเร็วขึ้นประมาณ 2× และใช้โทเค็นน้อยลง 12% ในงานเอกสารและตารางที่ซับซ้อน ตัวอย่างที่รายงานโดยผู้จำหน่ายเหล่านี้สะท้อนถึงการตั้งค่าการผสานรวมเฉพาะและไม่ได้เป็นตัวแทนของการประมาณการประหยัดที่มีการควบคุมในทุกการปรับใช้จริง
| คอมโพเนนต์ของระบบ | เครื่องมือที่เป็นตัวแทน | ความรับผิดชอบที่กำหนด | ขอบเขตการทำงานและข้อจำกัด |
|---|---|---|---|
| ตัวประสานงานระบบ (System Coordinator) | Gemini 4 Carbon / Argon | การออกแบบสถาปัตยกรรมระดับสูง, การวางแผนข้ามคลังเก็บโค้ด, การประเมินตรรกะที่ซับซ้อน | ความจุในการให้เหตุผลสูง; มีต้นทุนต่อโทเค็นสูงกว่าและมีความหน่วงในการสร้างนานกว่า |
| เอนจิ้นการดำเนินการ (Execution Engine) | Gemini 4 Hydrogen | การสร้างโค้ดเฉพาะจุด, การแก้ไขไฟล์อัตโนมัติ, ลูปการเรียกใช้เครื่องมืออย่างรวดเร็ว | ปริมาณการสร้างสูง; สามารถทำงานแบบเดี่ยวหรือภายใต้ตัวประสานงานได้ |
| เกตการตรวจสอบ (Verification Gate) | ชุดทดสอบย่อย / ตัวตรวจสอบโค้ดคงที่ (Static Linters) | การตรวจสอบกฎแบบกำหนด, การตรวจสอบความถูกต้องของไวยากรณ์, การทดสอบรีเกรสชัน | ตรวจสอบการยืนยันและกฎคงที่ที่กำหนด; การรับประกันขึ้นอยู่กับคุณภาพการทดสอบ ความครอบคลุม และการตรวจสอบอิสระ |
การประเมินสถาปัตยกรรมแบบหลายโมเดลกำหนดให้ทีมวิศวกรรมต้องสร้างความสมดุลระหว่างความซับซ้อนของระบบกับประสิทธิภาพการดำเนินการ แม้ว่าการกำหนดเส้นทางโมเดลแบบไดนามิกจะช่วยลดค่าใช้จ่ายด้านโทเค็นในงานที่ทำซ้ำๆ ได้ แต่มันก็เพิ่มภาระการประสานงาน ความท้าทายในการซิงโครไนซ์สถานะข้ามเอเจนต์ย่อย และการพึ่งพาตัวจำแนกการกำหนดเส้นทาง ทีมวิศวกรรมต้องวัดข้อแลกเปลี่ยนเหล่านี้เทียบกับการกระจายงาน โครงสร้างคลังโค้ด และข้อกำหนดความหน่วง API ของตนเอง
การนำไปใช้งานทางวิศวกรรมและรายการตรวจสอบการกำกับดูแลเวิร์กโฟลว์
การผสานรวม Gemini 4 Hydrogen เข้ากับชุดเครื่องมือพัฒนาอัตโนมัติจำเป็นต้องมีขอบเขตการดำเนินการที่ชัดเจน การติดตามโทเค็น และการกำกับดูแลเอเจนต์เชิงป้องกัน
รายการตรวจสอบการใช้งานสำหรับนักพัฒนา
- ปรับระดับการคิดให้สอดคล้องกับงานปฏิบัติการ: กำหนดค่าพารามิเตอร์ความพยายามในการให้เหตุผลตามความซับซ้อนของปริมาณงาน สงวน
xhighไว้สำหรับกรณีมุมทางอัลกอริทึมที่ซับซ้อน คงhighไว้เป็นเกณฑ์มาตรฐานมาตรฐานสำหรับการนำทางคลังโค้ด และใช้mediumหรือlowสำหรับงานที่ไวต่อความหน่วง เช่น การจัดรูปแบบโค้ดใหม่หรือการค้นหาเอกสารอย่างง่าย - จัดโครงสร้างอินเทอร์เฟซเครื่องมือแบบขนาน: ออกแบบคำจำกัดความของเครื่องมือให้ยอมรับอาร์กิวเมนต์แบบกลุ่ม (Batched arguments) ตามที่รันไทม์รองรับ ซึ่งช่วยให้เอเจนต์ผู้ปฏิบัติงานสามารถขอตรวจสอบหลายไฟล์หรือตรวจสอบไวยากรณ์ได้ในคำขอเดียว แทนที่จะเป็นการส่งและรับกลับแบบทีละรายการ
- แยกการสร้างโมเดลออกจากการดำเนินการ: ตรวจสอบให้แน่ใจว่าโมเดลเสนอการเรียกใช้เครื่องมือและการแก้ไขโค้ดเป็นข้อมูลที่มีโครงสร้าง ในขณะที่รันไทม์ของไคลเอ็นต์ที่แยกตัวหรือตัวรันการทดสอบในคอนเทนเนอร์จะดำเนินการคำสั่งและส่งคืนผลลัพธ์การดำเนินการและหลักฐานที่ทำซ้ำได้ตามความเหมาะสม
รายการตรวจสอบการกำกับดูแลระดับองค์กร
- สร้างการบันทึกเซสชัน (Session Logging): บันทึกคำขอเครื่องมือ ผลลัพธ์การดำเนินการ การตัดสินใจเกี่ยวกับสิทธิ์ การเปลี่ยนแปลงโค้ด ผลลัพธ์การทดสอบ และสรุปโมเดลที่มีอยู่ อย่าถือว่าสรุปการให้เหตุผลเป็นร่องรอยการดำเนินการที่สมบูรณ์หรือเชื่อถือได้
- ใช้การควบคุมความปลอดภัยแบบแบ่งชั้น: ปฏิบัติต่อเอกสารภายนอก ตัวติดตามปัญหา และความคิดเห็นเกี่ยวกับพูลรีเควสต์ว่าเป็นอินพุตที่ไม่น่าเชื่อถือ แม้ว่า Hydrogen จะแสดงการปรับปรุงความยืดหยุ่น 2.3 เท่าบนเบนช์มาร์กการฉีดพรอมต์ทางอ้อมของ Gray Swan แต่การฆ่าเชื้ออินพุตอัตโนมัติและเกตสิทธิ์การดำเนินการยังคงเป็นสิ่งจำเป็น
- ตรวจสอบการใช้โทเค็นสะสม: ติดตามโทเค็นอินพุตและโทเค็นเอาต์พุตที่มีค่าใช้จ่าย รวมถึงโทเค็นการคิด โดยใช้ฟิลด์การใช้งานของ API ที่เลือก อย่าเพิ่มโทเค็นการคิดอีกหากรวมอยู่ในยอดรวมเอาต์พุตที่มีการเรียกเก็บเงินแล้ว
คำถามที่พบบ่อย (FAQ)
Gemini 4 Hydrogen เปรียบเทียบอย่างไรกับ Carbon และ Argon ในภาระงานจริงระดับการผลิต?
ระดับการคิดทั้งสี่ระดับคืออะไร และนักพัฒนาควรใช้ xhigh เมื่อใด?
โมเดลราคาแบบคงทำงานอย่างไรกับหน้าต่างบริบทหนึ่งล้านโทเค็น?
ประเด็นสำคัญสำหรับทีมวิศวกรรม
การปรับใช้เครื่องมือเขียนโค้ดอัตโนมัติในสภาพแวดล้อมการผลิตกำหนดให้ทีมพัฒนาต้องมองข้ามคะแนนเบนช์มาร์กะระดับแนวหน้า และมุ่งเน้นไปที่เศรษฐศาสตร์ของการเรียกใช้เครื่องมือแบบวนซ้ำ การส่งทุกการแก้ไขโค้ดประจำผ่านโมเดลการให้เหตุผลที่มีความหน่วงสูงทำให้เกิดความล่าช้าในการดำเนินงานที่ไม่จำเป็นและการพองตัวของงบประมาณ ในขณะเดียวกัน การจัดการความหน่วงในการดำเนินการและอัตราความสำเร็จของงานจำเป็นต้องมีความคาดหวังที่สมจริงเกี่ยวกับคะแนนเบนช์มาร์กและพฤติกรรมการกู้คืนข้อผิดพลาด
ด้วยการสร้างสถาปัตยกรรมแบบแบ่งชั้นที่ผสมผสานโมเดลการให้เหตุผลความจุสูงเข้ากับเอนจิ้นการดำเนินการที่รวดเร็วและคาดการณ์ได้ องค์กรวิศวกรรมจึงสามารถปรับขนาดเวิร์กโฟลว์การพัฒนาอัตโนมัติได้อย่างยั่งยืน ทีมงานที่นำการกำหนดเส้นทางแบบหลายโมเดลที่มีวินัย ขอบเขตการทดสอบที่มีโครงสร้าง และการตรวจสอบอินพุตที่เข้มงวดมาใช้ จะอยู่ในตำแหน่งที่ดีที่สุดในการสร้างไปป์ไลน์ซอฟต์แวร์ช่วยเหลือด้วย AI ที่มีความทนทานและดูแลรักษาง่าย
ข้อมูลอ้างอิง
-
Google DeepMind. การแนะนำ Gemini 4 Hydrogen ประกาศอย่างเป็นทางการ
-
Google DeepMind. การ์ดโมเดล Gemini 4 Hydrogen ข้อกำหนดทางเทคนิคและรายงานความปลอดภัย
-
Google Cloud. เอกสารประกอบโมเดล Gemini 4 Hydrogen ข้อมูลอ้างอิงทางเทคนิค
-
Google Antigravity. Gemini 4 Hydrogen ใน Google Antigravity ภาพรวมการประสานงานหลายโมเดล
-
Artificial Analysis. เบนช์มาร์กสติปัญญาและความหน่วงของ Gemini 4 Hydrogen การประเมิน AI อิสระ
-
Ars Technica. Google เปิดตัว Gemini 4 Hydrogen เพื่อมาแทนที่ 3.8 Flash ในที่สุด การวิเคราะห์ทางเทคนิค
Share this article