Microsoft เปิดตัว MAI-Transcribe-2 รองรับ 60 ภาษา? การเปิดตัวโมเดลจดจำเสียงในครั้งนี้ถือเป็นก้าวสำคัญในโครงสร้างพื้นฐานแบบหลายรูปแบบ (multimodal) โดย Microsoft ได้เปิดตัว MAI-Transcribe-2 อย่างเป็นทางการ ซึ่งสร้างมาตรฐานใหม่ด้านความสมดุลระหว่างความแม่นยำและเวลาในการประมวลผล (latency) ใน 60 ภาษา หลังจากเปิดตัว MAI-Transcribe-1 เมื่อ 5 เดือนก่อน และเวอร์ชัน 1.5 เมื่อ 3 เดือนก่อน โมเดลพื้นฐานที่อัปเดตใหม่นี้มีค่าเฉลี่ยอัตราความผิดพลาดของคำ (Word Error Rate - WER) อยู่ที่ 5.2% บนมาตรฐาน FLEURS และมีความเร็วในการประมวลผลแบบกลุ่ม (batch processing) ที่เร็วกว่าคู่แข่งถึง 10 เท่า ด้วยราคาเปิดตัวที่ 10 เซนต์ต่อชั่วโมงเสียง ซึ่งลดลงถึง 72% จากเดิมที่ $0.36 ในเวอร์ชัน 1 และ 1.5 Microsoft กำลังผลักดันให้การจดจำเสียงอัตโนมัติกลายเป็นบริการมาตรฐานที่เข้าถึงได้ง่าย พร้อมมอบฟีเจอร์อย่างการระบุตัวผู้พูด (speaker diarization), การประทับเวลาในระดับคำ และการสลับภาษา (code-switching) โดยตรงผ่าน Microsoft Foundry ในสถานะพรีวิวสาธารณะ
เศรษฐศาสตร์ของการจดจำเสียงและความสามารถของ MAI-Transcribe-2
ภาพรวม
- Microsoft เปิดตัว MAI-Transcribe-2 เมื่อวันที่ 3 กันยายน 2026 โดยตั้งราคาเปิดตัวไว้ที่ $0.10 ต่อชั่วโมงเสียงจนถึงสิ้นปี
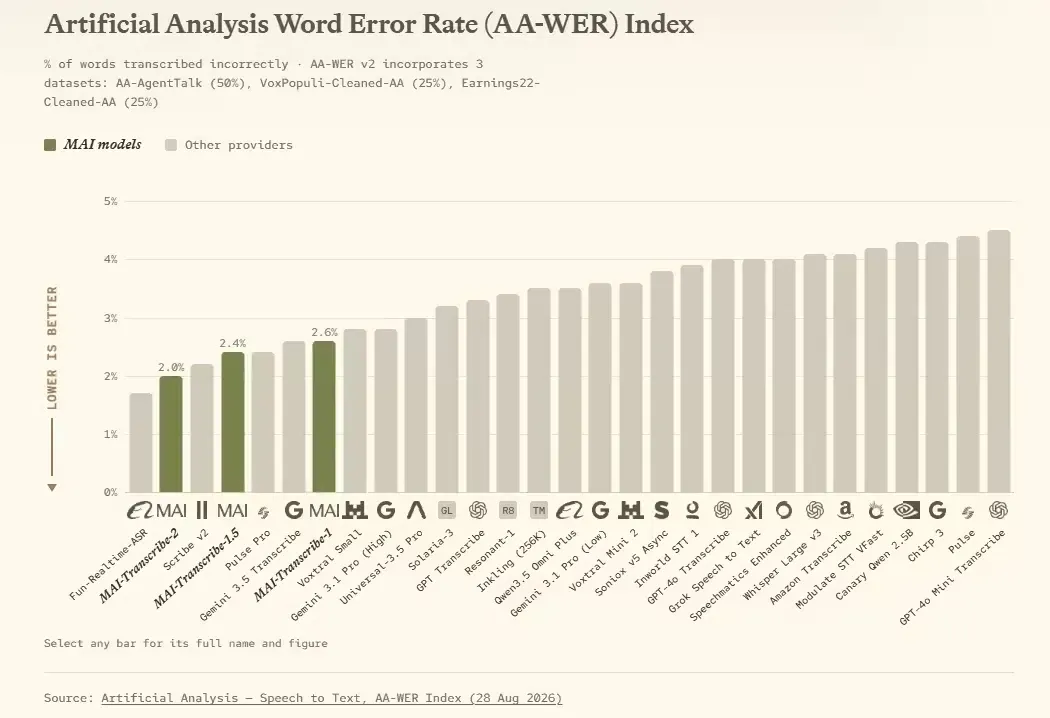
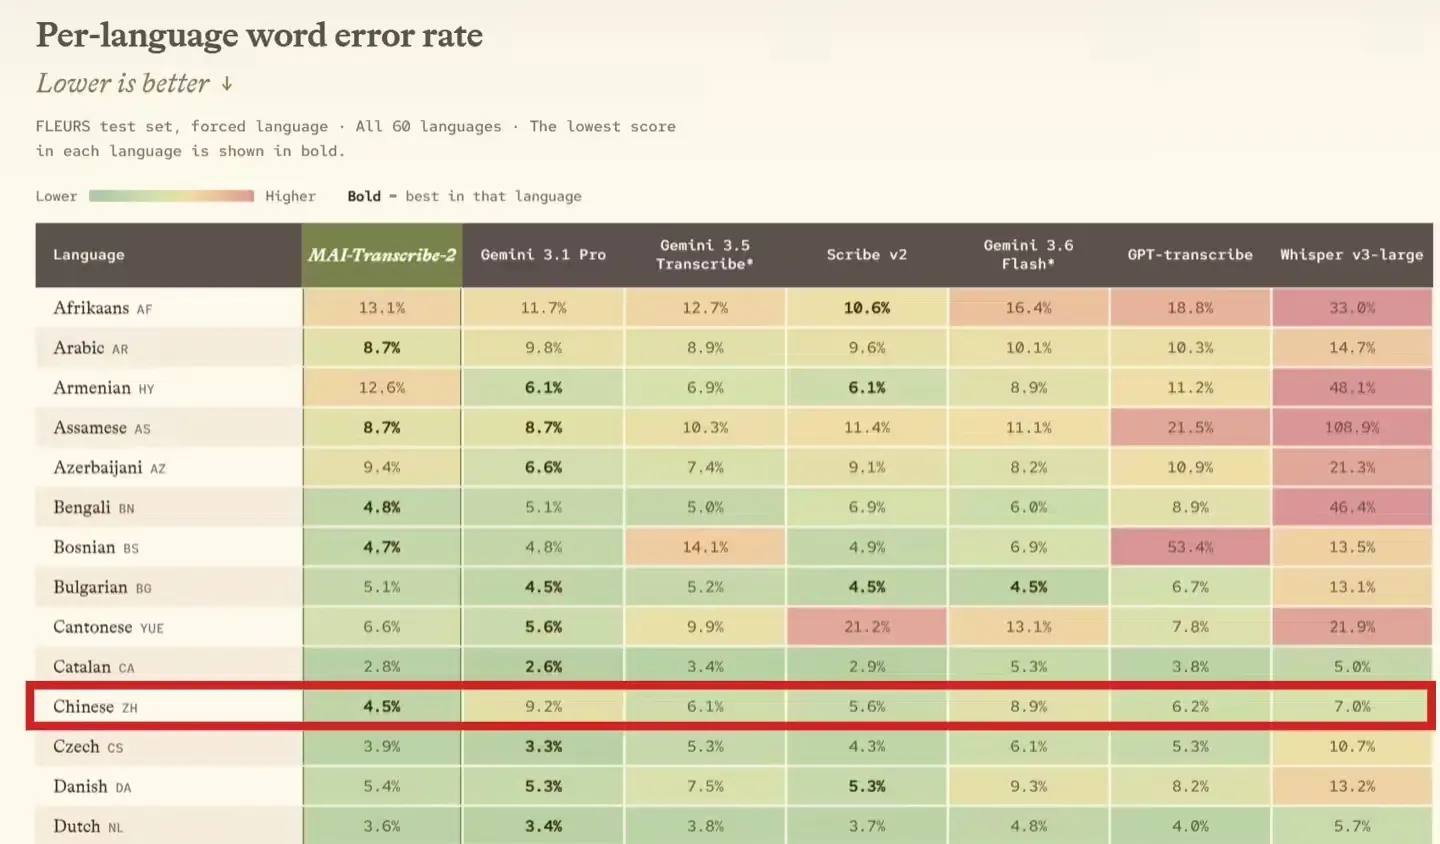
- โมเดลมีค่าเฉลี่ย Word Error Rate อยู่ที่ 5.2% ใน 60 ภาษาบนมาตรฐาน FLEURS และครองอันดับสองบนลีดเดอร์บอร์ด WER ของ Artificial Analysis
- ความสามารถของโมเดลประกอบด้วยการระบุตัวผู้พูด, การประทับเวลาในระดับคำ, การกำหนดคำเฉพาะโดเมน, การระบุภาษาอัตโนมัติ และการปรับรูปแบบการถอดความเป็นข้อความตามความต้องการ
ในอดีต ต้นทุนการประมวลผลเสียงสำหรับองค์กรทำให้นักพัฒนามักต้องเลือกระหว่างทางเลือกที่ยากลำบาก องค์กรที่จัดการข้อมูลเสียงปริมาณมาก เช่น ศูนย์บริการลูกค้า, แพลตฟอร์มบันทึกเอกสารทางกฎหมาย และกระบวนการถอดความทางการแพทย์ มักต้องเลือกระหว่างความแม่นยำสูงจาก API ราคาแพง หรือภาระในการดูแลโมเดลโอเพนซอร์สด้วยตนเอง ผู้ให้บริการเฉพาะทางมักเพิ่มความซับซ้อนโดยการจำกัดฟีเจอร์สำคัญอย่างการระบุตัวผู้พูดไว้ในแผนบริการระดับพรีเมียมเท่านั้น
จังหวะการเปิดตัวของ Microsoft AI สะท้อนถึงกลยุทธ์ที่ชัดเจนในการสร้างขีดความสามารถด้านโมเดลพื้นฐานภายในองค์กร การเปิดตัวโมเดลถึง 3 เจเนอเรชันภายใน 5 เดือน โดยขยายจาก 25 ภาษาที่ราคา $0.36 ในเดือนเมษายน เป็น 43 ภาษาในเดือนมิถุนายน และสูงถึง 60 ภาษาที่ราคา $0.10 ในเดือนกันยายน แสดงให้เห็นถึงประสิทธิภาพของกระบวนการพัฒนาและปรับแต่งโมเดลที่รวดเร็ว การวิเคราะห์โดย VentureBeat ระบุว่าปริมาณงาน (throughput) ที่สูงขึ้นช่วยลดจำนวน GPU-hours ที่ต้องการต่อปริมาณงานคงที่ ในขณะที่สถาปัตยกรรมรุ่นก่อนหน้าของ MAI-Transcribe ก็ได้รับการออกแบบมาเพื่อลดภาระการประมวลผลเช่นเดียวกัน
สำหรับผู้มีอำนาจตัดสินใจทางเทคนิค การประเมินผลกระทบจากการเปิดตัว MAI-Transcribe-2 ของ Microsoft เกี่ยวข้องกับการวิเคราะห์ทั้งต้นทุนต่อหน่วยและประสิทธิภาพโดยรวม ในสภาพแวดล้อมที่มีการประมวลผลข้อมูลเสียงหลายแสนชั่วโมงต่อปี การลดค่าธรรมเนียมพื้นฐานเหลือเพียง 10 เซนต์ต่อชั่วโมงจะเปลี่ยนให้การจดจำเสียงจากศูนย์รวมต้นทุนขนาดใหญ่กลายเป็นสาธารณูปโภคที่เข้าถึงได้ นอกจากนี้ การรวมฟีเจอร์หลักไว้ในโมเดลพื้นฐานยังช่วยลดความจำเป็นในการสร้างเลเยอร์การประมวลผลที่ซับซ้อนและใช้ผู้ให้บริการหลายรายในแอปพลิเคชันระดับองค์กร
สถาปัตยกรรมทางเทคนิคและขีดจำกัดด้าน Latency: วิธีที่ MAI-Transcribe-2 ทำงานในระดับสเกล
การบรรลุความแม่นยำสูงในสภาพแวดล้อมที่หลากหลายต้องอาศัยโมเดลที่สามารถจัดการกับสภาวะเสียงที่มีสัญญาณรบกวน, เสียงพูดที่ทับซ้อนกัน และคำศัพท์เฉพาะทางได้ จากข้อมูลการเปิดเผยประสิทธิภาพบน หน้าผลิตภัณฑ์ MAI-Transcribe-2 ของ Microsoft AI ระบุว่า MAI-Transcribe-2 ได้รับการออกแบบมาให้ทำงานได้อย่างแข็งแกร่งในสถานการณ์ที่มีเสียงรบกวน บทสนทนาที่มีหลายภาษาผสมกัน และข้อมูลนำเข้าที่มีคุณภาพหลากหลาย
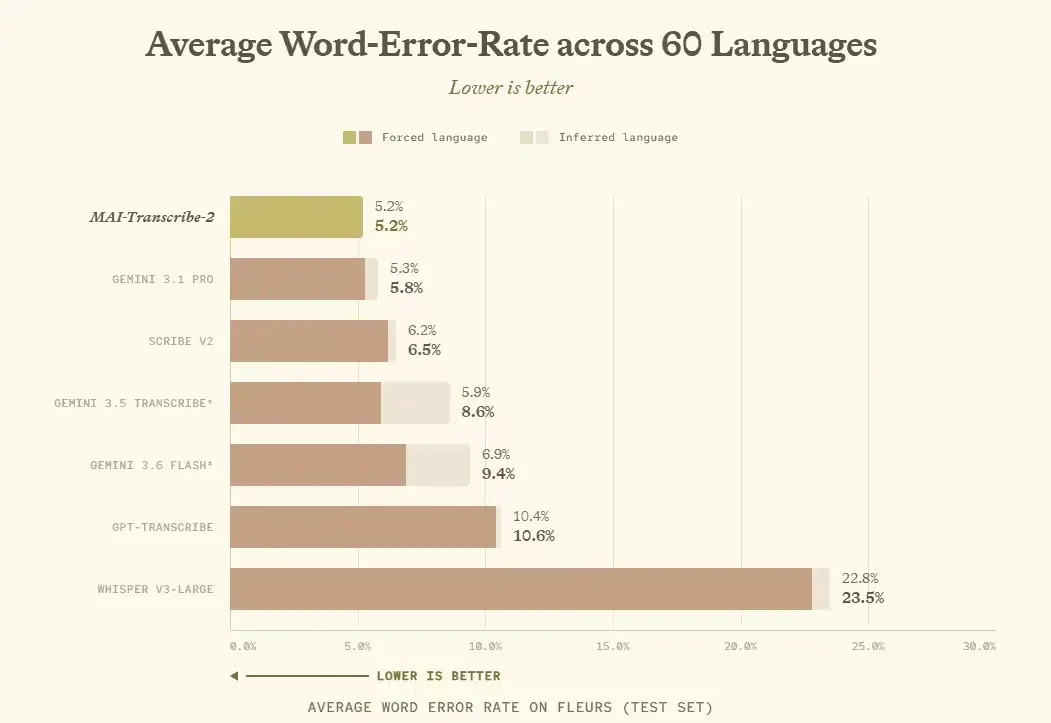
บนชุดทดสอบมาตรฐาน FLEURS โมเดลสามารถทำอัตราความผิดพลาดของคำเฉลี่ยได้ที่ 5.2% ใน 60 ภาษา ตามแผนภูมิมาตรฐานที่ Microsoft เผยแพร่และอ้างอิงโดย ITHome, MAI-Transcribe-2 รักษาค่าเฉลี่ย 5.2% นี้ไว้ได้ทั้งในการระบุภาษาแบบบังคับและการระบุภาษาอัตโนมัติ ในการทดสอบเปรียบเทียบ Gemini 3.5 Transcribe ถูกอ้างถึงในบันทึกของ Microsoft ว่าเป็นมาตรฐานอุตสาหกรรมหลัก ในขณะที่แผนภูมิเปรียบเทียบอื่นแสดงให้เห็นถึงประสิทธิภาพที่แข่งขันกับ Gemini 3.1 Pro (5.3% ถึง 5.8%), GPT-Transcribe ของ OpenAI (10.4% ถึง 10.6%) และ Whisper V3-Large (22.8% ถึง 23.5%) ในชุดทดสอบเดียวกัน
เศรษฐศาสตร์ของ Throughput และขีดจำกัดของ Pareto Latency
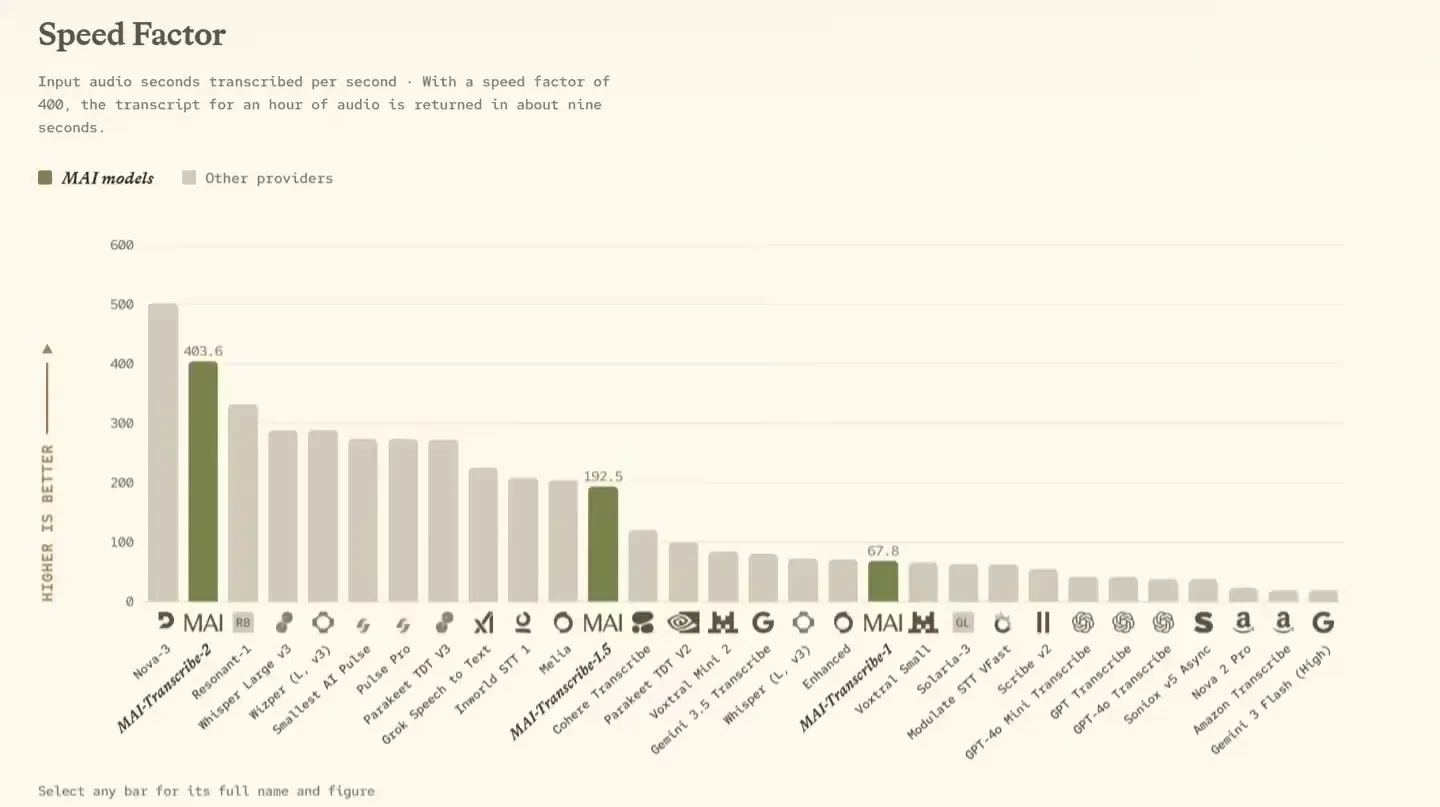
ในการประมวลผลเสียงแบบกลุ่ม (batch) อัตรา Throughput ของการอนุมาน (inference) เป็นปัจจัยสำคัญต่อต้นทุนคอมพิวเตอร์และราคาบริการ โมเดลที่สามารถประมวลผลเสียงได้เร็วกว่าเวลาจริงหลายร้อยเท่าสามารถลดเวลา GPU ที่ต้องใช้ในการประมวลผลงานหนึ่งๆ ได้มากกว่าทางเลือกที่ช้ากว่า การประเมินโดย Artificial Analysis จัดให้ MAI-Transcribe-2 อยู่บนเส้น Pareto ของความแม่นยำและเวลาประมวลผล โดยรายงานความเร็วที่ 403.6 เท่าของเวลาจริง ทำให้การถอดความเสียง 1 ชั่วโมงใช้เวลาดำเนินการเพียง 10 วินาทีโดยประมาณ
แผนภาพด้านล่างสรุปความสามารถในการประมวลผลที่นักพัฒนาสามารถนำไปใช้ได้:
[การรับข้อมูลเสียงเข้า]
  ข้อมูลเสียง (WAV / MP3 / FLAC / Codecs ที่รองรับ)
                         │
                         ▼
[ความสามารถของโมเดลที่สนับสนุน]
  ├── ระบุภาษาอัตโนมัติ (Auto-detect / Forced)
  ├── การจดจำเสียงหลายภาษา (60 ภาษา)
  ├── การระบุตัวผู้พูดและการประทับเวลาในระดับคำ
  └── การรองรับคำศัพท์เฉพาะ (Keyword Biasing)
                         │
                         ▼
[การสร้างผลลัพธ์ที่ปรับแต่งได้]
  สตรีมผลลัพธ์ที่จัดรูปแบบแล้ว (โหมดถอดความตรงตัว vs โหมดข้อความสะอาด)
เพื่อตอบสนองความต้องการทางธุรกิจที่หลากหลาย สถาปัตยกรรมนี้จึงรวมการตั้งค่าผลลัพธ์ที่ยืดหยุ่น นักพัฒนาสามารถเลือกโหมดถอดความตรงตัว (verbatim) เพื่อจับจังหวะการหยุดพูด คำฟุ่มเฟือย และการเริ่มประโยคใหม่ ซึ่งจำเป็นสำหรับงานด้านกฎหมายและการตรวจสอบทางการแพทย์ หรือในทางกลับกัน สามารถเลือกโหมดทำความสะอาด (clean) เพื่อกรองคำฟุ่มเฟือยจากการสนทนาออกโดยอัตโนมัติ เพื่อสร้างข้อความที่สวยงามสำหรับการสรุปการประชุม คำบรรยาย และการตีพิมพ์ภายนอก
การประเมินแนวทางการจดจำเสียงในระบบงานขององค์กร
การเลือกสถาปัตยกรรมจดจำเสียงจำเป็นต้องประเมินความซับซ้อนของโฮสติ้ง ข้อกำหนดความเป็นส่วนตัว และต้นทุนการดำเนินงานระยะยาว ทีมวิศวกรรมมักเปรียบเทียบโมเดลการดำเนินงานสามแบบที่แตกต่างกันเมื่อสร้างระบบถอดความอัตโนมัติ
การประเมินทางเทคนิค: โมเดลโฮสต์เอง vs API ประสิทธิภาพสูงเฉพาะทาง
การใช้โมเดลโอเพนซอร์สแบบโฮสต์เองเช่น Whisper ช่วยให้สามารถควบคุมพื้นที่เก็บข้อมูลได้อย่างสมบูรณ์ แต่เพิ่มภาระด้านโครงสร้างพื้นฐานอย่างมหาศาล ทีมวิศวกรรมต้องจัดการคลัสเตอร์ GPU, ปรับขนาดกลุ่มงาน, และดูแลระบบรองสำหรับการระบุตัวผู้พูด ในทางตรงกันข้าม Cloud API ช่วยให้ขยายระบบได้ทันทีโดยไม่ต้องดูแลรักษาโครงสร้างพื้นฐานอย่างต่อเนื่อง
ตารางด้านล่างแสดงการเปรียบเทียบวิธีการทั่วไปสำหรับการประมวลผลเสียงปริมาณมากในองค์กร:
| สถาปัตยกรรม | ภาระโครงสร้างพื้นฐาน | การระบุตัวผู้พูด & ประทับเวลา | การดูแลหลายภาษา | การแลกเปลี่ยนด้านปฏิบัติงาน |
|---|---|---|---|---|
| โอเพนซอร์สแบบโฮสต์เอง (เช่น Whisper) | สูง (คลัสเตอร์ GPU เฉพาะ) | ต้องใช้ระบบเสริม | ดูแลและทดสอบโมเดลเอง | ข้อมูลเป็นส่วนตัวสูงสุดแต่ภาระดูแลรักษาหนัก |
| API อเนกประสงค์ทั่วไป | ต่ำ (Serverless Cloud Endpoints) | ขึ้นอยู่กับผู้ให้บริการ | ครอบคลุมกว้างขวาง | ต้นทุนต่อหน่วยอาจสูงกว่าสำหรับงานถอดความเพียงอย่างเดียว |
| ระบบจดจำเสียงเฉพาะทาง (MAI-Transcribe-2) | ต่ำ (Managed Azure / Foundry API) | มีระบบในตัว | ใช้งานโมเดลเดียวครอบคลุม | ต้นทุนต่อหน่วยต่ำแต่ต้องพึ่งพาแผนการพัฒนาของผู้ให้บริการ |
แม้การโฮสต์เองจะยังคงจำเป็นสำหรับสภาพแวดล้อมที่แยกจากเครือข่ายภายนอก แต่เศรษฐศาสตร์ของ API เฉพาะทางกำลังเปลี่ยนทิศทางไปสู่การใช้บริการแบบจัดการ (Managed Services) การใช้บริการจุดเชื่อมต่อที่รวมเอาการระบุตัวผู้พูด การประทับเวลา และการปรับแต่งคำศัพท์ไว้ที่ราคา 10 เซนต์ต่อชั่วโมง จะช่วยลดต้นทุนรวมในการเป็นเจ้าของ (TCO) สำหรับงานเชิงพาณิชย์ส่วนใหญ่ได้อย่างมาก
รายการตรวจสอบทางวิศวกรรม: การเชื่อมต่อ API จดจำเสียงประสิทธิภาพสูง
เพื่อให้การเชื่อมต่อโมเดลถอดความบนระบบคลาวด์เข้ากับขั้นตอนการทำงานจริงเป็นไปอย่างราบรื่น ทีมพัฒนาสามารถจัดโครงสร้างการทำงานตามแนวทางปฏิบัติของแพลตฟอร์มที่กำหนดไว้
รายการตรวจสอบการนำไปใช้งานสำหรับนักพัฒนา
- ตรวจสอบข้อจำกัดของไฟล์เสียง: Fast Transcription API ทั่วไปของ Microsoft รองรับไฟล์ที่มีขนาดต่ำกว่า 500 MB และระยะเวลาห้าชั่วโมง นักพัฒนาควรตรวจสอบข้อจำกัดเฉพาะของโมเดลผ่านพรีวิวพอยต์ของ MAI-Transcribe-2 ก่อนการใช้งานจริง
- กำหนดการตั้งค่าคำเฉพาะทาง (Keyword Biasing): MAI-Transcribe-2 รองรับการให้น้ำหนักคำสำหรับศัพท์เฉพาะทางและตัวย่อ ทีมควรตรวจสอบสคีมาพรีวิวของ Foundry สำหรับฟิลด์การกำหนดคำเฉพาะในแต่ละการปรับใช้
- เลือกรูปแบบการจัดรูปแบบผลลัพธ์: สำหรับขั้นตอนการปฏิบัติตามกฎระเบียบและการตรวจสอบ ให้ใช้การตั้งค่าถอดความตรงตัว (verbatim) และเลือกใช้สไตล์การถอดความสะอาด (clean) สำหรับสรุปข้อมูลที่เน้นผู้บริโภคและบันทึกสาธารณะ
รายการตรวจสอบด้านความปลอดภัยและโครงสร้างพื้นฐาน
- ตรวจสอบขอบเขตข้อมูลระดับภูมิภาค: ตรวจสอบให้แน่ใจว่าทรัพยากรการประมวลผลเสียงสอดคล้องกับข้อกำหนดการจัดเก็บข้อมูลและการกำกับดูแลขององค์กรภายใน Cloud Console
- ใช้ตรรกะการแบ่งกลุ่มข้อมูล (Batch Chunking): สำหรับไฟล์เก็บถาวรขนาดใหญ่ขององค์กรที่เกินเกณฑ์ไฟล์เดียว ให้ใช้ระบบประมวลผลล่วงหน้าที่แบ่งไฟล์เสียงตามช่วงจังหวะหยุดพูดเพื่อให้คงความต่อเนื่องของสัญญาณเสียง
- ตรวจสอบเอกสารประกอบพรีวิว: ข้อมูลเปิดตัวของ Microsoft ยืนยันการระบุตัวผู้พูดใน MAI-Transcribe-2 ในขณะที่เอกสารการเชื่อมต่อก่อนหน้านี้กำลังได้รับการอัปเดต ควรตรวจสอบพารามิเตอร์ของพรีวิวพอยต์ล่าสุดก่อนที่จะพึ่งพาสคีมาคำขอใดๆ
ด้วยการปฏิบัติตามมาตรฐานการใช้งานที่เป็นระบบเหล่านี้ ทีมวิศวกรรมสามารถเชื่อมต่อบริการถอดความที่มีประสิทธิภาพสูงเข้ากับระบบข้อมูลหลักของตนได้อย่างไร้รอยต่อ โดยยังคงรักษาความสามารถในการคาดการณ์ทางสถาปัตยกรรมไว้ได้
คำถามที่พบบ่อย (FAQ)
ความสำคัญของอัตราความผิดพลาดของคำ (Word Error Rate) ที่ 5.2% บนมาตรฐาน FLEURS คืออะไร?
MAI-Transcribe-2 เปรียบเทียบกับ GPT-Transcribe และ Whisper ของ OpenAI อย่างไร?
อะไรคือความแตกต่างระหว่างรูปแบบการถอดความแบบตรงตัว (verbatim) และแบบสะอาด (clean)?
สรุปประเด็นสำคัญสำหรับทีมวิศวกรรม
วิวัฒนาการอย่างต่อเนื่องของโมเดลจดจำเสียงเฉพาะทางแสดงให้เห็นถึงการเปลี่ยนผ่านที่กว้างขึ้นสู่ประสิทธิภาพเฉพาะรูปแบบในปัญญาประดิษฐ์ ในขณะที่โมเดลอเนกประสงค์ (multimodal) ยังคงขยายขีดความสามารถในการใช้เหตุผลอย่างต่อเนื่อง แต่โมเดลจดจำเสียงเฉพาะทางกลับพิสูจน์ให้เห็นว่าการปรับแต่งให้ตรงจุดให้ประสิทธิภาพด้าน Latency ที่เหนือกว่า อัตราข้อผิดพลาดที่ต่ำกว่า และความคุ้มค่าทางเศรษฐศาสตร์ที่ดึงดูดใจ
สำหรับองค์กรทางเทคนิค การเชื่อมต่อบริการถอดความประสิทธิภาพสูงช่วยให้ระบบอัตโนมัติทำงานได้อย่างสเกลในงานธุรกิจที่เน้นเสียง การเลือกสถาปัตยกรรมเฉพาะทางที่รวมเอาฟีเจอร์การระบุตัวผู้พูด, รูปแบบเอาต์พุตที่ปรับแต่งได้ และการประมวลผลแบบกลุ่มที่มีประสิทธิภาพ จะช่วยให้ทีมพัฒนาสามารถสร้างระบบข้อมูลที่ตอบสนองรวดเร็วและคุ้มค่า ซึ่งสามารถขยายตัวไปพร้อมกับความต้องการขององค์กรได้
เอกสารอ้างอิง
-
Microsoft AI. MAI-Transcribe-2 คือโมเดลจดจำเสียงที่เร็ว แม่นยำ และประหยัดที่สุดในโลก https://microsoft.ai/news/mai-transcribe-2-is-the-fastest-most-accurate-and-cheapest-speech-recognition-model-in-the-world/
-
Microsoft AI. ภาพรวมและข้อมูลจำเพาะของโมเดล MAI-Transcribe-2 https://microsoft.ai/models/mai-transcribe-2/
-
Microsoft Learn. การใช้ Fast Transcription API https://learn.microsoft.com/en-us/azure/ai-services/speech-service/fast-transcription-create
-
Microsoft Learn. ปรับปรุงความแม่นยำในการจดจำด้วยรายการวลี (Phrase Lists) https://learn.microsoft.com/en-us/azure/ai-services/speech-service/improve-accuracy-phrase-list
-
Artificial Analysis. ลีดเดอร์บอร์ดการเปลี่ยนเสียงเป็นข้อความและขีดจำกัด Pareto ของความแม่นยำและเวลาประมวลผล https://artificialanalysis.ai/speech-to-text/non-streaming
-
Google Research. FLEURS: การประเมินประสิทธิภาพการเรียนรู้แบบ Few-shot ของโมเดลเสียงสากล https://huggingface.co/datasets/google/fleurs
-
VentureBeat. Microsoft AI เปิดตัว MAI-Transcribe-2 แข่งกับ OpenAI, Google และ ElevenLabs ในด้านราคาและความเร็ว https://venturebeat.com/technology/microsoft-launches-3-new-ai-models-in-direct-shot-at-openai-and-google
-
Neowin. โมเดล MAI-Transcribe-2 ของ Microsoft เอาชนะ OpenAI และ Google ในราคาเพียง $0.10 ต่อชั่วโมง https://www.neowin.net/news/microsofts-mai-transcribe-2-model-beats-openai-and-google-while-costing-just-010-per-hour/
-
ITHome. Microsoft เปิดตัวโมเดลจดจำเสียง MAI-Transcribe-2 ด้วยค่า WER 5.2% https://www.ithome.com/0/998/241.htm
Share this article



