NVIDIA กำลังลงทุนใน Perplexity หรือไม่? ตามรายงานที่เผยแพร่เมื่อวันที่ 24 สิงหาคม 2026 ระบุว่า NVIDIA กำลังอยู่ในระหว่างการหารือเกี่ยวกับการลงทุนในบริษัทค้นหาด้วย AI แห่งนี้ ซึ่งเป็นส่วนหนึ่งของการระดมทุนส่วน of equity ที่อาจทำให้ Perplexity มีมูลค่ามากกว่า 30,000 ล้านดอลลาร์ การพูดคุยดังกล่าวเน้นย้ำถึงวิธีที่เงินทุนโครงสร้างพื้นฐาน AI กำลังเคลื่อนตัวเข้าสู่การค้นหาแบบสนทนาและเอ็นจิ้นตอบคำถามอย่างลึกซึ้งยิ่งขึ้น ซึ่งการค้นพบแบรนด์สามารถเกิดขึ้นได้ก่อน—หรือโดยปราศจาก—การคลิกอ้างอิงแบบดั้งเดิม สำหรับทีมเติบโตและการระบุแหล่งที่มา ความท้าทายที่ตามมาไม่ใช่ว่าทุกปฏิสัมพันธ์ของ AI จะสามารถติดตามได้ทันที แต่การวัดผลแบบคลิกครั้งสุดท้าย (last-click) แบบดั้งเดิมในปัจจุบันกำลังสังเกตเห็นสัดส่วนที่ลดลงของเส้นทางการค้นพบที่มีความกระจัดกระจายมากขึ้นเรื่อยๆ
การเจรจาลงทุนของ NVIDIA อาจทำให้ Perplexity มีมูลค่าสูงกว่า 30,000 ล้านดอลลาร์
สรุปสาระสำคัญ
- รายงานจากสื่อระบุว่า NVIDIA กำลังหารือเกี่ยวกับการลงทุนใน Perplexity ซึ่งเป็นส่วนหนึ่งของการระดมทุนด้วยทุนเรือนหุ้นที่อาจทำให้สตาร์ทอัพ AI มีมูลค่ามากกว่า 30,000 ล้านดอลลาร์ ขณะที่การระดมทุนในภาพรวมมีมูลค่าหลายพันล้านดอลลาร์
- รายได้ต่อปีของ Perplexity พุ่งสูงขึ้นจากต่ำกว่า 250 ล้านดอลลาร์ในช่วงต้นปี 2026 สู่ระดับมากกว่า 750 ล้านดอลลาร์ ซึ่งได้รับการสนับสนุนจากการขยายตัวของระบบอัตโนมัติเวิร์กโฟลว์ Perplexity Computer
- การหารือเหล่านี้สอดคล้องกับรูปแบบที่ขยายตัวของการจัดวางโครงสร้างพื้นฐาน ซึ่งเชื่อมโยงความต้องการประมวลผลของฮาร์ดแวร์เข้ากับการค้นหาแบบสนทนาปลายทางและแพลตฟอร์มการจัดจำหน่ายซอฟต์แวร์
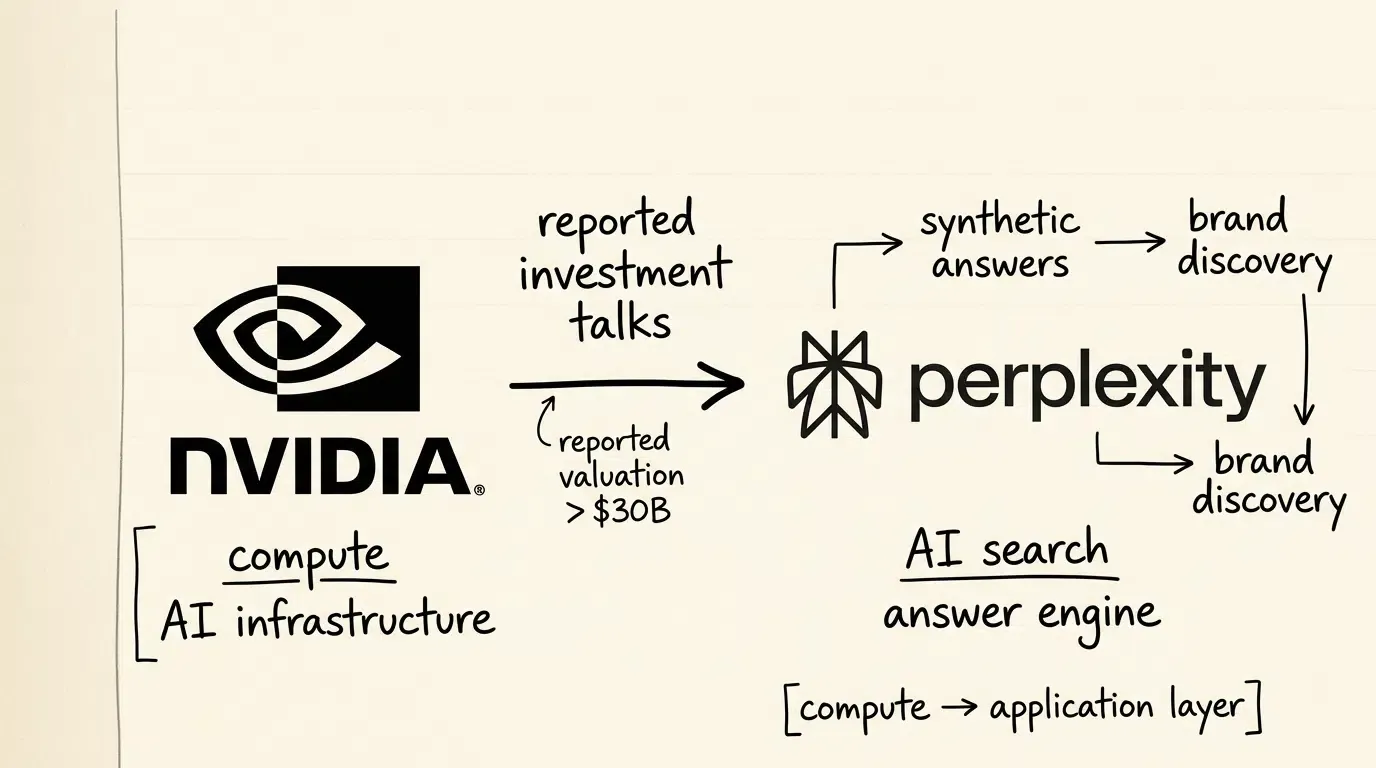
การขยายตัวเชิงพาณิชย์ของการค้นหาแบบสนทนากำลังปรับเปลี่ยนห่วงโซ่คุณค่าของปัญญาประดิษฐ์ เป็นเวลาหลายทศวรรษแล้วที่เศรษฐศาสตร์ของเครื่องมือค้นหาพึ่งพาการจัดทำดัชนีหน้าเว็บและการแสดงผลลัพธ์ไดเรกทอรีที่มีการจัดอันดับ ซึ่งสร้างรายได้ผ่านการประมูลคีย์เวิร์ดและการโฆษณาแบบจ่ายต่อคลิก กรอบการทำงานดังกล่าวช่วยให้ผู้ให้บริการเว็บไซต์มีช่องทางส่งต่อผู้เข้าชมที่สังเกตเห็นได้โดยตรง ในทางตรงกันข้าม เอ็นจิ้นตอบคำถามแบบสนทนาจะผสมผสานโมเดลภาษาขนาดใหญ่เข้ากับระบบการดึงข้อมูลเพื่อส่งคำตอบโดยตรง โดยแสดงการอ้างอิงแหล่งที่มาภายในคำตอบที่สังเคราะห์ขึ้นทันที แทนที่จะขับเคลื่อนการเข้าชมเต็มหน้าเว็บ
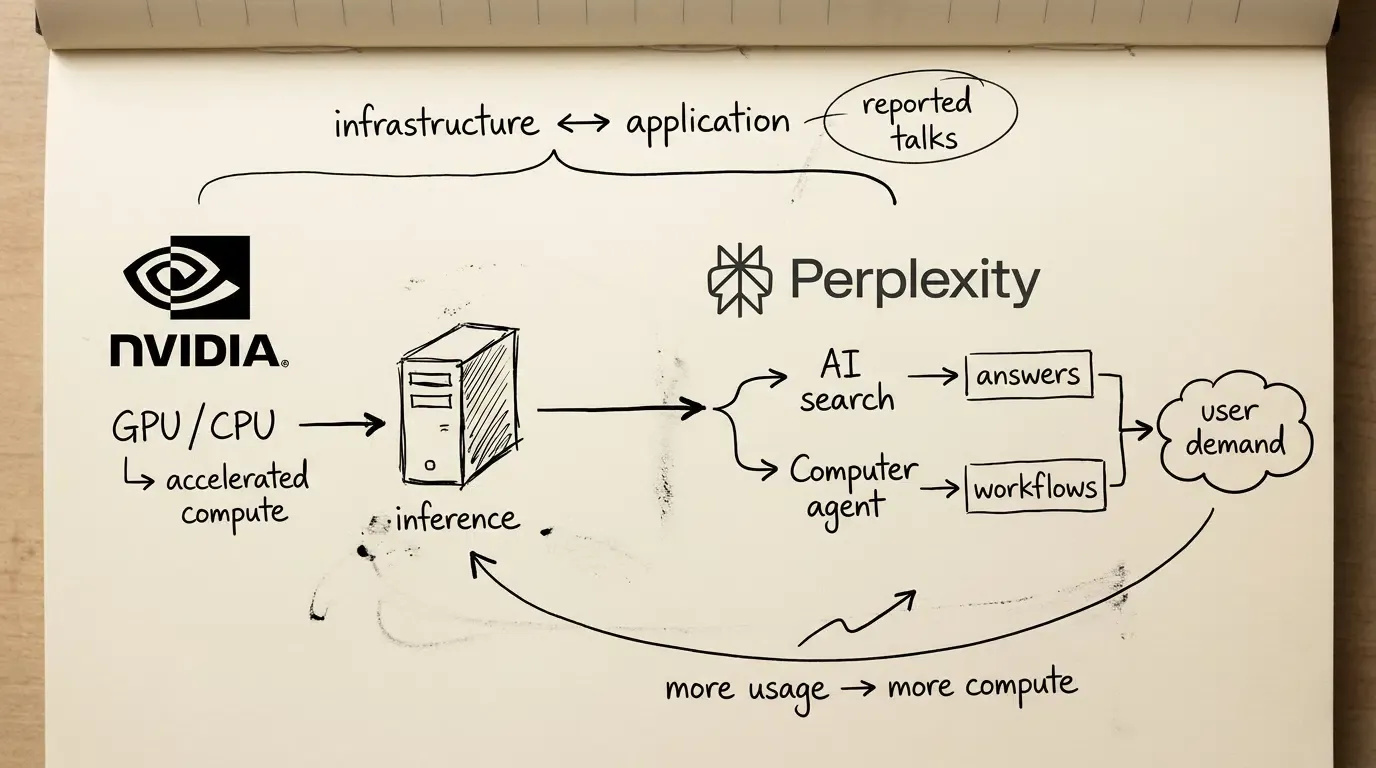
การเปลี่ยนแปลงพื้นฐานในพฤติกรรมผู้ใช้นี้สร้างความท้าทายในการวัดผลที่แตกต่างออกไปสำหรับผู้จัดพิมพ์ดิจิทัลและนักการตลาดด้านการเติบโต เมื่อผู้ใช้ได้รับคำตอบที่สังเคราะห์ขึ้นโดยตรงภายในส่วนติดต่อการค้นหาหรือบทสนทนา อัตราการคลิกผ่านไปยังผู้จัดพิมพ์ภายนอกอาจลดลง ซึ่งเพิ่มชั้นการค้นพบที่มองไม่เห็นล่วงหน้าก่อนการเยี่ยมชมเว็บแบบดั้งเดิม ในขณะเดียวกัน การสร้างและการให้บริการคำ QUERY แบบสนทนาเหล่านี้จำเป็นต้องมีโครงสร้างพื้นฐานด้านการประมวลผลจำนวนมาก การใช้งานการกำหนดเส้นทางหลายโมเดลแบบเรียลไทม์และเวิร์กโฟลว์คอมพิวเตอร์แบบเอเจนต์ต้องอาศัยความสามารถในการประมวลผลแบบเร่งความเร็วที่มีนัยสำคัญ ซึ่งเพิ่มค่าใช้จ่ายในการอนุមានเชิงปฏิบัติการสำหรับผู้ให้บริการค้นหา พลวัตของตลาดเหล่านี้ได้รับการวิเคราะห์ในรายงานของ Reuters ล่าสุดที่ติดตามเส้นทางการเติบโตของบริษัท
การพูดคุยที่มีรายงานสะท้อนให้เห็นถึงการจัดแนวทางที่กว้างขึ้นระหว่างผู้ให้บริการโครงสร้างพื้นฐาน AI และบริษัทซอฟต์แวร์เลเยอร์แอปพลิเคชัน รอบการระดมทุนที่มีรายงานอาจทำให้สตาร์ทอัพมีมูลค่ามากกว่า 30,000 ล้านดอลลาร์ เพิ่มขึ้นจาก 20,000 ล้านดอลลาร์ในช่วงปลายปี 2025 รายได้ต่อปีของ Perplexity พุ่งทะยานเกิน 750 ล้านดอลลาร์ ซึ่งขับเคลื่อนส่วนหนึ่งโดยเอเจนต์ Perplexity Computer สำหรับงานอัตโนมัติในที่ทำงาน การพูดคุยเหล่านี้เกิดขึ้นหลังจากการเจรจาก่อนหน้าซึ่ง NVIDIA พิจารณาข้อตกลงการอนุญาตเทคโนโลยีและการจัดหาบุคลากรก่อนที่การพูดคุยจะพัฒนาไปสู่การลงทุนในส่วนของทุน Perplexity ได้ระบุแผนการแยกต่างหากในการปรับใช้ CPU Vera ของ NVIDIA สำหรับเวิร์กโฟลว์ของเอเจนต์ และคงข้อตกลงโครงสร้างพื้นฐานกับ CoreWeave ที่เกี่ยวข้องกับระบบ NVIDIA Grace Blackwell สำหรับ NVIDIA ความสัมพันธ์ด้านทุนกับแอปพลิเคชัน AI ที่เติบโตอย่างรวดเร็วสามารถช่วยเพิ่มการเปิดรับความต้องการการประมวลผลปลายทาง พร้อมทั้งขยายตำแหน่งของตนให้กว้างขึ้นนอกเหนือจากการขายซิลิคอน
สาเหตุเชิงระบบ: จากการส่งต่อโดยตรงสู่การค้นหาแบบไม่คลิก (Zero-Click Discovery)
ในระดับสถาปัตยกรรม แพลตฟอร์มการค้นหาแบบสนทนาเปลี่ยนแปลงวิธีการเคลื่อนที่ของทราฟฟิกดิจิทัลทั่วอินเทอร์เน็ต ในการค้นหาเว็บแบบดั้งเดิม คำค้นหาของผู้ใช้จะถูกจับคู่กับดัชนีการค้นหาและผลลัพธ์ที่จัดอันดับจะถูกส่งกลับเป็นไฮเปอร์ลิงก์ เมื่อผู้ใช้คลิกลิงก์ภายนอกที่มีการแท็ก เซสชันเว็บที่เกิดขึ้นอาจเปิดเผยข้อมูลผู้อ้างอิง พารามิเตอร์แคมเปญ และตัวระบุเซสชันของบุคคลที่หนึ่งที่มีอยู่ ภายใต้การควบคุมของเบราว์เซอร์และความเป็นส่วนตัว
เอ็นจิ้นตอบคำถามแบบสนทนานำเสนอโฟลว์ปฏิสัมพันธ์ที่แตกต่างออกไป แทนที่จะพึ่งพาการดึงข้อมูลเว็บสดสำหรับทุกๆ พรอมต์เพียงอย่างเดียว สถาปัตยกรรมการดึงข้อมูลสมัยใหม่สามารถผสมผสานดัชนีการค้นหา สำเนาเนื้อหาที่แคชไว้ และการดึงข้อมูลสดหรือแหล่งข้อมูลภายนอกเข้าด้วยกันก่อนที่จะสังเคราะห์คำตอบ ในปฏิสัมพันธ์เหล่านี้หลายครั้ง ผู้ใช้ปลายทางจะได้รับข้อมูลที่ต้องการโดยไม่ต้องสร้างเซสชันเบราว์เซอร์ทันทีบนเซิร์ฟเวอร์ต้นทางของผู้จัดพิมพ์ที่ถูกอ้างอิง
ความตัดขาดของโปรโตคอล: การคลิกผ่านโดยตรงเทียบกับการอ้างอิงคำตอบสังเคราะห์
การตั้งค่าการวัดผลดิจิทัลแบบดั้งเดิมจำนวนมากพึ่งพาการระบุแหล่งที่มาแบบคลิกครั้งสุดท้ายเป็นหลัก โดยสันนิษฐานว่าการแปลงทุกครั้งมีต้นกำเนิดมาจากการคลิกเว็บที่ระบุตัวตนได้ ในระบบนิเวศของเอ็นจิ้นตอบคำถาม การค้นพบของลูกค้าเกิดขึ้นภายในบทสนทนาแบบสนทนาก่อนที่ผู้ใช้จะเยี่ยมชมเว็บไซต์หรือติดตั้งแอปพลิเคชันนานมาก
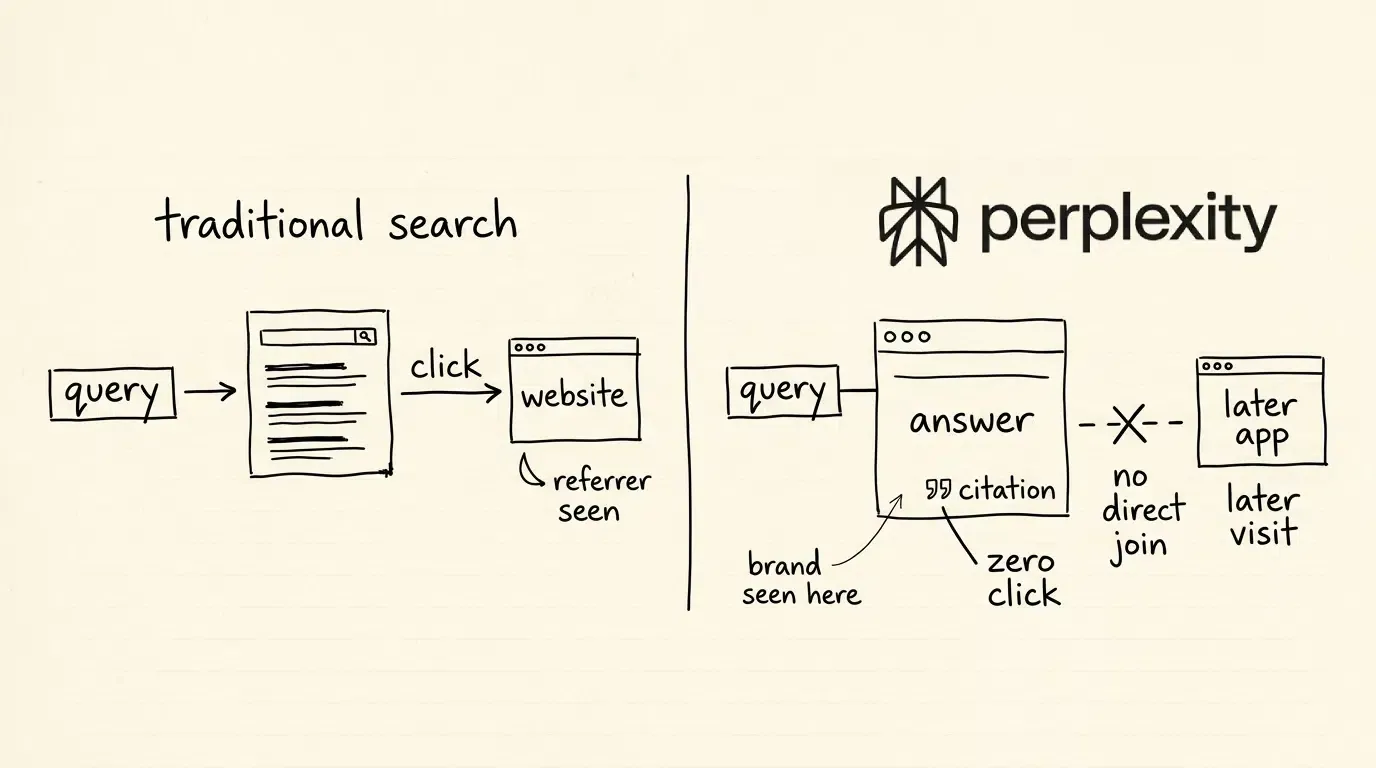
แผนภาพด้านล่างแสดงความแตกต่างของโปรโตคอลระหว่างช่องทางการคลิกค้นหาแบบดั้งเดิมและโฟลว์เอ็นจิ้นตอบคำถามแบบสนทนา:
[ช่องทางการคลิกค้นหาแบบดั้งเดิม]
  คำค้นหาของผู้ใช้ ──> 10 ลิงก์สีน้ำเงิน ──> คลิกโดยตรง ──> เซสชันเว็บขาเข้า (สังเกตเห็นข้อมูลผู้อ้างอิง / แคมเปญได้)

[โฟลว์เอ็นจิ้นตอบคำถามแบบสนทนา]
  คำค้นหาของผู้ใช้ ──> คำตอบสังเคราะห์ ──> การอ้างอิงแบรนด์ ──> ไม่คลิก / เยี่ยมชมภายหลัง (ไม่มีคีย์เชื่อมโยงโดยตรง)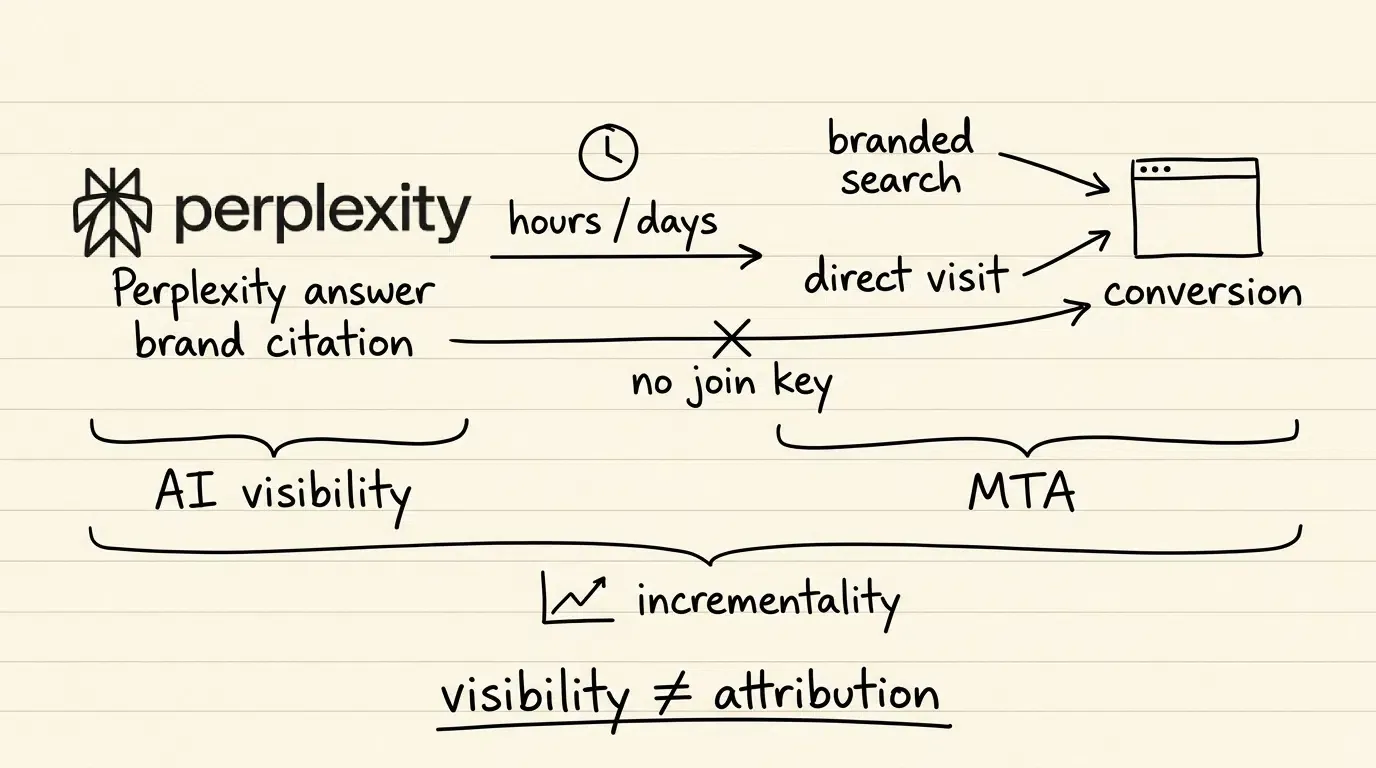
เมื่อเอ็นจิ้นตอบคำถามอ้างอิงแบรนด์ ผลิตภัณฑ์ หรือที่เก็บซอฟต์แวร์เป็นแหล่งที่มา ผู้ใช้อาจอ่านสรุป ประเมินคำแนะนำ และเปิดแอปพลิเคชันเป้าหมายบนอุปกรณ์มือถือของตนเองอย่างอิสระในอีกหลายชั่วโมงหรือหลายวันต่อมา เนื่องจากการคลิกอ้างอิงโดยตรงไม่ได้เกิดขึ้นระหว่างการประเมินเบื้องต้น เครื่องมือระบุแหล่งที่มาแบบสัมผัสเดียวมาตรฐานอาจบันทึกการเปิดใช้งานในภายหลังว่าเป็นแบบตรง (direct) แบบออร์แกนิก (organic) หรือแหล่งที่มาปลายทางอื่นๆ ที่สังเกตเห็นได้ พร้อมกับสูญเสียการเปิดรับ AI ดั้งเดิมไป ในการตลาดดิจิทัลและการจัดจำหน่ายแอปพลิเคชันที่กว้างขึ้น การเสื่อมถอยของผู้อ้างอิงการค้นหาแบบดั้งเดิมเน้นย้ำถึงช่องว่างที่กว้างขึ้นระหว่างการมองเห็นแบรนด์ในส่วนบนของฟनल (upper-funnel) และการระบุแหล่งที่มาของการแปลงแบบกำหนด (deterministic conversion attribution) ทีมเติบโตจึงต้องการกรอบการทำงานในการวัดผลที่แยกการมองเห็นแบรนด์ในวงกว้างออกจากการระบุแหล่งที่มาแบบหลายจุดสัมผัสของปฏิสัมพันธ์ของผู้ใช้ที่บันทึกไว้
สร้างหรือซื้อ: การจัดการการระบุแหล่งที่มาแบบหลายจุดสัมผัสในยุคค้นหาด้วย AI
เนื่องจากการค้นหาดิจิทัลเกิดขึ้นผ่านอินเทอร์เฟซการค้นหาแบบสนทนามากขึ้นเรื่อยๆ ทีมวิศวกรรมและทีมเติบโตจึงต้องประเมินวิธีที่ตนติดตามการได้มาซึ่งผู้ใช้ใหม่อีกครั้ง การวัดผลการแปลงในสภาพแวดล้อมการค้นหาที่ขับเคลื่อนด้วย AI จำเป็นต้องมีไปป์ไลน์ข้อมูลที่มีความสามารถในการประสานสัญญาณการค้นพบหลายช่องทางเข้ากับเหตุการณ์แอปพลิเคชันปลายทาง โดยทั่วไปองค์กรจะประเมินว่าจะสร้างฐานข้อมูลความสัมพันธ์ของเหตุการณ์ภายในองค์กรขึ้นมาเอง หรือจะนำแพลตฟอร์มการระบุแหล่งที่มาแบบหลายจุดสัมผัสที่เป็นมาตรฐานมาใช้
การประเมินสถาปัตยกรรม: ไปป์ไลน์ข้อมูลภายในองค์กรเทียบกับแพลตฟอร์มมาตรฐาน
การสร้างระบบระบุแหล่งที่มาแบบหลายจุดสัมผัสภายในองค์กรต้องอาศัยการจัดตั้งคลังข้อมูลที่ซับซ้อนเพื่อนำเข้าบันทึกเซิร์ฟเวอร์ (server logs) API webhooks และสัญญาณแพลตฟอร์มภายนอก ทีมวิศวกรรมต้องออกแบบโมเดลการระบุแหล่งที่มาเชิงอัลกอริทึมแบบกำหนดเอง จัดการการหมดเวลาของเซสชัน และอัปเดตไปป์ไลน์ข้อมูลอย่างต่อเนื่องเพื่อรองรับนโยบายความเป็นส่วนตัวของเบราว์เซอร์ที่เปลี่ยนแปลงไป ในทางกลับกัน การปรับใช้กรอบการทำงานการระบุแหล่งที่มาเฉพาะทางจะช่วยเพิ่มความคล่องตัวในการบูรณาการ โดยให้การรายงานที่เป็นอันหนึ่งอันเดียวกันทั่วทั้งจุดสัมผัสเว็บและมือถือที่บันทึกไว้โดยไม่มีภาระค่าใช้จ่ายในการบำรุงรักษาต่อเนื่อง
ตารางด้านล่างเปรียบเทียบแนวทางทางเทคนิคมาตรฐานสำหรับการจัดการการระบุแหล่งที่มาแบบหลายช่องทางและสถานะเซสชัน:
| โซลูชัน | จุดสัมผัสที่สังเกตได้ | ความต่อเนื่องข้ามแพลตฟอร์ม | ความเป็นเจ้าของทางวิศวกรรม | ดีที่สุดสำหรับ |
|---|---|---|---|---|
| การบันทึกเว็บแบบสัมผัสเดียว | เฉพาะคลิกโดยตรงเท่านั้น | ต่ำ (เฉพาะคุกกี้ไคลเอนต์) | ภายในองค์กรเป็นหลัก | พอร์ทัลเว็บรุ่นเก่าที่มีฟันเนลการแปลงโดยตรงอย่างง่าย |
| ฐานข้อมูล MTA ภายในองค์กร | สัญญาณที่บันทึกแบบกำหนดเอง | ผันแปรได้ (ไปป์ไลน์กำหนดเอง) | ภายในองค์กรทั้งหมด | ทีมองค์กรขนาดใหญ่ที่มีทรัพยากรวิศวกรรมข้อมูลโดยเฉพาะ |
| แพลตฟอร์มการระบุแหล่งที่มาบนมือถือและการฟื้นฟูบริบท | ช่องทางการตลาดที่บันทึกไว้ | สูง (ด้วยการบูรณาการ SDK) | ใช้ร่วมกัน / รองรับโดยผู้ขาย | การตลาดแบบ omnichannel, แอปมือถือ และฟันเนลหลายแคมเปญ |
ในจุดที่มีปฏิสัมพันธ์ซึ่งสามารถวัดผลได้—เช่น ลิงก์อ้างอิงที่มีการแท็ก หน้า Landing Page ของแคมเปญ การเปลี่ยนเส้นทางของพาร์ทเนอร์ หรือจุดสัมผัสอื่นๆ ที่บันทึกไว้—แพลตฟอร์มอย่าง OpoInstall สามารถรักษabบริบทแคมเปญที่มีอยู่ข้ามเส้นทางเว็บสู่แอปได้ผ่านการระบุแหล่งที่มาและการกำหนดเส้นทางพารามิเตอร์แบบรอการตัดบัญชี (deferred parameter routing) การรักษาสถานะพารามิเตอร์ของแคมเปญข้ามช่วงเปลี่ยนผ่านจากเว็บสู่แอปผ่านการกู้คืนสถานะฝั่งเซิร์ฟเวอร์ แนวทางนี้ช่วยสนับสนุนการวัดผลการแปลงที่แม่นยำยิ่งขึ้นทั่วทั้งฟันเนลหลายช่องทางที่บันทึกไว้ อย่างไรก็ตาม การกล่าวถึงของ AI แบบไม่ต้องคลิกยังคงเป็นปัญหาการวัดผลแยกต่างหาก เนื่องจากไม่มีเหตุการณ์การอ้างอิงในระดับผู้ใช้ที่จะเชื่อมโยงโดยตรงกับการแปลงที่เกิดขึ้นในท้ายที่สุด
รายการตรวจสอบการบูรณาการ: การสร้างการระบุแหล่งที่มาใหม่สำหรับเอ็นจิ้นตอบคำถาม
เพื่อปรับตัวให้เข้ากับการเติบโตของเครื่องมือค้นหาแบบสนทนาและเลเยอร์การค้นพบอัตโนมัติ ทีมเทคนิคและทีมการตลาดควรดำเนินเวิร์กโฟลว์การเก็บรวบรวมข้อมูลและการระบุแหล่งที่มาที่มีโครงสร้าง
รายการตรวจสอบการดำเนินงานสำหรับนักพัฒนา
- รวมศูนย์เหตุการณ์ที่สังเกตได้: ส่งเหตุการณ์บนเว็บ มือถือ CRM และพาร์ทเนอร์ที่วัดผลได้ไปยังไปป์ไลน์การวิเคราะห์ฝั่งเซิร์ฟเวอร์ทั่วไป เพื่อสร้างบันทึกที่เป็นอันหนึ่งอันเดียวกันของปฏิสัมพันธ์ที่สังเกตได้
- บูรณาการ SDK การเชื่อมโยงเชิงลึกแบบรอการตัดบัญชี (Deferred Deep Linking): ฝังไคลเอนต์ SDK ที่มีน้ำหนักเบาภายในแอปพลิเคชันมือถือเพื่อดึงและจับคู่พารามิเตอร์แคมเปญก่อนการติดตั้งเมื่อเปิดใช้งานครั้งแรก (cold launch)
- รักษาข้อมูลเมตาของแหล่งที่มา: รักษามิติข้อมูล UTM, รหัสผู้อ้างอิง, บริบทหน้า Landing Page และข้อมูลเมตาของแหล่งที่มาของพาร์ทเนอร์ทุกครั้งที่คลิกอ้างอิงที่สังเกตได้เกิดขึ้น
รายการตรวจสอบกลยุทธ์ผลิตภัณฑ์และการเติบโต
- เปลี่ยนไปสู่การระบุแหล่งที่มาแบบหลายจุดสัมผัส (MTA): ประเมินโมเดลการระบุแหล่งที่มาแบบหลายจุดสัมผัสเพื่อจัดสรรเครดิตข้ามปฏิสัมพันธ์ที่บันทึกไว้ทั้งหมด แทนที่จะพึ่งพาข้อมูลการคลิกครั้งสุดท้ายเพียงอย่างเดียว
- แยกการมองเห็นออกจากการระบุแหล่งที่มา: รายงานการอ้างอิง AI และการกล่าวถึงแบรนด์ในการสนทนาว่าเป็นเมตริกการมองเห็นส่วนบนของฟันเนล (upper-funnel visibility metrics) แทนที่จะบังคับให้เข้าสู่การระบุแหล่งที่มาของการแปลงแบบกำหนด
- ตรวจสอบความเร็วในการอ้างอิงแบรนด์: ติดตามความถี่ที่เอกสารของบริษัท ผลิตภัณฑ์ และบทความถูกอ้างถึงภายในผลลัพธ์การค้นหาแบบสนทนา เพื่อประเมินการรับรู้ตลาดในวงกว้าง
การดำเนินการตามแนวปฏิบัติเหล่านี้ช่วยให้องค์กรสามารถรักษาการมองเห็นที่ชัดเจนเหนือฟันเนลการได้มาซึ่งผู้ใช้ที่บันทึกไว้ ในขณะเดียวกันก็ยอมรับขอบเขตเชิงโครงสร้างของการค้นพบแบบไม่คลิก (zero-click discovery)
คำถามที่พบบ่อย (FAQ)
เหตุใด NVIDIA จึงพิจารณาลงทุนใน Perplexity?
การค้นหาแบบสนทนาขัดขวางทราฟฟิกการคลิกผ่านเว็บไซต์แบบดั้งเดิมอย่างไร?
ทีมงานควรวัดผลการระบุแหล่งที่มาอย่างไรเมื่อการค้นหาด้วย AI สร้างการค้นพบแบบไม่คลิก (zero-click discovery)?
ประเด็นสำคัญสำหรับทีมวิศวกรรม
การเจรจาลงทุนระหว่าง NVIDIA และ Perplexity ที่มีรายงานออกมาชี้ให้เห็นถึงการเปลี่ยนแปลงอย่างต่อเนื่องในวิธีการจัดทำดัชนี ดึงข้อมูล และสร้างรายได้จากข้อมูลดิจิทัล เนื่องจากเอ็นจิ้นตอบคำถามแบบสนทนาและเอเจนต์อัตโนมัติกลายเป็นเลเยอร์การค้นพบที่สำคัญมากขึ้นเรื่อยๆ ฟันเนลการคลิกบนเว็บแบบดั้งเดิมจึงจะจับภาพได้เพียงบางส่วนของเส้นทางลูกค้าทั้งหมดเท่านั้น
เพื่อรักษาการเติบโตในภูมิทัศน์ที่กำลังพัฒนานี้ ทีมวิศวกรรมและทีมเติบโตจะต้องปรับปรุงโครงสร้างพื้นฐานการระบุแหล่งที่มาให้ทันสมัย ด้วยการผสมผสานการระบุแหล่งที่มาแบบหลายจุดสัมผัส การรักษาสบริบทฝั่งเซิร์ฟเวอร์ และการส่งผ่านพารามิเตอร์แบบรอการตัดบัญชีสำหรับการเดินทางที่สังเกตได้ องค์กรต่างๆ จะสามารถวัดผลเส้นทางของลูกค้าที่บันทึกไว้ได้อย่างแม่นยำยิ่งขึ้น พร้อมทั้งใช้เมตริกแบบรวม (aggregate) การมองเห็น และวิธีการเพิ่มขึ้นเพื่อประเมินการค้นพบผ่าน AI ที่ขาดเหตุการณ์ที่เชื่อมโยงกันได้โดยตรง
Share this article



