Anthropic Sonnet 5.5 tăng tốc 30%? Anthropic đã chính thức phát hành Claude Sonnet 5.5, với báo cáo cho thấy tốc độ tạo phản hồi nhanh hơn 30% và chi phí trên mỗi tác vụ hoàn thành giảm tới 30%. Khi các nền tảng trí tuệ nhân tạo tạo sinh chuyển đổi từ nguyên mẫu thử nghiệm sang hệ thống sản xuất quy mô lớn, các đội ngũ kỹ thuật phần mềm đang đối mặt với áp lực lớn trong việc kiểm soát mức tiêu thụ token và độ trễ khi vận hành. Trước đây, các kiến trúc sư doanh nghiệp thường cho rằng để đạt được hiệu suất lập trình đỉnh cao, cần phải triển khai các mô hình lớn và đắt đỏ nhất. Ngày nay, vì các kiến trúc tầm trung được tối ưu hóa có thể giải quyết các thách thức kỹ thuật phần mềm phức tạp với ít bước vận hành và ít lệnh gọi công cụ hơn, nền tảng kinh tế cơ bản của các công cụ hỗ trợ phát triển tự động đang chuyển dịch theo hướng tối ưu hiệu suất thực thi.
Kinh tế vận hành: Tại sao chi phí hoàn thành tác vụ quan trọng hơn giá token
Điểm nổi bật
- Anthropic phát hành Claude Sonnet 5.5 vào ngày 28 tháng 9 năm 2026, mang lại tốc độ tạo phản hồi nhanh hơn 30% và giảm tới 30% chi phí cho mỗi tác vụ hoàn thành.
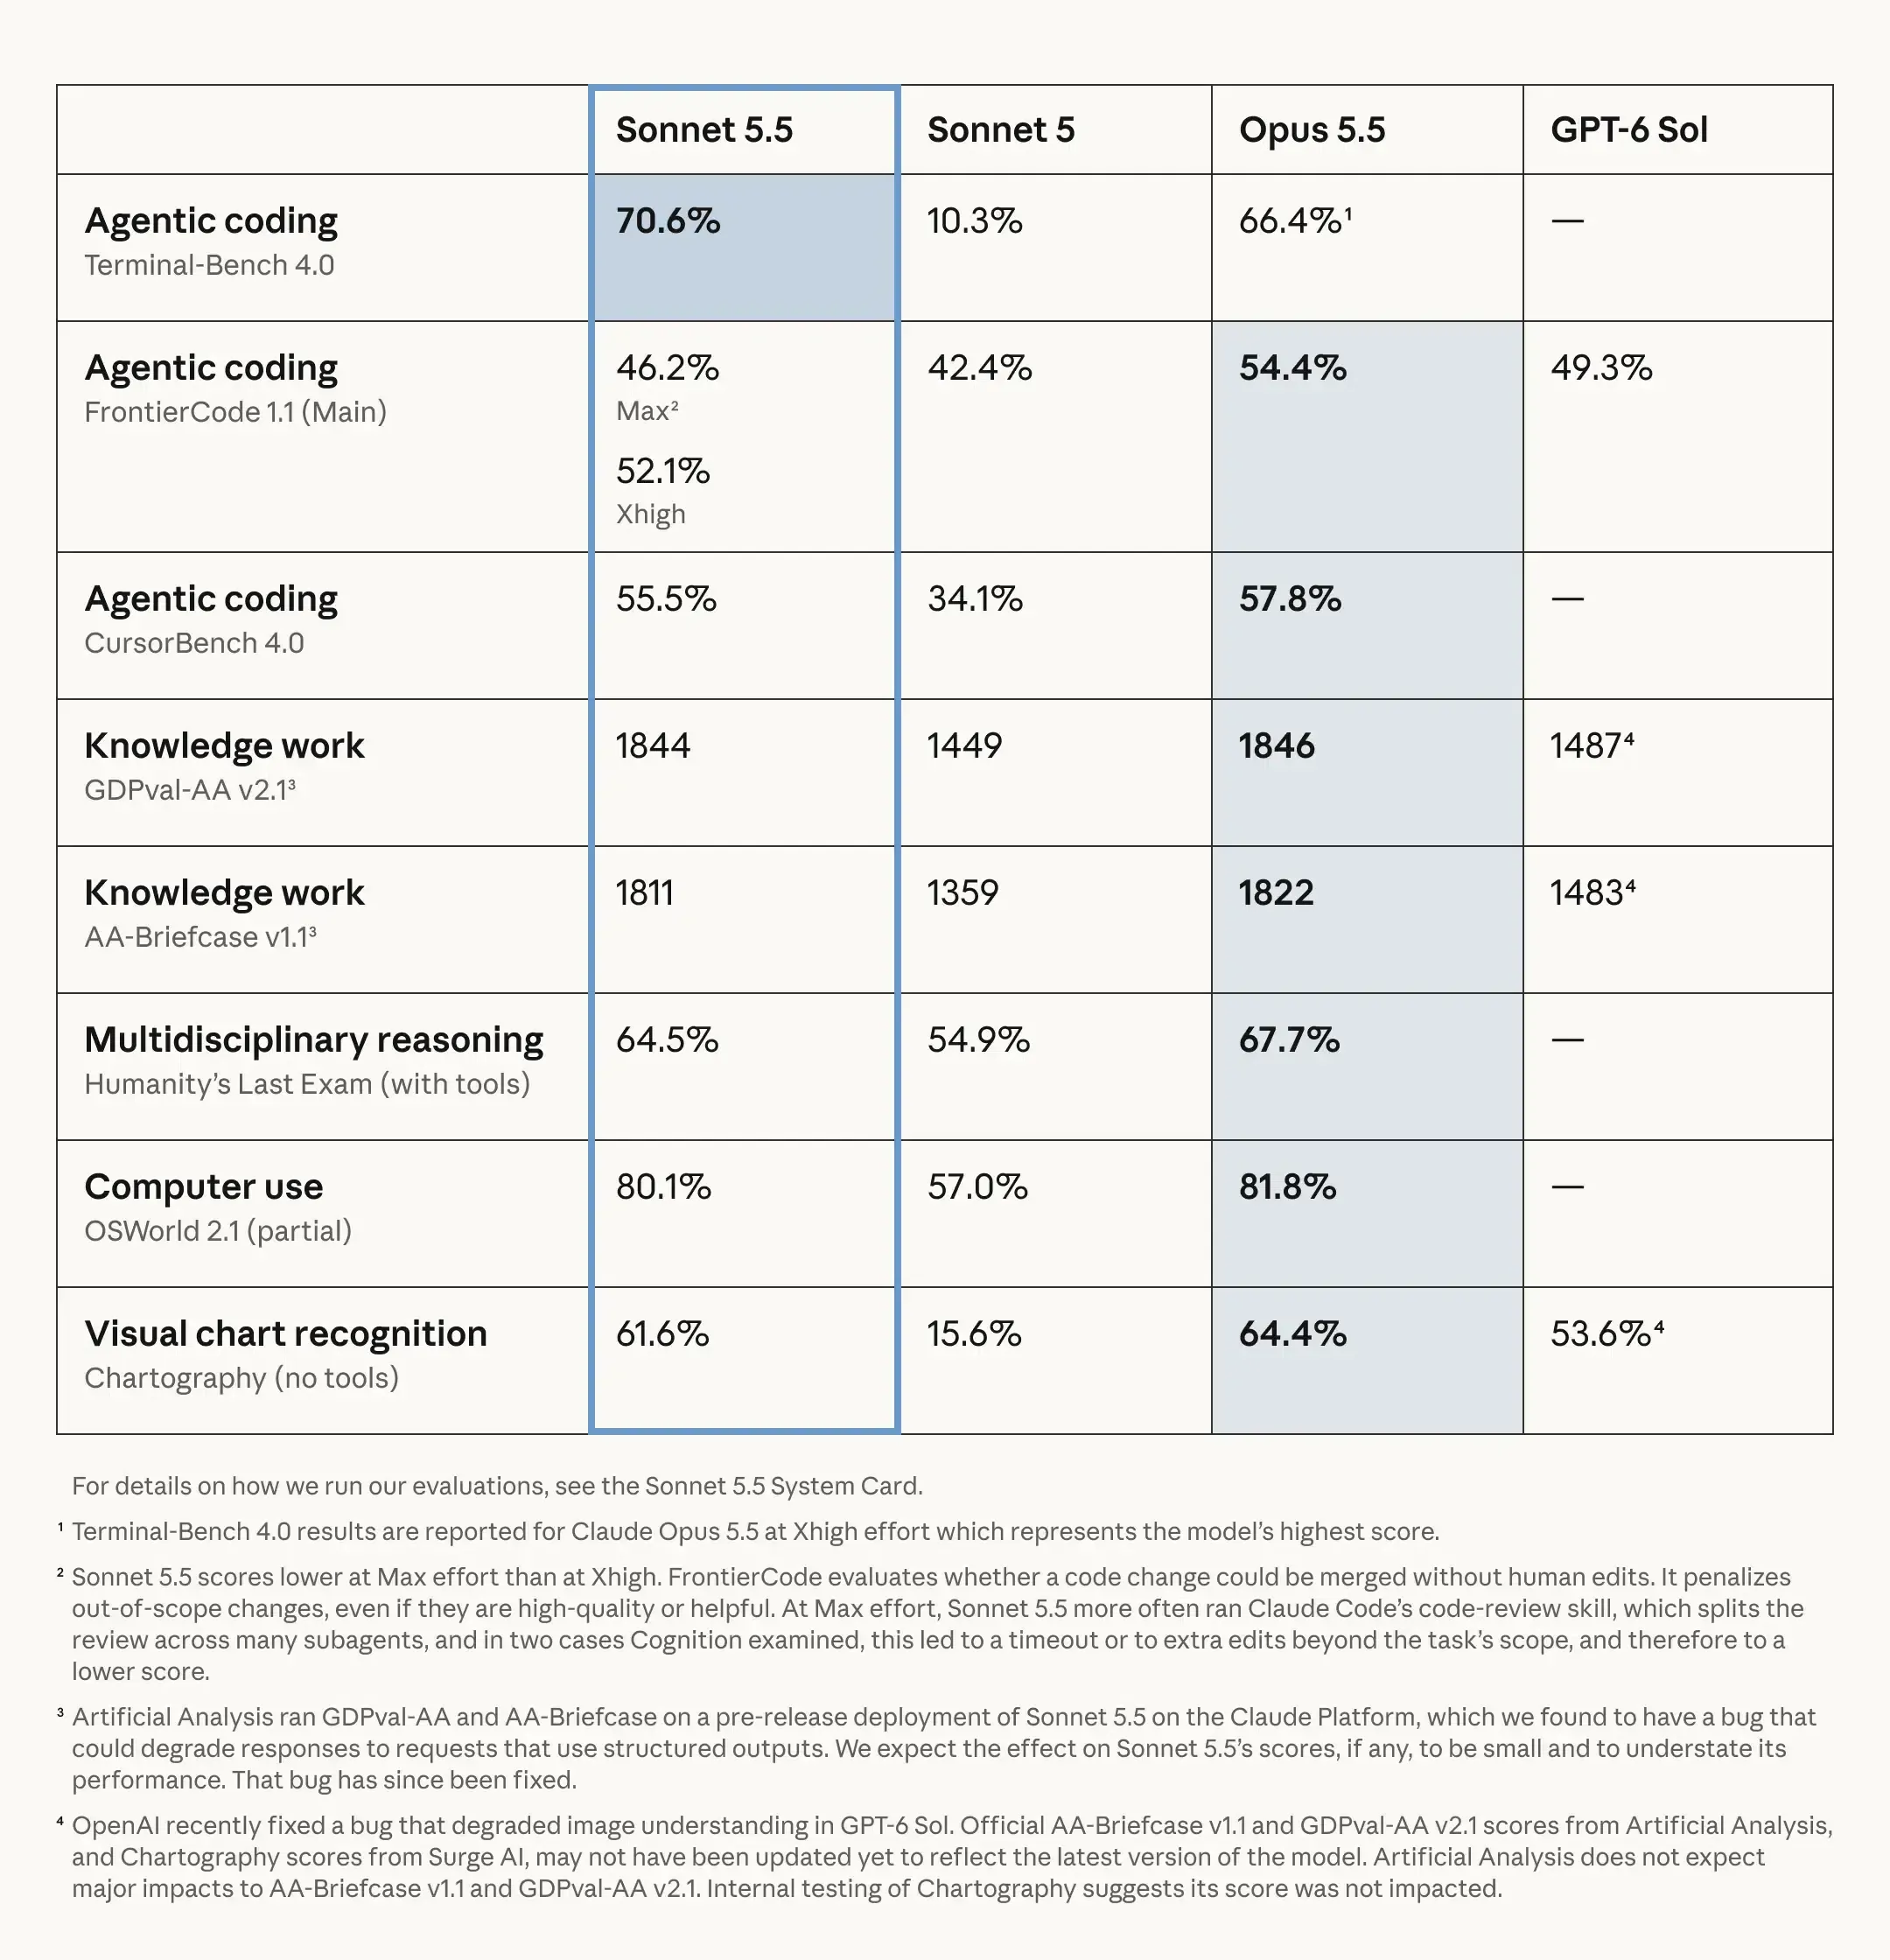
- Trong bài kiểm tra lập trình tác nhân Terminal-Bench 4.0, Sonnet 5.5 đạt 70,6%, vượt qua mô hình chủ lực Claude Opus 5.5 với 66,4% và Sonnet 5 với 10,3%.
- Giá token API vẫn ở mức $2 cho mỗi triệu token đầu vào và $10 cho mỗi triệu token đầu ra, đạt được mức giảm chi phí thông qua việc giảm số bước thực thi và gộp các lệnh gọi công cụ.
Tính khả thi về mặt thương mại trong việc triển khai các tác nhân kỹ thuật phần mềm tự động từ lâu đã gặp phải những rào cản kinh tế nghiêm trọng. Việc chạy các công cụ dành cho nhà phát triển với nhiều bước—như kiểm tra codebase, thực thi các lệnh shell và sửa lỗi unit test lặp đi lặp lại—tiêu tốn một lượng token khổng lồ. Mặc dù các mô hình hàng đầu thể hiện khả năng suy luận đáng kinh ngạc, nhưng chi phí token cao và độ trễ lớn khiến việc thực thi liên tục mà không cần giám sát trở nên đắt đỏ đối với các doanh nghiệp phần mềm đang phát triển.
Khi đánh giá cơ sở hạ tầng cho nhà phát triển, mức giá API niêm yết thường làm lu mờ chi phí thực tế để hoàn thành công việc. Một mô hình có giá mỗi token thấp nhưng phải thực hiện hàng chục lệnh gọi công cụ lặp đi lặp lại và thử lại nhiều lần cuối cùng sẽ tốn kém hơn đáng kể so với một mô hình giải quyết vấn đề trong ít bước thực thi hơn. Động lực này đã được phân tích trong các báo cáo ngành về Sonnet 5.5, nhấn mạnh cách chi phí hoàn thành tác vụ đang dần tách biệt khỏi mức giá niêm yết của token.
Anthropic đã thiết kế Claude Sonnet 5.5 để giải quyết trực tiếp các nút thắt vận hành này. Trong khi vẫn duy trì mức giá API cơ bản là $2 cho mỗi triệu token đầu vào và $10 cho mỗi triệu token đầu ra, mô hình này đạt mức giảm tới 30% chi phí tác vụ ròng nhờ yêu cầu ít bước suy luận hơn đáng kể. Các báo cáo kiểm thử của khách hàng được Anthropic công bố làm nổi bật những hiệu quả đáng kể trong các khối lượng công việc sản xuất:
- Box báo cáo rằng Sonnet 5.5 hoạt động nhanh hơn 2,4 lần trong khi sử dụng ít hơn 12% tổng số token để kiểm tra lại tài liệu nguồn và xác định các lỗi hồi quy trong mã.
- Zendesk quan sát thấy các phiếu hỗ trợ được xử lý nhanh hơn 20% cùng với ít sai sót quyết định tự động hơn so với các mô hình sản xuất hiện có.
- Slack chứng minh rằng mô hình này hoạt động vượt trội so với Sonnet 5 trong các bài đánh giá bot ngoại tuyến mà không cần thay đổi prompt, tiêu thụ ít hơn khoảng 14% token đầu ra.
- Lovable nhận thấy Sonnet 5.5 yêu cầu ít hơn khoảng một phần ba số lệnh gọi công cụ và một nửa số lệnh thực thi shell trong quá trình xây dựng ứng dụng tự động.
- Base44 xác minh rằng mô hình hoàn thành quá trình xây dựng ứng dụng đầy đủ trung bình trong 3,6 vòng lặp, so với 7,7 vòng lặp đối với Opus 5.
Những kết quả này minh họa cách hiệu quả thực thi thay đổi cơ bản năng suất của nhà phát triển. Bằng cách giảm các lệnh gọi công cụ thất bại và loại bỏ các vòng lặp dư thừa, các mô hình tầm trung cung cấp nền tảng bền vững cho quá trình tự động hóa doanh nghiệp liên tục.
Phân tích kỹ thuật: Đánh giá tiêu chuẩn lập trình và mở rộng tác nhân phụ
Sự xuất hiện của các mô hình tầm trung vượt trội hơn các mô hình hàng đầu trên các tiêu chuẩn kỹ thuật cụ thể phản ánh sự thay đổi trong quá trình hậu huấn luyện các mô hình nền tảng. Các quy luật mở rộng ban đầu cho thấy số lượng tham số thô là yếu tố quyết định chính đến trí thông minh của mô hình. Tuy nhiên, các tác vụ tác nhân phức tạp—như điều hướng môi trường terminal và chỉnh sửa các kho mã nguồn lớn—phụ thuộc rất nhiều vào quản lý ngữ cảnh, kỷ luật sử dụng công cụ chính xác và kiểm soát phạm vi.
Các mô hình hàng đầu như Opus 5.5 sở hữu năng lực suy luận to lớn, vượt trội trong các quyết định kiến trúc mơ hồ và không giới hạn. Tuy nhiên, chiều sâu suy luận quá mức đôi khi có thể tạo ra chi phí vận hành cho các tác vụ được xác định chặt chẽ. Ví dụ, trong các bài đánh giá FrontierCode, Anthropic lưu ý rằng Sonnet 5.5 ở nỗ lực tối đa (Max) đạt điểm thấp hơn so với nỗ lực cao (Xhigh) vì nó thường xuyên gọi kỹ năng đánh giá mã của Claude Code. Kỹ năng này chia nhỏ các đánh giá trên nhiều tác nhân phụ, dẫn đến các trường hợp bị quá thời gian hoặc các chỉnh sửa ngoài phạm vi bị phạt bởi hệ thống đánh giá. Ngược lại, Sonnet 5.5 chạy ở nỗ lực tiêu chuẩn đặc biệt phù hợp với việc thực thi có giới hạn và phạm vi rõ ràng: nó phân tích nhanh cấu trúc kho mã, đánh giá các thay đổi được đề xuất và vận hành trong phạm vi tệp được xác định.
Sự tương đương về tiêu chuẩn: Terminal-Bench, CursorBench và GDPval-AA
Các đánh giá được Anthropic công bố cho thấy Sonnet 5.5 đạt hoặc vượt qua các tiêu chuẩn hàng đầu trong các lĩnh vực kỹ thuật thông thường. Trên Terminal-Bench 4.0, đánh giá khả năng giải quyết vấn đề dòng lệnh gồm nhiều bước, Sonnet 5.5 đạt 70,6%, vượt qua Opus 5.5 với 66,4% và Sonnet 5 với 10,3%. Trên CursorBench 4.0, được rút ra từ các phiên làm việc thực tế của nhà phát triển Cursor, Sonnet 5.5 đạt 55,5%, chỉ kém Opus 5.5 (57,8%) hơn hai phần trăm. Hơn nữa, trên GDPval-AA v2.1, đo lường các tác vụ chuyên môn thực tế trên 44 ngành nghề, Sonnet 5.5 đạt điểm Elo là 1844, bám sát Opus 5.5 ở mức 1846.
Để xem xét cách các mô hình tinh gọn tối ưu hóa việc thực thi tự động, hãy cân nhắc sự khác biệt trong quy trình làm việc:
[Vòng lặp tác nhân hàng đầu nguyên khối]
  Yêu cầu người dùng ──> Chuỗi suy luận nặng ──> Gọi công cụ dàn trải (Tiêu tốn nhiều token) ──> Rủi ro chỉnh sửa quá mức & quá thời gian

[Vòng lặp tác nhân tầm trung tinh gọn]
  Yêu cầu người dùng ──> Ánh xạ ý định có phạm vi ──> Gọi công cụ theo đợt ──> Ít bước thực thi hơn ──> Bản vá ngắn gọn được phân phối
Vòng lặp thực thi tinh gọn này có thể giảm các cơ hội làm chệch hướng ngữ cảnh và các vòng lặp mạng không cần thiết. Anthropic báo cáo tốc độ tạo phản hồi nhanh hơn 30%+ cùng với số bước giảm so với Sonnet 5. Mô hình thực hiện gộp các lệnh gọi công cụ lại với nhau, giảm thiểu độ trễ mạng giữa runtime của tác nhân và môi trường máy chủ.
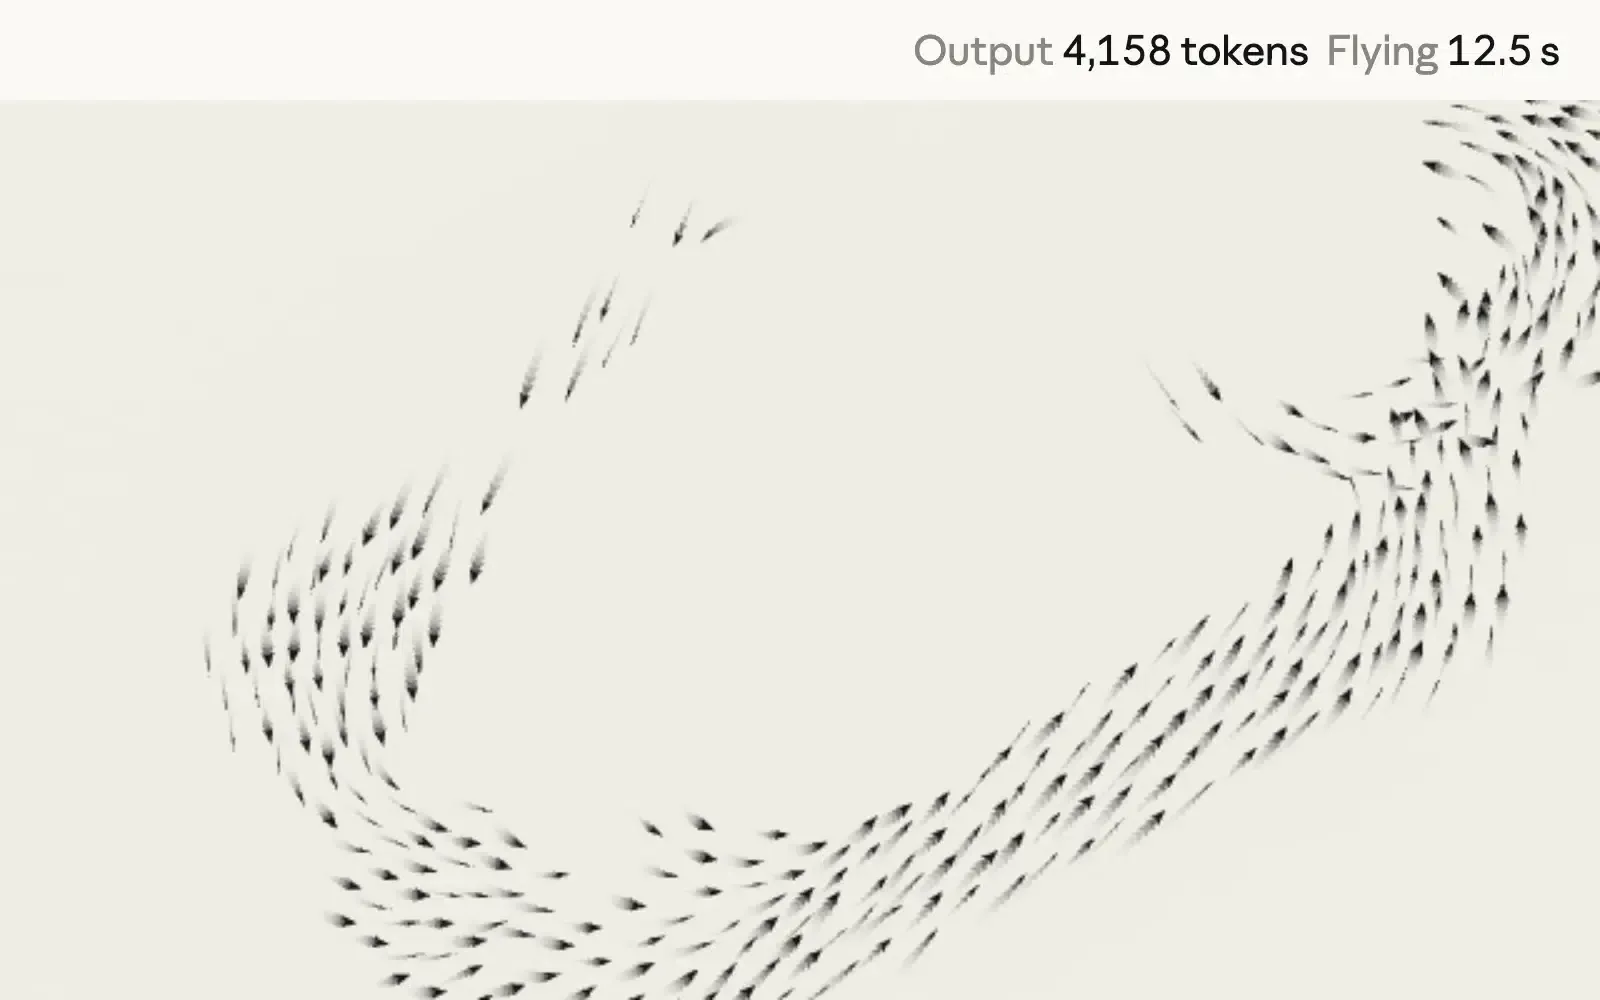
Sonnet 5.5 cũng giới thiệu cơ sở hạ tầng an toàn cấp một vào danh mục tầm trung. Đây là biến thể Sonnet đầu tiên được triển khai với các biện pháp bảo vệ an ninh mạng tương tự như Opus 5.5. Các tác vụ phát hiện lỗ hổng rủi ro cao sẽ tự động chuyển về các kiến trúc cũ hơn, trong khi những người bảo vệ được phê duyệt nhận được các quyền truy cập theo tầng thông qua Chương trình Xác minh An ninh mạng (Cyber Verification Program). Ngoài ra, hệ thống kết hợp các bộ phân loại an toàn được thiết kế để giảm thiểu việc trích xuất suy luận quy mô công nghiệp và giữ cho tư duy được bảo tồn gắn liền với tài khoản gốc.
Chiến lược kiến trúc: Phân bổ khối lượng công việc giữa các mô hình hàng đầu và tầm trung
Khi các mô hình nền tảng AI phân tách thành các công cụ suy luận cực sâu và các mô hình thực thi linh hoạt, các lãnh đạo kỹ thuật phải đánh giá lại cách họ phân bổ các cấp độ mô hình trong vòng đời phát triển phần mềm. Việc triển khai một mô hình hàng đầu duy nhất trên toàn bộ đường ống kỹ thuật gây ra độ trễ và chi phí không cần thiết. Thay vào đó, cơ sở hạ tầng nhà phát triển hiện đại ngày càng dựa vào việc định tuyến mô hình động, phân công các tác vụ dựa trên độ phức tạp về cấu trúc.
Khi thiết kế quy trình sản xuất, các đội ngũ phải cân nhắc giữa suy luận khái niệm sâu sắc và giải quyết tác vụ thông lượng cao. Trong khi các mô hình hàng đầu vẫn không thể thiếu cho việc lập kế hoạch kiến trúc rộng lớn, các mô hình trung gian xử lý phần lớn công việc thực thi mã hàng ngày với khả năng phản hồi vượt trội.
Ma trận quyết định sau đây phác thảo sự liên kết kỹ thuật giữa các cấp độ mô hình:
| Danh mục khối lượng công việc | Lựa chọn mô hình chính | Hồ sơ chi phí | Hồ sơ độ trễ | Tốt nhất cho |
|---|---|---|---|---|
| Sửa lỗi thông thường & Đánh giá PR | Claude Sonnet 5.5 | Thấp ($2 / $10 mỗi 1 triệu token) | Nhanh (tạo phản hồi nhanh hơn 30%+) | Các tác vụ phần mềm hàng ngày có phạm vi rõ ràng và kiểm tra CI/CD khối lượng lớn |
| Kiến trúc Codebase toàn diện & Di chuyển | Claude Opus 5.5 | Cao ($4 / $20 mỗi 1 triệu token) | Các chu kỳ suy luận sâu, thích ứng | Tái cấu trúc phức tạp, mơ hồ trên các kho mã nguồn lớn |
| Tạo nguyên mẫu tương tác & Thiết kế UI | Claude Sonnet 5.5 | Thấp ($2 / $10 mỗi 1 triệu token) | Lặp lại nhanh, phản hồi tốt | Thiết kế luồng người dùng, tạo biểu đồ và khung giao diện người dùng |
| Nghiên cứu an ninh mạng nâng cao | Các mô hình Claude có xác thực | Phụ thuộc vào mô hình và cấp độ truy cập | Xác minh nhiều bước kỹ lưỡng | Nghiên cứu bảo mật rủi ro cao được ủy quyền theo các chương trình xác minh của Anthropic |
Anthropic xây dựng các khả năng an ninh mạng thông qua các biện pháp bảo vệ theo tầng. Trong khi việc khắc phục lỗ hổng thông thường diễn ra bình thường trên Sonnet 5.5, các tác vụ bảo mật rủi ro cao hơn sẽ tự động chuyển về các kiến trúc cũ hơn. Đối với những người bảo vệ được ủy quyền thực hiện nghiên cứu bảo mật nâng cao, quyền truy cập vào các khả năng mở rộng trên khắp các mô hình Sonnet 5.5, Opus 5.5 và Mythos được quản lý thông qua Chương trình Xác minh An ninh mạng nhiều tầng.
Bằng cách thiết lập các quy tắc định tuyến động, các tổ chức kỹ thuật có thể hướng các đánh giá yêu cầu kéo (pull request), tạo unit test và bản địa hóa lỗi đến Sonnet 5.5. Điều này bảo toàn năng lực Opus hàng đầu cho việc tái cấu trúc kiến trúc có độ phức tạp cao, giữ cho ngân sách kỹ thuật có thể dự đoán được mà không ảnh hưởng đến độ tin cậy của phần mềm.
Danh sách kiểm tra tích hợp: Vận hành Sonnet 5.5 trong CI/CD của doanh nghiệp
Khi các tổ chức phần mềm kết hợp các mô hình tốc độ cao, chi phí thấp như Sonnet 5.5 vào các đường ống sản xuất, các nhóm kỹ thuật phải thiết lập các lịch trình quản trị mạnh mẽ. Việc tối đa hóa tiết kiệm chi phí đòi hỏi phải căn chỉnh các cài đặt tham số API với độ phức tạp của tác vụ trong khi ngăn chặn sự trệch hướng của tác nhân không được giám sát.
Danh sách kiểm tra triển khai cho nhà phát triển
- Cấu hình mức nỗ lực động: Sử dụng các cài đặt nỗ lực gốc của mô hình—mặc định là Trung bình trong các ứng dụng Claude và Claude Code, và Cao trên Nền tảng Claude—để cân bằng giữa chiều sâu suy luận và chi phí token.
- Tận dụng lưu trữ cache prompt: Triển khai lưu trữ cache prompt trên các system prompt tĩnh và bản đồ kho mã nguồn để đảm bảo mức giảm giá 90% cho các token đọc từ cache ($0,20 mỗi triệu token).
- Triển khai xử lý theo đợt không đồng bộ: Định tuyến các đánh giá không theo thời gian thực, kiểm toán mã tự động và di chuyển theo đợt thông qua các API theo đợt để đạt mức giảm 50% chi phí token tiêu chuẩn.
- Tích hợp các cơ chế dự phòng an toàn (Fail-Safe): Thiết lập các bộ ngắt mạch lập trình để chấm dứt hoặc định tuyến lại yêu cầu một cách an toàn nếu các vòng lặp công cụ tự động vượt quá ngân sách lặp đã xác định trước.
Danh sách kiểm tra quản trị & cơ sở hạ tầng
- Đánh giá lại đơn vị kinh tế đăng ký: Tính toán chi phí tính toán biên trên mỗi nhà phát triển đang hoạt động để xác định liệu các mô hình tầm trung tốc độ cao có cho phép cung cấp hạn mức sử dụng cao hơn hoặc giá cấp thấp hơn hay không.
- Theo dõi tỷ lệ lặp lại: Đo lường số lượng thực thi công cụ trung bình cần thiết để giải quyết các tác vụ của người dùng; việc giảm số lượng vòng lặp trực tiếp cải thiện mức độ hài lòng của nhà phát triển.
- Cấu hình xử lý tại Hoa Kỳ khi cần thiết: Đối với các khách hàng doanh nghiệp được quản lý có yêu cầu cư trú dữ liệu trong nước, hãy cấu hình các điểm cuối suy luận chỉ tại Hoa Kỳ (có sẵn ở mức giá 1,1x theo các điều khoản doanh nghiệp đủ điều kiện).
- Xác minh tính đủ điều kiện về việc không lưu giữ dữ liệu: Xác nhận trạng thái không lưu giữ dữ liệu với nhà cung cấp API, đảm bảo tuân thủ doanh nghiệp trong khi lưu ý rằng các tính năng chuyên biệt như cache prompt cố định có thể hoạt động theo các điều khoản lưu giữ dữ liệu riêng biệt.
Bằng cách áp dụng các thực tiễn vận hành có cấu trúc này, các tổ chức phần mềm có thể chuyển đổi tốc độ thuật toán và hiệu quả token thành những thành quả phát triển có thể dự đoán được.
Các câu hỏi thường gặp (FAQ)
Tại sao Sonnet 5.5 có chi phí mỗi tác vụ thấp hơn nếu giá mỗi token tương đương với Sonnet 5?
Claude Sonnet 5.5 có thể thay thế Opus 5.5 trong kỹ thuật phần mềm không?
Lưu trữ cache prompt ảnh hưởng như thế nào đến chi phí vận hành trong các tác nhân lập trình?
Bài học chính cho các nhóm kỹ thuật
Việc phát hành Claude Sonnet 5.5 phản ánh sự tiến hóa của ngành từ việc mở rộng tham số không giới hạn sang hiệu quả tác vụ vận hành. Các nền tảng kỹ thuật phần mềm thông lượng cao không nhất thiết phải yêu cầu chi phí tính toán của các mô hình hàng đầu cho mọi giai đoạn vận hành. Khi một mô hình trung gian giải quyết ổn định các tác vụ codebase trong ít vòng lặp hơn, việc phát triển phần mềm tự động trở nên hiệu quả về chi phí hơn đáng kể để triển khai ở quy mô lớn.
Việc tận dụng những hiệu quả này đòi hỏi phải thiết lập kiến trúc có kỷ luật: định tuyến tác vụ một cách linh hoạt dựa trên độ phức tạp, thực thi các ranh giới sử dụng công cụ và áp dụng hệ thống lưu trữ cache prompt một cách bài bản. Khi các nhà cung cấp mô hình nền tảng tiếp tục tối ưu hóa hiệu quả token song song với khả năng suy luận thô, các nhóm kỹ thuật thiết kế các đường ống mô-đun, có giám sát chi phí sẽ duy trì các quy trình sản xuất bền vững và có khả năng mở rộng tốt nhất.
Tài liệu tham khảo
-
Anthropic. Giới thiệu về Claude Sonnet 5.5.
-
Anthropic. Thẻ hệ thống Claude Sonnet 5.5.
-
Anthropic. Giá API Claude và Cư trú dữ liệu.
-
Anthropic. Điều khoản thương mại dịch vụ và Chính sách lưu giữ dữ liệu.
-
VentureBeat. Anthropic ra mắt Claude Sonnet 5.5 với mức giảm 30% chi phí cho mỗi tác vụ.
-
TechCrunch. Anthropic phát hành Sonnet 5.5 như một đối tác công việc nhanh hơn và rẻ hơn đáng kể.
-
9to5Mac. Anthropic nâng cấp Claude với mô hình Sonnet 5.5 mới.
Share this article



