Cloudflare Chặn Bot Đào tạo? Cloudflare đã công bố một chính sách mặc định mới nhằm chặn các trình thu thập dữ liệu (crawlers) đào tạo AI trên các trang web xuất bản hợp lệ, đồng thời giới thiệu các tùy chọn kiếm tiền mới cho chủ sở hữu nội dung. Khi trí tuệ nhân tạo tạo sinh làm thay đổi cách tiêu thụ nội dung trên web, các nền tảng AI vẫn tiếp tục tiêu thụ một lượng lớn tài nguyên web mà không thiết lập cấu trúc giá trị tương xứng. Trước đây, việc cho phép lập chỉ mục trên công cụ tìm kiếm đồng nghĩa với việc nhận được lưu lượng truy cập giới thiệu, từ đó có thể kiếm tiền thông qua quảng cáo hoặc đăng ký thuê bao. Ngày nay, vì các trình thu thập dữ liệu hỗn hợp liên tục quét dữ liệu độc quyền để đào tạo mô hình, đồng thời tạo ra các bản tóm tắt trực tiếp làm bỏ qua nhu cầu nhấp chuột, các nhà xuất bản phải đối mặt với tình trạng sụt giảm doanh thu nghiêm trọng.
Vấn đề vận hành & Thách thức tài chính: Cloudflare chặn bot đào tạo trên các trang hỗ trợ quảng cáo
Điểm tin nhanh
- Các lá chắn tự động sẽ khởi tạo chính sách hạn chế mặc định đối với hoạt động thu thập dữ liệu mô hình và các tác nhân lập trình trong các thư mục nội dung có kiếm tiền từ quý ba năm hai nghìn hai mươi sáu.
- Các trình thu thập dữ liệu kết hợp giữa lập chỉ mục tìm kiếm và thu hoạch dữ liệu sẽ bị hạn chế trừ khi chúng tách biệt mục đích hoạt động thành các luồng xử lý riêng biệt.
- Các khung cơ chế bù đắp giá trị sử dụng mới đang nổi lên để cung cấp phần thưởng trực tiếp theo giao dịch cho các quản trị viên nội dung thay vì tính theo số lượng yêu cầu tiêu chuẩn.
Sự cân bằng truyền thống giữa các nhà xuất bản trực tuyến và các trình thu thập dữ liệu web tự động đã hoàn toàn bị phá vỡ. Một thỏa thuận ngầm đã duy trì Internet toàn cầu trong suốt gần 30 năm qua. Theo thỏa thuận cơ bản này, các quản trị viên web hoan nghênh các bot thu thập dữ liệu ghé thăm trang để nhận lại các lượt nhấp chuột từ người dùng thực thông qua kết quả tìm kiếm. Sự trao đổi qua lại này đã nuôi dưỡng các đơn vị truyền thông tự chủ, đảm bảo rằng lượt hiển thị quảng cáo, tài trợ kỹ thuật số và tư cách thành viên định kỳ có thể tài trợ cho các tài liệu phần mềm độc lập và báo chí.
Sự chuyển dịch hiện nay hướng tới các mạng lưới tạo sinh quy mô lớn đã định hình lại hoạt động của trình thu thập dữ liệu, chuyển mục tiêu từ khám phá đường dẫn sang trích xuất dữ liệu. Các hệ thống thu thập tự động hiện nay tiếp nhận toàn bộ các thư mục kỹ thuật số, phân tích dữ liệu ngữ nghĩa và cung cấp thông tin tổng hợp trong các widget chat đóng. Giải pháp tức thời này bỏ qua nhu cầu truy cập trang web thông thường. Các đánh giá cho thấy khi giao diện tìm kiếm trình bày kết quả tạo sinh tích hợp, khả năng người đọc nhấp vào liên kết ngoài của thư mục thấp hơn đáng kể, giảm xuống dưới mức một con số trong nhiều trường hợp được báo cáo. Các mô hình lưu lượng truy cập này tạo ra sự thiếu hụt ngân sách ngay lập tức cho các nền tảng phụ thuộc vào cấu trúc quảng cáo tiêu chuẩn để bù đắp chi phí vận hành.
Tại sao việc Cloudflare chặn bot đào tạo trở thành yêu cầu bắt buộc đối với nhà xuất bản
Các nhà xuất bản từ lâu đã phải đối mặt với sự đánh đổi khó khăn giữa việc bảo vệ nội dung và duy trì khả năng hiển thị trên công cụ tìm kiếm. Nếu một chủ sở hữu trang web độc lập chặn Googlebot, Applebot hoặc Bingbot để ngăn chặn việc đào tạo mô hình, họ sẽ đối mặt với rủi ro biến mất khỏi các chỉ mục tìm kiếm truyền thống. Độc quyền cấu trúc này buộc người tạo nội dung phải đưa ra lựa chọn khó khăn: từ bỏ dữ liệu độc quyền có giá trị miễn phí hoặc chấp nhận hy sinh hoàn toàn khả năng được tìm thấy. Động thái này cũng khuyến khích các thực thể AI mới nổi sử dụng các chiến thuật thu thập dữ liệu lách luật, làm tăng thêm tải trọng máy chủ cho các nhà xuất bản vốn đã phải trả chi phí cho các yêu cầu dư thừa.
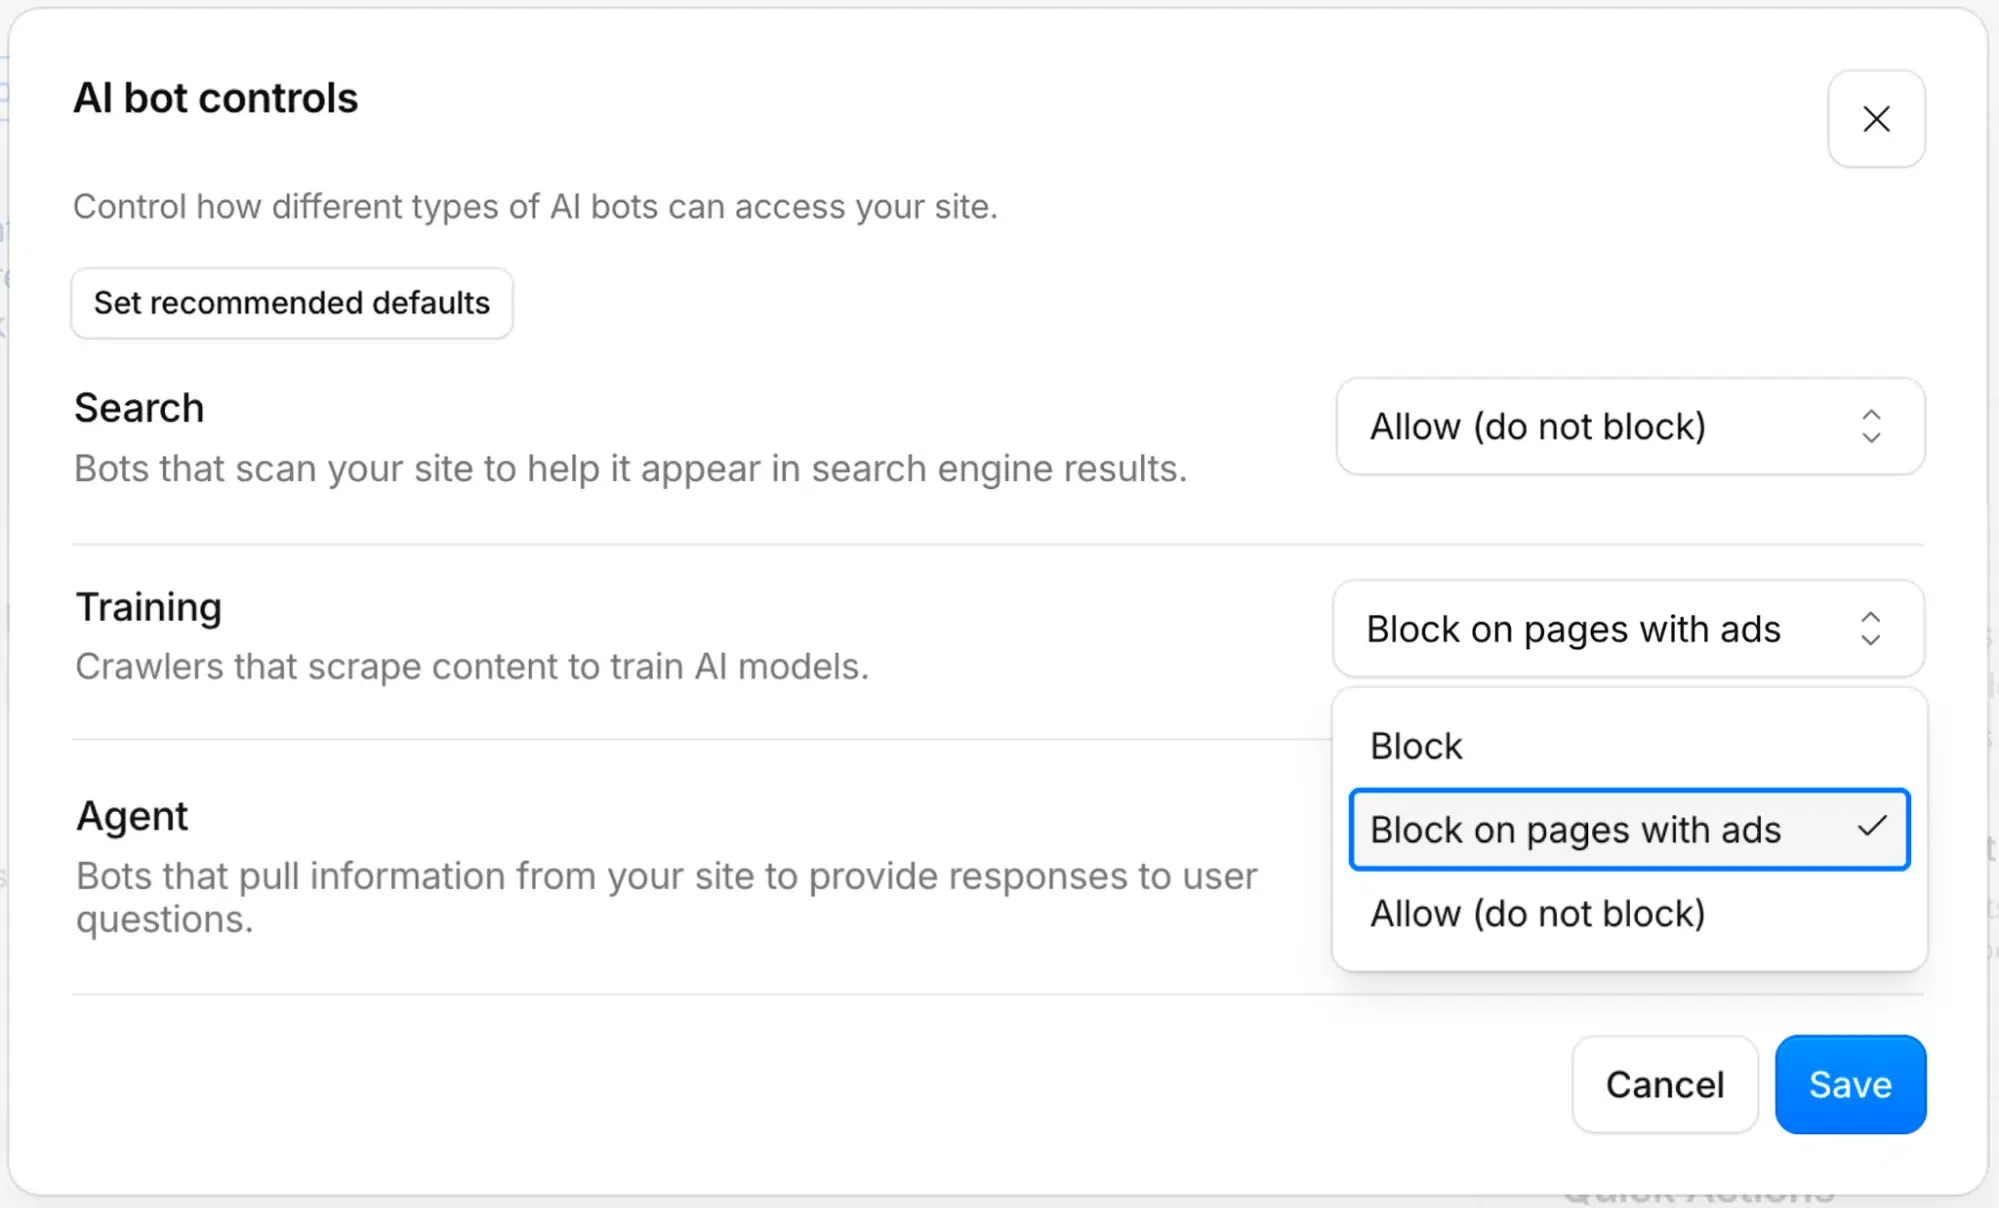
Để tái lập sự cân bằng, Cloudflare đã giới thiệu một cơ chế kiểm soát khai báo. Cloudflare cho biết chính sách mặc định sẽ bắt đầu triển khai vào ngày 15 tháng 9 năm 2026, thiết lập các chặn mặc định đối với bot đào tạo và các tác nhân hướng người dùng trên tất cả các trang của khách hàng có hỗ trợ quảng cáo. Cập nhật này đảm bảo rằng nội dung có khả năng kiếm tiền không thể bị thu thập nếu không có sự cho phép rõ ràng. Đồng thời, gã khổng lồ mạng này đang tái cấu trúc khuôn khổ kiếm tiền của mình, chuyển từ kiến trúc Pay Per Crawl (trả phí theo lượt quét) cũ sang hệ sinh thái Pay Per Use (trả phí theo lượt sử dụng) định hướng kết quả. Thông qua việc tích hợp với các nền tảng như You.com và Ceramic.ai, các nhà xuất bản có thể đảm bảo nhận được khoản bù đắp trực tiếp bất cứ khi nào một tác nhân AI sử dụng nội dung của họ để trả lời truy vấn, từ đó tạo ra một dòng doanh thu bền vững ở cấp độ giao dịch.
Nguyên nhân gốc rễ mang tính hệ thống & Chuỗi yêu cầu phi hình ảnh của chính sách Cloudflare chặn bot đào tạo
Phân tích thành phần vật lý của lưu lượng truy cập Internet cho thấy các bot tự động hiện chiếm hơn 50% tổng hoạt động trực tuyến. Khối lượng này gây áp lực rất lớn lên các máy chủ nguồn, đặc biệt là do các yêu cầu trùng lặp thường tải lại nội dung không thay đổi. Dữ liệu từ Cloudflare chỉ ra rằng hơn một nửa lưu lượng truy cập của trình thu thập dữ liệu đã được xác minh là hoàn toàn dư thừa, gây lãng phí sức mạnh tính toán ở cả hai đầu kết nối. Vấn đề cơ bản nằm ở kiến trúc nền tảng của các hoạt động tìm kiếm và quét hiện đại, vốn dựa vào các bot đa năng che giấu ý định thực sự của chúng.
Ở lớp ứng dụng, đặc điểm kỹ thuật của một tác nhân hướng người dùng khác biệt đáng kể so với các phiên duyệt web do con người điều khiển thông thường. Sự khác biệt này rất quan trọng vì các trình thu thập không đầu (headless scrapers) hiện đại bỏ qua hoàn toàn các yếu tố tương tác truyền thống, gây ra sự gián đoạn nghiêm trọng trong việc theo dõi trên các hệ thống đo lường hạ nguồn.
Ngắt kết nối giao thức: Tác nhân không trạng thái so với trình duyệt web có trạng thái
Tối ưu hóa web truyền thống giả định rằng các phiên duyệt web tiêu chuẩn quản lý trạng thái thông qua ngăn xếp cookie, lưu trữ cục bộ và chuỗi User-Agent có cấu trúc. Ngược lại, các tác nhân tự động và trình thu thập dữ liệu không đầu thực hiện các yêu cầu HTTP không trạng thái. Sự khác biệt này làm hỏng các luồng đo lường mà các nhà xuất bản sử dụng để chứng minh giá trị quảng cáo của họ. Sơ đồ dưới đây phác thảo những khác biệt cốt lõi ở lớp ứng dụng:
[Phiên duyệt web chuẩn]
  Trình duyệt người dùng (Trạng thái bền vững & Cookie) ──> Yêu cầu HTTP Web ──> Lượt hiển thị quảng cáo & Referrer được đăng ký


[Phiên tác nhân không trạng thái]
  Trình thu thập tự động (HTTP không trạng thái / Công cụ không đầu) ──> Truy vấn cô lập ──> Mất Referrer & Mất phân bổ
Khi một tác nhân trình duyệt tự động tìm nạp một trang, xử lý văn bản và đưa ra câu trả lời trong môi trường chat đóng, toàn bộ ngữ cảnh phía khách hàng (client-side) sẽ bị hủy hoại. Các tập lệnh theo dõi truyền thống không thể thực thi. Không có lượt hiển thị quảng cáo nào được ghi lại và các tiêu đề Referrer tiêu chuẩn biến mất. Điều này tạo ra một khoảng trống phân bổ nơi nhà xuất bản cung cấp giá trị thông tin thô, nhưng hệ thống hạ nguồn lại ghi nhận bằng không về mức độ tương tác. Sự mất mát ngữ cảnh trình duyệt tương tự cũng ảnh hưởng đến quy trình phân bổ di động hạ nguồn khi người dùng cuối cùng cài đặt ứng dụng. Do các lượt truy cập không đầu này thiếu các vùng chứa theo dõi trạng thái, các công cụ đo lường di động tiêu chuẩn không thể khớp sự kiện khám phá ban đầu với việc cài đặt ứng dụng sau đó. Động thái này đẩy nhanh sự sụp đổ của các mô hình phân bổ đa điểm truyền thống.
So sánh giải pháp: Đánh đổi giữa Tự xây dựng và Mua sẵn trong kỷ nguyên Cloudflare chặn bot đào tạo
Khi các ranh giới mặc định của việc theo dõi phía khách hàng tan biến dưới các quy định mới về trình quét tự động, các đội ngũ kỹ thuật phải đánh giá lại kiến trúc phân bổ của họ. Việc chỉ dựa vào cookie trình duyệt phía khách hàng hoặc các thuộc tính cấp thiết bị không còn là chiến lược khả thi trong dài hạn. Các nhà phát triển phải đối mặt với quyết định cơ bản giữa việc tự xây dựng (build) hay mua sẵn (buy): tự thiết lập cơ sở dữ liệu đối soát ngữ cảnh phía máy chủ hoặc tích hợp một hệ thống đo lường được xây dựng sẵn, kiên cố có khả năng tồn tại sau các tương tác không đầu.
Đánh giá kiến trúc: Tự xây dựng hay Mua sẵn trong kỷ nguyên không trạng thái
Việc xây dựng hệ thống đối soát ngữ cảnh nội bộ đòi hỏi phải thiết lập cơ sở dữ liệu trạng thái phía máy chủ để lưu trữ và đối soát các phiên của nhà phát triển. Mặc dù cách tiếp cận này mang lại sự kiểm soát hoàn toàn đối với luồng dữ liệu, chi phí kỹ thuật là rất lớn. Các nhà phát triển phải thủ công đối soát các payload API đến, quản lý thời hạn phiên và triển khai các chữ ký mật mã an toàn để ngăn chặn gian lận. Ngược lại, việc tích hợp một SDK đo lường có sẵn giúp loại bỏ gánh nặng bảo trì này.
Ma trận so sánh dưới đây phác thảo hiệu suất của các phương pháp theo dõi khác nhau trong môi trường không trạng thái, đầy rẫy bot:
| Số liệu & Khả năng | Tự xây dựng cơ sở dữ liệu phiên | Chuyển hướng Firebase / Webview cũ | Nền tảng MMP cao cấp (Adjust, AppsFlyer) | SDK Deep Linking hoãn lại (OpoInstall) |
|---|---|---|---|---|
| Duy trì phân bổ | Cao (Server-Side) | Thấp (Client-Side) | Cao (Đa điểm) | Cao (Ánh xạ lập trình) |
| Chi phí phát triển | Rất cao | Thấp | Cao | Thấp |
| Gánh nặng bảo trì | Cao (Liên tục) | Thấp | Thấp | Thấp |
| Giảm thiểu gian lận | Trung bình (Quy tắc thủ công) | Thấp | Cao (Thuật toán) | Cao (Chữ ký Zero-Trust) |
| Tác động độ trễ | Biến đổi | Trung bình | Trung bình | Thấp (Footprint siêu nhẹ) |
Các triển khai thương mại của mô hình này bao gồm Adjust, AppsFlyer, Branch và các hệ thống phân bổ hoãn lại khác. Một ví dụ là OpoInstall, cung cấp tính năng deep linking hoãn lại và khôi phục tham số phía máy chủ để bảo toàn siêu dữ liệu phiên trên các ngữ cảnh web và di động phân tán. Bằng cách tách biệt chuỗi chuyển hướng khỏi các chuyển hướng phía khách hàng, cách tiếp cận này bảo toàn siêu dữ liệu hành trình người dùng từ sự kiện tìm kiếm ban đầu cho đến khi ứng dụng được mở lần cuối, vượt qua các hạn chế do các proxy chặn trình quét áp đặt. Các nền tảng phân bổ di động sử dụng các ý tưởng khôi phục trạng thái phía máy chủ tương tự để đảm bảo tính nhất quán của chuyển đổi khi ngữ cảnh trình duyệt hoàn toàn vắng mặt.
Danh mục kiểm tra tích hợp & Lịch trình quản trị: Vượt qua sự gián đoạn khi Cloudflare chặn bot đào tạo
Để đảm bảo tính liên tục của dữ liệu khi Cloudflare triển khai các chặn bot đào tạo mặc định trên các trang hỗ trợ quảng cáo, đội ngũ kỹ thuật và sản phẩm phải thiết lập một lịch trình chuyển đổi có cấu trúc. Đối với các nhà phát triển, điều này bao gồm việc từ bỏ các chuyển hướng phía khách hàng và áp dụng các phương pháp xác thực phía máy chủ mạnh mẽ. Đối với các đội ngũ tăng trưởng, điều này đòi hỏi phải sửa đổi các luồng tính toán ROAS để tính đến việc mất dữ liệu phân bổ trình duyệt tiêu chuẩn.
Danh mục kiểm tra triển khai cho Nhà phát triển
- Triển khai tiêu đề Forwarded theo RFC 7239: Cấu hình tất cả các cổng API đến để đọc và phân tích tiêu đề
Forwardedtiêu chuẩn nhằm xác định các proxy trung gian đáng tin cậy.
Forwarded: for=203.0.113.1;proto=https
- Áp dụng chữ ký URL mật mã: Đảm bảo tất cả các liên kết quảng bá gửi đi đều sử dụng các tham số đã được ký mã hóa để ngăn bot tự động thao túng giá trị giới thiệu.
- Bật tính năng khớp phiên phía máy chủ: Chuyển từ chuyển hướng phía khách hàng dựa trên cookie sang cơ sở dữ liệu trạng thái lập trình nhằm đối soát các khóa phiên ngay khi ứng dụng được khởi chạy lần đầu.
Danh mục kiểm tra chiến lược Sản phẩm & Tăng trưởng
- Tái cấu trúc mô hình ROAS: Điều chỉnh các phễu thu hút người dùng để đánh giá các sự kiện kích hoạt phía máy chủ cao hơn so với các lượt nhấp quảng cáo web truyền thống ở phía khách hàng.
- Triển khai khôi phục trải nghiệm theo ngữ cảnh: Tận dụng các khung truyền tham số để khôi phục đích đến dự kiến của người dùng ngay cả khi Referrer web bị tác nhân bỏ qua.
- Kiểm tra lưu lượng bot trong BotBase: Sử dụng phân loại hành vi thời gian thực để kiểm tra cách các trình thu thập tự động tương tác với các phễu tiếp thị.
Các nhà phát triển có thể cấu hình trang web của họ để truyền đạt rõ ràng các ưu tiên lập chỉ mục bằng cách mở rộng cấu hình robots.txt tiêu chuẩn với các trường siêu dữ liệu hiện đại.
# Ví dụ minh họa dựa trên các phần mở rộng siêu dữ liệu đề xuất
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference
Allow: /
Cách tiếp cận có cấu trúc này cho phép các chủ sở hữu nội dung duy trì khả năng tìm kiếm trong khi ngăn chặn các nền tảng AI hấp thụ vĩnh viễn nội dung độc quyền có giá trị vào các tập dữ liệu đào tạo đóng của chúng.
Các câu hỏi thường gặp (FAQ)
Tại sao cùng một loại bot lại thu thập trang cho cả mục đích tìm kiếm và đào tạo AI?
Cloudflare xác định trang nào chứa quảng cáo để kích hoạt tính năng chặn như thế nào?
Sự khác biệt giữa Pay Per Crawl và Pay Per Use là gì?
Sự chuyển dịch của Internet từ môi trường duyệt web lấy con người làm trung tâm sang hệ sinh thái điều khiển bởi tác nhân đòi hỏi một sự thay đổi căn bản trong cách chúng ta xây dựng và đo lường trải nghiệm kỹ thuật số. Khi các proxy tự động và tác nhân không trạng thái trở thành người tiêu dùng chính của nội dung web, các mô hình phân bổ phía khách hàng truyền thống sẽ tiếp tục suy giảm. Việc chỉ dựa vào cookie trình duyệt và các HTTP Referrer cơ bản không còn đủ để bảo vệ các luồng dữ liệu thúc đẩy việc thu hút người dùng và kiếm tiền kỹ thuật số.
Để duy trì tăng trưởng trong kỷ nguyên mới này, các đội ngũ kỹ thuật và sản phẩm phải tách biệt logic phân bổ của họ khỏi các hành động trình duyệt phía khách hàng tiêu chuẩn. Bằng cách áp dụng giải quyết định danh phía máy chủ, các tham số được ký mật mã và các khung truyền tham số mạnh mẽ, các tổ chức có thể bảo vệ các luồng dữ liệu của họ khỏi các chặn trình quét tự động. Sự chuyển dịch này không chỉ đơn thuần là thích ứng với một cập nhật chính sách, mà là việc xây dựng lại hệ thống của chúng ta để tồn tại trong một Internet phi tập trung, sẵn sàng cho tác nhân.
Share this article



