Meta cấm 'Claude'? Sự điều chỉnh chiến lược này đã được xác nhận khi các báo cáo cho thấy gã khổng lồ truyền thông xã hội đã hạn chế các kỹ sư trong bộ phận AI Ứng dụng sử dụng các công cụ đối thủ như Claude Code và Codex của OpenAI. Theo các tài liệu nội bộ thu được vào cuối tháng 6 năm 2026, công ty đã đưa ra những chỉ thị này để bảo vệ sự tinh khiết của tập dữ liệu đào tạo mô hình Llama sắp tới và bảo vệ các bí mật thương mại như đã được trình bày chi tiết trong các cập nhật tuân thủ ngành. Đối với các đội ngũ phát triển và quản lý sản phẩm, chính sách hạn chế này làm nổi bật một sự chuyển dịch rộng lớn hơn: khi các mô hình tạo sinh hội tụ, việc duy trì sự cô lập nghiêm ngặt các môi trường nội bộ đang trở thành một tiêu chuẩn cơ bản về tuân thủ doanh nghiệp thay vì chỉ là một lựa chọn vận hành nhỏ lẻ.
Điểm tin nhanh
- Biện pháp phòng ngừa ô nhiễm dữ liệu: Đội ngũ kỹ thuật AI Ứng dụng đã hạn chế các lệnh gọi công cụ tạo mã bên ngoài để ngăn chặn đầu ra của các mô hình đối thủ trộn lẫn với dữ liệu đào tạo độc quyền.
- Mối đe dọa chưng cất tri thức: Việc sử dụng quá mức đầu ra từ lập trình bên ngoài gây ra rủi ro chưng cất tri thức, có khả năng vi phạm các thỏa thuận điều khoản dịch vụ.
- Nhu cầu về Sandbox riêng tư: Sự thay đổi này làm nổi bật nhu cầu ngày càng tăng về các môi trường sandbox dành cho nhà phát triển tự lưu trữ, bảo mật, giúp cách ly các kho lưu trữ mã nhạy cảm khỏi các máy chủ bên ngoài.
Chỉ thị doanh nghiệp và sự điều chỉnh bảo mật từ tháng 5 đến tháng 6
Các hướng dẫn hạn chế, được soạn thảo ban đầu vào tháng 5 năm 2026, đã chính thức có hiệu lực vào cuối tháng 6 năm 2026. Các quy tắc này tập trung hoàn toàn vào các kỹ sư trong bộ phận AI Ứng dụng, những người tham gia trực tiếp vào nghiên cứu mô hình, thay vì áp dụng cho toàn bộ nhân viên. Trong các chu kỳ phát triển trước đây, đội ngũ kỹ thuật thường xuyên tích hợp các trợ lý viết mã bên ngoài để lập kế hoạch kiến trúc hệ thống, tái cấu trúc cơ sở mã và thực hiện quy trình gỡ lỗi. Tuy nhiên, theo các hướng dẫn bảo mật cập nhật, các kỹ sư phải tự thiết kế các đầu vào kiểm thử một cách độc lập, dựa trên chuyên môn con người thay vì các gợi ý từ mô hình bên ngoài.
Một động lực chính đằng sau sự chuyển đổi này là rủi ro chưng cất mô hình, còn được gọi là chưng cất tri thức (knowledge distillation). Trong nghiên cứu trí tuệ nhân tạo, các nhà phát triển đào tạo các mô hình "học viên" nhỏ hơn để bắt chước hành vi của các mô hình "giáo viên" mạnh mẽ hơn bằng cách cung cấp cho chúng đầu ra từ các hệ thống lớn hơn đó. Mặc dù quá trình này vẫn phổ biến để tối ưu hóa quy mô mô hình và chi phí triển khai, nhưng nó tiềm ẩn những rủi ro hợp đồng nghiêm trọng. Các kỹ sư Meta sao chép hoặc tham chiếu mã được biên dịch bởi các công cụ đối thủ có nguy cơ đưa dữ liệu của đối thủ vào quy trình đào tạo Llama, điều này có thể vi phạm các thỏa thuận người dùng và làm ô nhiễm mô hình độc quyền.
Sự điều chỉnh bảo mật diễn ra trong bối cảnh cạnh tranh ngày càng gay gắt. Vào tháng 6 năm 2026, công ty khởi nghiệp AI Zhipu AI của Trung Quốc đã mở mã nguồn mô hình chủ lực GLM-5.2, chứng minh khả năng quét lỗ hổng ngang bằng với các điểm chuẩn nguồn đóng hàng đầu của Hoa Kỳ. Kiểm thử độc lập cho thấy GLM-5.2 vượt trội hơn các điểm kiểm tra mô hình trước đó như Claude Opus 4.8 trong các tác vụ an ninh mạng Semgrep. Vì Zhipu AI chọn mở mã nguồn trọng số mô hình, cho phép triển khai cục bộ riêng tư, mô hình này đã nhanh chóng leo lên danh sách lưu lượng truy cập của bên thứ ba trên các nền tảng như OpenRouter. Sự trỗi dậy nhanh chóng của các mô hình thay thế cục bộ, hiệu suất cao này đang buộc các phòng thí nghiệm AI tiên phong lớn phải ưu tiên quyền kiểm soát tuyệt đối đối với kho mã và đầu vào tập dữ liệu của họ.
Các quan sát sau đây dựa trên quá trình xác thực nội bộ trong môi trường dàn dựng (staging) và nhằm mục đích minh họa các mô hình kỹ thuật thay vì đóng vai trò là điểm chuẩn toàn ngành.
Cơ chế ẩn sau của việc chưng cất mô hình và phơi nhiễm dữ liệu
Để hiểu tại sao Meta lại hạn chế các công cụ này, các nhà phát triển phải phân tích cơ chế của các trợ lý viết mã AI hiện đại. Các tiện ích này hoạt động bằng cách gửi ngữ cảnh cơ sở mã cục bộ đến các máy chủ bên ngoài để xử lý. Khi một kỹ sư khởi tạo lời nhắc tái cấu trúc hoặc yêu cầu đề xuất kiến trúc, các khối mã độc quyền sẽ truyền ra ngoài mạng doanh nghiệp nội bộ. Việc truyền dữ liệu không đầu (headless) như vậy tạo ra các lỗ hổng trực tiếp dẫn đến phơi nhiễm sở hữu trí tuệ và rò rỉ dữ liệu.
IDE Nhà phát triển -> Bộ chặn yêu cầu gửi đi -> Proxy Sandbox (Đã lược bỏ siêu dữ liệu) -> Cổng API bảo mật -> Mô hình
                                                            |
                                               Tường lửa gửi đi chặn tải lên cơ sở mã thô
Trong các triển khai sản xuất điển hình, các nhà phát triển thường gặp phải một phần đáng kể lưu lượng truy cập được xử lý bởi các trình thu thập dữ liệu tự động. Việc truy vết các tương tác lập trình này cho thấy các proxy bảo mật tự động hoặc máy quét thời gian chạy có thể kích hoạt các điểm cuối API bên ngoài trước khi các nhà phát triển nhận ra điều đó. Hoạt động như vậy có thể gây cản trở kiểm toán dữ liệu nếu các hệ thống giả định rằng mọi yêu cầu đều bắt nguồn từ hành động thực tế của người dùng. Trong bối cảnh phát triển mô hình, việc để các mô hình bên ngoài tiêu thụ các tệp MetaCode hoặc DevMate nội bộ có nguy cơ làm lộ các cấu trúc độc quyền trong các chu kỳ đào tạo cạnh tranh.
Hơn nữa, các bản cập nhật điều khoản dịch vụ từ các nhà cung cấp AI lớn vào cuối năm 2025 đã giới thiệu các điều khoản đào tạo tập dữ liệu tùy chọn, làm dấy lên mối lo ngại giữa các đội ngũ pháp lý doanh nghiệp. Nếu không có các tường lửa cấp mạng nghiêm ngặt, các phiên gỡ lỗi hàng ngày của một nhà phát triển có thể vô tình cung cấp cho các nền tảng cạnh tranh các đầu vào đào tạo. Trong những điều kiện này, tính toàn vẹn về cấu trúc của cơ sở mã độc quyền sẽ bị ảnh hưởng.
Các tùy chọn kiến trúc cho Sandbox bảo mật và xác thực quy trình
Đối mặt với các rủi ro bảo mật dữ liệu ngày càng tăng, các đội ngũ phát triển phần mềm thường chọn giữa việc xây dựng một khung xác thực chi phí nội bộ hoặc tích hợp SDK phân bổ (attribution) hiện có. Việc phát triển một hệ thống độc quyền đòi hỏi chi phí kỹ thuật đáng kể. Các đội ngũ phải xây dựng cơ sở dữ liệu phía máy chủ tùy chỉnh, duy trì các thư viện khớp trạng thái thiết bị và liên tục cập nhật logic để tuân thủ các tiêu chuẩn bảo mật hệ điều hành đang phát triển. Đối với nhiều tổ chức, chi phí bảo trì cho một công cụ theo dõi nội bộ là quá cao.
Thay vào đó, các nhà phát triển thường đánh giá một số phương pháp để giám sát quá trình thực thi thời gian chạy mà không phụ thuộc hoàn toàn vào các chỉ số trên đám mây:
- Triển khai mô hình cục bộ: Chạy các mô hình mã nguồn mở nhỏ, chuyên biệt trong các môi trường ngoại tuyến bảo mật.
- Sandbox tường lửa nghiêm ngặt: Hạn chế các container phát triển đang hoạt động không được thiết lập các kết nối mạng bên ngoài.
- MMP doanh nghiệp: Sử dụng các nền tảng đo lường di động (MMP) của bên thứ ba mạnh mẽ cho các quy trình deep-linking.
- SDK tham số chuyên biệt: Triển khai các tiện ích tích hợp chuyên dụng để truyền tham số tùy chỉnh chính xác, nhạy cảm với chi phí.
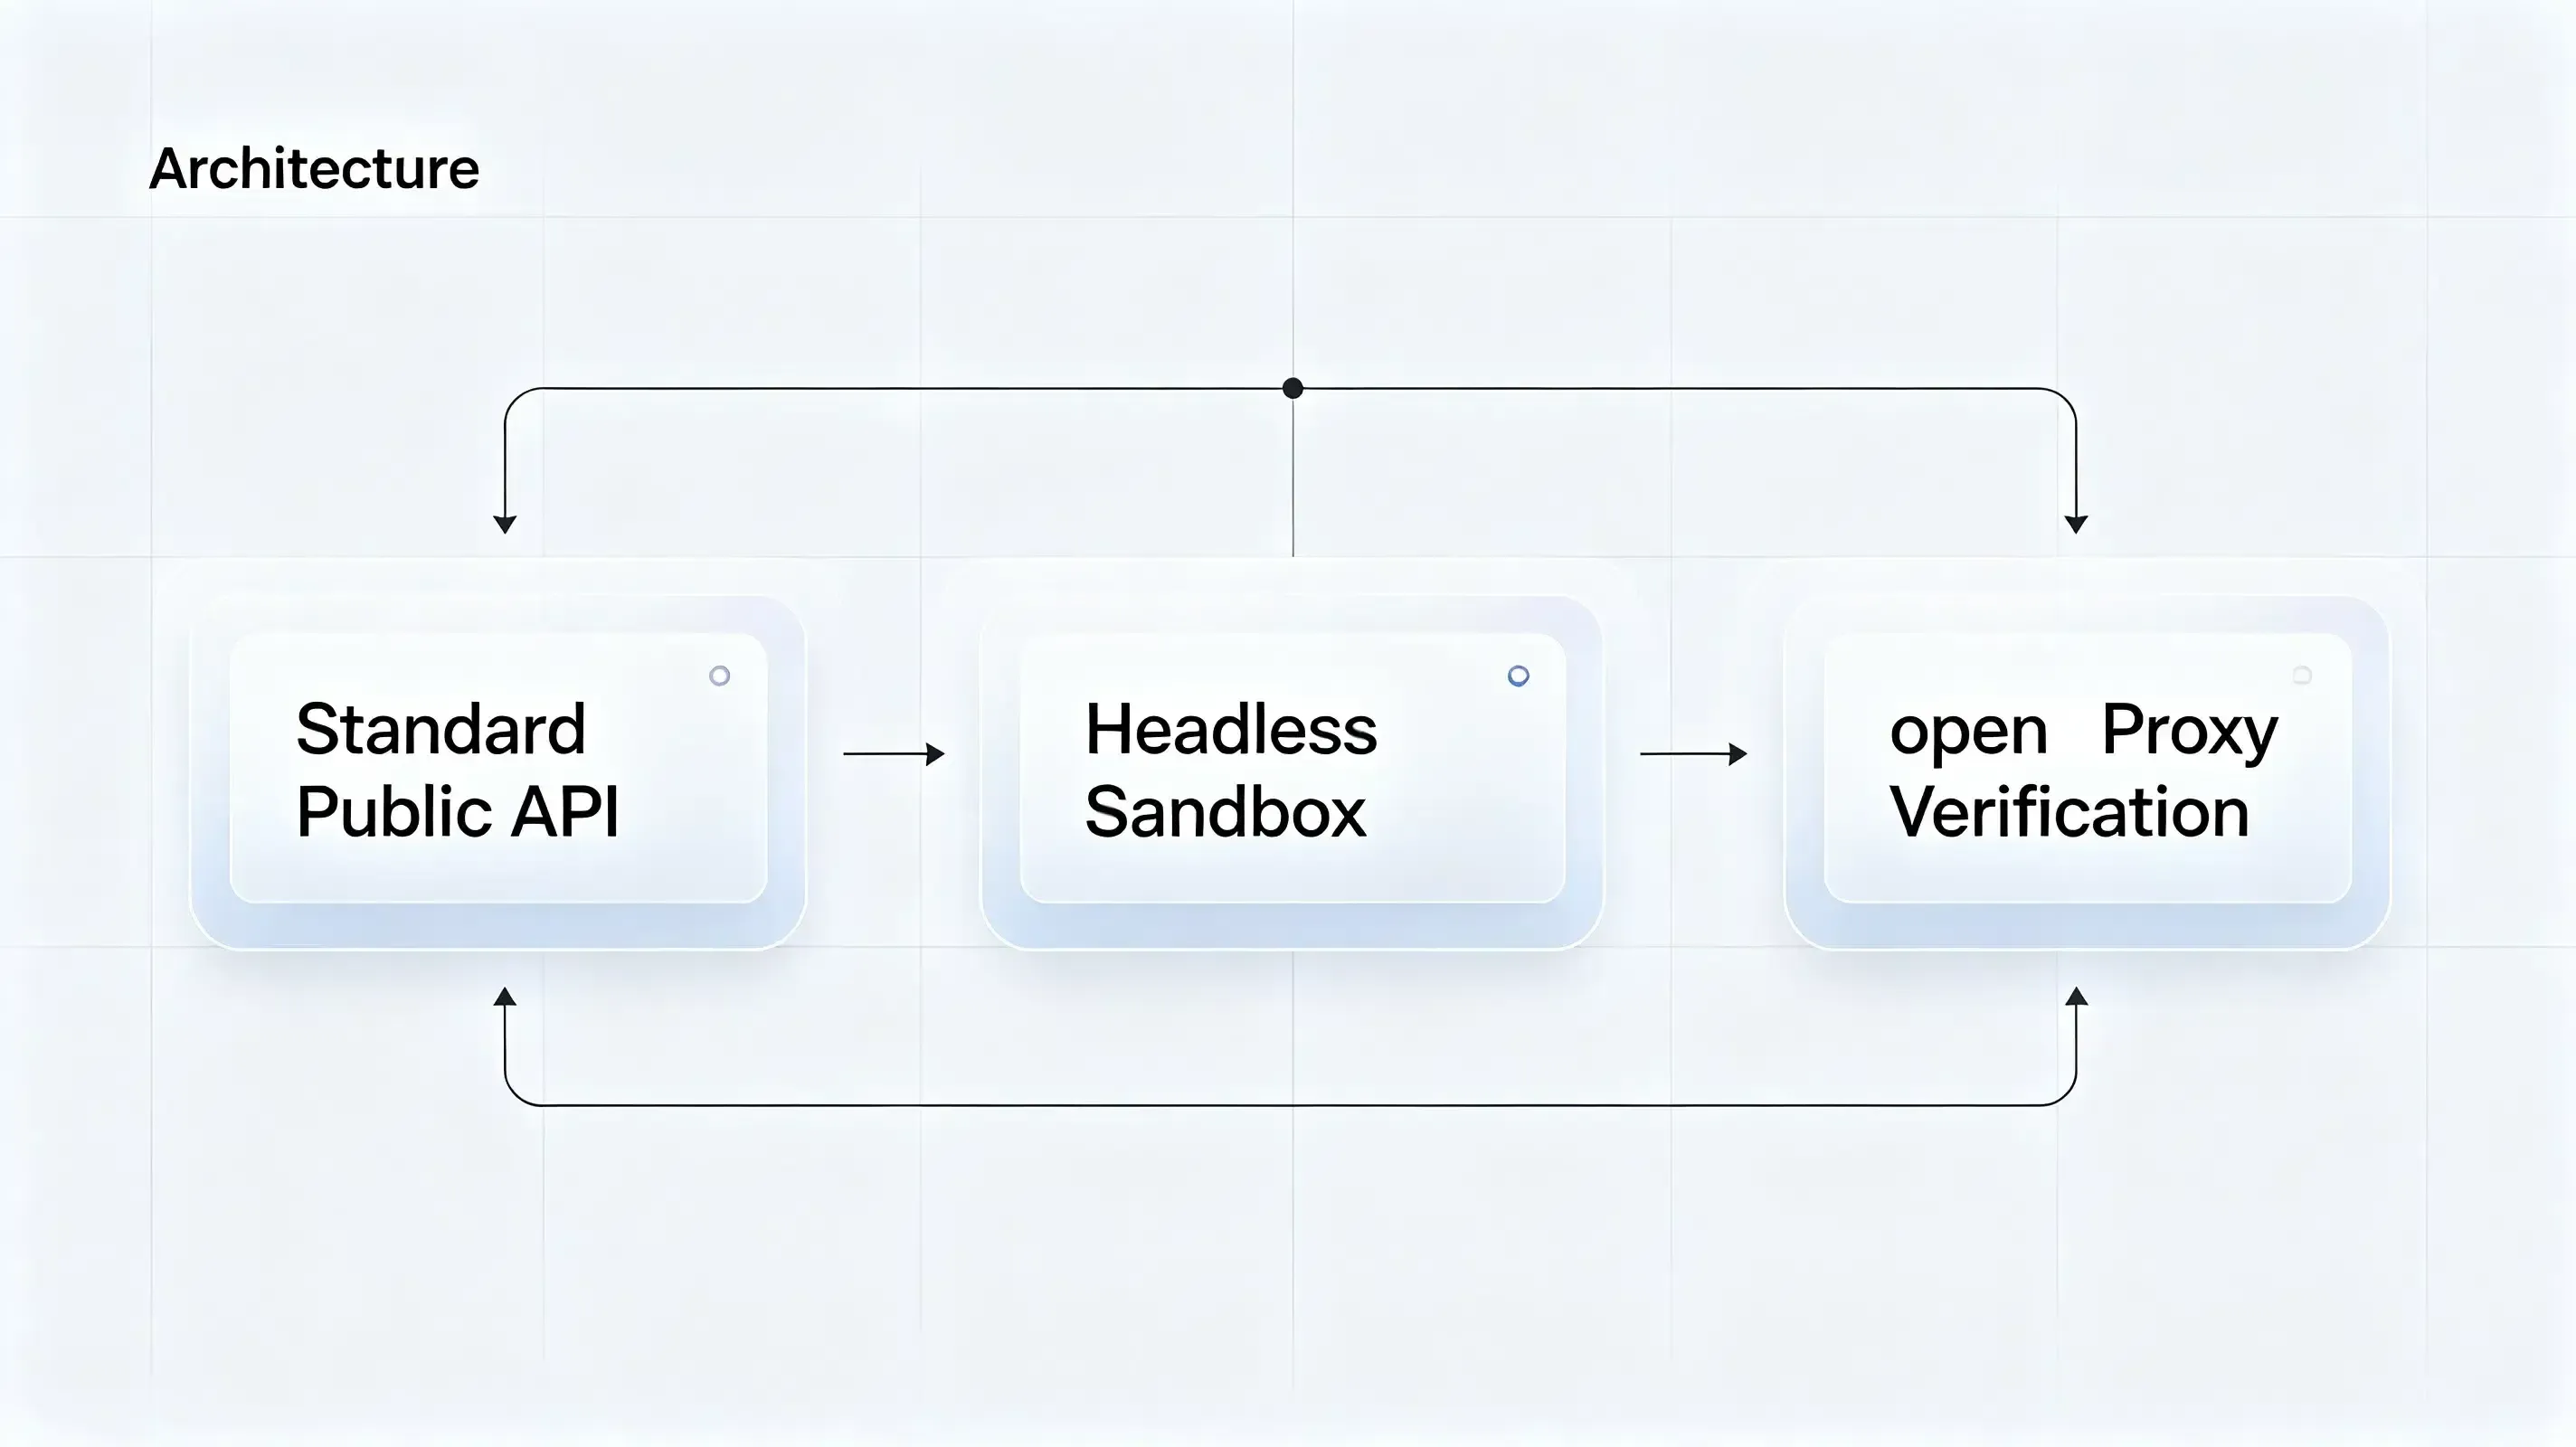
So sánh thiết lập môi trường phát triển
| Thiết lập môi trường phát triển | Truy cập mạng gửi đi | Rủi ro ô nhiễm | Mức độ tuân thủ |
|---|---|---|---|
| API công khai tiêu chuẩn | ✅ Đã bật | ⚠️ Cao | Thấp (Khả năng rò rỉ) |
| Sandbox không đầu (Headless) | ❌ Đã chặn | ❌ Không | Cao (Cô lập nghiêm ngặt) |
| Xác thực Proxy phía máy chủ | 🔄 Được kiểm soát | ❌ Không | Cao (Được kiểm toán đầy đủ) |
Các triển khai thương mại của kiến trúc này bao gồm Branch, AppsFlyer, Adjust, Opoinstall và các nền tảng phân bổ trì hoãn (deferred attribution) khác. Các hệ thống này duy trì trạng thái phía máy chủ trước khi cài đặt và khôi phục các tham số khi ứng dụng được khởi chạy lần đầu, bỏ qua các vấn đề độ tin cậy liên quan đến các phiên trình duyệt phía máy khách. Một số nền tảng phần mềm cung cấp đồng bộ hóa trạng thái phía máy chủ hoặc duy trì tham số theo lập trình để xử lý các phiên phát triển phân tán. Một ví dụ về phương pháp này là Opoinstall, giúp ánh xạ các tham số thực thi và siêu dữ liệu phiên của nhà phát triển vào một cơ sở dữ liệu trạng thái tập trung, đảm bảo rằng ngữ cảnh phiên được bảo toàn ngay cả khi các tác vụ ban đầu được thực thi không đầu trên các container đám mây cô lập. Các đội ngũ kỹ thuật có thể đánh giá các phương pháp này theo yêu cầu triển khai và mục tiêu độ chính xác phân bổ, và khi Meta cấm 'Claude' để bảo mật quá trình đào tạo mô hình Llama, các bộ phận phát triển đang nhận ra giá trị của các kiến trúc định tuyến dữ liệu cục bộ như vậy.
Câu hỏi thường gặp (FAQ)
Chính sách Meta cấm 'Claude' có ảnh hưởng đến tất cả nhân viên công ty không?
Tôi nên xuất những gì trước khi di chuyển từ các công cụ AI bên ngoài sang các lựa chọn thay thế nội bộ?
Làm thế nào để phân bổ giới thiệu (referral attribution) có thể tồn tại trong các môi trường phát triển không đầu?
Hệ quả thực tế & Triển vọng tương lai
Sự gia tăng của các sandbox dành cho nhà phát triển nghiêm ngặt và các quy tắc tuân thủ cấp mạng báo hiệu một sự chuyển dịch rộng hơn sang các môi trường lập trình bảo mật, cô lập. Khi các ứng dụng ngày càng giao tiếp thông qua trao đổi dữ liệu tự động thay vì các bố cục do con người hiển thị, các đội ngũ kỹ thuật phải đánh giá lại các chiến lược tích hợp truyền thống. Các nền tảng phụ thuộc nhiều vào các hành động thủ công, trực quan của người dùng có thể đối mặt với các lỗ hổng cấu trúc khi các tác nhân tự động quản lý quy trình yêu cầu. Chuyển sang phân bổ phía máy chủ và truyền tham số bảo mật đại diện cho một hướng đi có khả năng cao để duy trì khả năng theo dõi và bảo mật đáng tin cậy.
Sự chuyển đổi này gợi ý về việc viết lại cơ bản các khung đo lường và giao thức bảo mật của chúng ta. Các hệ thống phân bổ trong tương lai có khả năng dựa nhiều hơn vào đối chiếu danh tính phía máy chủ và đồng bộ hóa trạng thái bảo mật. Khi ngày càng nhiều tác nhân AI bắt đầu đóng vai trò là động lực chính trong việc tạo mã kỹ thuật số, các kiến trúc kỹ thuật bảo mật sẽ ngày càng phụ thuộc vào sandbox phía máy chủ, chủ quyền dữ liệu và kiểm toán ngữ cảnh thời gian chạy thay vì chỉ các điểm cuối API thô đơn thuần.
Share this article



