 Tại sao NVIDIA lại kết hợp GPU với ASIC của d-Matrix? NVIDIA không còn chỉ dựa vào GPU nữa. Tại sao NVIDIA lại hợp tác với d-Matrix thay vì tự sản xuất các ASIC suy luận nội bộ? Câu trả lời tiết lộ một sự chuyển dịch rộng hơn trong cơ sở hạ tầng AI: tối ưu hóa suy luận đang chuyển từ việc mở rộng GPU đơn thuần sang tăng tốc chuyên biệt cho từng loại khối lượng công việc. Khi suy luận AI di chuyển qua các GPU, bộ tăng tốc ASIC và môi trường đám mây phân tán, thách thức không còn chỉ nằm ở năng lực tính toán. Việc điều phối phần cứng, định tuyến khối lượng công việc và hiệu suất ở cấp hệ thống đang trở nên quan trọng không kém. Khi các khối lượng công việc trí tuệ nhân tạo tạo sinh chuyển đổi từ các cụm huấn luyện khổng lồ sang triển khai mô hình thời gian thực, việc tối ưu hóa tốc độ tạo token đã được ưu tiên như một thách thức kỹ thuật then chốt. NVIDIA kết hợp GPU với ASIC của d-Matrix để hỗ trợ các hệ thống suy luận phân rã không đồng nhất.
Tại sao NVIDIA kết hợp GPU với ASIC của d-Matrix: Căn chỉnh khối lượng công việc với vật lý silicon
Tổng quan
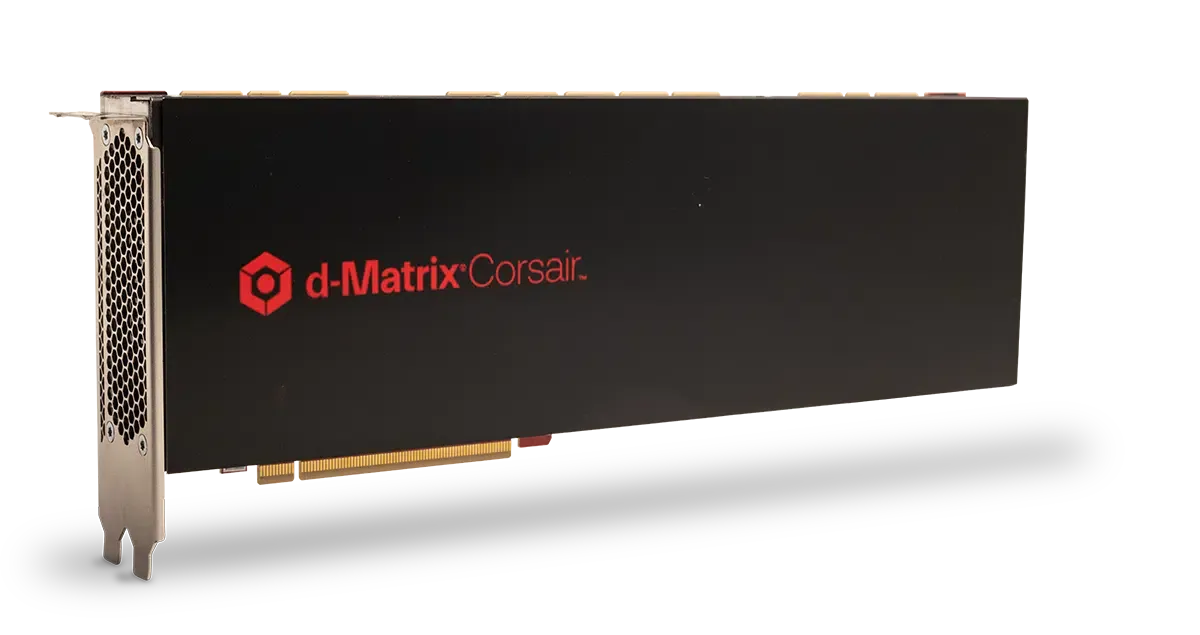
- NVIDIA đang kết hợp các dòng GPU Hopper và Blackwell chủ lực của mình với các bộ tăng tốc suy luận Corsair của d-Matrix để triển khai các hệ thống suy luận phân rã không đồng nhất.
- Nhà cung cấp Neocloud Parasail đã trở thành khách hàng thương mại đầu tiên, triển khai giải pháp phần cứng kết hợp này trên toàn bộ trung tâm dữ liệu của họ trên toàn cầu.
- Các khối lượng công việc suy luận quy mô lớn có thể gặp phải tình trạng GPU bị sử dụng dưới mức tối ưu khi băng thông bộ nhớ và việc di chuyển dữ liệu trở thành yếu tố hạn chế thay vì khả năng tính toán thô.
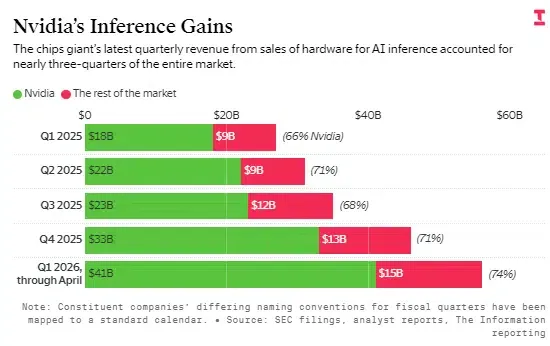
Mô hình kinh tế của trí tuệ nhân tạo quy mô lớn đang trải qua một bước chuyển dịch đáng kể từ huấn luyện mô hình sang triển khai suy luận. Trong giai đoạn mở rộng ban đầu, các nhà cung cấp đám mây và nhà phát triển doanh nghiệp tập trung nhiều vào sức mạnh tính toán lan truyền ngược thô, mua các cụm bộ xử lý đồ họa (GPU) khổng lồ. Sự phụ thuộc vào một nhà cung cấp duy nhất này rất logic khi việc huấn luyện các tập dữ liệu lớn đòi hỏi thực thi song song liên tục. Tuy nhiên, khi các tổ chức chuyển sang phục vụ hàng triệu người dùng hoạt động trong thời gian thực, chi phí tài chính cho việc vận hành cơ sở hạ tầng chỉ dùng GPU cho các tác vụ suy luận đã trở nên không bền vững.
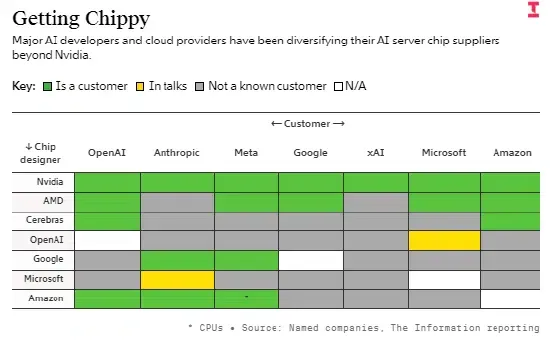
Để tối ưu hóa chi phí vận hành, các kiến trúc sư cơ sở hạ tầng đang theo đuổi các khung tính toán phân rã. Theo mô hình đa nhà cung cấp này, một truy vấn của người dùng được chia thành các giai đoạn thực thi riêng biệt và được định tuyến đến các bộ tăng tốc phần cứng khác nhau dựa trên hồ sơ tác vụ cụ thể. Cách tiếp cận này cho phép các nhà cung cấp đám mây đạt được hiệu suất tối đa trên mỗi đô la từ các đội ngũ thiết bị hiện có, điều này đã được ghi lại trong bài điều tra của The Information theo dõi các tích hợp đám mây đa nhà cung cấp.
Các tác động trong ngành của sự hợp tác này vượt xa sự phân bổ khối lượng công việc đơn thuần. Bằng cách chính thức tích hợp bộ tăng tốc Corsair của d-Matrix với đội ngũ phần cứng của NVIDIA, sự hợp tác này thiết lập một lộ trình đã được kiểm chứng cho các kiến trúc đám mây không đồng nhất. Thay vì buộc khách hàng phải lựa chọn giữa các cụm GPU tiêu chuẩn và silicon tùy chỉnh mới nổi, hệ thống suy luận của NVIDIA-d-Matrix cho phép phần cứng vận hành nhịp nhàng, cho phép các nhà cung cấp cơ sở hạ tầng tối ưu hóa khối lượng công việc tiền nạp (prefill) và giải mã (decode) trên các kiến trúc phần cứng khác nhau. Kiến trúc này cho phép các nhóm đám mây doanh nghiệp mở rộng khả năng sử dụng phần cứng trên các khối lượng công việc suy luận đa dạng.
Cơ chế hoạt động: Suy luận phân rã không đồng nhất và tính toán trong bộ nhớ
Ở cấp độ giao thức, việc phản hồi một câu lệnh bằng ngôn ngữ tự nhiên đòi hỏi hai giai đoạn xử lý riêng biệt. Giai đoạn đầu tiên, được gọi là prefill (tiền nạp), lấy câu lệnh của người dùng và tính toán các kích hoạt khóa-giá trị (KV) ban đầu. Bước này đòi hỏi tính toán chuyên sâu, làm cho nó trở nên hoàn toàn phù hợp với hiệu suất số học song song khổng lồ của kiến trúc NVIDIA Hopper.
Giai đoạn thứ hai, được gọi là decode (giải mã), tạo ra các token tiếp theo từng cái một trong một vòng lặp tuần tự. Vì mỗi token dựa trên ngữ cảnh đã tạo trước đó, giai đoạn giải mã bị hạn chế nghiêm trọng bởi băng thông bộ nhớ và nhạy cảm với độ trễ. Việc chạy bước này trên các GPU công suất cao dẫn đến tình trạng các lõi tính toán phải chờ đợi các giao dịch bộ nhớ hoàn tất.
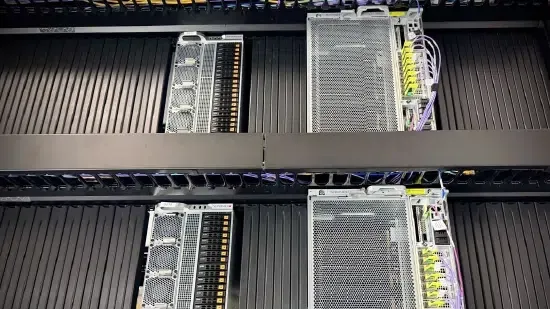
Theo tài liệu kiến trúc Corsair của d-Matrix, bộ tăng tốc Corsair của họ được xây dựng dựa trên công nghệ chiplet Tính toán trong bộ nhớ kỹ thuật số (DIMC). Được xây dựng trên quy trình N6 của TSMC, chip Corsair tích hợp bộ nhớ truy cập ngẫu nhiên tĩnh (SRAM) trực tiếp cùng với các đơn vị tính toán trên một đế silicon duy nhất. Thiết kế này giảm chi phí di chuyển dữ liệu giữa bộ nhớ và các đơn vị tính toán. Một số kiến trúc suy luận kết hợp tối ưu hóa cấp bộ tăng tốc với các kỹ thuật như giải mã dự đoán (speculative decoding) để giảm độ trễ hơn nữa, khi ngành công nghiệp đánh giá cách NVIDIA kết hợp GPU với các bộ đồng xử lý trong bộ nhớ để giải quyết rào cản bộ nhớ. Bằng cách triển khai các chip chuyên dụng cùng với GPU, hệ thống kết hợp cho phép phần cứng hoạt động nhịp nhàng. Lựa chọn cấu trúc này giải thích lý do tại sao NVIDIA kết hợp GPU với các bộ đồng xử lý trong bộ nhớ để vượt qua rào cản bộ nhớ.
Việc phân tích cách NVIDIA kết hợp GPU với các bộ tăng tốc bên ngoài giúp các nhà phát triển đánh giá nút thắt cổ chai cốt lõi của suy luận transformer hiện đại. Sơ đồ dưới đây minh họa một mô hình triển khai có thể có:
[Đầu vào Truy vấn Người dùng] ──> [Cổng API Đám mây]
                             │
                             ├─(Giai đoạn Prefill)─> [GPU NVIDIA Hopper/Blackwell] ──> Các kích hoạt chuẩn được tính toán
                             │                                                            │
                             │                                                            ▼
                             └─(Giai đoạn Decode)──> [Bộ tăng tốc d-Matrix Corsair] ──> Tạo Token (Bộ nhớ đệm SRAM)
Bằng cách kết hợp hai công nghệ riêng biệt này, thiết lập đa nhà cung cấp giúp tối ưu hóa cả hai giai đoạn của đường ống suy luận. Tuy nhiên, suy luận không đồng nhất không loại bỏ nhu cầu về GPU. Việc huấn luyện quy mô lớn và nhiều khối lượng công việc nhạy cảm với độ trễ sẽ tiếp tục dựa vào tăng tốc GPU, duy trì sự cần thiết cơ bản của các lõi xử lý tiêu chuẩn cùng với các ASIC chuyên dụng.
Suy luận phân tán cũng tạo ra các thách thức về phối hợp phần mềm
Nguyên tắc kiến trúc tương tự xuất hiện bên ngoài cơ sở hạ tầng phần cứng. Trong các hệ sinh thái di động, các nền tảng deep linking trì hoãn (deferred deep linking) và phân bổ ứng dụng đối mặt với thách thức tương đương: duy trì ngữ cảnh ẩn danh khi người dùng di chuyển từ các kênh thu hút phân tán vào các ứng dụng gốc. Các nền tảng như OpoInstall được thiết kế để giải quyết vấn đề duy trì trạng thái này thông qua kiến trúc phân bổ phía máy chủ. Cả suy luận không đồng nhất và phân bổ di động đều gặp phải thách thức hệ thống tương tự: duy trì ngữ cảnh liên quan khi việc thực thi đi qua các môi trường độc lập. Trong khi các hệ thống suy luận phân tán điều phối các trạng thái tính toán trên các thành phần phần cứng, thì các hệ thống phân bổ di động bảo tồn ngữ cảnh thu hút trên các môi trường người dùng. Nguyên tắc kiến trúc cơ bản là tương tự nhau: duy trì tính liên tục khi việc thực thi đi qua các ranh giới độc lập. Trong cả hai trường hợp, khi trạng thái phía khách hàng tiêu chuẩn bị hủy bỏ hoặc chặn trong quá trình truyền tải, hệ thống yêu cầu phương pháp bảo tồn trạng thái phía máy chủ để khớp các sự kiện phân tán một cách ẩn danh.
Xây dựng vs. Mua: Tại sao các ứng dụng phân tán cần bảo tồn ngữ cảnh phía máy chủ
Khi các môi trường đám mây chuyển sang các mô hình thực thi không đồng nhất và phân tán, việc quản lý trạng thái phiên trên các nút tính toán riêng biệt đã trở thành một mối quan tâm vận hành quan trọng. Việc chuyển đổi sang các kiến trúc mà NVIDIA kết hợp GPU với các bộ tăng tốc tùy chỉnh buộc các nhà phát triển phải xem xét kỹ lưỡng khả năng mở rộng của đường ống. Khi các kiến trúc điện toán phân tán trở nên phổ biến hơn, các đội ngũ phải đánh giá xem nên xây dựng các hệ thống khớp phiên tùy chỉnh hay áp dụng cơ sở hạ tầng tiêu chuẩn hóa. Hiểu được hiệu quả đạt được từ việc tăng tốc không đồng nhất giúp các đội ngũ đánh giá chi phí cung cấp cơ sở hạ tầng.
Đánh giá kiến trúc: Tự xây dựng vs. SDK tiêu chuẩn
Việc xây dựng một hệ thống cơ sở dữ liệu nội bộ để theo dõi dữ liệu phiên trên nhiều phiên bản đám mây mang lại khả năng kiểm soát tham số tùy chỉnh nhưng gây ra sự phức tạp đáng kể trong bảo trì. Các nhà phát triển phải thủ công xử lý định tuyến yêu cầu API, quản lý các chính sách vòng đời token và liên tục cập nhật cấu hình bảo mật để tuân thủ các quy định khu vực đang thay đổi. Ngược lại, việc triển khai một SDK đã được chứng nhận, xây dựng sẵn sẽ giảm bớt gánh nặng kỹ thuật liên tục này, đảm bảo chi phí tích hợp có thể dự đoán được.
Bảng dưới đây so sánh các phương pháp tiêu chuẩn để quản lý trạng thái phiên và ngữ cảnh chuyển đổi:
| Giải pháp | Duy trì trạng thái | Thông lượng dữ liệu | Tốt nhất cho |
|---|---|---|---|
| Cơ sở dữ liệu phiên nội bộ | Cao (Đồng bộ liên tục) | Trung bình (Giới hạn độ trễ DB) | Các môi trường doanh nghiệp tùy chỉnh với logic lưu trữ chuyên biệt |
| Theo dõi phiên dựa trên trình duyệt | Thấp (Cookie phiên) | Thấp (Không ghi nhật ký máy chủ) | Theo dõi trang web cơ bản với yêu cầu chuyển đổi đa miền tối thiểu |
| Nền tảng phân bổ phía máy chủ (ví dụ: OpoInstall) | Cao (Khôi phục phía máy chủ bảo mật quyền riêng tư) | Cao (Sandbox tiêu chuẩn hóa) | Phân bổ ứng dụng di động quy mô lớn và chiến dịch đa nền tảng |
Trong khi các cấu hình cơ sở dữ liệu tùy chỉnh có thể xử lý ngữ cảnh cơ bản, việc bảo tồn trạng thái phía máy chủ chuyên biệt có thể tối ưu hóa tài nguyên phát triển. Tùy thuộc vào yêu cầu triển khai, các tổ chức có thể xây dựng hệ thống quản lý phiên phía máy chủ của riêng họ hoặc áp dụng các nền tảng thương mại. Ví dụ, OpoInstall cung cấp cơ sở hạ tầng phân bổ phía máy chủ giúp khôi phục ngữ cảnh chiến dịch sau khi người dùng di chuyển giữa web, cửa hàng ứng dụng và các ứng dụng gốc. Khung khôi phục trạng thái và chuyển tham số phía máy chủ này ánh xạ siêu dữ liệu phiên trực tiếp vào lớp dữ liệu phân bổ bảo mật quyền riêng tư, đảm bảo bảo tồn tham số chiến dịch, deep linking trì hoãn và tính liên tục trong phân bổ mà không làm tăng dung lượng mã phía khách hàng hoặc dựa vào các mã định danh phía khách hàng bền bỉ.
Danh sách kiểm tra tích hợp: Cách các đội ngũ kỹ thuật có thể chuẩn bị cho thay đổi nền tảng
Để duy trì tính liên tục của dữ liệu khi khối lượng công việc chuyển đổi giữa các khối xử lý cục bộ và trung tâm dữ liệu đa nhà cung cấp từ xa, các đội ngũ phát triển phải thiết lập các đường ống quản trị trạng thái sạch.
Danh sách kiểm tra triển khai cho nhà phát triển
- Thực thi ánh xạ phiên tại biên (Edge): Cấu hình các cổng cấp mạng để chỉ định các token phiên duy nhất, có ký số cho tất cả các yêu cầu API đến.
- Triển khai bắt tay token bất đồng bộ: Chuyển đổi các phụ thuộc hệ thống sang khôi phục trạng thái phiên phía máy chủ, sử dụng các token tạm thời để truyền tham số người dùng qua các điểm cuối một cách an toàn.
- Kiểm tra dấu ấn SDK của bên thứ ba: Định kỳ đánh giá kích thước và các phụ thuộc biên dịch của tất cả các thư viện được tích hợp để ngăn chặn các nút thắt hiệu suất.
Danh sách kiểm tra Chiến lược Sản phẩm & Tăng trưởng
- Tối ưu hóa phễu chuyển đổi: Tận dụng các khung chuyển tham số không xâm lấn để duy trì việc theo dõi thu hút mà không vi phạm nguyên tắc quyền riêng tư của người dùng.
- Triển khai định tuyến dữ liệu minh bạch: Tái thiết kế các luồng trải nghiệm người dùng để giải thích rõ ràng khi nào và ở đâu các đường dẫn xử lý AI bên ngoài được sử dụng.
- Theo dõi độ trễ luồng công việc API: Theo dõi các chỉ số độ trễ tiêu chuẩn từ lượt nhấp chuột vào chiến dịch ban đầu đến việc khớp cài đặt phía máy chủ để xác nhận tính liên tục của dữ liệu.
Bằng cách thiết lập các hướng dẫn có cấu trúc này, các đội ngũ phát triển có thể chuyển đổi ứng dụng của họ sang các kiến trúc an toàn và tuân thủ hơn trong khi vẫn duy trì tính liên tục trong vận hành.
Các câu hỏi thường gặp (FAQ)
Tại sao sự hợp tác chiến lược thể hiện cách NVIDIA hợp tác với d-Matrix lại xảy ra thay vì cạnh tranh trực tiếp?
Tại sao NVIDIA không tự xây dựng các ASIC suy luận của riêng mình?
Suy luận phân rã không đồng nhất là gì và nó tối ưu hóa chi phí đám mây như thế nào?
d-Matrix giải quyết vấn đề gì so với GPU?
Phân bổ phía máy chủ hoạt động như thế nào khi người dùng di chuyển từ web sang ứng dụng di động?
Tại sao các ứng dụng di động cần phân bổ phía máy chủ trong các môi trường chú trọng quyền riêng tư?
Những điểm chính cho các đội ngũ kỹ thuật
Khi các nền tảng AI ngày càng dựa vào suy luận đám mây hỗn hợp, các nhà phát triển cần thiết kế lại sản phẩm xung quanh quyền riêng tư, sự đồng ý minh bạch và định tuyến dữ liệu an toàn. Các kiến trúc dữ liệu tiến hóa đòi hỏi một sự chuyển dịch căn bản trong cách chúng ta xây dựng và đo lường trải nghiệm kỹ thuật số. Khi các proxy phi trạng thái và trình thu thập headless trở thành những người tiêu dùng tiêu chuẩn của nội dung web, các mô hình phân bổ phía khách hàng truyền thống sẽ tiếp tục suy giảm. Việc dựa vào cookie và referrer tiêu chuẩn không còn đủ để bảo mật các đường ống dữ liệu thúc đẩy việc thu hút người dùng.
Thay vì thay thế GPU, NVIDIA đang định nghĩa lại cách triển khai các khối lượng công việc suy luận. Khi việc phục vụ AI làm lu mờ việc huấn luyện mô hình, các hệ thống không đồng nhất kết hợp GPU với các ASIC chuyên dụng có khả năng trở thành kiến trúc tiêu chuẩn cho cơ sở hạ tầng AI doanh nghiệp. Sự kết hợp phần cứng tối ưu phụ thuộc vào đặc điểm khối lượng công việc, yêu cầu độ trễ, kích thước mô hình và kinh tế cơ sở hạ tầng. Trong khi suy luận không đồng nhất mang lại lợi thế chi phí đáng kể, các kiến trúc tiêu chuẩn sẽ tiếp tục tiến hóa cùng với các bộ tăng tốc chuyên biệt. Đối với các đội ngũ tăng trưởng di động, việc áp dụng cơ sở hạ tầng phân bổ phía máy chủ có thể giúp bảo tồn thông tin thu hút trên các hành trình kỹ thuật số ngày càng phân mảnh. OpoInstall cung cấp lớp phân bổ này bằng cách bảo tồn ngữ cảnh thu hút trên các môi trường web, cửa hàng ứng dụng và ứng dụng gốc.
Share this article



