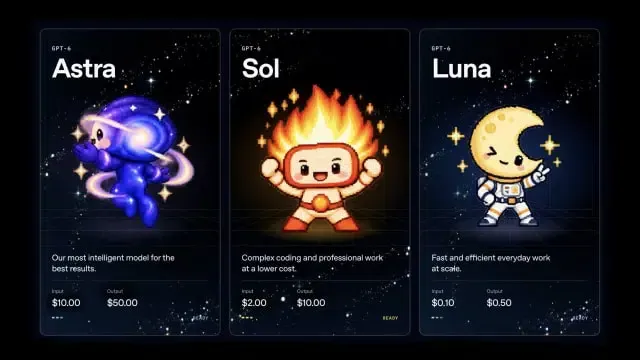
OpenAI giảm một nửa chi phí API Sol? OpenAI đã chính thức công bố tính thương mại hóa của GPT-6 Sol và GPT-6 Luna vào ngày 22 tháng 9 năm 2026, hạ giá token API từ 50% trở lên so với mức giá ưu đãi GPT-5.6 trước đây trên các điểm cuối tiêu chuẩn. Đối với việc xử lý tiêu chuẩn các prompt chứa tối đa 272K token đầu vào, GPT-6 Sol có giá $2.00 cho mỗi triệu token đầu vào và $10.00 cho mỗi triệu token đầu ra, trong khi mẫu GPT-6 Luna nhỏ hơn có giá $0.10 đầu vào và $0.50 đầu ra cho mỗi triệu token. Khi OpenAI giảm một nửa chi phí API Sol trên các bậc nhà phát triển tiêu chuẩn, sự giảm phát năng lực tính toán cấu trúc sẽ làm thay đổi các giới hạn vận hành của phần mềm tạo sinh. Mức giá đơn vị thấp hơn giúp cho các vòng lặp tác vụ đệ quy, trích xuất hàng loạt nền và các tác nhân tự động đa bước trở nên khả thi về mặt kinh tế ở quy mô lớn. Tuy nhiên, đối với các kiến trúc sư hệ thống, kỹ sư độ tin cậy và lập trình viên backend, việc giảm ma sát tài chính này lại làm nổi bật các thách thức về khả năng mở rộng ở hạ nguồn, chuyển trọng tâm kỹ thuật từ ngân sách token sang các ranh giới giới hạn tốc độ, giới hạn đồng thời, đường ống telemetry và các điểm nghẽn chống nghẽn.
Vấn Đề Vận Hành & Điểm Nghẽn Tài Chính
Trong suốt các giai đoạn đầu áp dụng LLM doanh nghiệp trong môi trường sản xuất, mức phí token danh định đóng vai trò như một cơ chế kiểm soát kiến trúc không chính thức. Chi phí suy luận cao buộc các nhóm phát triển phải coi các lệnh gọi mô hình là các giao dịch riêng biệt do người dùng khởi tạo. Các ứng dụng phụ thuộc nhiều vào sự phê duyệt có con người tham gia, lịch sử trò chuyện có giới hạn và các tác nhân theo lịch trình được điều tiết nghiêm ngặt để đảm bảo hóa đơn hàng tháng của nhà cung cấp vẫn có thể dự đoán được. Việc giới thiệu các mức giảm giá mô hình vĩnh viễn tầm trung này đặt ra thách thức cho các sự đánh đổi trong quá khứ, dịch chuyển các mối quan tâm về kỹ thuật hệ thống từ định giá mô hình sang độ bền vững của cơ sở hạ tầng backend.
Tổng Quan Nhanh
- Giảm Giá Cơ Bản: Vào ngày 22 tháng 9 năm 2026, OpenAI đã giới thiệu GPT-6 Sol với giá $2.00 đầu vào / $10.00 đầu ra và GPT-6 Luna với giá $0.10 đầu vào / $0.50 đầu ra cho mỗi triệu token đối với việc xử lý Tiêu chuẩn trên các prompt lên tới 272K token, thể hiện mức giảm danh định 50% trở lên so với giá API ưu đãi của GPT-5.6.
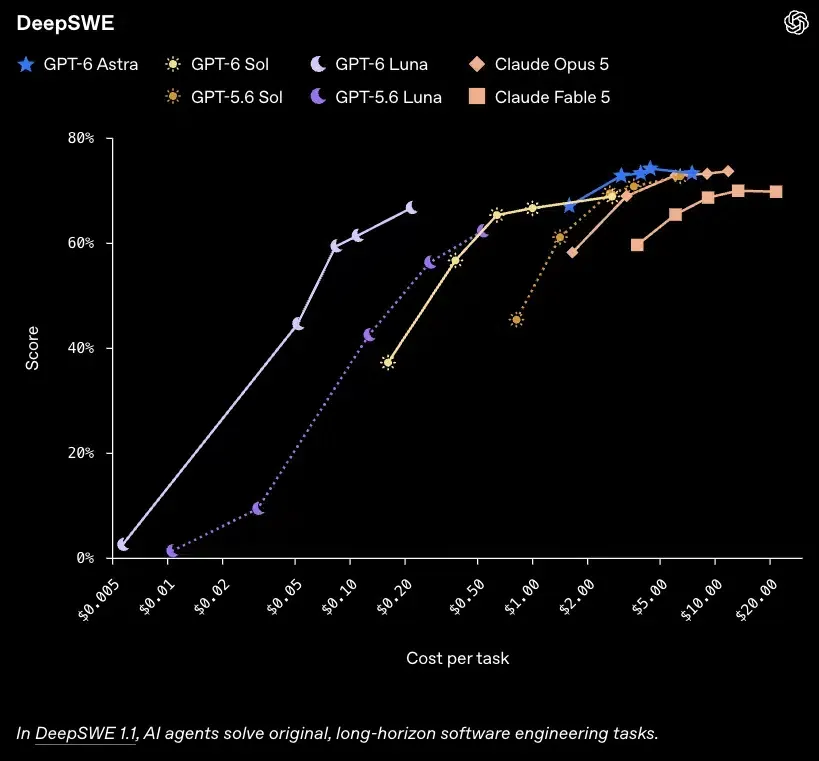
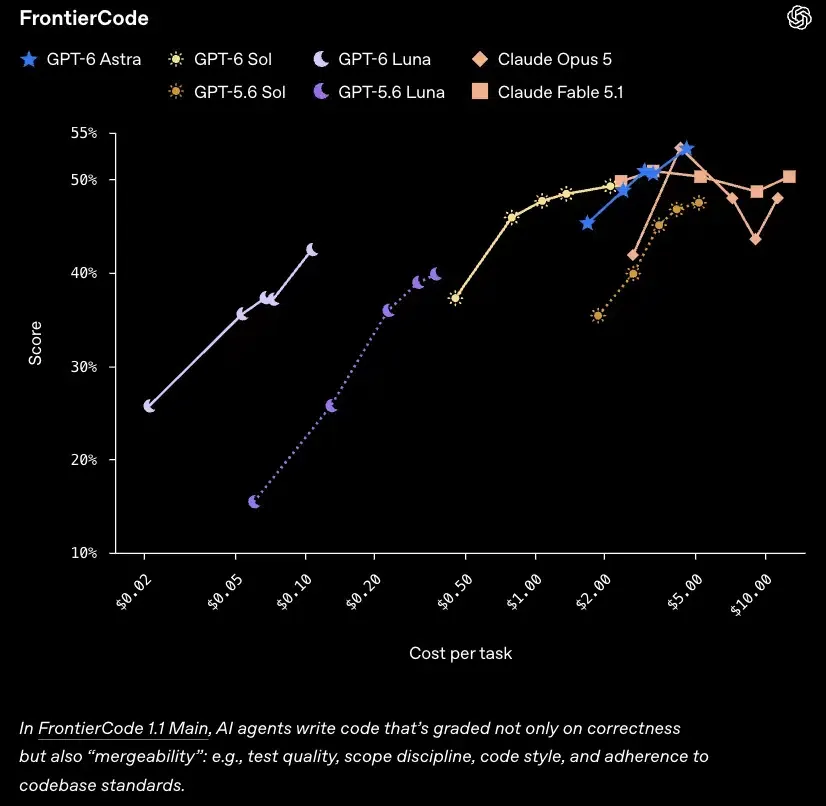
- Kinh Tế Điểm Chuẩn Cấp Tác Vụ: Trên AutomationBench 1.0.6, OpenAI báo cáo rằng GPT-6 Sol được cấu hình với mức độ suy luận xhigh đã đạt điểm số quy trình làm việc 33.2% với chi phí trung bình được báo cáo là $0.27 cho mỗi tác vụ đã thử nghiệm, chuyển đổi việc đánh giá của nhà phát triển từ giá token thô sang chi phí cho mỗi đơn vị công việc đã thử nghiệm.
- Động Lực Lưu Trệm Prompt (Prompt Caching): Nền tảng mang lại mức giảm giá tự động 90% cho việc đọc token đầu vào đã lưu vào bộ nhớ đệm (được tính phí bằng 0.1× tốc độ token đầu vào cơ sở), trong khi việc ghi bộ nhớ đệm ban đầu được tính phí bằng 1.25× tốc độ token đầu vào chưa lưu vào bộ nhớ đệm, đòi hỏi phải chuẩn hóa tiền tố cẩn thận để duy trì tỷ lệ truy cập bộ nhớ đệm cao trên các lần chạy đa bước động.
Như được chi tiết qua Tài Liệu Tham Khảo Định Giá API Nhà Phát Triển OpenAI chính thức và Thông Báo Cộng Đồng OpenAI, các cấu trúc định giá này bắt nguồn từ những cải tiến liên tục trong các đường ống suy luận cấp thấp và hệ thống lưu đệm KV. Tuy nhiên, khi chi phí thực hiện các chuỗi tác vụ tự động giảm đáng kể, các nhóm kỹ thuật sẽ mở rộng phạm vi của các tác vụ nền của họ. Sàn kinh tế trước đây từng ngăn cản các tác nhân nền chạy liên tục các lượt thăm dò, các đợt xem xét mã tự động hoặc các đường ống trích xuất tài liệu nhiều giai đoạn nay đã được hạ xuống.
Trên thị trường, nhiều nhà cung cấp mô hình nền tảng đã giảm hoặc cấu trúc lại giá API trên các bậc nhà phát triển. Anthropic phát hành Claude Opus 5.5 bên cạnh các thông số kỹ thuật được cập nhật trên Thông Số Kỹ Thuật Nền Tảng Anthropic Claude Opus 5.5, báo giá $4 cho mỗi triệu token đầu vào, $0.20 cho mỗi triệu lượt đọc đầu vào được lưu đệm và $20 cho mỗi triệu token đầu ra, nêu bật mức tiêu thụ token giảm trên các điểm chuẩn tái cấu trúc mã. Đồng thời, Google duy trì mức giá giới thiệu ưu đãi cho Gemini 3.8 Flash được tài liệu hóa trên Google AI dành cho Nhà Phát Triển, và các bản phát hành mã nguồn mở như MiMo-V2.6-Pro của Xiaomi cung cấp cho các nhóm tự lưu trữ các tùy chọn chi phí token mạnh mẽ theo các giấy phép phần mềm linh hoạt.
Khi chi phí mô hình giảm, hành vi phát triển thay đổi. Các nhóm kỹ thuật triển khai các vòng lặp đệ quy sâu hơn, đưa tài liệu doanh nghiệp toàn diện vào các system prompt và cấu trúc logic thử lại tự động trên các biểu đồ tác vụ phức tạp. Những gì bắt đầu như việc giảm chi phí ở lớp API có thể chuyển các độ trễ và các đợt bùng nổ lưu lượng truy cập sang các dịch vụ nội bộ. Nếu một worker điều phối phát hành hàng chục lệnh gọi mô hình tuần tự hoặc song song cho một giao dịch người dùng duy nhất, các nhóm cơ sở dữ liệu nội bộ, các cụm lưu trữ phụ trợ, các đường ống telemetry và các trình giới hạn tốc độ phải hấp thụ tải trọng kết quả.
Nguyên Nhân Gốc Rễ Hệ Thống & Chuỗi Yêu Cầu Phi Trực Quan
Khi các ứng dụng khách chuyển từ giao diện trò chuyện tương tác sang tự động hóa nền phi trực quan, các cấu hình yêu cầu ngược dòng thay đổi đáng kể. Một sự kiện kinh doanh đơn lẻ có thể kích hoạt một đường ống tự động kiểm tra lược đồ, đánh giá các biến môi trường, gọi các công cụ bên ngoài và xác minh kết quả đầu ra qua nhiều lượt liên tục.
+-----------------------------------------------------------------------------------------+
|                  RECURSIVE AGENT EXECUTION & BACKPRESSURE BOTTLENECK                    |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ User Web / App Trigger ]                                                             |
|         |                                                                               |
|         v                                                                               |
|  [ Ingestion API Gateway ]                                                              |
|         |                                                                               |
|         +---> Spawns Autonomous Worker Instance                                         |
|         |                                                                               |
|         v                                                                               |
|  [ Autonomous Orchestration Loop (GPT-6 Sol / Luna) ]                                   |
|         |                                                                               |
|         +--- Step 1: Query Context (Cache Read) -----------------+                      |
|         |                                                        |                      |
|         +--- Step 2: Tool Execution (Uncached Call)              |                      |
|         |                                                        |                      |
|         +--- Step 3: Self-Correction Validation                  |                      |
|         |                                                        v                      |
|         +--- Step 4: Recursive Execution Fork ----> [ Bursting Internal RPCs ]          |
|                                                                  |                      |
|  [ Downstream System Bottlenecks ]                               |                      |
|         |                                                        |                      |
|         +--- Internal Microservices <-- (Connection Starvation) -+                      |
|         +--- PostgreSQL / Cache Stores <-- (Connection Pool Saturation)                 |
|         +--- Distributed Telemetry Stream <-- (Lossy Drop Buffer Applied)               |
|         +--- Audit Compliance Store <-- (Durable / Replayable Queue Lag)                |
|         +--- Upstream Provider Thresholds <-- (HTTP 429 Rate Limit Exhaustion)          |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
Thực Thi Tác Nhân Đệ Quy và Nhân Lên Tính Đồng Thời
Trong các hệ thống web tương tác truyền thống, khối lượng yêu cầu phản ánh nhịp điệu tương tác của con người. Mỗi luồng HTTP thường ánh xạ tới một tương tác người dùng rõ ràng, với mức độ phân nhánh tổng thể thấp hơn và nhịp độ bị giới hạn bởi thời gian suy nghĩ của con người. Thời gian chạy của máy khách gửi một payload, đợi phản hồi và tạm dừng trước khi bắt đầu các tương tác tiếp theo.
So Sánh Cấu Hình Yêu Cầu Khái Niệm: Tương Tác vs. Tác Nhân
| Chỉ Số Kiến Trúc | Luồng Người Dùng Tương Tác | Vòng Lặp Tác Nhân Tự Động |
|---|---|---|
| Mô Hình Đồng Thời | Sự phân nhánh yêu cầu theo nhịp độ con người thường thấp hơn | 1 Sự Kiện Tiếp Nhận = N Lệnh Gọi Con Chuỗi |
| Thời Gian Thực Thi | Được điều tiết theo phản hồi và thời gian suy nghĩ của người dùng | Tiến hành tự động cho đến khi các giới hạn chính sách can thiệp |
| Vô Hiệu Hóa Ngữ Cảnh | Payload mới cho mỗi phiên | Phụ thuộc nhiều vào ngữ cảnh đã lưu đệm |
| Xử Lý Lỗi | Người dùng thử lại khi có lỗi | Thử lại tự động bằng chương trình |
| Điểm Nghẽn Hệ Thống | Băng thông gateway frontend | Giới hạn pool cơ sở dữ liệu nội bộ |
| Thác Lỗi | Cô lập trong một phiên duy nhất | Có thể gây bão hòa hàng đợi |
Khi các hệ thống tích hợp các tác nhân tự động, nhịp độ này sẽ bị tách rời. Một sự kiện được kích hoạt duy nhất có thể tạo ra một chuỗi các lệnh gọi tự động không bị ngắt quãng. Nếu một tác nhân gặp lỗi tạm thời hoặc đầu ra công cụ kém định dạng, logic thử lại ngây thơ có thể tạo ra các đợt yêu cầu nhanh chóng đối với các dịch vụ backend. Do chi phí token giảm giúp cho các lần chạy thực thi dài hơn trở nên khả thi về mặt tài chính, các quy trình làm việc tự động có thể mở rộng quy mô khối lượng yêu cầu nền một cách đáng kể, ngay cả với một cơ sở người dùng hoạt động cố định.
Cơ Chế Bộ Nhớ Đệm Prompt: Tái Sử Dụng KV, Chi Phí Ghi và Tính Ổn Định Tiền Tố
OpenAI đã kết hợp các bản phát hành Sol và Luna với các tối ưu hóa trên hệ thống con lưu đệm prompt của mình. Như được tài liệu hóa trong Tài Liệu Lưu Đệm Prompt OpenAI, các token đầu vào khớp với tiền tố đã lưu đệm sẽ nhận được mức giảm giá 90% đối với giá đọc. Lưu đệm prompt chủ yếu làm giảm việc tính toán lại phía mô hình thay vì hoạt động như một cơ chế nén payload mạng đa năng. Trong các tương tác không trạng thái tiêu chuẩn, ứng dụng khách truyền ngữ cảnh yêu cầu, và nhà cung cấp bỏ qua việc tính toán lại các tensor KV cho tiền tố khớp, giúp giảm đáng kể độ trễ thời gian đến token đầu tiên và hóa đơn đầu vào.
Quan trọng là, việc ghi một tiền tố ban đầu vào bộ nhớ đệm phía máy chủ được tính phí bằng 1.25× tốc độ token đầu vào chưa lưu đệm. Việc tối đa hóa hiệu quả chi phí đòi hỏi phải duy trì tính ổn định của tiền tố trên nhiều truy vấn.
### Các Mức Giá Danh Sách API Công Khai Đã Chọn — Không So Sánh Trực Tiếp Giữa Các Nhà Cung Cấp
| Mã Định Danh Mô Hình | Đầu Vào ($/1M Tok) | Đầu Ra ($/1M Tok) | Chính Sách Đọc Bộ Nhớ Đệm |
|---|---|---|---|
| OpenAI GPT-6 Luna (Std) | $0.10 | $0.50 | Giảm giá 90% (0.10×) |
| OpenAI GPT-6 Sol (Std) | $2.00 | $10.00 | Giảm giá 90% (0.10×) |
| OpenAI GPT-6 Astra (Std) | $10.00 | $50.00 | Định Giá Phân Tầng Động |
| Anthropic Opus 5.5 | $4.00 | $20.00 | $0.20/1M Đọc (0.05×) |
| Anthropic Sonnet 5 | $2.00 | $10.00 | Lên đến 90% trên bộ nhớ đệm |
| Google Gemini 3.8 Flash | $0.75 (Giới thiệu) | $3.75 (Giới thiệu) | $0.075/1M Đọc Bộ Nhớ Đệm |
| Xiaomi MiMo-V2.6-Pro | $0.435 | $0.87 | $0.0036/1M Đọc Bộ Nhớ Đệm |
Lưu ý: Tỷ lệ tiêu chuẩn áp dụng cho các bậc ngữ cảnh ngắn (prompt lên đến 272K token đầu vào cho OpenAI). Các nhà cung cấp áp dụng các chi phí ghi bộ nhớ đệm, giới hạn ngữ cảnh và các điều khoản khuyến mại có giới hạn thời gian khác nhau.
Việc bảo tồn tiền tố đòi hỏi phải xử lý cẩn thận các tùy chọn cấu hình API. Trong kiến trúc API của OpenAI, việc thay đổi trực tiếp các tham số nỗ lực suy luận hoặc thay đổi các mảng định nghĩa công cụ sẽ làm thay đổi tiền tố prompt đã được kết xuất và làm mất hiệu lực các trạng thái đã lưu đệm trước đó.
Để bảo tồn ngữ cảnh được lưu đệm trong các phiên làm việc nhiều lượt, các nhà phát triển phải giữ cho các lược đồ công cụ và các hướng dẫn cơ bản theo một thứ tự nhất quán. Nếu cần điều chỉnh thời gian chạy, các nhà phát triển nên cập nhật các tham số thông qua các điều khiển phiên có cấu trúc (như configuration_update) hoặc chuyển đổi thực thi công cụ bằng cách sử dụng tool_choice hoặc allowed_tools thay vì sửa đổi trực tiếp mảng định nghĩa công cụ.
Khi xảy ra lỗi bỏ lỡ bộ nhớ đệm, nhà cung cấp ngược dòng sẽ xử lý lại chuỗi đầu vào mà không có mức giảm giá đọc 90%. Ở quy mô lớn, điều này có thể làm tăng độ trễ suy luận và áp lực thời gian chờ. Đối với việc thực thi tác vụ nhiều bước, việc đánh giá chi phí chuyển từ nhân tử token đơn giản sang các khoản chi tiêu tác vụ đã hoàn thành, như đã thấy trong Báo Cáo của VentureBeat Về Các Điểm Chuẩn GPT-6 Sol và Luna, nơi GPT-6 Sol đạt điểm số 33.2% trên AutomationBench 1.0.6 với mức trung bình $0.27 cho mỗi tác vụ đã thử nghiệm.
Kiến Trúc Telemetry: Tách Biệt Các Chỉ Số Vận Hành Khỏi Kiểm Định Tuân Thủ
Sự bùng nổ của các yêu cầu LLM tự động đặt ra áp lực đáng kể lên các đường ống tuân thủ và khả năng quan sát backend. Các quy trình làm việc của tác nhân có độ đồng thời cao đòi hỏi sự tách biệt rõ ràng về kiến trúc giữa telemetry vận hành và các dấu vết kiểm toán pháp lý.
Các chính sách tuân thủ của doanh nghiệp thường yêu cầu ghi lại siêu dữ liệu phiên, bằng chứng thực thi công cụ và hồ sơ giao dịch. Việc đối xử với telemetry vận hành và dữ liệu tuân thủ giống hệt nhau tạo ra những sự đánh đổi kỹ thuật nghiêm trọng:
- Kênh Kiểm Toán Tuân Thủ và Bảo Mật: Phải cung cấp khả năng phân phối bền vững, có thể phát lại với việc thử lại rõ ràng, tính bền vững và xử lý lỗi vào các kho lưu trữ kiểm toán ghi một lần, được kiểm soát quyền truy cập. Các payload phải nắm bắt siêu dữ liệu có cấu trúc, danh tính người gọi và trạng thái mật mã trong khi khử trùng có hệ thống thông tin nhận dạng cá nhân (PII) và các khóa bí mật. Dưới tải trọng cao, các đường ống này phải áp dụng chống nghẽn hoặc xếp hàng các tác vụ một cách bền vững thay vì loại bỏ các bản ghi.
- Kênh Telemetry Vận Hành: Theo dõi các chỉ số hiệu suất như số lượng token, tỷ lệ truy cập bộ nhớ đệm prompt và độ trễ phản hồi ngược dòng. Bởi vì các dấu vết này được sử dụng để giám sát và gỡ lỗi thời gian thực, chúng có thể được xử lý thông qua các bộ đệm giảm thiểu có giới hạn và mất mát. Nếu các bộ thu thập hạ nguồn chậm lại, ứng dụng có thể loại bỏ an toàn phần telemetry vận hành dư thừa để bảoવા tính sẵn sàng của dịch vụ cốt lõi.
Khi các nhà cung cấp bên ngoài trả về lỗi giới hạn tốc độ HTTP 429, các chính sách thử lại được cấu hình kém có thể gây ra các vấn đề vận hành nghiêm trọng. Các lần thử lại ngay lập tức hoặc các quy trình giảm dần theo cấp số nhân đồng bộ mà không có độ trễ ngẫu nhiên sẽ tạo ra các làn sóng thử lại có thể lan truyền qua các microservice trung gian, tiêu thụ các pool luồng và kết nối cơ sở dữ liệu.
So Sánh Giải Pháp: Sự Đánh Đổi Giữa Tự Xây Dựng vs. Mua Sẵn
Việc quản lý tải trọng vận hành phát sinh từ chi phí suy luận thấp hơn đòi hỏi các tổ chức phải đánh giá các kiến trúc proxy và cổng AI của họ. Các nhóm phải quyết định xem nên tự phát triển các proxy định tuyến, giới hạn tốc độ và telemetry tùy chỉnh trong nhà hay triển khai cơ sở hạ tầng của bên thứ ba chuyên specialized.
+-----------------------------------------------------------------------------------------+
|                 SYSTEM RESILIENCY PIPELINE WITH DECOUPLED TELEMETRY                     |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ Inbound Application Requests ]                                                       |
|         |                                                                               |
|         v                                                                               |
|  [ Sliding-Window Rate Limiter ] <--- Local In-Memory or Distributed Cache              |
|         |                                                                               |
|         +---> Rejects / Delays Excess Concurrency (HTTP 429 Protection)                 |
|         |                                                                               |
|         v                                                                               |
|  [ Prompt Normalization & Cache Alignment Engine ]                                      |
|         |                                                                               |
|         +---> Pins Static System Prompts & Tool Definitions to Base Prefix              |
|         +---> Uses Structured Controls to Modify Session Parameters                     |
|         |                                                                               |
|         v                                                                               |
|  [ Upstream Provider Dispatch (OpenAI / Anthropic / Local API) ]                         |
|         |                                                                               |
|         +---------------------------------------+---------------------------------------+
|         |                                       |                                       |
|         v (Synchronous Fast Path)               |                                       |
|  [ Client Response Assembly ]                   |                                       |
|         |                                       v (Asynchronous Dual Path)              |
|         v                               +-----------------------------------------------+
|  [ Return Payload to App ]              |                                               |
|                                         v (Lossy Ring Buffer)   v (Durable Outbox)      |
|                                    [ Operational Metrics ]  [ Compliance Audit Store ]  |
|                                    (Drops on Congestion)    (Durable / Replayable)      |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
Đường Ống Khả Năng Phục Hồi Tùy Chỉnh Nội Bộ
Việc phát triển cơ sở hạ tầng tùy chỉnh giúp các nhóm kỹ thuật kiểm soát hoàn toàn các chính sách mạng, khử trùng dữ liệu và chiến lược định tuyến. Các tổ chức có thể xây dựng các proxy biên phù hợp chính xác với cấu trúc topology microservice nội bộ của họ.
// Triển khai tham khảo: Token Bucket được đồng bộ hóa với phần dư phân số và bão hòa có giới hạn
package com.example.ai.resilience;

import java.math.BigInteger;
import java.time.Duration;

public final class TokenBucketLimiter {
    private final long maxTokenCapacity;
    private final long refillPeriodNanos;
    private long availableTokens;
    private long lastRefillNanos;
    // Tử số phần dư được chia tỷ lệ trong khoảng [0, refillPeriodNanos)
    private long scaledRemainder;

    public TokenBucketLimiter(long maxTokens, Duration refillPeriod) {
        if (maxTokens <= 0 || refillPeriod.isZero() || refillPeriod.isNegative()) {
            throw new IllegalArgumentException("Invalid boundary configuration for TokenBucketLimiter.");
        }
        this.maxTokenCapacity = maxTokens;
        this.refillPeriodNanos = refillPeriod.toNanos();
        this.availableTokens = maxTokens;
        this.lastRefillNanos = System.nanoTime();
        this.scaledRemainder = 0L;
    }

    public synchronized boolean tryAcquire(long requestedUnits) {
        if (requestedUnits <= 0) {
            return false;
        }
        refillTokens();
        if (requestedUnits > availableTokens) {
            return false;
        }
        availableTokens -= requestedUnits;
        return true;
    }

    private void refillTokens() {
        long nowNanos = System.nanoTime();
        long elapsedNanos = nowNanos - lastRefillNanos;

        if (elapsedNanos <= 0) {
            return;
        }

        // Tăng dấu thời gian cơ sở một cách đơn điệu
        this.lastRefillNanos = nowNanos;

        // Nếu bucket đã đầy, hãy loại bỏ các tín dụng phân số chưa tiêu thụ để ngăn chặn độ lệch thời gian
        if (this.availableTokens >= this.maxTokenCapacity) {
            this.scaledRemainder = 0L;
            return;
        }

        long wholePeriods = elapsedNanos / refillPeriodNanos;
        long remElapsedNanos = elapsedNanos % refillPeriodNanos;

        // Đường đi nhanh: nếu ít nhất một chu kỳ hoàn chỉnh đã trôi qua, bucket sẽ được bổ sung đầy đủ đến dung lượng.
        // Điều này loại bỏ bề mặt tràn phép nhân (wholePeriods * maxTokenCapacity).
        if (wholePeriods > 0) {
            this.availableTokens = maxTokenCapacity;
            this.scaledRemainder = 0L;
            return;
        }

        // Dưới các khoảng thời gian phụ micro-interval, tính toán chính xác các token phân số bằng số học BigInteger
        BigInteger bigRemNanos = BigInteger.valueOf(remElapsedNanos);
        BigInteger bigCapacity = BigInteger.valueOf(maxTokenCapacity);
        BigInteger bigRemainder = BigInteger.valueOf(scaledRemainder);
        BigInteger bigPeriod = BigInteger.valueOf(refillPeriodNanos);

        // totalWork = (remElapsedNanos * maxTokenCapacity) + scaledRemainder
        BigInteger totalWork = bigRemNanos.multiply(bigCapacity).add(bigRemainder);
        BigInteger[] divAndRem = totalWork.divideAndRemainder(bigPeriod);

        long tokensGenerated = divAndRem[0].longValue();
        this.scaledRemainder = divAndRem[1].longValue();

        if (tokensGenerated > 0) {
            long spaceLeft = maxTokenCapacity - availableTokens;
            if (tokensGenerated >= spaceLeft) {
                this.availableTokens = maxTokenCapacity;
                this.scaledRemainder = 0L;
            } else {
                this.availableTokens += tokensGenerated;
            }
        }
    }
}
Tuy nhiên, việc phát triển nội bộ đòi hỏi bảo trì kỹ thuật liên tục. Các nhóm phải thích ứng thủ công với các bản cập nhật API của nhà cung cấp, xử lý các giới hạn tốc độ đang tiến hóa trên nhiều nhà cung cấp và quản lý các hàng đợi telemetry phân tán. Chi phí bảo trì này có thể chuyển hướng nguồn lực nhà phát triển nội bộ khỏi các tính năng sản phẩm cốt lõi.
Cổng Thương Mại và Công Cơ Sở Hạ Tầng
Để tránh việc xây dựng các tính năng này từ đầu, nhiều doanh nghiệp triển khai các proxy API được quản lý, cổng LLM và mặt phẳng điều khiển biên. Một số cổng được quản lý cung cấp sự điều phối giới hạn tốc độ nhận thức nhà cung cấp, khả năng quan sát, kiểm soát chính sách và định tuyến nhận thức bộ nhớ đệm; các khả năng chính xác thay đổi tùy theo nhà vendor, và việc tối ưu hóa tiền tố thường vẫn đòi hỏi kỷ luật yêu cầu cấp độ ứng dụng.
Các nền tảng thương mại cho phép các nhóm kỹ thuật thực thi hạn ngạch chi phí cho mỗi môi trường, cấu trúc định tuyến dự phòng tự động trên các họ mô hình và tước bỏ thông tin khách hàng nhạy cảm trước khi ghi nhật ký siêu dữ liệu yêu cầu. Các cổng được xây dựng có mục đích quản lý các đợt bùng nổ đồng thời, kiểm toán xu hướng tiêu thụ API và bảo vệ các microservice hạ nguồn trên các môi trường ứng dụng phức tạp.
Ma Trận Quyết Định: Đường Ống Nội Bộ vs. Nền Tảng Được Quản Lý
| Tiêu Chí Đánh Giá | Công Cụ Phục Hồi Nội Bộ | Cơ Sở Hạ Tầng Định Tuyến Được Quản Lý |
|---|---|---|
| Nỗ Lực Phát Triển Ban Đầu | Cao (3-6 tuần kỹ thuật) | Thấp (Tích hợp qua API tiêu chuẩn) |
| Bảo Trì Giao Thức | Trách nhiệm liên tục của nhóm | Được xử lý bởi các bản cập nhật của nhà cung cấp |
| Kiểm Soát Vận Hành | Khả năng hiển thị stack hoàn chỉnh | Bị giới hạn bởi giao diện nhà cung cấp |
| Tinh Chỉnh Bộ Nhớ Đệm Prompt | Đòi hỏi proxy tùy chỉnh | Phụ thuộc nhà cung cấp; thường đòi hỏi sự hợp tác của ứng dụng |
| Cô Lập Telemetry | Quản lý hàng đợi tùy chỉnh | Phụ thuộc nhà cung cấp |
| Hồ Sơ Chi Phí Tài Chính | Chi phí tiền lương kỹ thuật | Phí SaaS / sử dụng định kỳ |
Danh Sách Kiểm Tra Tích Hợp & Lịch Trình Quản Trị
Các tổ chức mở rộng quy mô sử dụng mô hình của họ sau khi giảm giá GPT-6 Sol và Luna có thể sử dụng khung vận hành này để ngăn chặn quá tải hệ thống:
+-----------------------------------------------------------------------------------------+
|                  ENTERPRISE LLM INFRASTRUCTURE READINESS CHECKLIST                      |
+-----------------------------------------------------------------------------------------+
| [ ] Audit client applications to identify unbounded recursive model calling loops       |
| [ ] Set hard timeout limits and non-linear retry backoffs with randomized jitter        |
| [ ] Implement local and edge token-bucket rate limiters ahead of upstream calls          |
| [ ] Organize prompt structures to maximize prompt caching prefix reuse                   |
| [ ] Separate lossy operational telemetry from durable, replayable audit trails           |
| [ ] Add runtime sampling to strip raw prompt bodies from high-frequency traces          |
| [ ] Monitor HTTP 429 status trends and set automated backpressure triggers              |
| [ ] Configure cost alerts and circuit breakers to catch runaway automated jobs          |
+-----------------------------------------------------------------------------------------+
Cấu Hình Đường Ống Telemetry
Các hệ thống quan sát phải tách biệt việc ghi nhật ký prompt khỏi các đường dẫn yêu cầu thời gian thực. Khi xử lý khối lượng công việc của tác nhân tần suất cao, các ứng dụng nên ghi siêu dữ liệu telemetry vào các hàng đợi bất đồng bộ có giới hạn bộ nhớ, ngăn ngừa tình trạng đình trệ I/O nếu các bộ thu telemetry hạ nguồn chậm lại.
// Triển khai tham khảo: Trình ghi nhật ký telemetry giới hạn bộ nhớ với tính năng loại bỏ tải mất mát
package com.example.ai.resilience;

import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.BlockingQueue;
import java.util.concurrent.atomic.AtomicLong;

public final class BoundedTelemetryQueue {
    public static final class LogPayload {
        public final String traceId;
        public final String modelId;
        public final long promptTokens;
        public final long completionTokens;
        public final boolean cacheHit;

        public LogPayload(String traceId, String modelId, long pTokens, long cTokens, boolean hit) {
            this.traceId = traceId;
            this.modelId = modelId;
            this.promptTokens = pTokens;
            this.completionTokens = cTokens;
            this.cacheHit = hit;
        }
    }

    private final BlockingQueue<LogPayload> internalQueue;
    private final AtomicLong droppedEvents = new AtomicLong(0);

    public BoundedTelemetryQueue(int maxQueueCapacity) {
        if (maxQueueCapacity <= 0) {
            throw new IllegalArgumentException("Queue capacity must be positive.");
        }
        this.internalQueue = new ArrayBlockingQueue<>(maxQueueCapacity);
    }

    public boolean recordEvent(LogPayload payload) {
        if (payload == null) {
            return false;
        }
        // Gửi không chặn: loại bỏ telemetry dưới tải để bảo vệ tính ổn định của ứng dụng
        boolean accepted = internalQueue.offer(payload);
        if (!accepted) {
            droppedEvents.incrementAndGet();
        }
        return accepted;
    }

    public LogPayload pollEvent() {
        return internalQueue.poll();
    }

    public long getDroppedEventCount() {
        return droppedEvents.get();
    }
}
Các Câu Hỏi Thường Gặp (FAQ)
Mức giá API chính thức cho GPT-6 Sol và Luna là gì?
Làm thế nào để việc lưu đệm prompt làm giảm chi phí cho các cuộc trò chuyện dài?
Tại sao các token rẻ hơn lại làm tăng rủi ro vận hành backend?
Những Điểm Chính Dành Cho Các Nhóm Kỹ Thuật
Việc ra mắt GPT-6 Sol và Luna thúc đẩy một xu hướng rộng lớn hơn: trí thông minh biên đang trở nên rẻ hơn và dễ tiếp cận hơn. Khi chi phí token đơn vị giảm mạnh, các ràng buộc tài chính không còn là cơ chế kiểm soát hiệu quả cho các kiến trúc phần mềm.
Khi các tổ chức áp dụng các tác nhân tần suất cao và cấu trúc topology mô hình đa bậc, kỹ thuật vận hành trở nên quan trọng đối với sự thành công của doanh nghiệp. Các nhóm phải vượt qua việc đánh giá các mô hình chỉ bằng giá token danh định hoặc điểm số điểm chuẩn. Độ tin cậy lâu dài sẽ phụ thuộc vào mức độ hiệu quả mà các hệ thống quản lý tính đồng thời, căn chỉnh ngữ cảnh prompt để tái sử dụng bộ nhớ đệm, xử lý giới hạn tốc độ ngược dòng một cách uyển chuyển và tách biệt telemetry khỏi các đường dẫn ứng dụng quan trọng. Các tổ chức xây dựng cơ sở hạ tầng có khả năng phục hồi sẽ mở rộng quy mô thành công các quy trình làm việc của tác nhân tự động mà không làm giảm thời gian hoạt động của ứng dụng hoặc độ ổn định của hệ thống.
Nguồn Chính & Tài Liệu Tham Khảo
-
Tài Liệu Tham Khảo Định Giá API Nhà Phát Triển OpenAI: Thẻ giá nhà phát triển chính thức, giới hạn cửa sổ ngữ cảnh (ngưỡng tiêu chuẩn ≤272K) và lịch trình định giá đọc/ghi bộ nhớ đệm cho GPT-6 Sol, Luna và Astra.
-
Thông Báo Cộng Đồng OpenAI: Công bố công khai xác nhận việc giảm giá cơ bản 50% so với các bậc ưu đãi GPT-5.6 và chi tiết triển khai mốc quan trọng.
-
Thông Số Kỹ Thuật Lưu Đệm Prompt OpenAI: Tài liệu kiến trúc về việc tái sử dụng tiền tố Key-Value phía máy chủ, chi phí ghi bộ nhớ đệm và các quy tắc vô hiệu hóa cấu hình.
-
Thông Số Kỹ Thuật Nền Tảng Anthropic Claude Opus 5.5: Thông số kỹ thuật phát hành chính thức xác nhận mức giá token $4 đầu vào / $20 đầu ra / $0.20 đọc bộ nhớ đệm và hiệu suất điểm chuẩn.
-
Tổng Quan Về Anthropic Claude Sonnet 5: Thẻ giá nhà phát triển chính thức và các chỉ số hiệu quả lưu đệm prompt ($2 đầu vào / $10 đầu ra / giảm giá bộ nhớ đệm lên đến 90%).
-
Thẻ Giá Google AI dành cho Nhà Phát Triển: Tổng quan về thẻ giá nhà phát triển và các chính sách định giá giới thiệu cho Gemini 3.8 Flash.
-
Định Giá API Chính Thức & Lịch Trình Tỷ Lệ Xiaomi MiMo: Tỷ lệ token trả phí theo mức sử dụng chính thức ở nước ngoài cho suy luận MiMo-V2.6-Pro ($0.435 đầu vào / $0.87 đầu ra / $0.0036 truy cập bộ nhớ đệm).
-
Báo Cáo của VentureBeat Về Các Điểm Chuẩn GPT-6 Sol và Luna: Đưa tin về kinh tế phát hành, đảm bảo định giá vĩnh viễn và số liệu chi phí tác vụ AutomationBench 1.0.6 ($0.27 cho mỗi tác vụ đã thử nghiệm).
Share this article