Anthropic Sonnet 5.5 速度提升 30%?Anthropic 正式發表了 Claude Sonnet 5.5,據該實驗室報告指出,其輸出生成速度提升超過 30%,且每個完成任務的成本降低高達 30%。隨著生成式人工智慧平台從實驗原型轉向大規模生產系統,軟體工程團隊在控管 Token 消耗與運行延遲方面面臨日益嚴峻的壓力。過去,企業架構師普遍認為要達到頂尖的編碼效能,必須部署規模最大、成本最高的旗艦模型。然而今日,由於優化後的中階架構能以更少的運算步驟與工具呼叫來解決複雜的軟體工程難題,自動化開發工具的基礎經濟模型正轉向追求執行效率。
生產經濟學:為何任務完成成本比單一 Token 價格更重要
重點總覽
- Anthropic 於 2026 年 9 月 28 日發表 Claude Sonnet 5.5,提供超過 30% 的輸出速度提升,並將每個任務的完成成本降低最多 30%。
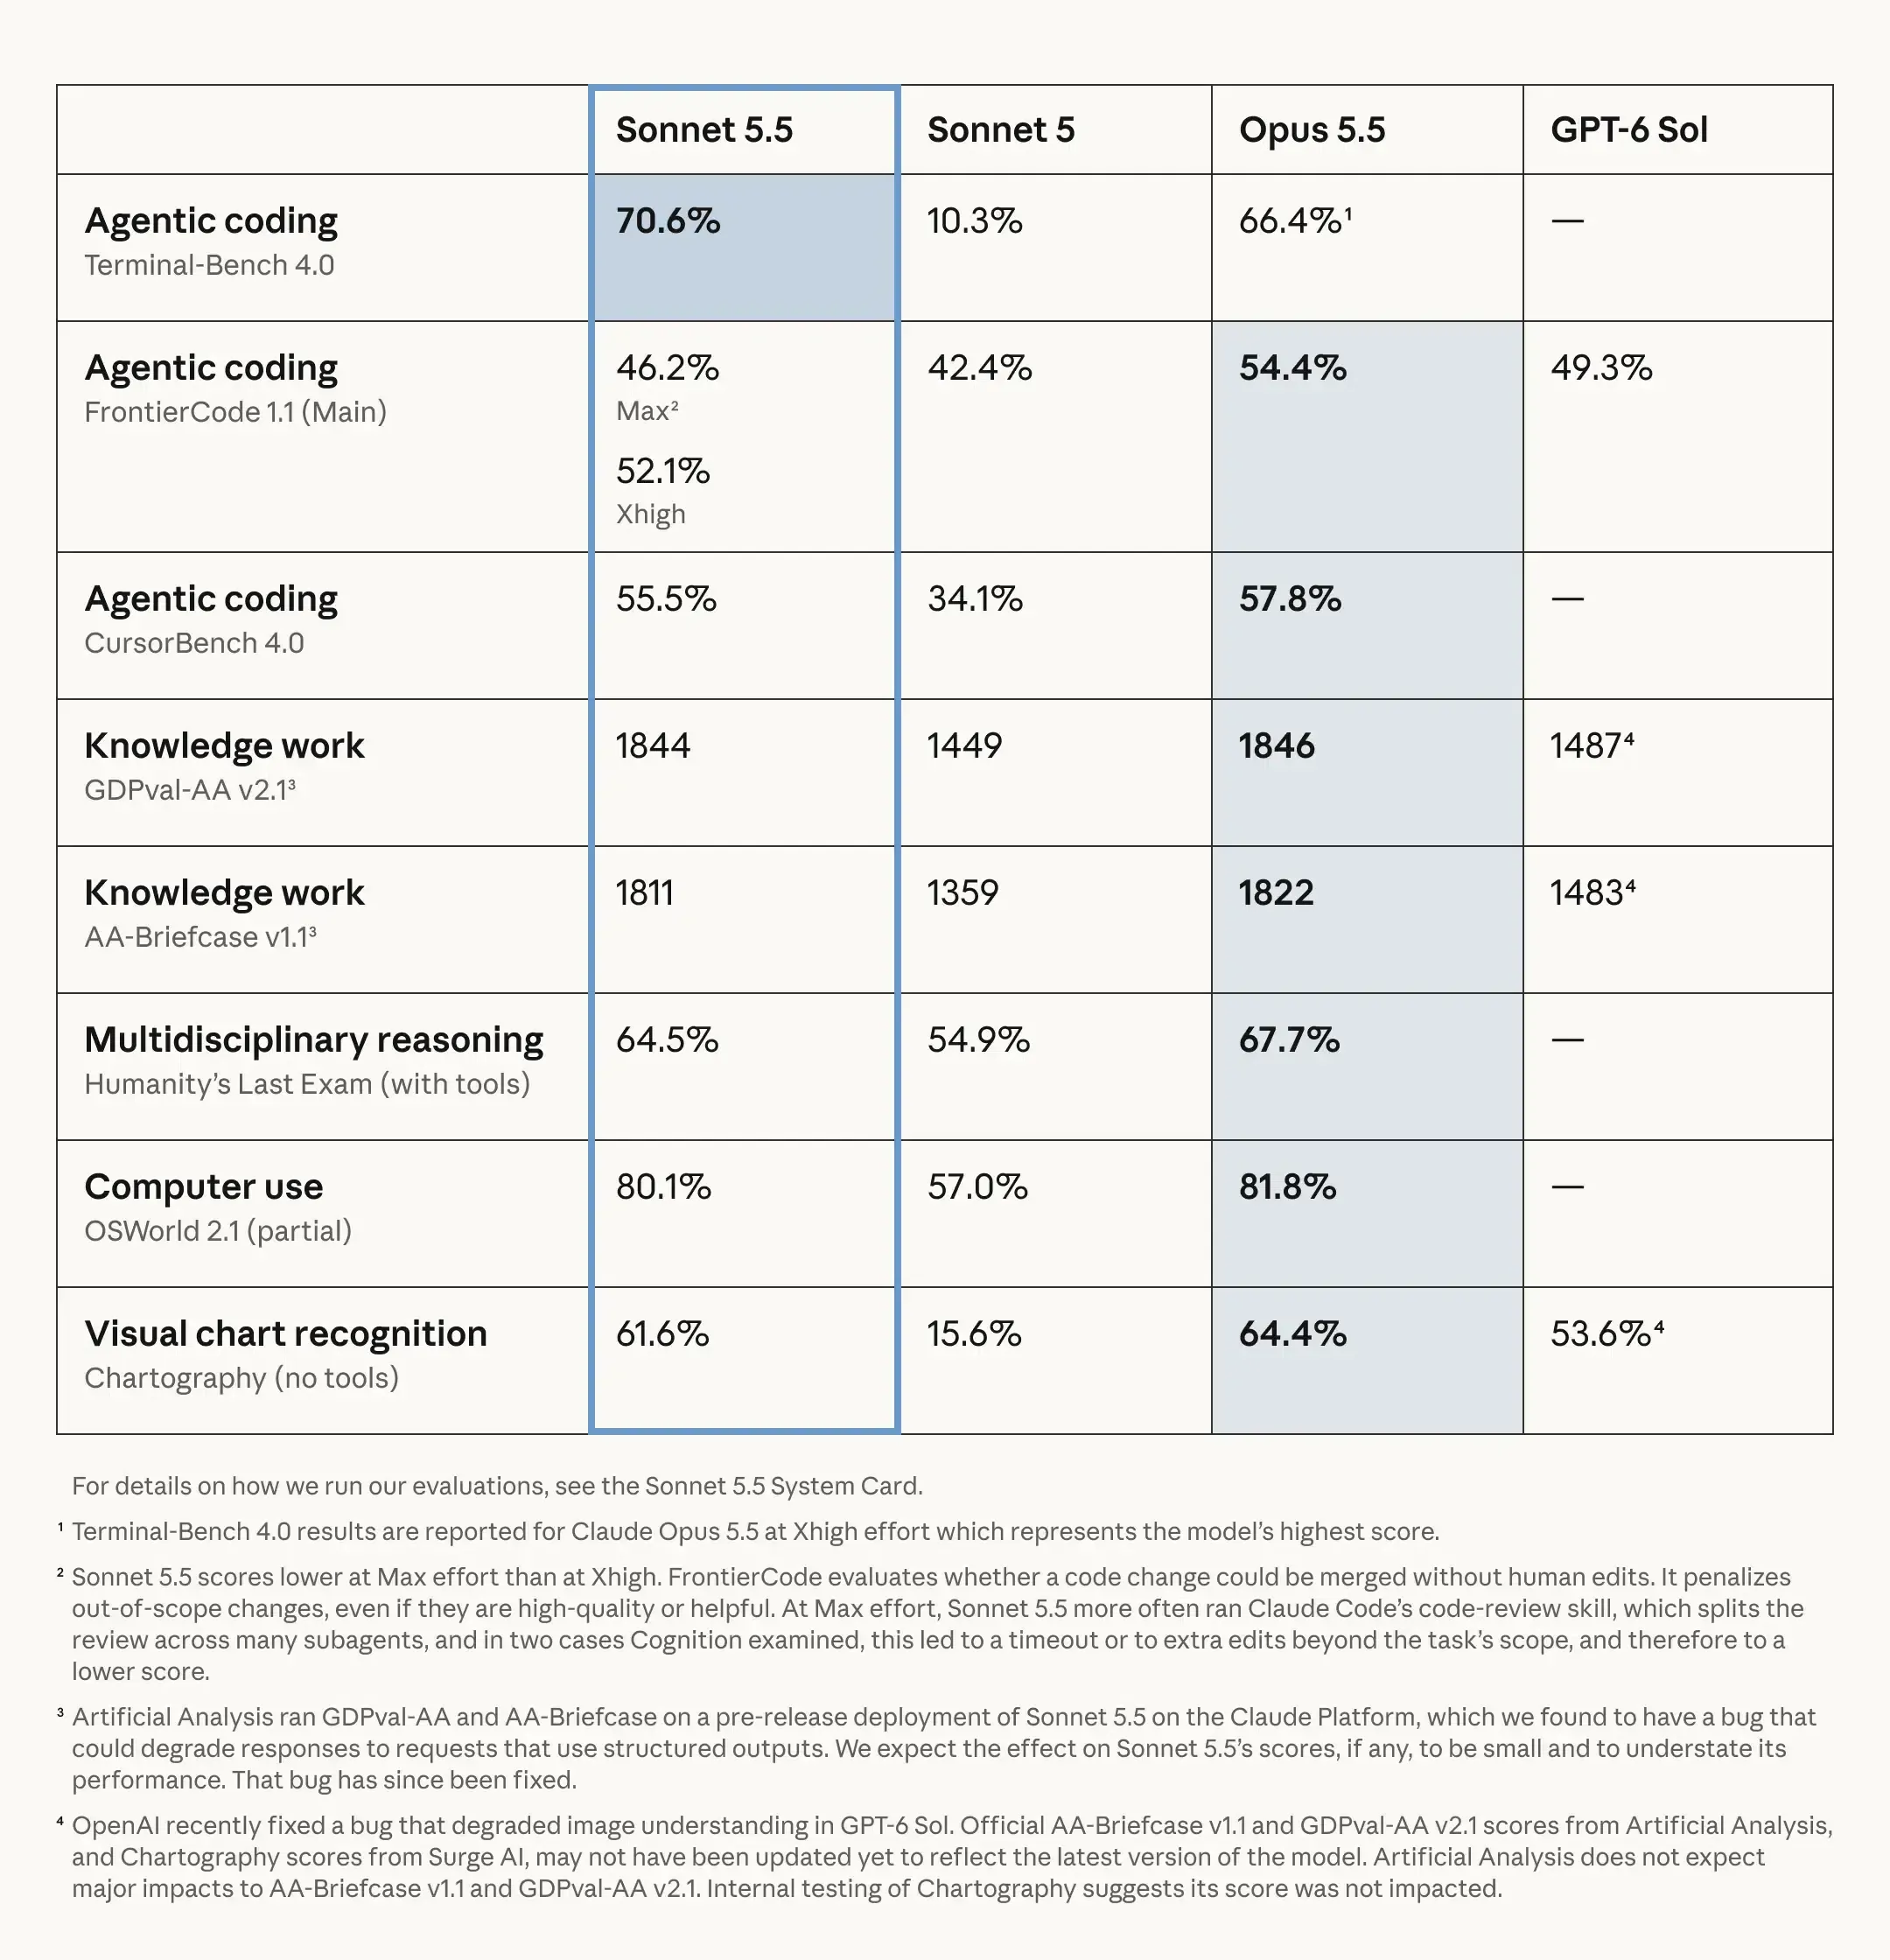
- 在 Terminal-Bench 4.0 的 Agent 編碼評測中,Sonnet 5.5 獲得 70.6% 的分數,超越了旗艦級 Claude Opus 5.5(66.4%)與 Sonnet 5(10.3%)。
- API Token 定價維持在每百萬輸入 Token 2 美元及每百萬輸出 Token 10 美元,透過減少執行步驟與批次工具呼叫來實現成本削減。
部署自動化軟體工程 Agent 的商業可行性,過去常受限於沉重的經濟負擔。運行多步驟開發工具(如檢查程式庫、執行 Shell 指令、迭代修復單元測試)會消耗龐大的 Token 數量。雖然頂級模型展現了卓越的推理深度,但其高額的 Token 成本與較長的生成延遲,使得持續性的無人值守執行對於擴展中的軟體企業而言變得相當昂貴。
在評估開發者基礎設施時,API 的標價往往掩蓋了完成工作的真實成本。一個單 Token 價格較低的模型,若需透過多次重複的工具呼叫與重試來完成任務,其最終成本遠高於能夠以較少執行步驟解決問題的模型。這一動態變化在關於 Sonnet 5.5 的產業報導中有詳細探討,強調了任務完成成本如何與原始 Token 定價脫鉤。
Anthropic 對 Claude Sonnet 5.5 的架構設計旨在直接解決這些作業瓶頸。在維持每百萬輸入 Token 2 美元與輸出 10 美元的 API 基礎費率同時,該模型透過大幅減少推理步驟,實現了高達 30% 的淨任務成本節省。Anthropic 發佈的客戶測試報告突顯了生產工作負載中的顯著效率增長:
- Box 指出 Sonnet 5.5 的運作速度提升 2.4 倍,同時減少了 12% 的總 Token 使用量來重新檢查原始文件並識別程式碼回歸。
- Zendesk 觀察到支援工單處理速度提升 20%,且自動化決策錯誤較現有生產模型更少。
- Slack 顯示該模型在離線機器人評估中表現優於 Sonnet 5,且無需修改提示詞(Prompt),輸出 Token 消耗減少約 14%。
- Lovable 發現 Sonnet 5.5 在自動化應用程式建置過程中,所需的工具呼叫次數減少約三分之一,Shell 執行次數減半。
- Base44 驗證該模型平均在 3.6 次迭代內完成完整應用建置,相較於 Opus 5 的 7.7 次迭代更為高效。
這些結果說明了執行效率如何從根本上改變開發者的生產力。藉由減少失敗的工具呼叫並消除冗餘迭代,中階模型為持續性的企業自動化奠定了永續基礎。
技術剖析:評估編碼基準與子代理(Subagent)擴展
中階模型在特定技術基準上超越旗艦模型的現象,反映了基礎模型後訓練階段的轉變。早期的擴展定律認為,模型參數量是決定智慧程度的主要因素。然而,複雜的代理任務(如瀏覽終端環境、編輯龐大的儲存庫)極度依賴上下文管理、精確的工具使用準則與範圍控制。
像 Opus 5.5 這樣的旗艦模型擁有龐大的推理能力,擅長處理模糊、開放式的架構決策。然而,過深的推理深度有時會在嚴格定義的任務中引入額外的作業負載。例如,在 FrontierCode 基準測試中,Anthropic 指出 Sonnet 5.5 在「最大努力」(Max effort)模式下的評分反而低於「極高努力」(Xhigh),因為它更頻繁地調用了 Claude Code 的程式碼審查技能。此技能將審查分散至多個子代理,導致在測試案例中出現超時或超出預期的編輯,進而受到基準測試框架的扣分。相比之下,以標準模式運行的 Sonnet 5.5 特別適合受限、範圍明確的執行任務:它能快速剖析儲存庫結構、評估建議變更,並在定義的檔案邊界內進行操作。
基準對等性:Terminal-Bench、CursorBench 與 GDPval-AA
Anthropic 公布的評估數據顯示,Sonnet 5.5 在日常技術領域的頂級基準測試中已能並駕齊驅甚至超越。在評估多步驟命令列問題解決能力的 Terminal-Bench 4.0 中,Sonnet 5.5 取得 70.6% 的分數,擊敗了 Opus 5.5(66.4%)與 Sonnet 5(10.3%)。在基於真實 Cursor 開發者會話的 CursorBench 4.0 中,Sonnet 5.5 達到 55.5%,僅落後 Opus 5.5(57.8%)約兩個百分點。此外,在測量涵蓋 44 種職位真實專業任務的 GDPval-AA v2.1 中,Sonnet 5.5 獲得 1844 的 Elo 評級,緊追 Opus 5.5 的 1846 分。
若要檢視精簡型模型如何優化自動化執行,請參考以下工作流程差異:
[單體式旗艦代理循環]
  使用者輸入 ──> 重度推理鏈 ──> 散亂的工具呼叫 (高 Token 消耗) ──> 過度編輯與超時風險

[精簡型中階代理循環]
  使用者輸入 ──> 定義範圍的意圖映射 ──> 批次工具呼叫 ──> 較少的執行步驟 ──> 提供精準修補程式
此精簡執行循環可減少上下文漂移與不必要的網路來回傳輸。Anthropic 指出,相較於 Sonnet 5,該模型輸出速度提升超過 30%,同時減少了步驟計數。模型將工具呼叫進行批次處理,最大限度減少了代理運行時與主機環境之間的網路延遲。
Sonnet 5.5 同時將頂級安全架構引入中階模型範疇。它是首款具備與 Opus 5.5 相同網路安全保護機制的 Sonnet 變體。高風險漏洞發現任務會自動退回到先前的架構,而受批准的防禦人員可透過「網路驗證計畫」(Cyber Verification Program)獲得分級權限。此外,該系統整合了安全分類器,旨在減少工業級別的推理提取,並確保保留的思考內容僅限於原始帳戶內。
架構策略:在旗艦模型與中階模型間分配工作負載
隨著 AI 基礎模型分化為超深層推理引擎與敏捷執行模型,工程領導者必須重新評估如何將模型級距應用於軟體開發生命週期中。在整個工程管線中部署單一旗艦模型會引入不必要的延遲與成本。相反,現代開發者基礎設施日益依賴動態模型路由,根據結構複雜度指派任務。
在規劃生產工作流程時,團隊必須權衡深層概念推理與高吞吐量任務解析之間的取捨。雖然旗艦模型在廣泛的架構規劃中仍不可或缺,但中階模型能以卓越的反應速度處理絕大多數的日常程式碼執行工作。
下表概述了各模型層級的技術定位:
| 工作負載類別 | 主要模型選擇 | 成本概況 | 延遲概況 | 適用於 |
|---|---|---|---|---|
| 日常 Bug 修復與 PR 審查 | Claude Sonnet 5.5 | 低(每百萬 Token $2 / $10) | 快(輸出生成提升 30%+) | 範圍明確的日常軟體任務與高頻率 CI/CD 檢查 |
| 完整程式碼庫架構與遷移 | Claude Opus 5.5 | 高(每百萬 Token $4 / $20) | 適應性強,深度思考週期 | 龐大儲存庫中複雜、模糊的重構工作 |
| 互動式原型設計與 UI 設計 | Claude Sonnet 5.5 | 低(每百萬 Token $2 / $10) | 快速、反應靈敏的迭代 | 設計使用者流程、生成圖表與前端架構搭建 |
| 進階網路安全研究 | 驗證存取版 Claude 模型 | 視模型與存取等級而定 | 全面的多步驟驗證 | 在 Anthropic 驗證計畫下進行的授權高風險安全研究 |
Anthropic 透過分級安全防護機制建立網路安全能力。雖然常規漏洞修復在 Sonnet 5.5 上正常運作,但更高風險的安全任務會自動退回到先前架構。對於進行進階安全研究的授權防禦者,Sonnet 5.5、Opus 5.5 與 Mythos 模型擴展功能的存取權限,皆透過分級的「網路驗證計畫」進行管理。
透過建立動態路由規則,工程組織可將日常 Pull Request 審查、單元測試生成與 Bug 定位指派給 Sonnet 5.5。這能保留頂級 Opus 的運算量供複雜架構重構使用,確保工程預算可控,且不損及軟體可靠性。
整合檢核表:在企業 CI/CD 中落實 Sonnet 5.5
隨著軟體組織將高速、高成本效益的模型(如 Sonnet 5.5)納入生產管線,工程團隊必須建立穩健的治理排程。要將成本節省最大化,需將 API 參數設定與任務複雜度掛鉤,同時防止未受監控的代理漂移(Agent drift)。
開發者實施檢核表
- 設定動態努力水平:利用模型的原生努力程度設定(在 Claude App 與 Claude Code 中預設為「中」,在 Claude Platform 中預設為「高」),以平衡推理深度與 Token 支出。
- 利用提示詞快取 (Prompt Caching):針對靜態系統提示詞與儲存庫地圖實施快取,確保快取讀取 Token 可享 90% 折扣(每百萬 Token $0.20)。
- 部署非同步批次處理:透過批次 API 處理非即時性評估、自動化程式碼稽核與批次遷移,達成標準 Token 成本 50% 的折扣。
- 整合故障安全機制 (Fail-Safe):建立程式化斷路器,當自動化工具循環超過預定義的迭代預算時,優雅地終止或重定向請求。
治理與基礎設施檢核表
- 重新評估訂閱單位經濟效益:計算每位活躍開發者的邊際運算成本,以判斷高速中階模型是否允許提供更高的使用配額或更低的定價等級。
- 監控迭代比率:衡量解決使用者任務所需的平均工具執行次數;迭代次數的減少可直接提升開發者滿意度。
- 必要時設定僅限美國境內的處理:對於有國內資料駐留要求的受監管企業客戶,設定僅限美國的推理端點(符合企業條款下以 1.1 倍價格提供)。
- 驗證零資料保留資格:與 API 提供者確認零資料保留狀態,確保企業合規性,同時注意如持續性提示詞快取等特殊功能,可能在不同的資料保留條款下運作。
透過採用這些結構化的作業實務,軟體組織可將演算法的速度優勢與 Token 使用效率轉化為可預測的開發效益。
常見問題 (FAQ)
既然 Sonnet 5.5 的單 Token 價格與 Sonnet 5 相同,為何其任務成本較低?
Claude Sonnet 5.5 能取代 Opus 5.5 進行軟體工程開發嗎?
提示詞快取如何影響程式碼代理的運作成本?
工程團隊的關鍵總結
Claude Sonnet 5.5 的發佈反映了產業趨勢從不受限的參數量擴展,轉向追求作業任務效率。高吞吐量的軟體工程平台在每個作業階段並不一定都需要旗艦模型的運算負載。當中間級別的模型能穩定地以較少的迭代次數解決範圍明確的程式庫任務時,自動化軟體開發在大規模部署下的成本效益將顯著提升。
要充分利用這些效率提升,需要建立嚴謹的架構:根據複雜度動態路由任務、執行工具使用的邊界規範,並系統性地運用提示詞快取。隨著基礎模型供應商持續優化 Token 使用效率並兼顧原始推理能力,設計模組化且具備成本監控管線的工程團隊,將能維持最永續且可擴展的生產工作流程。
參考資料
-
Anthropic. Introducing Claude Sonnet 5.5.
-
Anthropic. Claude Sonnet 5.5 System Card.
-
Anthropic. Claude API Pricing and Data Residency.
-
Anthropic. Commercial Terms of Service and Data Retention Policy.
-
VentureBeat. Anthropic Launches Claude Sonnet 5.5 with 30% Cost Reduction Per-Task.
-
TechCrunch. Anthropic Releases Sonnet 5.5 as a Significantly Cheaper, Faster Work Partner.
-
9to5Mac. Anthropic Upgrades Claude with New Sonnet 5.5 Model.
Share this article



