Cloudflare 封鎖訓練機器人?Cloudflare 已宣佈一項新的預設政策,將針對合資格的出版商網站封鎖 AI 訓練爬蟲,並為內容擁有者提供新的變現選項。隨著生成式 AI 改變網路內容的消費方式,AI 平台持續在缺乏互惠價值結構的情況下,耗用大量的網路資源。過去,開放搜尋引擎索引意味著能獲得可透過廣告或訂閱變現的引薦流量。然而今日,由於混合用途的爬蟲系統性地抓取專有數據進行模型訓練,並直接產生摘要內容繞過點擊需求,出版商的收入正遭受嚴重侵蝕。
營運問題與財務瓶頸:Cloudflare 對廣告支援頁面封鎖訓練機器人
概覽
- 自動化防護機制將於 2026 年第三季起,對受營利內容目錄中的模型抓取與程式化代理程式啟動預設限制。
- 同時執行搜尋索引與數據採集的爬蟲,除非將其營運目的拆分為獨立的管道,否則將受到限制。
- 新興的效用補償架構正陸續出現,旨在為內容管理者提供直接的交易層級回饋,而非傳統的請求計數。
線上出版商與自動化網路抓取工具之間的傳統平衡已完全破碎。過去近三十年來,一項默認的互惠協議支撐著全球網際網路。在此基準協議下,網站管理員歡迎解析蜘蛛程式掃描頁面,並換取目錄查詢帶來的合格使用者點擊。這種互惠交換維繫了自給自足的媒體環境,確保廣告曝光、數位贊助與定期會員制能為獨立軟體手冊及新聞報導提供資金。
當前向大規模生成式網路的轉型重塑了爬蟲活動,將目標從純粹的路徑探索轉為數據提取。自動化收集系統現能攝取完整的數位目錄,解析語意數據,並在封閉的聊天視窗中提供合成見解。這種即時解決方案繞過了標準的網站造訪需求。評估顯示,當搜尋介面呈現整合式的生成輸出時,讀者點擊外部目錄連結的可能性顯著降低,許多案例顯示已降至個位數百分比。這些流量模式為仰賴標準廣告投放結構來抵銷營運成本的平台,造成了迫切的資金缺口。
為何 Cloudflare 封鎖訓練機器人演變成出版商的強制要求
長期以來,出版商在保護內容與維持搜尋曝光度之間面臨艱難的權衡。若獨立網站擁有者為了防止模型訓練而封鎖 Googlebot、Applebot 或 Bingbot,他們就得冒著從傳統搜尋索引中消失的風險。這種結構性壟斷迫使內容創作者面臨兩難:免費交出寶貴的專有數據,或徹底犧牲搜尋可見度。這種動態也鼓勵新興 AI 實體採用規避式爬取策略,加重了本已為冗餘請求買單的出版商的伺服器負載。
為了恢復平衡,Cloudflare 導入了一種聲明式閘控機制。Cloudflare 表示,該預設政策將於 2026 年 9 月 15 日起開始實施,針對所有廣告支援的客戶頁面,對訓練機器人與使用者導向的代理程式建立預設封鎖。此更新確保可變現內容在未經明確許可下無法被爬取。與此同時,該網路巨頭正在重組其變現框架,從傳統的「按爬取計費 (Pay Per Crawl)」架構轉型為「按使用計費 (Pay Per Use)」的結果導向生態系。透過與 You.com 和 Ceramic.ai 等平台的整合,當 AI 代理程式利用其內容回答查詢時,出版商可獲得直接的報酬,進而引入永續的交易層級收入來源。
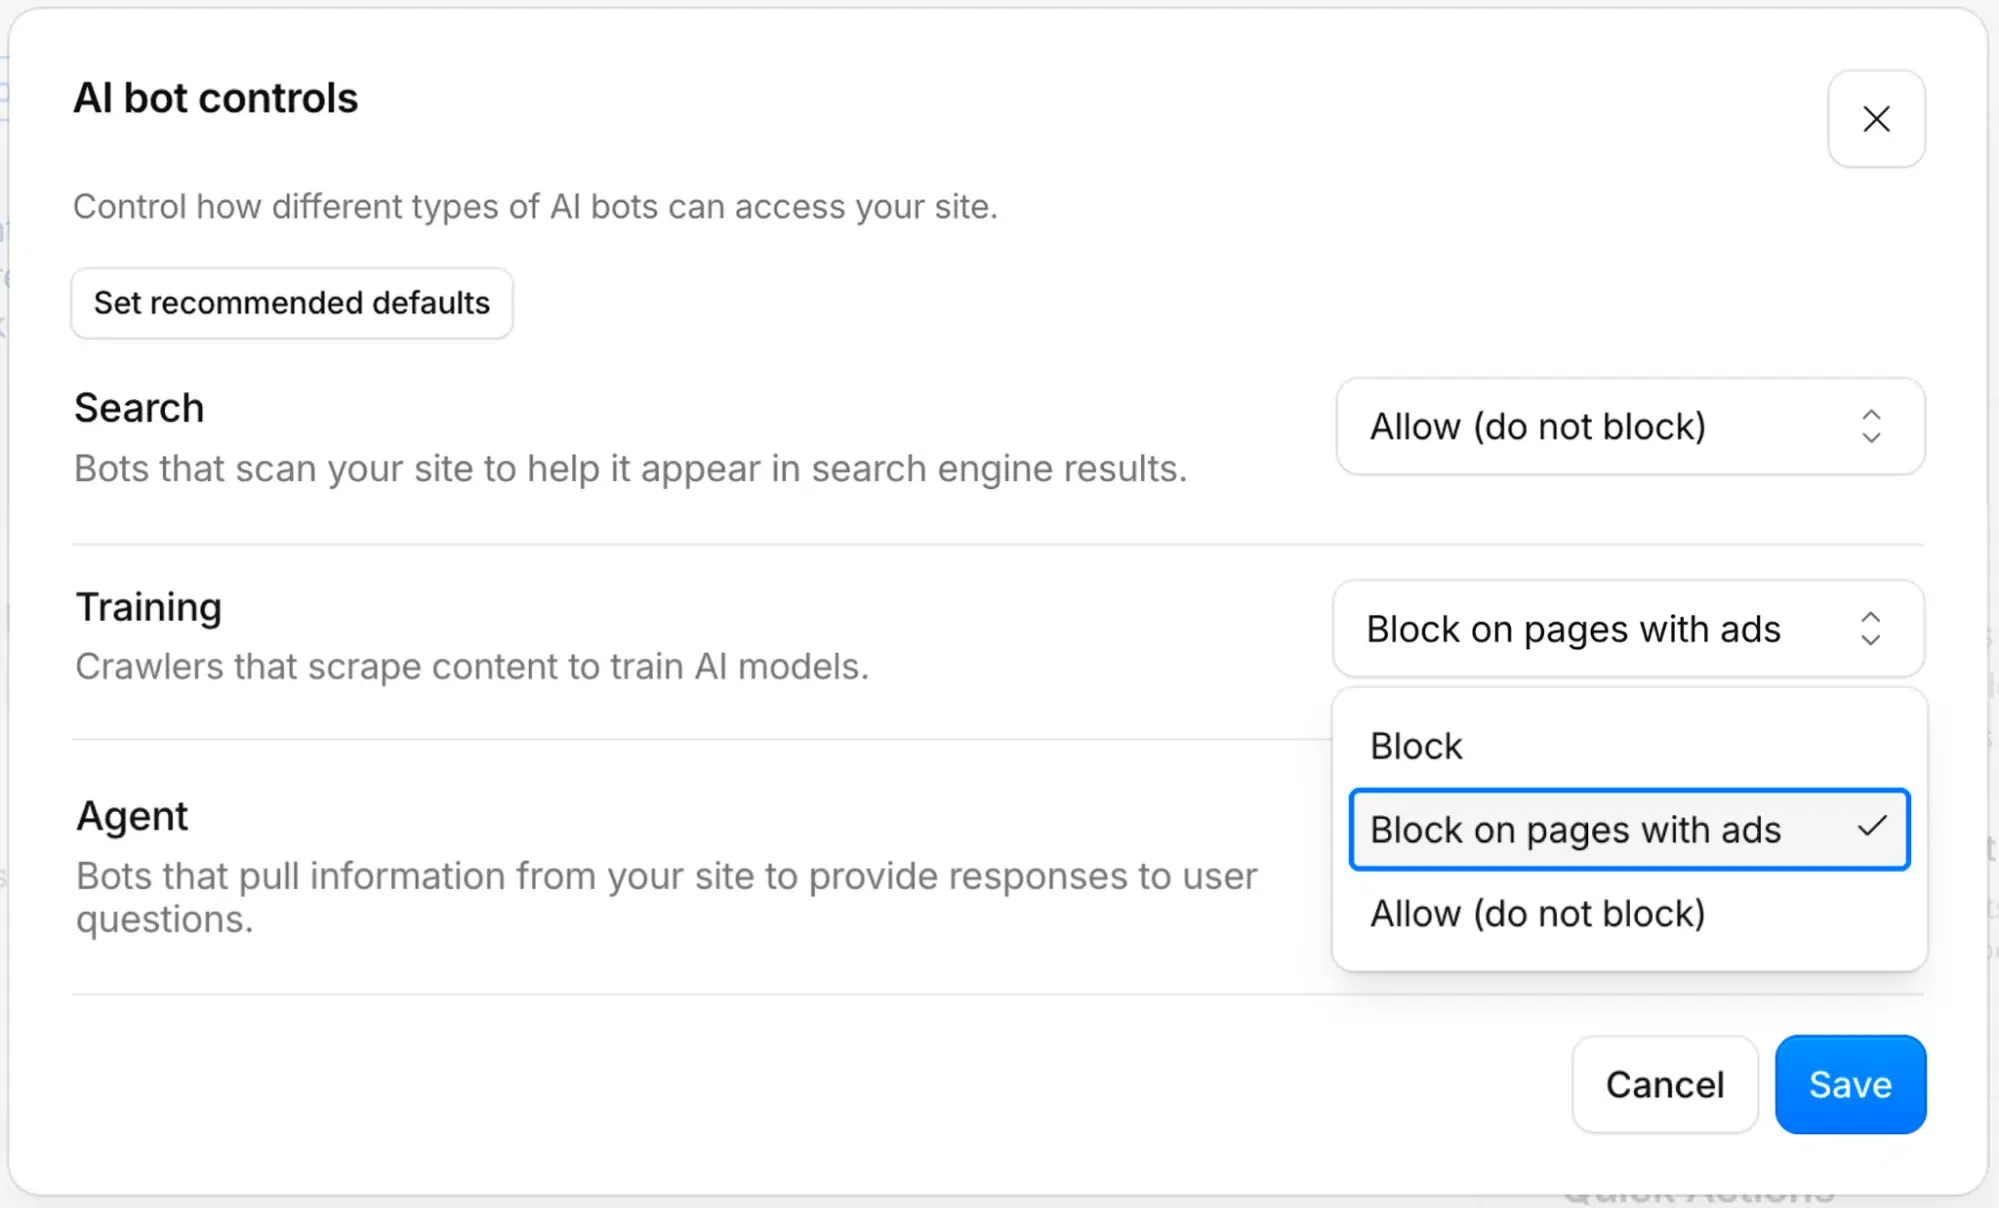
系統性根本原因與 Cloudflare 封鎖訓練機器人政策的非視覺請求鏈
分析網路流量的物理組成顯示,自動化機器人目前佔所有線上活動的 50% 以上。此流量體積對原始伺服器造成巨大壓力,特別是因為重複請求往往只是抓取未變動的內容。Cloudflare 遙測數據指出,超過一半的驗證爬蟲流量皆屬完全冗餘,在連接兩端皆浪費了計算能力。根本問題在於現代搜尋與抓取運作的底層架構,這些操作仰賴混合用途機器人,掩蓋其真實意圖。
在應用層面上,使用者導向代理程式的技術特性與標準的人類瀏覽器工作階段有顯著差異。此區別至關重要,因為現代無頭抓取工具 (headless scrapers) 完全繞過了傳統的互動元素,導致下游測量系統出現嚴重的追蹤中斷。
協定脫鉤:無狀態代理程式 vs. 有狀態網頁瀏覽器
傳統網頁優化假設標準瀏覽器工作階段透過 Cookie 堆疊、本機儲存與結構化 User-Agent 字串來管理狀態。相對地,自動化代理程式與無頭爬蟲執行的是無狀態 HTTP 請求。此差異破壞了出版商用以證明廣告價值的測量管道。下圖概述了核心應用層面的差異:
[標準網頁工作階段]
  使用者瀏覽器 (持續狀態與 Cookie) ──> Web HTTP 請求 ──> 廣告曝光與引薦來源註冊


[無狀態代理程式工作階段]
  自動化爬蟲 (無狀態 HTTP / 無頭工具) ──> 獨立擷取 ──> 缺少引薦來源與歸因遺失
當自動化瀏覽器代理程式抓取頁面、處理文字並在封閉的聊天環境中呈現答案時,整個用戶端環境內容 (client-side context) 即被銷毀。傳統追蹤腳本無法執行。沒有廣告曝光註冊,標準的引薦來源標頭 (referrer headers) 隨之消失。這創造了一個歸因真空,出版商提供了原始資訊價值,但下游系統記錄到的參與度卻為零。相同的瀏覽器內容遺失問題,也會影響使用者後續安裝應用程式時的下游行動歸因工作流程。由於這些無頭造訪缺乏狀態追蹤容器,標準行動測量工具無法將初始探索事件與隨後的 App 安裝進行匹配。此動態加速了傳統多點歸因模型的崩潰。
解決方案比較:Cloudflare 封鎖訓練機器人時代下的自建與採購取捨
隨著用戶端追蹤的預設邊界在新的自動化爬蟲法規下消解,工程團隊必須重新評估其歸因架構。僅僅仰賴標準的用戶端瀏覽器 Cookie 或裝置層級屬性,已不再是可行的長期策略。開發者面臨著核心的「自建 vs. 採購」決策:是自行建置伺服器端內容匹配資料庫,還是整合一套能存活於無頭互動環境下的現成、強健測量系統。
架構評估:無狀態時代下的自建與採購
建置內部的內容匹配系統需要設置伺服器端狀態資料庫,以快取並協調開發者工作階段。雖然此方法對數據管道擁有完全掌控權,但工程成本相當高昂。開發者必須手動協調傳入的 API 負載、管理工作階段過期,並實作安全加密簽章以防止詐欺。相較之下,整合現成的測量 SDK 可消除這些維護負擔。
下表概述了不同的追蹤方法在無狀態、代理程式密集的環境中表現如何:
| 指標與能力 | 內部資料庫工作階段建置 | 傳統 Firebase / Webview 重新導向 | 頂級行動測量平台 (Adjust, AppsFlyer) | 延遲深度連結 SDK (Opoinstall) |
|---|---|---|---|---|
| 歸因存活率 | 高 (伺服器端) | 低 (用戶端) | 高 (多點) | 高 (程式化映射) |
| 開發成本 | 極高 | 低 | 高 | 低 |
| 維護負擔 | 高 (持續性) | 低 | 低 | 低 |
| 詐欺緩解 | 中 (手動規則) | 低 | 高 (演算法) | 高 (零信任簽章) |
| 延遲影響 | 變動 | 中 | 中 | 低 (極輕量佔用) |
此模型的商業實現包括 Adjust、AppsFlyer、Branch 及其他延遲歸因系統。其中一個範例是 Opoinstall,它提供延遲深度連結 (Deferred Deep Linking) 與伺服器端參數復原,能在分散式網頁與 App 環境中保留工作階段元數據。透過將重新導向鏈與用戶端重新導向解耦,此方法能保留從初始搜尋事件到最終 App 啟動的使用者旅程元數據,繞過爬蟲封鎖代理程式造成的限制。行動歸因平台使用類似的伺服器端狀態恢復概念,以確保在缺乏瀏覽器內容的情況下,轉換一致性仍得以維持。
整合清單與治理時程:在 Cloudflare 封鎖訓練機器人的干擾下生存
為了確保 Cloudflare 實施廣告頁面預設訓練機器人封鎖時的數據連續性,工程與產品團隊必須建立結構化的轉型時程。對開發者而言,這涉及脫離用戶端重新導向,改採強健的伺服器端驗證方法;對成長團隊而言,這需要修訂行銷投資報酬率 (ROAS) 計算管道,以計入標準瀏覽器歸因數據流失的情況。
開發者實作檢查清單
- 實作 RFC 7239 Forwarded 標頭:設定所有傳入 API 閘道以讀取並解析標準化的
Forwarded標頭,以識別受信任的中間代理程式。
Forwarded: for=203.0.113.1;proto=https
- 採用加密 URL 簽章:確保所有外連促銷連結皆使用經加密簽名的參數,防止自動化機器人操縱引薦價值。
- 啟用伺服器端工作階段匹配:從基於 Cookie 的用戶端重新導向,轉向程式化的狀態資料庫,於首次 App 啟動時協調工作階段金鑰。
產品與成長策略檢查清單
- 重構 ROAS 模型:調整獲客漏斗,將伺服器端啟動事件的權重調高於傳統的用戶端網頁廣告點擊。
- 部署內容體驗還原:利用參數傳遞框架,即使網頁引薦來源被代理程式刪除,仍能重構使用者的預期目標。
- 於 BotBase 審核機器人流量:使用即時行為分類來審核自動化爬蟲如何與行銷漏斗進行互動。
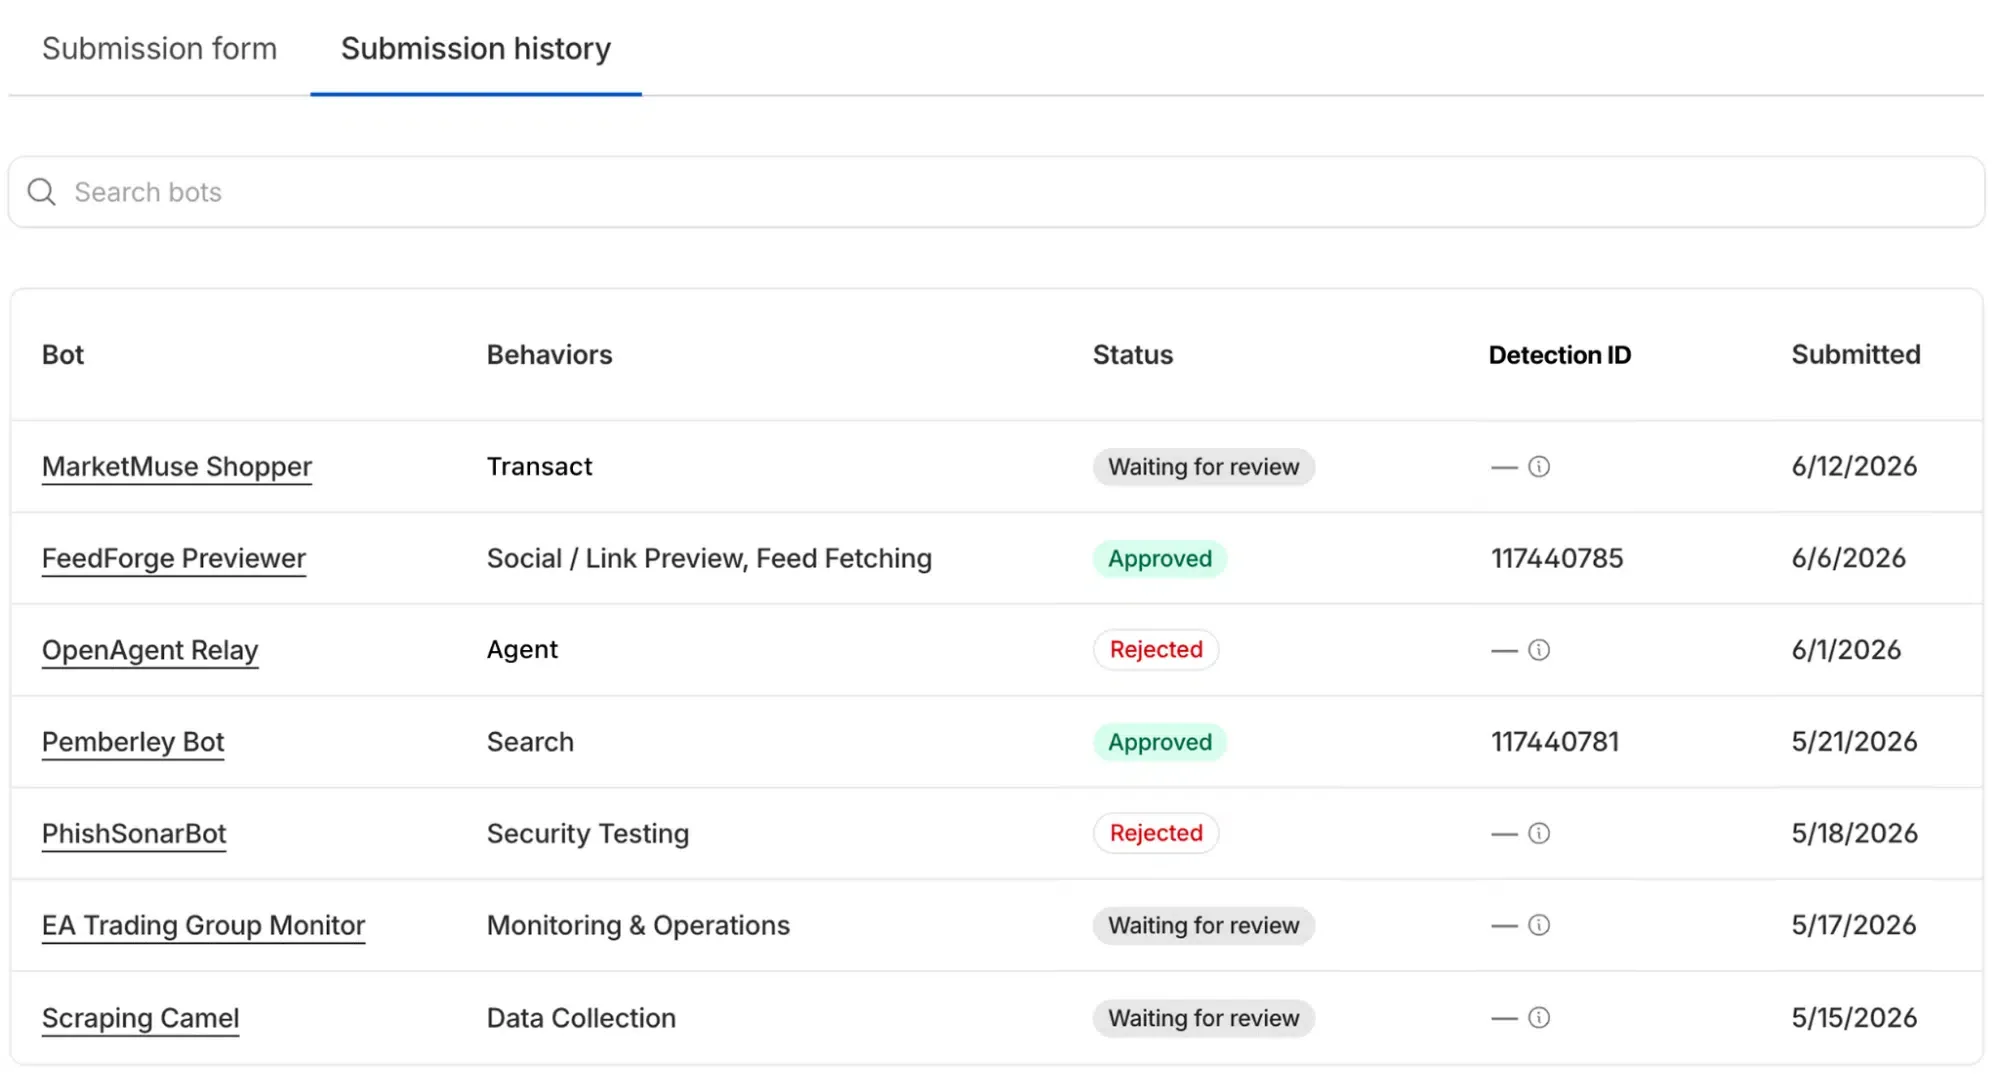
開發者可透過在標準 robots.txt 設定中擴充現代化元數據欄位,傳達明確的索引偏好。
# 參考建議元數據擴充的範例
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference
Allow: /
此結構化方法允許內容擁有者在保持搜尋曝光度的同時,防止 AI 平台將珍貴的專有內容永久吸收至其封閉的訓練數據集中。
常見問題 (FAQ)
為什麼同一個機器人會同時爬取頁面進行搜尋與 AI 訓練?
Cloudflare 如何判定哪些頁面包含廣告以觸發封鎖機制?
「按爬取計費」與「按使用計費」有何不同?
網際網路從以人為中心的瀏覽環境,轉向代理程式驅動的生態系,要求我們在建置與衡量數位體驗的方式上做出根本性轉變。隨著自動化代理與無狀態代理程式成為網頁內容的主要消費者,傳統的用戶端歸因模型將持續衰退。僅依賴瀏覽器 Cookie 與基礎 HTTP 引薦來源已不足以保障驅動使用者獲客與數位變現的數據管道。
為了在新時代保持成長,工程與產品團隊必須將歸因邏輯從標準的用戶端瀏覽器操作中脫鉤。透過採用伺服器端身分識別、加密簽章參數與強健的參數傳遞框架,組織能保護數據管道免受自動化爬蟲封鎖的影響。此轉變不僅是為了適應單一政策更新;更是為了重建系統,以存活於去中心化、支援代理程式的網路環境中。
Share this article



