GitHub 推出 Copilot Fusion?GitHub 於 2026 年 10 月 28 日正式宣佈 Copilot Fusion 全面上市,推出了一款執行階段模型路由器與協調器,可為軟體工程任務協調多個人工智慧模型。該系統在舊金山舉行的年度 GitHub Universe 大會上亮相,將模型選擇權從個別開發人員手中轉移開來,讓平台能夠分析任務需求,並在不同的基礎模型之間動態分派工作。隨著軟體工程團隊面臨不斷攀升的 API 成本,以及在不同前沿模型之間頻繁切換所帶來的認知疲勞,自動化模型協調正逐漸成為標準的營運架構模式。
核心產業重新調整:GitHub 於 Universe 大會推出 Copilot Fusion
概覽
- GitHub 於 2026 年 10 月 28 日正式推出 Copilot Fusion,適用於 Visual Studio Code、Copilot CLI、JetBrains IDE 以及 GitHub Copilot 桌面應用程式。
- 該系統結合了源自 Project HydraFusion 的執行階段多模型協調功能,以及微調的自動模型選擇演算法。
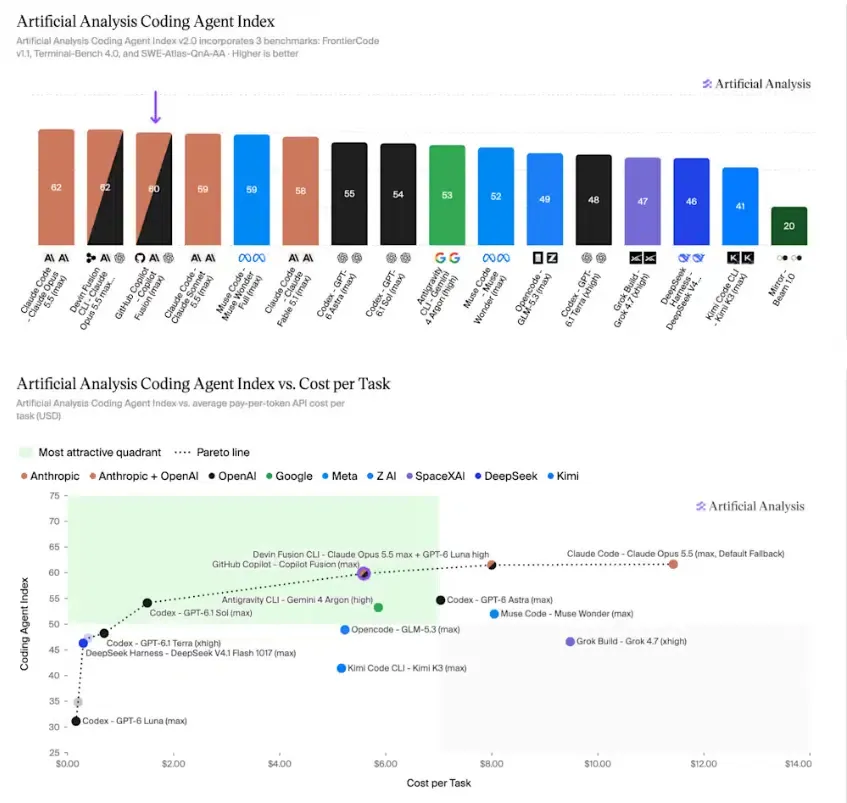
- 根據 Artificial Analysis 的獨立評估,Fusion Max 在 Coding Agent Index v2.0 上獲得了 60 分的綜合評分,僅落後採用 Claude Code 與 Opus 5.5 Max 的系統兩分,同時將任務成本降低了約 51%。
使用 AI 程式碼輔助工具的軟體開發團隊過去一直採用手動選擇的模式。程式設計師從 IDE 下拉選單中選擇單一模型(例如 GPT-4o、Claude Sonnet 或 o1 系列推理模型),並在整個程式碼編寫工作階段中維持該選擇。雖然這對獨立的提示詞很有效,但這種模式會帶來營運上的取捨。開發人員經常會針對複雜的架構規劃選擇高階、高延遲的前沿模型,然後在進行日常任務(例如產生單元測試或撰寫重複文件)時,卻忘記切換回輕量級模型。
這種手動方法可能會膨脹企業的 API 支出,並無法有效消耗上下文 Token。為了應對這些工作流程上的取捨,GitHub 開發了 Copilot Fusion,如官方的 GitHub 公告中所述。Fusion 不把 AI 程式碼編寫視為與單一靜態模型的互動,而是作為執行階段協調器運作。開發人員指定一個整體的推理工作量級別,系統便會針對任務的每個步驟,自主選擇最適合的底層模型或模型組合。

GitHub 推出 Copilot Fusion 所代表的策略性轉變,核心在於任務層級的經濟效益,而非單純的參數規模擴展。Artificial Analysis 發布的基準評估顯示,在 Coding Agent Index v2.0 上透過 Copilot CLI 測試的 Copilot Fusion Max,完成基準程式碼編寫任務的平均成本為每個任務 $5.59,而執行 Anthropic 的 Claude Opus 5.5 最大設定的 Claude Code 則為 $11.42。受評估的配置每個任務大約消耗 720 萬個 Token——大約是單獨 Opus 配置的一半 Token 容量——同時完成任務的時間縮短了約 40%。
各個基準元件的效能各有不同:Fusion Max 在 Terminal-Bench 4.0 上以 71 分領先,但在 FrontierCode 上獲得 51 分(落後於 Claude Code 的 56 分),在 SWE-Atlas-QnA-AA 上則獲得 57 分。此外,儘管微軟領導階層引述了內部的 DeepSWE 評估,顯示潛在成本降幅高達 77%,但該數字代表的是獨立、公司回報的最高情境,而非獨立的基準平均值。這些結果證實,動態多模型協調可以顯著降低支援的工作流程的開發費用,不過實際節省的金額取決於具體的任務組合、審查需求和企業使用模式。
架構模式:單一、串聯與評論執行拓樸
Copilot Fusion 並不是作為一個獨立的基礎模型運作。相反地,它扮演著嵌入在開發人員客戶端中的智慧控制平面。當使用者提交涉及推理、程式碼生成、偵錯或工具使用的指令時,Fusion 會將傳入的意圖訊號與即時系統健康狀況、可用性以及語意複雜度進行評估。
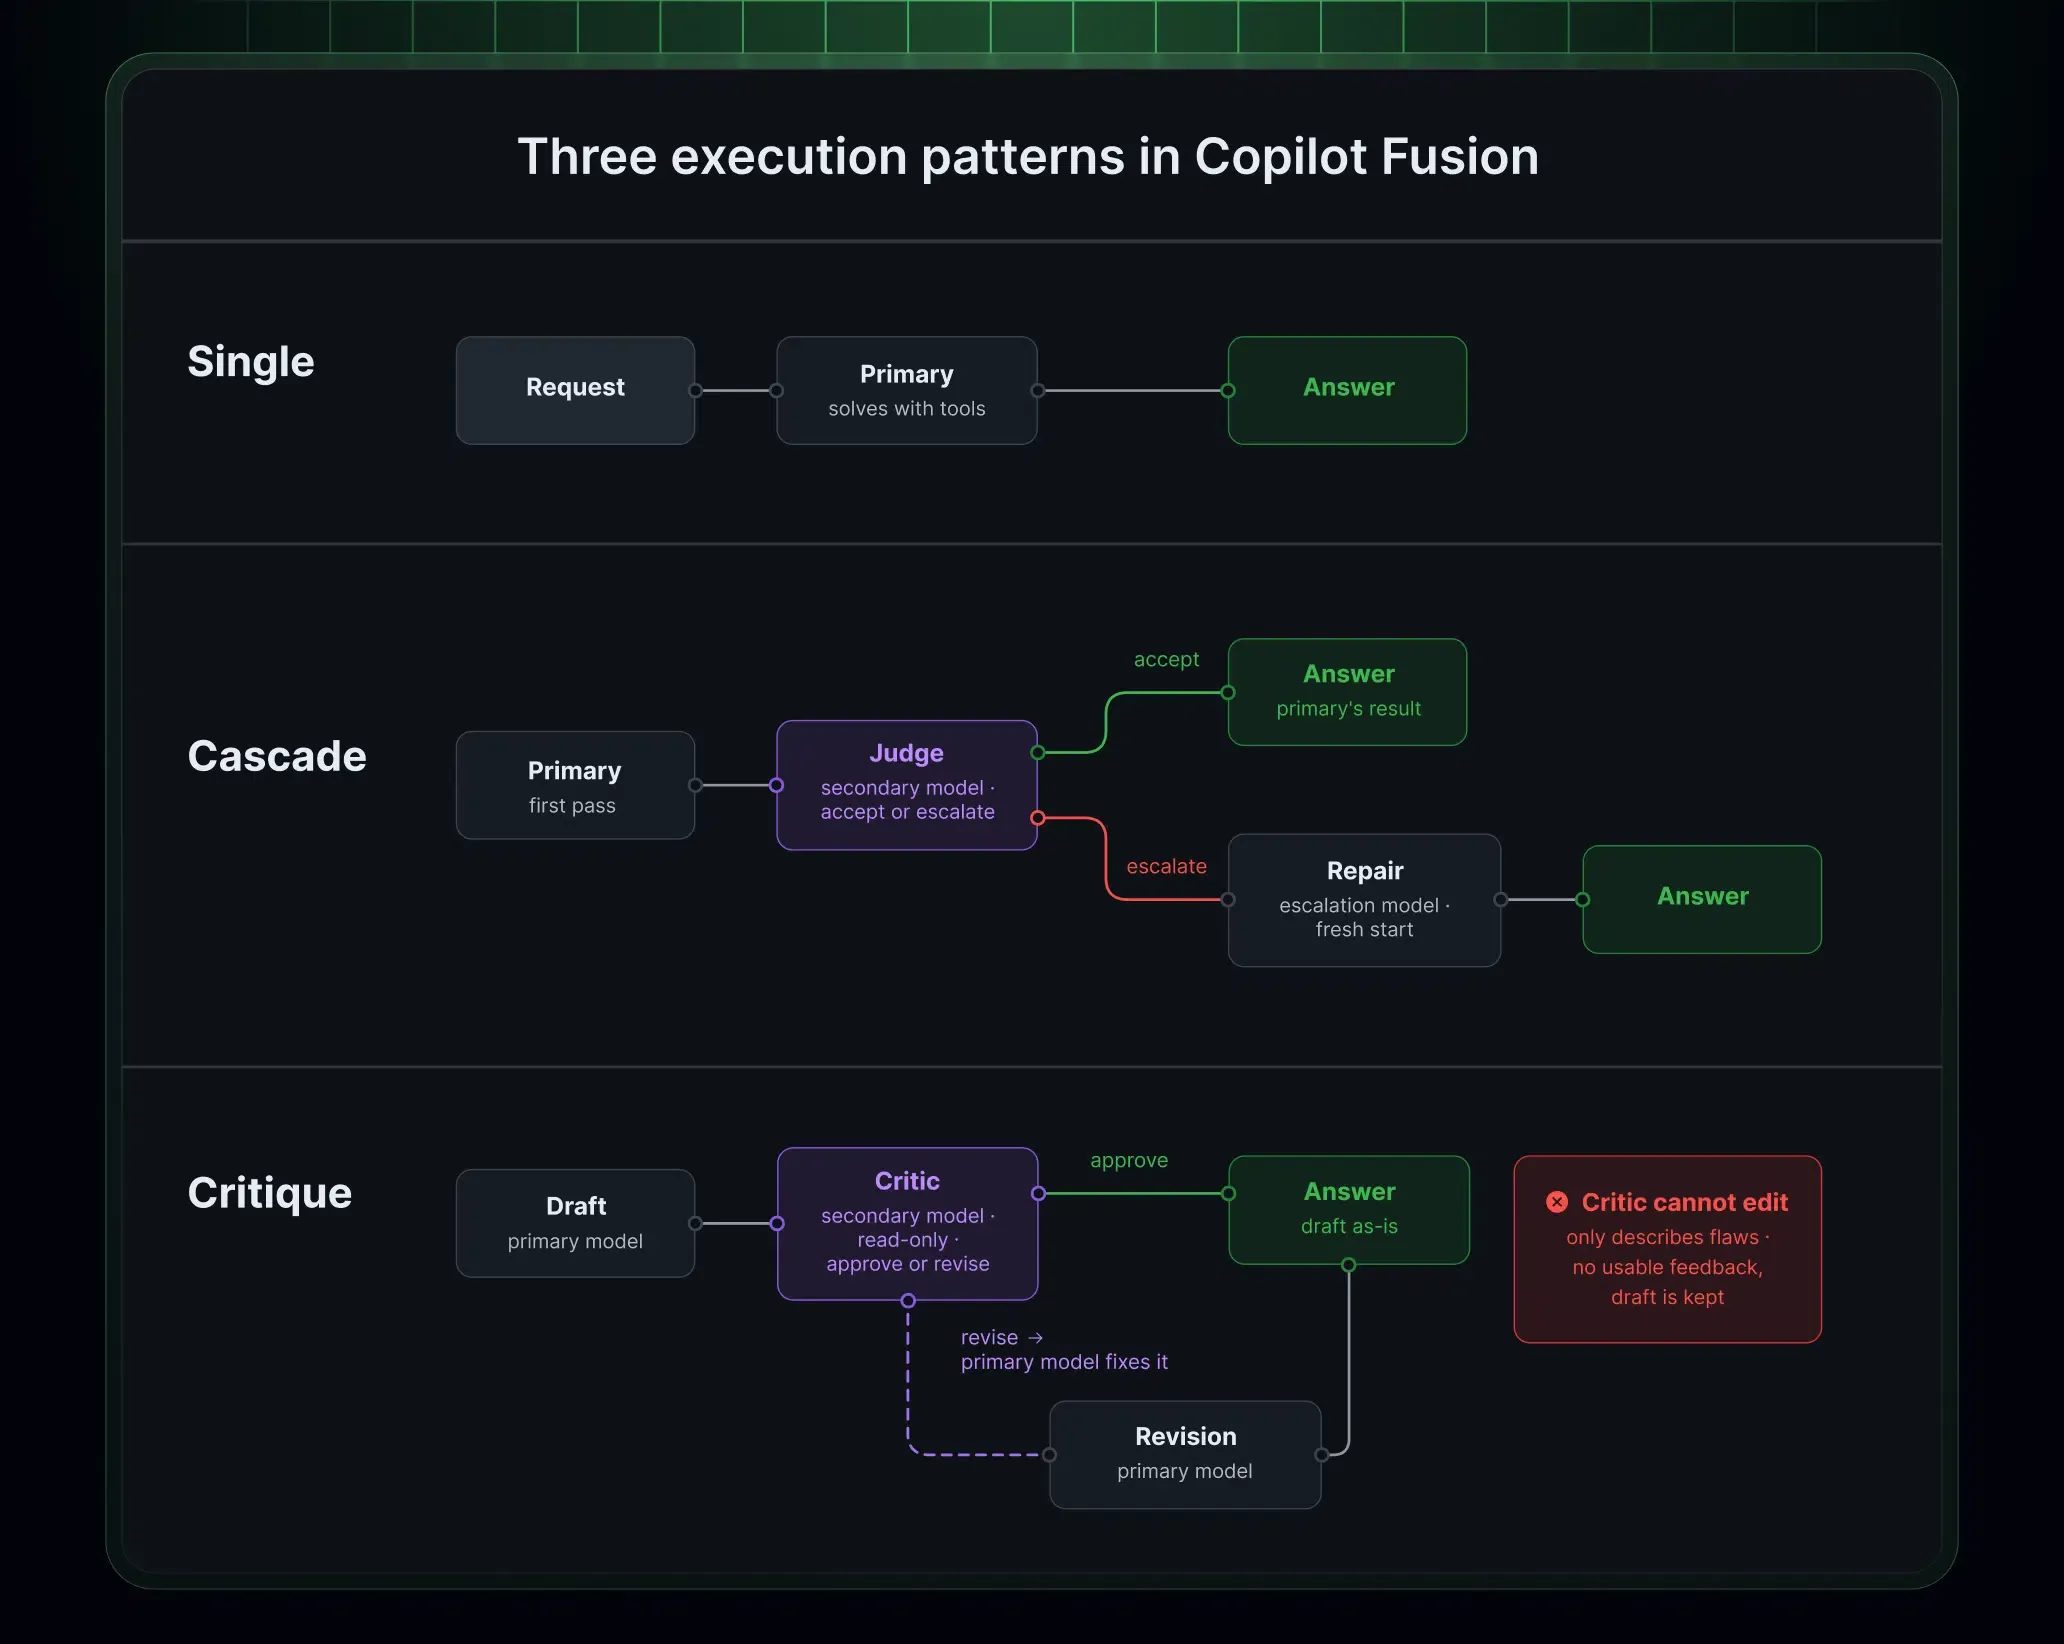
根據任務特性與所選的工作量級別,系統會動態選擇以下三種執行模式之一:
- 單一模式 (Single Pattern):單一模型接收提示詞並直接完成任務,增加零審查負擔。此模式適用於簡單的程式碼生成、語法查詢和基本的重構。
- 串聯模式 (Cascade Pattern):輕量級模型草擬初步解決方案。次要的評判模型會檢查建議的程式碼,並決定是接受輸出,還是將任務升級至能力更強的模型以進行精進。
- 評論模式 (Critique Pattern):主要模型草擬初步回應,同時一個或多個審查模型並行獨立評估程式碼。協調器會彙整他們的意見回饋,主要模型據此修改程式碼,然後再將最終輸出傳回給使用者。
[Single Pattern]
  Prompt ──> Primary Model ──> Single Execution ──> Final Code Output

[Cascade Pattern]
  Prompt ──> Lightweight Model ──> Initial Draft ──> Judge Model ──[Accept]──> Final Code Output
                                                         └──[Escalate]──> Stronger Model ──> Final Output

[Critique Pattern]
  Prompt ──> Drafting Model ──> Initial Draft ──┬─> Reviewer Model A ──┐
                                                └─> Reviewer Model B ──┴─> Feedback Aggregator ──> Final Revision
這些執行拓樸在執行速度、驗證嚴謹度與計算成本之間帶來了不同的取捨。GitHub 沒有將提示詞寫死在特定模式中,而是將這些工作流程對應到可選擇的工作量級別:
- Fusion 標準版 (Fusion Standard):平衡日常程式碼編寫的成本、品質與延遲。目前的實作通常每個任務選擇一個模型。
- Fusion 高效版 (Fusion High):在考慮 Token 效率的同時,優先考慮強大能力與更深層次的推理,以處理大量的程式碼編寫任務。必要時可能會使用多模型協調。
- Fusion 最大版 (Fusion Max):優先為最具挑戰性的任務提供前沿級的能力,並在有用時動態選擇額外的審查或升級步驟。
- Fusion 快速版 (Fusion Fast):一種專門的、使用者無法手動選擇的工作量級別,用於支援 Visual Studio Code 內聯聊天情境中對延遲敏感的場景。
跨動態工作流程管理上下文邊界需要專門的記憶體處理機制。Copilot Fusion 本身不具備統一的上下文視窗。相反地,每個執行步驟都嚴格在執行該子任務的特定模型的上下文限制內運作。IDE 中顯示的上下文容量反映了參與模型中最保守的限制。此外,為了最大化提示詞快取效率,Fusion 盡可能將核心對話執行緒保留在單一主要模型上,僅將必要的、隔離的上下文視窗傳遞給協助的審查模型。
跨開發團隊的企業治理與本地模型整合
在大型企業工程組織中部署自主模型協調會引進治理、合規性與預算考量。當 AI 系統在 Anthropic、OpenAI 和其他提供者的模型之間動態選擇時,管理者必須確保組織的資料落地性(Data Residency)與安全性規則維持完整。
企業管理者可以透過支援的 GitHub Copilot 模型政策與企業管理設定來管理適用於 Copilot Fusion 的模型,正如 Copilot Fusion 管理手冊中所記錄的。管理者可以檢視 Fusion 可用的模型名單、在各個開發人員席位中設定預設的工作量級別,以及停用 Fusion 的特定模型,而無需在全公司範圍內停用它們。Fusion 會遵守適用的訂閱、組織、資料落地、FedRAMP 相關以及評估模型限制。這些控制措施規範了系統內的模型資格,但它們並不能取代組織自身的合規性審查、資料治理或安全性驗證流程。
下表概述了不同的執行架構如何在執行介面、審查機制與 Token 支出分佈之間取得平衡:
| 執行模式 | 主要調用 | 審查機制 | Token 成本分佈 | 最適合用於 |
|---|---|---|---|---|
| 單一模式 (Single Mode) | 一個專屬模型 | 無 | 基準標準模型定價 | 直接的程式碼編輯與語法問題 |
| 串聯模式 (Cascade Mode) | 高效的草擬模型 | 評判模型檢查與升級 | 低至中等(有條件升級) | 範圍明確的錯誤修復與結構化修改 |
| 評論模式 (Critique Mode) | 主要產生器 | 並行獨立審查模型 | 較高(多個同時模型調用) | 複雜的架構邏輯與安全性敏感的程式碼 |
| 本地模型混合 (Local Model Hybrid) | 支援的本地裝置端模型 | 雲端協調的模型選擇 | 減少本地步驟上的雲端 Token 消耗 | 符合條件的裝置端推論與雲端協調路由 |
正如 GitHub 關於本地模型選擇的變更日誌中所宣布的,GitHub 推出了支援本地模型感知的路由作為選用的實驗性預覽功能。在配置了支援的本地模型後,Copilot Fusion Standard 可以為符合條件的任務選擇裝置端推論,從而減少這些步驟的雲端模型使用量。在配備相容硬體的 Windows 系統上,開發人員可以在 Copilot 應用程式、Copilot CLI 或 Visual Studio Code 中,透過 Windows ML 管理安裝並執行 MAI Code 1.1 Flash。跨平台的 Windows、macOS 和 Linux 使用者可以在 Copilot CLI 中使用 Ollama 等本地模型提供者來配置本地模型(例如 Qwen3.8 Flash Next),並透過 --experimental 旗標啟動 CLI。
然而,Copilot Fusion 仍然依賴基於雲端的路由決策,且任務在適當時仍可能會使用雲端模型。因此,本地模型支援並未使 Copilot Fusion 成為完全離線的程式碼編寫環境;需要實體隔離(Air-gapped)安全的開發人員應改為評估專用的離線工具。
工程檢核表:在生產環境中採用多模型協調
將多模型執行階段協調整合至軟體開發工作流程中,需要調整開發人員的習慣、IDE 配置以及企業財務維運。工程領導階層必須建立清晰的營運協定,以充分利用 Token 效率,同時避免工作流程中的陷阱。
開發人員實作檢核表
- 在提交前檢查工作區 Diff:捨棄 AI 草稿並不會自動還原工作區檔案的修改;開發人員在提交程式碼之前,必須檢閱所有未提交的檔案編輯。
- 將工作量級別與任務複雜度相匹配:保留 Fusion Max 用於複雜的演算法邏輯與安全性稽核,並將 Fusion Standard 用於日常程式碼編寫,以防止不必要的 AI 點數消耗。
- 稽核多模型進度串流:觀察 IDE 的進度指示器,以檢查哪些特定模型對產生的程式碼區塊有貢獻,確保執行步驟的透明度。
- 配置支援的本地模型:對於 Fusion Standard 上的合適任務,設定支援的本地模型(例如 Windows 上的 MAI Code 1.1 Flash 或透過 Ollama 的 Qwen3.8 Flash Next),並在必要時啟用實驗性設定。
企業治理與 FinOps 檢核表
- 配置企業模型政策:在企業儀表板中指定哪些模型符合 Fusion 路由的資格,將模型名單與企業合規性及資料落地要求保持一致。
- 稽核基於用量的 AI 點數:追蹤跨工作量級別的團隊級點數消耗,並考量到 Fusion High 和 Max 中的多模型執行每個任務所消耗的點數可能會比單一模型執行更多。
- 納入促銷計費視窗的考量:在進行營運費用基準測試時,將 GitHub 針對付費 Copilot 訂閱者在 2026 年 11 月 30 日前提供的模型成本 30% 促銷折扣納入考量。
- 建立人工程式碼審查關卡:為所有代理程式產生的 Pull Request 維持強制性的同儕程式碼審查,確保自動化評論循環是作為人工工程監督的補充,而非取代。
常見問題 (FAQ)
當 Copilot Fusion 調用多個模型時,GitHub 如何計算帳單?
如果 Copilot Fusion 捨棄了中繼程式碼草稿,會發生什麼事?
企業管理者可以限制 Copilot Fusion 選擇哪些模型嗎?
工程團隊的關鍵要點
GitHub Copilot Fusion 的推出證實了,對於複雜的軟體工程任務,依賴單一的單體式 AI 模型會引入不必要的營運取捨。現代開發工作流程涵蓋了多樣化的認知需求,從即時語法完成到複雜的跨儲存庫推理。強迫單一模型架構來處理這整個範圍,可能會導致模型支出不斷攀升或執行品質受損。
獨立的基準測試結果表明,多模型協調可以在較低的模型成本下為某些工作負載提供具競爭力的程式碼編寫效能。實際結果將取決於任務複雜度、協調行為、所選模型以及組織的使用模式。透過將任務分派與開發人員的手動選擇脫鉤,執行階段模型協調建立了一個務實的營運路徑。隨著軟體工程組織擴大自動化程式碼編寫代理程式的規模,主要的競爭差異化因素將不再是存取任何個別的基礎模型,而是連接它們的協調層的治理、可靠性與架構嚴謹度。
參考資料
-
GitHub:使用 GitHub Copilot Fusion 路由與協調模型 —來自 GitHub Universe 2026 的官方發布說明與功能概述。
-
GitHub:Copilot Fusion 現已支援選擇本地模型 —詳細介紹透過本地模型路由進行符合條件任務的裝置端推論的官方公告。
-
GitHub 文件:關於 GitHub Copilot Fusion 概念與配置 —詳細說明執行模式、工作量級別與計費規則的官方技術文件。
-
GitHub 文件:配置適用於 Copilot Fusion 的模型 —用於管理企業模型政策與預設設定的管理指南。
-
Artificial Analysis:GitHub Copilot Fusion 基準評估 —衡量任務成本、Token 效率與 Coding Agent Index 分數的獨立分析。
-
The New Stack:GitHub 推出 Copilot Fusion 多模型系統 —關於 Project HydraFusion 整合與企業客戶實作的技術報導。
-
VentureBeat:GitHub Copilot Fusion 混合模型以實現成本效益 —涵蓋執行階段路由架構的 GitHub 產品領導階層技術訪談。
Share this article