Google 推出 Gemini 4 Hydrogen?Google DeepMind 於 2026 年 11 月 12 日正式推出 Gemini 4 Hydrogen,將該模型定位為適用於日常軟體工程與多步驟代理式工作流程的具成本效益、高吞吐量系統,詳見官方 Google DeepMind 公告。隨著軟體團隊日益部署自主代理來導覽程式碼庫並執行測試,若完全依賴大型前沿推理模型,將會產生明顯的延遲與不斷累積的 API 費用。雖然深層架構推理對於複雜系統設計依然不可或缺,但如編寫在地化修改、執行測試工具與解析建置日誌等日常工程任務,則需要快速執行。Hydrogen 既可作為高容量開發的獨立工具,也能在多模型路由管線中與前沿模型搭配作為執行引擎。
核心產業重新調整:Google 推出適用於高吞吐量工作流程的 Gemini 4 Hydrogen
概覽
- Google DeepMind 推出了 Gemini 4 Hydrogen,這是一款高吞吐量模型,旨在以比前沿層級更低的延遲處理日常編寫、程式碼庫問答與代理式工作流程。
- 該模型在橫跨輸入與輸出的統一 1,048,576 個 Token 的上下文視窗內運作,定價為每百萬個輸入 Token 1.50 美元,每百萬個輸出 Token 7.50 美元。
- 可用性涵蓋 Google AI Studio、Gemini API、Android Studio、Google 搜尋與企業平台,存取層級則依免費消費者方案與付費開發人員工作區而有所不同。
軟體工程工作流程的營運需求已超越單一提示詞的程式碼自動完成。現代代理式設定通常會觸發數十個自主步驟,包含讀取目錄結構、檢查相依性樹狀結構、提出修補程式以及執行迴歸測試。當開發人員將每個日常動作都透過前沿推理模型進行路由時,任務執行速度會顯著放慢。在疊代環境中,單一工具呼叫的微幅延遲也可能在自動化開發週期中累積成長期延遲。
圍繞此次發布的產業討論反映出一個日益明顯的共識:模型專業化對於生產擴充性至關重要。團隊不再將單一通用模型視為每個開發任務的預設選擇,而是正在評估分層架構。在這些配置中,高容量推理模型負責管理系統設計與模糊的問題界定,而專門的執行模型則處理重複的程式碼庫運算。Google 設計 Hydrogen 目的即在於滿足此營運層級的需求,透過標準 API 端點與程式化環境提供即時的開發人員可用性。
Gemini 4 Hydrogen 的基準測試分析與技術界限
Google 將 Hydrogen 描述為由 Gemini 4 Carbon 調適而成。然而,已發布的技術文件並未公開關於權重轉移機制、分詞器架構或蒸餾管線的特定內部細節。因此,技術評估必須聚焦於可觀察的基準測試資料、記載的上下文界限與回報的營運限制,而非推測的內部運作機制。
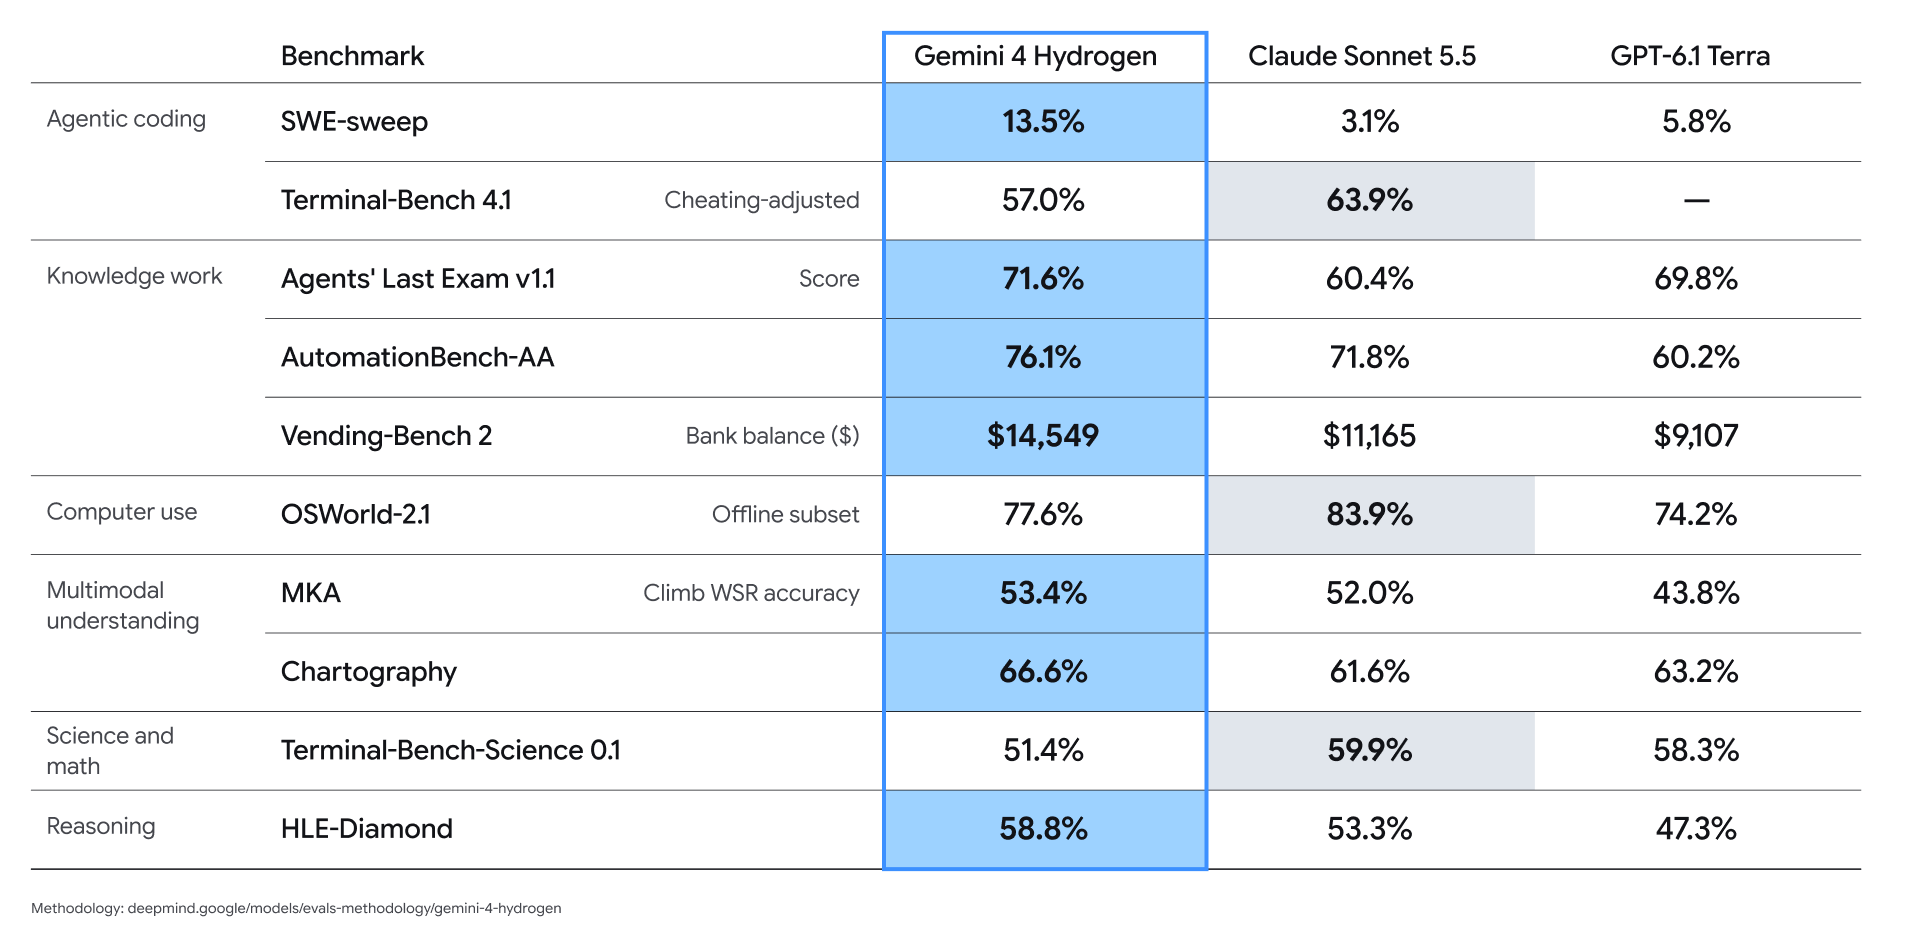
在 Gemini 4 Hydrogen 模型卡片中回報的標準評估中,Hydrogen 在不同任務類別展現出明顯的效能差異。在針對問題解決的 SWE-sweep 基準測試中,Google 回報 Hydrogen 的解決率為 13.5%,相較之下,Claude Sonnet 5.5 為 3.1%,在指定評估條件下的 GPT-6.1 Terra 則為 5.8%。相反地,在採用防作弊調整參數的 Terminal-Bench 4.1 上,Hydrogen 達到 57.0%,這比 Gemini 3.8 Flash(18.2%)大幅提升,但仍落後於記錄到 63.9% 的 Claude Sonnet 5.5。在獨立的 Artificial Analysis 智慧指數上,Hydrogen 在預設的高思考設定下獲得 51 分,在 xhigh 設定下獲得 54 分,相較之下,旗艦級的 Gemini 4 Argon 則為 50 分。
一項關鍵的架構考量是模型的上下文容量,如 Google 雲端模型文件中所記載。Hydrogen 提供跨所有輸入與輸出共享的 1,048,576 個 Token 的統一上下文上限。這意味著大量的輸入檔案會減少可用於模型輸出的剩餘 Token 容量。單一前景片段支援高達 65,536 個輸出 Token。較長的生成作業使用支援的接續機制,包含 SDK 管理的接續、自訂接續 Token 迴圈,或在可用時由伺服器管理的背景執行。所有片段皆受限於共用的上下文限制。輸出 Token 包含內部推理 Token、生成的工具請求以及可見的文字。
[Google Antigravity 中的多模型協調器架構]
                         ┌────────────────────────┐
                         │  Gemini 4 Carbon/Argon │ (架構規劃與複雜推理)
                         └───────────┬────────────┘
                                     │ 任務指派與計畫審查
                                     ▼
                         ┌────────────────────────┐
                         │   Gemini 4 Hydrogen    │ (平行程式碼生成與工具呼叫)
                         └───────────┬────────────┘
                                     │ 結構化工具呼叫
                                     ▼
                [ 本機執行階段 / 測試套件 / 檔案系統 ]
為了平衡延遲與分析深度,Hydrogen 納入了四個可配置的推理層級:低、中、高(預設)與特高(xhigh)。較低的設定可降低簡單語法調整的回應延遲,而較高的層級則配置更多內部推理 Token 來評估邊緣案例。開發人員應注意記錄在案的限制仍然存在:該模型的知識截止時間為 2026 年 3 月,在大量背景處理期間可能會經歷偶發的逾時,並且在模糊的提示詞上可能會產生幻覺或過度拒絕。
解耦系統與多模型協調的取捨
多模型協調允許開發平台將工程工作流程劃分至不同的模型層級。在這種模式中,複雜的系統建模與安全性評估會委託給前沿推理模型,而具體的程式碼修改與測試斷言則指派給快速執行模型。
Google 使用 Google Antigravity 中的實驗性協調器評估了此方法。在 Terminal-Bench 4.0 的測試中,Google 回報 Carbon 與 Hydrogen 之間的動態切換達到了接近 Carbon 的任務成功率,同時消耗的配額減少了 24%,且完成任務的速度比單獨執行 Carbon 快了 19%。Google 亦回報早期合作夥伴測試顯示,在選定的工作流程中,執行速度比 Gemini 3.8 Flash 快 2×–2.8×,Token 使用量減少 12%–23%。例如,Box 回報在複雜的文件與表格任務上,執行速度大約快 2×,且 Token 減少 12%。這些由廠商回報的範例反映了特定的整合設定,並不代表所有正式環境部署中節省成本的受控估算。
| 系統元件 | 代表性工具 | 定義的職責 | 營運範圍與限制 |
|---|---|---|---|
| 系統協調器 | Gemini 4 Carbon / Argon | 高階架構設計、跨程式碼庫規劃、複雜邏輯評估 | 高推理能力;會產生較高的每個 Token 成本與較長的生成延遲 |
| 執行引擎 | Gemini 4 Hydrogen | 在地化程式碼生成、自動化檔案編輯、快速工具呼叫迴圈 | 高生成吞吐量;可獨立運作或在協調器下運作 |
| 驗證閘道 | 單元測試工具 / 靜態程式碼檢查器 | 確定性規則檢查、語法驗證、迴歸測試 | 檢查定義的斷言與靜態規則;確信度取決於測試品質、覆蓋率與獨立審查 |
評估多模型架構需要工程團隊在系統複雜度與執行效率之間取得平衡。雖然動態模型路由可以降低重複任務的 Token 支出,但它也會引入協調額外負擔、子代理之間的狀態同步挑戰,以及對路由分類器的相依性。工程團隊必須針對自身的任務分佈、程式碼庫結構與 API 延遲需求來衡量這些取捨。
工程實作與工作流程治理檢查清單
將 Gemini 4 Hydrogen 整合至自動化開發人員工具鍊中需要明確的執行界限、Token 監控以及防禦性代理治理。
開發人員實作檢查清單
- 將思考層級與營運任務對齊:根據工作負載複雜度配置推理工作參數。保留
xhigh給複雜的演算法邊緣案例,維持high作為程式碼庫導覽的標準基準,並將medium或low用於對延遲敏感的任務,例如程式碼重新格式化或簡單的說明文件查詢。 - 建構平行工具介面:設計工具定義以在執行階段支援時接受批次參數,使工作代理能夠在合併的請求中請求多次檔案檢查或語法檢查,而非循序的往返呼叫。
- 將模型生成與執行解耦:確保模型將工具呼叫與程式碼修改建議為結構化資料,而隔離的客戶端執行階段或容器化測試執行器則執行命令並盡可能傳回執行結果與可重現的證據。
企業治理檢查清單
- 建立工作階段記錄:記錄工具請求、執行結果、權限決策、程式碼變更、測試結果以及可用的模型摘要。切勿將推理摘要視為完整或忠實的執行追蹤。
- 套用分層安全性控制:將外部說明文件、問題追蹤器與提取請求(PR)評論視為不受信任的輸入。雖然 Hydrogen 在 Gray Swan 間接提示詞注入基準測試中展現了 2.3 倍的韌性提升,但自動化輸入清理與執行權限閘道仍然是必要的。
- 監控累積的 Token 消耗:使用所選 API 的使用欄位追蹤輸入 Token 與計費輸出 Token(包含思考 Token)。當思考 Token 已經包含在計費輸出總數中時,切勿再次將其加總。
常見問題 (FAQ)
在生產工作負載中,Gemini 4 Hydrogen 與 Carbon 和 Argon 相比如何?
四個思考層級分別是什麼?開發人員何時應該使用 xhigh?
統一的定價模型如何在一百萬個 Token 的上下文視窗中運作?
工程團隊的關鍵要點
在生產環境中部署自主編寫工具,需要開發團隊超越前沿基準測試分數,並專注於疊代工具執行的經濟效益。將每個日常程式碼修改透過高延遲推理模型進行路由,會引入不必要的營運延遲與預算膨脹。同時,管理執行延遲與任務成功率需要對基準測試分數與錯誤復原行為有實際的期望。
透過建立結合高容量推理模型與快速、可預測執行引擎的分層架構,工程組織可以永續地擴充自動化開發工作流程。實施紀律化的多模型路由、結構化測試界限以及嚴格輸入驗證的團隊,將最有能力建構強固、可維護的 AI 輔助軟體管線。
參考資料
-
Google DeepMind. Introducing Gemini 4 Hydrogen. 官方公告。
-
Google DeepMind. Gemini 4 Hydrogen Model Card. 技術規格與安全性報告。
-
Google Cloud. Gemini 4 Hydrogen Model Documentation. 技術參考。
-
Google Antigravity. Gemini 4 Hydrogen in Google Antigravity. 多模型協調概覽。
-
Artificial Analysis. Gemini 4 Hydrogen Intelligence and Latency Benchmark. 獨立 AI 評估。
-
Ars Technica. Google Rolls Out Gemini 4 Hydrogen, Finally Replacing 3.8 Flash. 技術分析。
Share this article