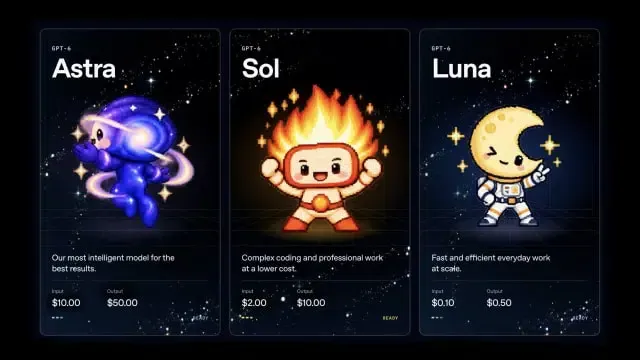
OpenAI 將 Sol API 成本砍半?OpenAI 於 2026 年 9 月 22 日正式宣布 GPT-6 Sol 與 GPT-6 Luna 的商業化上線,標準端點的 API Token 費率相較早期的 GPT-5.6 促銷定價降低了 50% 甚至更多。針對包含多達 272K 輸入 Token 的提示詞進行標準處理時,GPT-6 Sol 的定價為每百萬輸入 Token 2.00 美元、每百萬輸出 Token 10.00 美元;而較小的 GPT-6 Luna 模型則落在每百萬 Token 輸入 0.10 美元與輸出 0.50 美元。當 OpenAI 在各標準開發者層級將 Sol API 成本砍半時,基礎運算成本的下降轉變了生成式軟體的營運限制。更低的單位定價使得遞迴代理迴圈、背景批次萃取以及自主多步驟背景工作在規模化下具備經濟可行性。然而,對於系統架構師、可靠性工程師與後端開發人員而言,降低的財務摩擦卻暴露了下游擴展性的挑戰,將工程焦點從 Token 預算轉移至速率限制邊界、並行限制、遙測管線以及背壓瓶頸。
營運問題與財務瓶頸
在企業早期導入生產環境 LLM 的過程中,名義上的 Token 費用扮演了非正式的架構治理角色。高昂的推論成本迫使開發團隊將模型調用視為離散的使用者觸發交易。應用程式高度依賴人工介入審核、受限的對話歷史記錄,以及嚴格節流排程背景工作,以確保每月供應商帳單保持可預測性。永久中階模型降價的導入挑戰了這些歷史取捨,將系統工程關注點從模型定價轉移至後端基礎設施的韌性。
重點一覽
- 基準價格調降:於 2026 年 9 月 22 日,OpenAI 針對標準處理推出 GPT-6 Sol(每百萬 Token 輸入 2.00 美元 / 輸出 10.00 美元)與 GPT-6 Luna(輸入 0.10 美元 / 輸出 0.50 美元),適用於高達 272K Token 的提示詞,相較於 GPT-5.6 促銷 API 定價,實現了 50% 或更高的名義降幅。
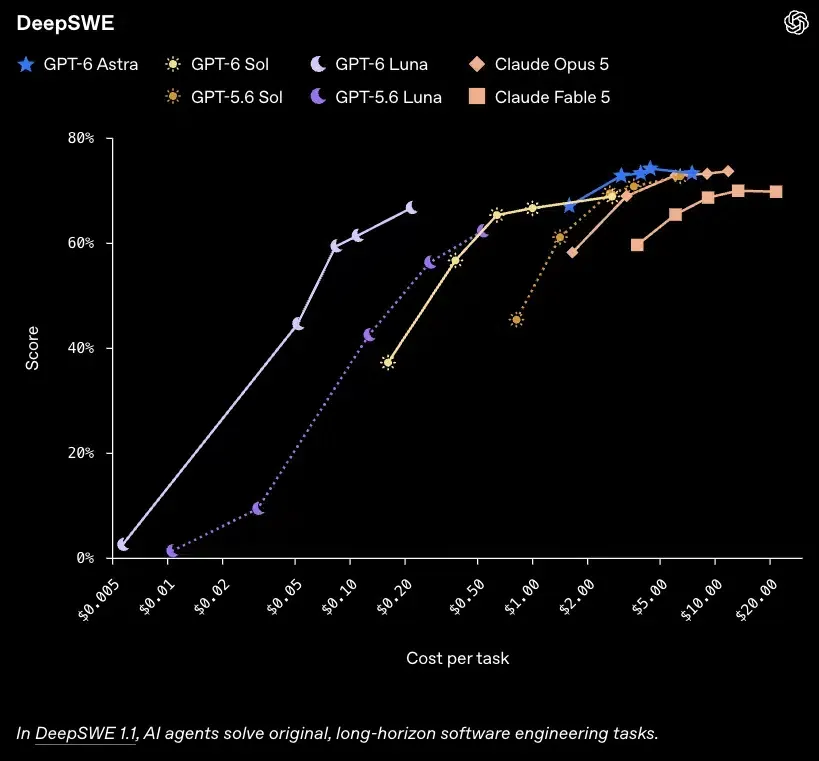
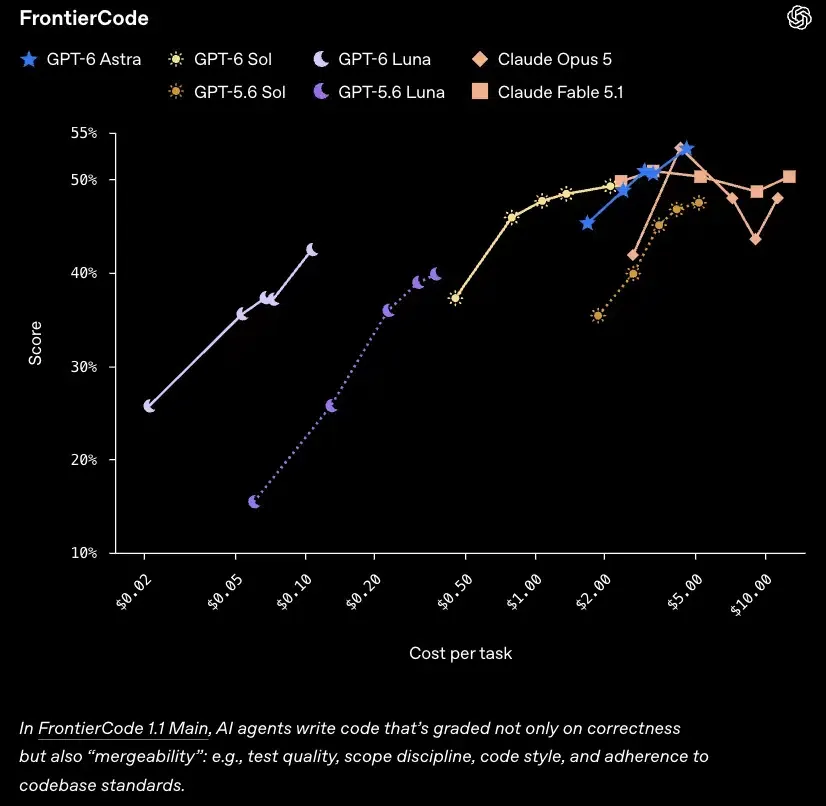
- 任務層級基準經濟學:在 AutomationBench 1.0.6 上,OpenAI 報告指出設定在超高推理工作量的 GPT-6 Sol 實現了 33.2% 的工作流程分數,平均回報成本為每項嘗試任務 0.27 美元,將開發人員評估從原始 Token 定價轉移至每個嘗試工作單元的成本。
- 提示詞快取動態:該平台針對快取輸入 Token 讀取提供自動 90% 折扣(以基本輸入 Token 費用的 0.1 倍計費),而初始快取寫入則以未快取輸入 Token 費用的 1.25 倍計費,需要謹慎的前綴正規化以在動態多步驟執行中維持高快取命中率。
如官方 OpenAI 開發人員 API 定價參考與 OpenAI 社群公告中所詳述,這些定價結構源自於底層推論管線與 KV 快取系統的持續改進。然而,當執行自動化任務序列的成本顯著下降時,工程團隊便會擴大其背景任務的範圍。先前阻礙背景工作執行持續輪詢、自動程式碼審查傳遞或多階段文件萃取管線的經濟門檻已經降低。
在整個市場中,多家基礎模型供應商已在開發人員層級調降或重構 API 價格。Anthropic 發布了 Claude Opus 5.5 以及 Anthropic Claude Opus 5.5 平台規格上的更新規格,標價為每百萬輸入 Token 4 美元、每百萬快取輸入讀取 0.20 美元,以及每百萬輸出 Token 20 美元,突顯了程式碼重構基準上降低的 Token 消耗。同時,Google 維持其在 Google AI 針對開發人員文件上記載的 Gemini 3.8 Flash 促銷介紹定價,而像是小米 MiMo-V2.6-Pro 等開放權重版本則在寬鬆的軟體授權下為自我託管團隊提供積極的 Token 成本選項。
當模型成本下降時,開發行為隨之改變。工程團隊部署更深的遞迴迴圈、將全面的企業文件注入系統提示詞中,並在複雜的任務圖表中配置自動重試邏輯。在 API 層看似成本減輕的做法,可能會將延遲與流量尖峰轉移至內部服務。如果編排背景工作為單一使用者交易發出數十個循序或平行的模型調用,內部資料庫池、輔助儲存叢集、遙測管線以及速率限制器必須吸收由此產生的負載。
系統性根本原因與非視覺請求鏈
當客戶端應用程式從互動式聊天介面過渡到非視覺背景自動化時,上游請求設定檔會發生劇烈變化。單一商業事件可以觸發自動化管線,檢查綱要、評估環境變數、調用外部工具,並在多個連續傳遞中驗證輸出。
+-----------------------------------------------------------------------------------------+
|                  RECURSIVE AGENT EXECUTION & BACKPRESSURE BOTTLENECK                    |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ User Web / App Trigger ]                                                             |
|         |                                                                               |
|         v                                                                               |
|  [ Ingestion API Gateway ]                                                              |
|         |                                                                               |
|         +---> Spawns Autonomous Worker Instance                                         |
|         |                                                                               |
|         v                                                                               |
|  [ Autonomous Orchestration Loop (GPT-6 Sol / Luna) ]                                   |
|         |                                                                               |
|         +--- Step 1: Query Context (Cache Read) -----------------+                      |
|         |                                                        |                      |
|         +--- Step 2: Tool Execution (Uncached Call)              |                      |
|         |                                                        |                      |
|         +--- Step 3: Self-Correction Validation                  |                      |
|         |                                                        v                      |
|         +--- Step 4: Recursive Execution Fork ----> [ Bursting Internal RPCs ]          |
|                                                                  |                      |
|  [ Downstream System Bottlenecks ]                               |                      |
|         |                                                        |                      |
|         +--- Internal Microservices <-- (Connection Starvation) -+                      |
|         +--- PostgreSQL / Cache Stores <-- (Connection Pool Saturation)                 |
|         +--- Distributed Telemetry Stream <-- (Lossy Drop Buffer Applied)               |
|         +--- Audit Compliance Store <-- (Durable / Replayable Queue Lag)                |
|         +--- Upstream Provider Thresholds <-- (HTTP 429 Rate Limit Exhaustion)          |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
遞迴代理執行與並行度倍增
在傳統的互動式網頁系統中,請求量反映了人類互動的節奏。每個 HTTP 執行緒通常對應到明確的使用者互動,且整體扇出較低,步調受限於人類的思考時間。客戶端執行階段傳送酬載、等待回應,並在發起後續互動之前暫停。
概念性請求設定檔比較:互動式與代理式
| 架構指標 | 互動式使用者流程 | 自主代理迴圈 |
|---|---|---|
| 並行模型 | 人類步調的請求扇出通常較低 | 1 個擷取事件 = N 個串聯的子調用 |
| 執行時機 | 由使用者回應與思考時間步調化 | 自動進行直到政策限制介入 |
| 內容失效 | 每個工作階段皆為全新酬載 | 高度依賴快取內容 |
| 錯誤處理 | 發生錯誤時由使用者重試 | 自動程式化重試 |
| 系統瓶頸 | 前端閘道器頻寬 | 內部資料庫池限制 |
| 故障級聯 | 隔離至單一工作階段 | 可能觸發佇列飽和 |
當系統整合自主代理時,這種步調便會脫鉤。單一觸發事件可以產生連續不斷的自動化調用序列。如果代理遇到短暫錯誤或格式錯誤的工具輸出,單純的重試邏輯可能會對後端服務產生快速的請求暴增。由於降低的 Token 成本使得更長的執行時間變得經濟實惠,自動化工作流程可以顯著擴大背景請求量,即使在活躍使用者基數持平的情況下也是如此。
提示詞快取機制:KV 重用、寫入額外負荷與前綴穩定性
OpenAI 將 Sol 與 Luna 的發布與其提示詞快取子系統的優化相結合。如 OpenAI 提示詞快取規格中所記載,符合快取前綴的輸入 Token 可在讀取定價上享有 90% 的折扣。提示詞快取主要減少模型端的重新計算,而不是充當通用的網路酬載壓縮機制。在標準的無狀態互動中,客戶端應用程式傳輸請求內容,而供應商則跳過重新計算匹配前綴的 KV 張量,大幅減少首次 Token 回應延遲與輸入計費。
至關重要的是,將初始前綴寫入伺服器端快取的計費為未快取輸入 Token 費率的 1.25 倍。要將成本效益最大化,需要在多個查詢之間維持前綴的穩定性。
選定的公開 API 定價列表 — 跨供應商無法直接比較
| 模型識別碼 | 輸入 ($/1M Tok) | 輸出 ($/1M Tok) | 快取讀取政策 |
|---|---|---|---|
| OpenAI GPT-6 Luna (標準) | $0.10 | $0.50 | 90% 折扣 (0.10×) |
| OpenAI GPT-6 Sol (標準) | $2.00 | $10.00 | 90% 折扣 (0.10×) |
| OpenAI GPT-6 Astra (標準) | $10.00 | $50.00 | 動態分級定價 |
| Anthropic Opus 5.5 | $4.00 | $20.00 | $0.20/1M 讀取 (0.05×) |
| Anthropic Sonnet 5 | $2.00 | $10.00 | 快取最高達 90% |
| Google Gemini 3.8 Flash | $0.75 (介紹期) | $3.75 (介紹期) | $0.075/1M 快取讀取 |
| Xiaomi MiMo-V2.6-Pro | $0.435 | $0.87 | $0.0036/1M 快取讀取 |
註:標準費率適用於短上下文層級(OpenAI 的提示詞最高可達 272K 輸入 Token)。供應商強制執行不同的快取寫入額外負荷、上下文限制與具時間限制的促銷條款。
前綴保留需要對 API 設定選項進行謹慎處理。在 OpenAI 的 API 架構中,直接更改推理工作量參數或修改工具定義陣列將會改變呈現的提示詞前綴並使先前的快取狀態失效。
為了在多輪對話期間保留快取的內容,開發人員必須以一致的順序保持工具綱要與基準指令。如果需要執行階段調整,開發人員應透過結構化工作階段控制項(例如 configuration_update)來更新參數,或使用 tool_choice 或 allowed_tools 來切換工具執行,而不是直接修改工具定義陣列。
當發生快取未命中時,上游供應商會在沒有 90% 讀取折扣的情況下重新處理輸入序列。在大規模下,這會增加推論延遲與逾時壓力。對於多步驟任務執行,成本評估從單純的 Token 乘數轉移至完成的任務支出,如 VentureBeat 關於 GPT-6 Sol 與 Luna 基準測試的報導中所見,其中 GPT-6 Sol 在 AutomationBench 1.0.6 上以平均每項嘗試任務 0.27 美元的成本取得了 33.2% 的分數。
遙測架構:將營運指標與合規稽核解耦
自動化 LLM 請求的激增對後端可觀測性與合規管線造成了顯著的壓力。高並行代理工作流程要求在營運遙測與法律稽核追蹤之間進行清晰的架構分離。
企業合規政策通常需要記錄工作階段中繼資料、工具執行證明與交易記錄。將營運遙測與合規資料同等對待會產生嚴重的工程取捨:
- 合規與安全稽核管道:必須提供具備明確重試、持久化與失敗處理的持久且可重播的傳遞,寫入寫入一次、存取受控的稽核儲存區中。酬載應擷取結構化中繼資料、呼叫者身分與密碼編譯狀態,同時系統性地淨化個人可識別資訊(PII)與密碼金鑰。在高負載下,這些管線必須套用背壓或持久地將任務排隊,而不是丟棄記錄。
- 營運遙測管道:追蹤效能指標,例如 Token 數量、提示詞快取命中率與上游回應延遲。由於這些追蹤用於即時監控與除錯,因此可以透過有界、有損的丟棄緩衝區進行處理。如果下游收集器變慢,應用程式可以安全地卸載多餘的營運遙測,以維護核心服務可用性。
當外部供應商傳回 HTTP 429 速率限制錯誤時,配置不當的重試政策可能會導致嚴重的營運問題。立即重試或缺乏隨機化抖動的同步指數退避常式會產生重試浪潮,可能透過中間微服務級聯,消耗執行緒池與資料庫連線。
解決方案比較:自建與採購的取捨
管理降低推論成本所帶來的營運負載,要求組織評估其 AI 閘道器與代理架構。團隊必須決定是在內部開發自訂路由、速率限制與遙測代理,還是部署專門的第三方基礎設施。
+-----------------------------------------------------------------------------------------+
|                 SYSTEM RESILIENCY PIPELINE WITH DECOUPLED TELEMETRY                     |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ Inbound Application Requests ]                                                       |
|         |                                                                               |
|         v                                                                               |
|  [ Sliding-Window Rate Limiter ] <--- Local In-Memory or Distributed Cache              |
|         |                                                                               |
|         +---> Rejects / Delays Excess Concurrency (HTTP 429 Protection)                 |
|         |                                                                               |
|         v                                                                               |
|  [ Prompt Normalization & Cache Alignment Engine ]                                      |
|         |                                                                               |
|         +---> Pins Static System Prompts & Tool Definitions to Base Prefix              |
|         +---> Uses Structured Controls to Modify Session Parameters                     |
|         |                                                                               |
|         v                                                                               |
|  [ Upstream Provider Dispatch (OpenAI / Anthropic / Local API) ]                         |
|         |                                                                               |
|         +---------------------------------------+---------------------------------------+
|         |                                       |                                       |
|         v (Synchronous Fast Path)               |                                       |
|  [ Client Response Assembly ]                   |                                       |
|         |                                       v (Asynchronous Dual Path)              |
|         v                               +-----------------------------------------------+
|  [ Return Payload to App ]              |                                               |
|                                         v (Lossy Ring Buffer)   v (Durable Outbox)      |
|                                    [ Operational Metrics ]  [ Compliance Audit Store ]  |
|                                    (Drops on Congestion)    (Durable / Replayable)      |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
自訂內部韌性管線
開發自訂基礎設施可讓工程團隊完全掌控網路政策、資料淨化與路由策略。組織可以建構量身打造以符合其精確內部微服務拓樸的邊緣代理。
// Reference implementation: Synchronized Token Bucket with fractional remainder and bounded saturation
package com.example.ai.resilience;

import java.math.BigInteger;
import java.time.Duration;

public final class TokenBucketLimiter {
    private final long maxTokenCapacity;
    private final long refillPeriodNanos;
    private long availableTokens;
    private long lastRefillNanos;
    // Scaled remainder numerator in the range [0, refillPeriodNanos)
    private long scaledRemainder;

    public TokenBucketLimiter(long maxTokens, Duration refillPeriod) {
        if (maxTokens <= 0 || refillPeriod.isZero() || refillPeriod.isNegative()) {
            throw new IllegalArgumentException("Invalid boundary configuration for TokenBucketLimiter.");
        }
        this.maxTokenCapacity = maxTokens;
        this.refillPeriodNanos = refillPeriod.toNanos();
        this.availableTokens = maxTokens;
        this.lastRefillNanos = System.nanoTime();
        this.scaledRemainder = 0L;
    }

    public synchronized boolean tryAcquire(long requestedUnits) {
        if (requestedUnits <= 0) {
            return false;
        }
        refillTokens();
        if (requestedUnits > availableTokens) {
            return false;
        }
        availableTokens -= requestedUnits;
        return true;
    }

    private void refillTokens() {
        long nowNanos = System.nanoTime();
        long elapsedNanos = nowNanos - lastRefillNanos;

        if (elapsedNanos <= 0) {
            return;
        }

        // Advance baseline timestamp monotonically
        this.lastRefillNanos = nowNanos;

        // If bucket is already full, discard unconsumed fractional credits to prevent timing drift
        if (this.availableTokens >= this.maxTokenCapacity) {
            this.scaledRemainder = 0L;
            return;
        }

        long wholePeriods = elapsedNanos / refillPeriodNanos;
        long remElapsedNanos = elapsedNanos % refillPeriodNanos;

        // Fast-path: if at least one complete period has elapsed, the bucket fully replenishes to capacity.
        // This eliminates the multiplication overflow surface (wholePeriods * maxTokenCapacity).
        if (wholePeriods > 0) {
            this.availableTokens = maxTokenCapacity;
            this.scaledRemainder = 0L;
            return;
        }

        // Under sub-period micro-intervals, calculate exact fractional tokens using BigInteger arithmetic
        BigInteger bigRemNanos = BigInteger.valueOf(remElapsedNanos);
        BigInteger bigCapacity = BigInteger.valueOf(maxTokenCapacity);
        BigInteger bigRemainder = BigInteger.valueOf(scaledRemainder);
        BigInteger bigPeriod = BigInteger.valueOf(refillPeriodNanos);

        // totalWork = (remElapsedNanos * maxTokenCapacity) + scaledRemainder
        BigInteger totalWork = bigRemNanos.multiply(bigCapacity).add(bigRemainder);
        BigInteger[] divAndRem = totalWork.divideAndRemainder(bigPeriod);

        long tokensGenerated = divAndRem[0].longValue();
        this.scaledRemainder = divAndRem[1].longValue();

        if (tokensGenerated > 0) {
            long spaceLeft = maxTokenCapacity - availableTokens;
            if (tokensGenerated >= spaceLeft) {
                this.availableTokens = maxTokenCapacity;
                this.scaledRemainder = 0L;
            } else {
                this.availableTokens += tokensGenerated;
            }
        }
    }
}
然而,內部開發需要持續的工程維護。團隊必須手動適應供應商 API 更新、處理多個供應商不斷演進的速率限制,並管理分散式遙測佇列。這種維護額外負荷可能會將內部開發人員資源從核心產品功能中轉移出去。
商業閘道器與基礎設施工具
為了避免從頭建構這些功能,許多企業會部署託管的 API 代理、LLM 閘道器與邊緣控制平面。某些託管閘道器提供感知供應商的速率限制協調、可觀測性、政策控制與感知快取的路由;確切功能因供應商而異,且前綴優化通常仍需要應用程式層級的請求紀律。
商業平台允許工程團隊強制執行每個環境的成本配額、跨模型系列配置自動容錯移轉路由,並在記錄請求中繼資料之前剝離敏感的客戶資訊。專門建構的閘道器可管理並行尖峰、稽核 API 消耗趨勢,並在複雜的應用程式環境中保護下游微服務。
決策矩陣:內部管線與託管平台
| 評估標準 | 內部韌性工具 | 託管路由基礎設施 |
|---|---|---|
| 前期開發工作 | 高(3-6 個工程週) | 低(透過標準 API 整合) |
| 協定維護 | 持續的團隊責任 | 由供應商更新處理 |
| 營運控制 | 完整的堆疊可見性 | 受限於供應商介面 |
| 提示詞快取調校 | 需要自訂代理 | 取決於供應商;通常需要應用程式配合 |
| 遙測隔離 | 自訂佇列管理 | 取決於供應商 |
| 財務成本設定檔 | 工程薪資額外負荷 | 經常性 SaaS / 使用量費用 |
整合檢查清單與治理時程
在 GPT-6 Sol 與 Luna 降價後擴大模型使用規模的組織,可以利用此營運框架來預防系統性過載:
+-----------------------------------------------------------------------------------------+
|                  ENTERPRISE LLM INFRASTRUCTURE READINESS CHECKLIST                      |
+-----------------------------------------------------------------------------------------+
| [ ] Audit client applications to identify unbounded recursive model calling loops       |
| [ ] Set hard timeout limits and non-linear retry backoffs with randomized jitter        |
| [ ] Implement local and edge token-bucket rate limiters ahead of upstream calls          |
| [ ] Organize prompt structures to maximize prompt caching prefix reuse                   |
| [ ] Separate lossy operational telemetry from durable, replayable audit trails           |
| [ ] Add runtime sampling to strip raw prompt bodies from high-frequency traces          |
| [ ] Monitor HTTP 429 status trends and set automated backpressure triggers              |
| [ ] Configure cost alerts and circuit breakers to catch runaway automated jobs          |
+-----------------------------------------------------------------------------------------+
遙測管線設定
可觀測性系統必須將提示詞記錄與即時請求路徑解耦。當處理高頻代理工作負載時,應用程式應該將遙測中繼資料寫入記憶體受限的非同步佇列,以防下游遙測收集器變慢時造成 I/O 停滯。
// Reference implementation: Memory-bounded telemetry logger with lossy load shedding
package com.example.ai.resilience;

import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.BlockingQueue;
import java.util.concurrent.atomic.AtomicLong;

public final class BoundedTelemetryQueue {
    public static final class LogPayload {
        public final String traceId;
        public final String modelId;
        public final long promptTokens;
        public final long completionTokens;
        public final boolean cacheHit;

        public LogPayload(String traceId, String modelId, long pTokens, long cTokens, boolean hit) {
            this.traceId = traceId;
            this.modelId = modelId;
            this.promptTokens = pTokens;
            this.completionTokens = cTokens;
            this.cacheHit = hit;
        }
    }

    private final BlockingQueue<LogPayload> internalQueue;
    private final AtomicLong droppedEvents = new AtomicLong(0);

    public BoundedTelemetryQueue(int maxQueueCapacity) {
        if (maxQueueCapacity <= 0) {
            throw new IllegalArgumentException("Queue capacity must be positive.");
        }
        this.internalQueue = new ArrayBlockingQueue<>(maxQueueCapacity);
    }

    public boolean recordEvent(LogPayload payload) {
        if (payload == null) {
            return false;
        }
        // Non-blocking submission: drops telemetry under load to preserve app stability
        boolean accepted = internalQueue.offer(payload);
        if (!accepted) {
            droppedEvents.incrementAndGet();
        }
        return accepted;
    }

    public LogPayload pollEvent() {
        return internalQueue.poll();
    }

    public long getDroppedEventCount() {
        return droppedEvents.get();
    }
}
常見問題 (FAQ)
GPT-6 Sol 與 Luna 的官方 API 費率是多少?
提示詞快取如何降低長對話的成本?
為什麼更便宜的 Token 會增加後端營運風險?
工程團隊的關鍵要點
GPT-6 Sol 與 Luna 的推出加速了一項更廣泛的趨勢:前沿智慧正變得更便宜且更容易取得。隨著單位 Token 成本急劇下降,財務限制不再是軟體架構的有效控制機制。
隨著組織採用高頻代理與多層模型拓樸,營運工程對於企業成功變得至關重要。團隊必須超越僅透過名義 Token 價格或基準分數來評估模型的做法。長期可靠性將取決於系統如何有效管理並行性、對齊提示詞內容以進行快取重用、妥善處理上游速率限制,以及將遙測與關鍵應用程式路徑解耦。建構韌性基礎設施的組織將能成功擴展其自動化代理工作流程,而不會犧牲應用程式執行時間或系統穩定性。
主要來源與參考文件
-
OpenAI 開發人員 API 定價參考:GPT-6 Sol、Luna 與 Astra 的官方開發人員費率卡、上下文視窗限制(≤272K 標準閾值)以及快取讀取/寫入定價時程。
-
OpenAI 社群公告:確認相較於 GPT-6 促銷層級實現 50% 基準價格調降的公開揭露與里程碑推出細節。
-
OpenAI 提示詞快取規格:關於伺服器端金鑰-數值前綴重用、快取寫入額外負荷與設定失效規則的架構文件。
-
Anthropic Claude Opus 5.5 平台規格:確認 4 美元輸入 / 20 美元輸出 / 0.20 美元快取讀取 Token 費率與基準效能的官方發布規格。
-
Anthropic Claude Sonnet 5 概觀:官方開發人員費率卡與提示詞快取效率指標(2 美元輸入 / 10 美元輸出 / 最高達 90% 快取折扣)。
-
Google AI 針對開發人員費率卡:Gemini 3.8 Flash 開發人員費率卡與介紹性定價政策概觀。
-
小米 MiMo 官方 API 定價與費率時程:MiMo-V2.6-Pro 推論的正統海外隨用隨付 Token 費率(0.435 美元輸入 / 0.87 美元輸出 / 0.0036 美元快取命中)。
-
VentureBeat 關於 GPT-6 Sol 與 Luna 基準測試的報導:涵蓋發布經濟學、永久定價保證以及 AutomationBench 1.0.6 任務成本數據(每項嘗試任務 0.27 美元)的報導。
Share this article



