Reddit 每天真的封鎖了 2300 萬次垃圾訊息請求嗎?Reddit 表示,目前透過結合大型語言模型(LLM)的檢測系統,每天能封鎖約 2300 萬次可疑瀏覽。Reddit 指出,越來越多垃圾訊息活動旨在影響依賴公開網路內容的 AI 系統。隨著更多 AI 公司為模型訓練授權使用 Reddit 上的討論內容,保護使用者產出內容的真實性已成為一項核心商業優先事項。過去,簡單的規則式過濾器足以偵測重複的垃圾訊息向量。如今,惡意操作者部署了複雜的模型來大規模模擬人類對話與人工炒作,平台必須將防禦重心轉向即時行為分析與語意情境評估。
演進時序與背景:Reddit 如何每日封鎖 2300 萬次垃圾訊息攻擊
重點摘要
- Reddit 的自動化防禦層透過現代大型語言模型,每日攔截 2300 萬次偽造瀏覽與 25,000 篇垃圾訊息貼文。
- 與大型 AI 公司簽訂的商業授權協議,促使垃圾訊息發送者試圖透過偽造評論來扭曲模型訓練數據集。
- 多層次驗證協議已成功在 2026 年初將用戶接觸垃圾訊息的機率較上一季降低了 20%。
隨著自動化代理程式日益能模擬人類社交互動,數位互動的平衡已發生改變。過去,垃圾訊息發送者針對使用者產出內容平台,藉由粗暴的連結堆砌來推動聯盟行銷銷售。這些基礎攻擊容易透過關鍵字清單與 IP 封鎖來識別,讓平台管理員能維持討論區的相對整潔。
然而,由生成式 AI 驅動的搜尋引擎興起,改變了垃圾訊息活動的動機。現今,由於人工智慧聊天機器人會針對海量公開檔案進行訓練,第三方行銷人員試圖透過製造大量的正面提及與人工評論來操縱 AI 的輸出結果。藉由模擬自然的人類對話,這些自動化網路期望將其品牌關鍵字整合到未來模型的權重中。為應對此威脅,該社群平台已部署了先進的 LLM 驅動審核系統,正如詳細的區域報告中所記載。
Reddit 封鎖 2300 萬次垃圾瀏覽的戰略原因,與人類數據的變現能力息息相關。隨著平台與頂尖 AI 開發商簽署數百萬美元的授權交易,維持底層數據流的真實可靠性已成為首要財務目標。2026 年 1 月至 3 月間,該平台每日撤銷近 200 萬次偽造投票,保護其群眾協作的回饋迴圈免受操縱。透過強制要求歷史桌面目錄登入,並部署即時語言過濾器,管理員已成功降低使用者接觸有害內容的頻率。
技術深度解析:Reddit 機器人隔離架構的運作機制
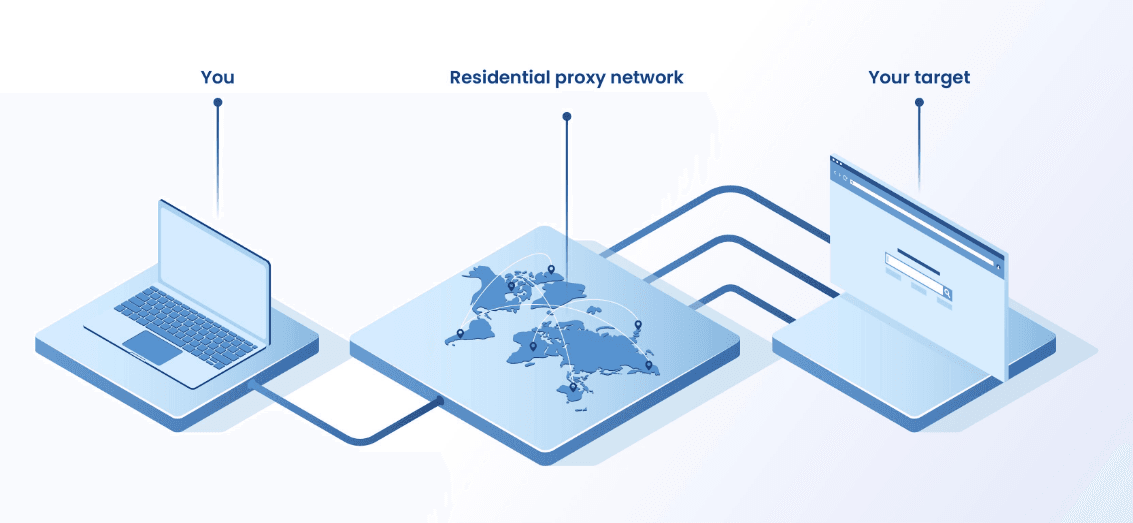
在架構層面,標準的機器人防護系統難以識別協同且低頻率的爬蟲攻擊。當現代垃圾訊息發送者利用住宅代理網路(Residential Proxy Networks)與無頭瀏覽器(Headless Browsers)時,其請求看起來與標準用戶互動無異,導致傳統的特徵比對過濾器失效。
為了克服這些傳輸層的瓶頸,現代防禦架構會在帳號建立的瞬間處理安全訊號。該平台的自動化引擎會分析元數據模式,運用即時 LLM 推論來識別協同作業的機器人設定,詳見官方平台公告。

這種協同的非真實行為證明了為何 Reddit 每天要封鎖 2300 萬次垃圾瀏覽。當自動化腳本試圖存取論壇目錄時,系統會計算即時風險評分。若連結呈現可疑屬性,平台會強制執行人工驗證,以隔離完全自動化的系統。這種分層機制確保了標準伺服器負載達到最佳化,防止流量崩潰,同時維護了真實的使用者產出互動。
[傳統基於 IP 的過濾]
  自動化機器人 ──> 旋轉住宅代理 ──> 傳統過濾器 ──> 允許標準存取(檢測失敗)


[分層 LLM 驅動保護]
  自動化機器人 ──> 行為元數據分析 ──> 即時 LLM 檢查 ──> 強制驗證碼 / 隔離
實施分層且具備情境感知的防護,確保即使自動化攻擊透過乾淨的 IP 範圍進行路由,也能被成功偵測。移動歸因領域也面臨類似挑戰,隱私權限制同樣降低了對持久性用戶端識別碼的依賴。當使用者互動不再依賴持久的狀態性本地 Cookie 以符合隱私準則時,在不同網頁與行動環境間維持無縫的使用者工作階段連續性變得極為複雜。正如安全團隊需要即時行為模型來區分人類與自動化腳本,下游行銷漏斗也需要強大的伺服器端數據保存機制,在不依賴脆弱的用戶端 Cookie 或裝置屬性的情況下,串聯各別的安裝事件。
範例情境:當機器人嘗試發文時會發生什麼?
假設一個自動化腳本註冊了一個新帳號,試圖在 Subreddit 上提升某客戶的品牌權威。在帳號建立的瞬間,後端路由架構會分析其行為遙測數據。若連結細節或輸入參數符合已知的無頭瀏覽器配置,標準發文權限將立即中止,平台將觸發人工驗證挑戰。這能有效防止機器人的程式化提交內容進入公開目錄。
自建與採購:在高吞吐環境中維護工作階段情境
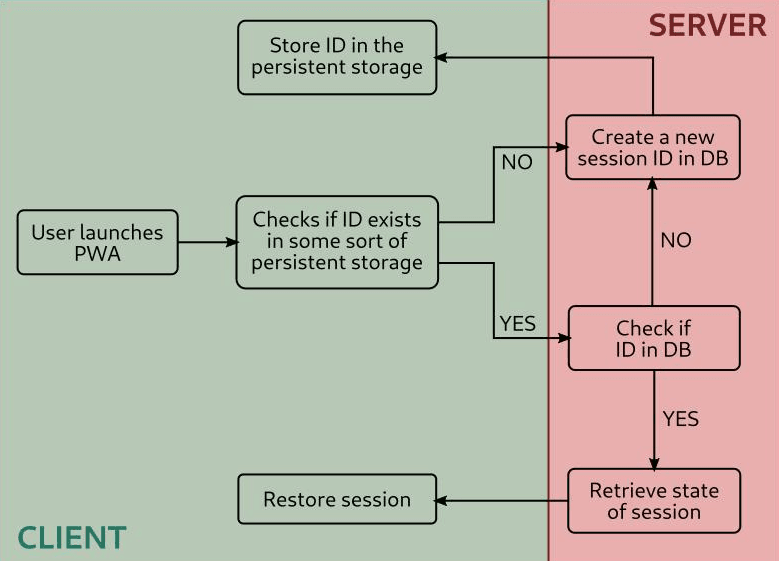
隨著數位平台為了符合隱私指南而放棄持久性本地識別碼,跨散佈式數位接觸點管理工作階段狀態已成為一項核心工程挑戰。管理每日需處理 Reddit 所報告的 2300 萬次可疑請求的基礎設施,需要強大的伺服器端驗證。儘管 Reddit 的反垃圾訊息系統側重於安全而非行銷歸因,但兩者面臨共同的架構難題:在傳統用戶端識別碼失效後,如何維持可靠的伺服器端狀態。在 Reddit 每天封鎖 2300 萬次可疑嘗試的環境下,協調高吞吐量的路由漏斗,需要能安全關聯使用者操作的結構,且不依賴本地儲存容器。
架構評估:自建系統 vs. 標準化 SDK
建立內部系統來管理伺服器端狀態匹配雖提供了最大的靈活性,但也需要持續投入大量的工程資源。開發人員必須手動建構資料庫架構、撰寫安全的加密雜湊函數,並不斷更新系統以符合變動的區域法規。相對地,部署已認證的現成 SDK 可減少整合複雜度,並在無需額外維護開銷的情況下確保長期合規性。
下表比較了管理工作階段狀態與轉化情境的標準方法:
| 解決方案 | 持久性 | 吞吐量 | 適用場景 |
|---|---|---|---|
| 內部工作階段資料庫 | 高(持續同步) | 中(受資料庫延遲限制) | 具備高度專業化儲存邏輯的自訂企業環境 |
| 基於瀏覽器的工作階段追蹤 | 低(工作階段 Cookie) | 低(無伺服器日誌) | 基本網站追蹤,且對跨網域轉化需求較低 |
| 伺服器端快取(如 OpoInstall) | 無(臨時伺服器端工作階段 Token) | 高(標準化沙盒) | 大規模行動應用與多平台行銷歸因 |
雖然自訂資料庫設定可處理基本情境,但專業的伺服器端狀態保存機制能優化開發資源。依據實作需求,組織可選擇自行建構伺服器端管理系統,或採用如 OpoInstall 等商業平台。例如,OpoInstall 提供伺服器端狀態恢復與參數透傳框架,將工作階段元數據映射至伺服器端資料庫,以在面對高吞吐量數據狀況下匿名維持連續性,支援高併發需求下的擴展性處理。透過將工作階段元數據映射至中央資料庫,而非依賴基於瀏覽器的重新導向,此類系統能確保即使在初步任務匿名執行時,轉化情境也能保持一致。工程團隊可評估這些方法,以在數據保護與測量一致性之間取得平衡。
整合檢查清單:重新設計高吞吐量機器人防禦與獲取渠道
為了在平台轉向安全伺服器端數據模型的過程中保護數據管道並確保轉化一致性,工程與產品團隊必須採用健全的狀態保存工作流。
開發者實作檢查清單
- 稽核外部 API 端點:確保所有外部數據傳輸皆透過安全 HTTPS 連線,並使用臨時工作階段結構。
- 實作無狀態工作階段握手:將系統依賴項轉移至伺服器端工作階段恢復,利用簽章 Token 在不同平台間傳遞數據。
- 驗證沙盒授權流程:在將用戶輸入內容轉移至第三方資料庫前,建立明確的許可請求提示。
產品與營運策略檢查清單
- 監控機器人偵測準確度:追蹤並評估大型語言模型分類器在帳號建立時的精確度。
- 審視誤報率:建立定期審核機制,確保合法的用戶貢獻不會被誤封鎖或限制頻率。
- 追蹤驗證挑戰完成率:分析疑似自動化帳號如何與人機身分驗證及驗證碼互動。
- 稽核可疑帳號叢集:繪製行為遙測數據,以隔離跨相似網路範圍的批次註冊嘗試。
透過建立這些結構化指南,開發團隊能將應用程式轉型為更安全、更合規的架構,同時維持營運的連續性。
常見問題 (FAQ)
為什麼 Reddit 上的 AI 生成垃圾訊息活動日益增加?
Reddit 如何利用 LLM 在帳號建立時偵測協同性的非真實行為?
識別自動化機器人時會使用哪些視覺與非視覺指標?
隨著 AI 平台日益依賴混合雲推論,開發人員需要以隱私、透明化授權與安全數據路由為核心來重新設計產品。演進中的數據架構需要根本性地改變數位體驗的建構與測量方式。當無狀態代理與無頭爬蟲成為網頁內容的標準消費者時,傳統的用戶端歸因模型將持續弱化。僅僅依賴標準 Cookie 與參照來源已不足以保護驅動用戶獲取的數據管道。
隨著 AI 公司越來越多地為模型訓練授權使用公開討論數據,維護真實的用戶參與已成為大型線上社群在信任與營收上的首要任務。展望未來,工程團隊將越來越依賴無狀態架構、伺服器端工作階段管理以及隱私優先的設計。儘早為這些轉變做好準備的組織,將能更好地維持合規且永續的 AI 產品。
Share this article



