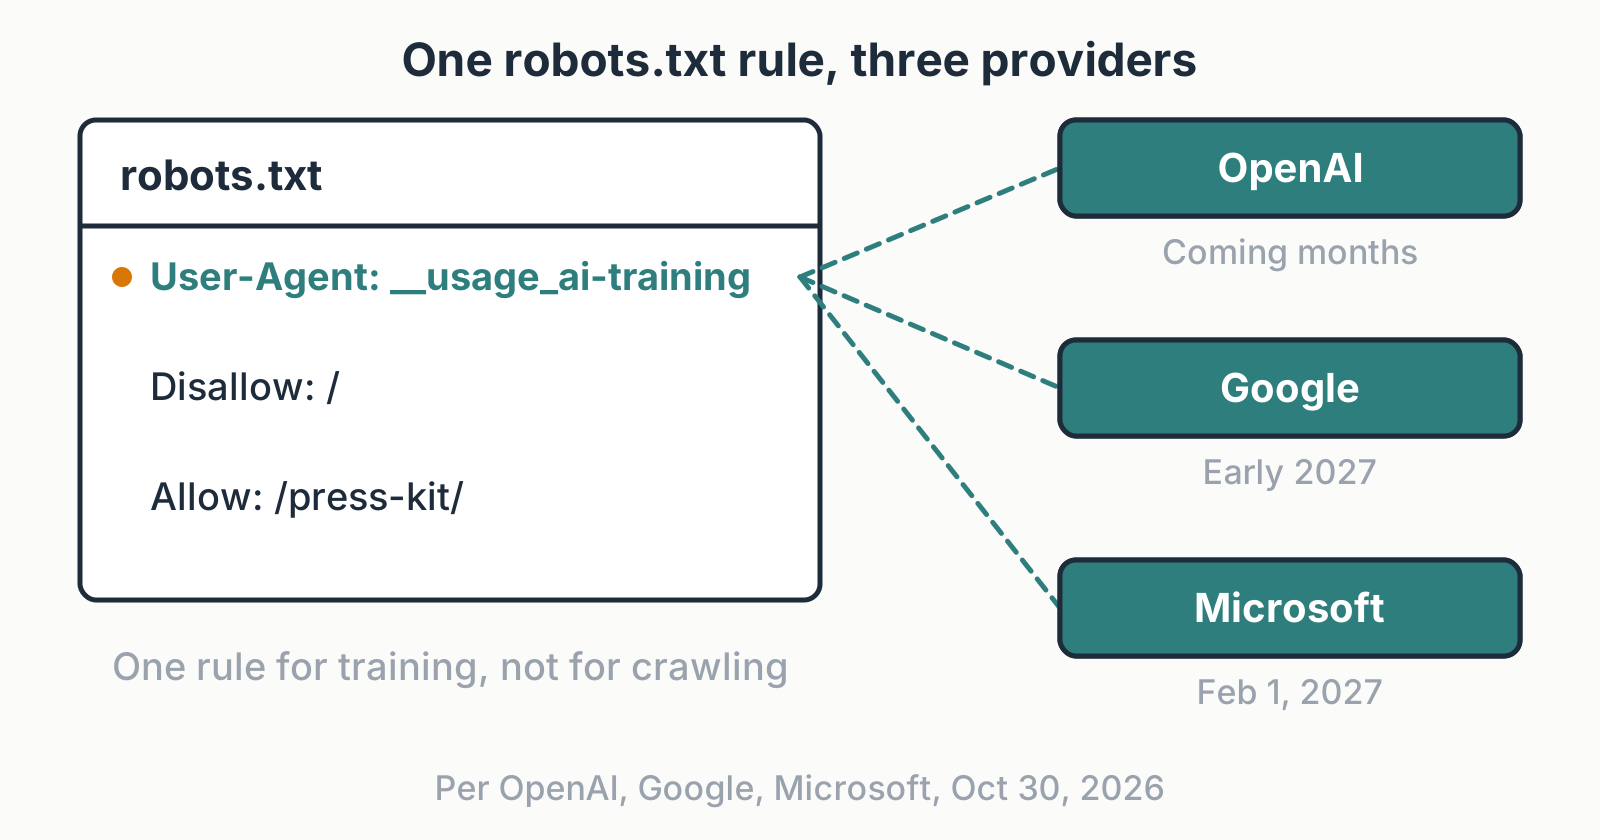
OpenAI 與 Google 支援共同的 AI 訓練退出機制?OpenAI、Google 與 Microsoft 於 2026 年 10 月 30 日宣佈,計畫在 robots.txt 中支援單一且共用的政策代幣,讓網站營運商能夠同時向多個提供者表達生成式 AI 模型訓練的偏好設定。此提案機制源自 Anthropic 工程師 Kevin Kelley 提交給 IETF AI 偏好工作群組的獨立網際網路草案(Internet-Draft)。雖然該倡議為內容發布者提供了一種簡化的方法,能利用標準的 Allow 與 Disallow 語法宣告訓練退出,但其實施時間表將延續至 2027 年,且各大平台計畫在模型訓練與即時對話接地(grounding)中,以不同的方式解讀與應用此訊號。
產業核心重組:各大 AI 實驗室就 Robots.txt 標準展開協調
重點總覽
- OpenAI、Google 與 Microsoft 於 2026 年 10 月 30 日宣佈協調計畫,將認可一個共用的 robots.txt 政策代幣
__usage_ai-training,以管理生成式模型的訓練偏好。 - 此訊號定義於 Anthropic 工程師 Kevin Kelley 撰寫的獨立 IETF 網際網路草案中,確立了標準化語法,但不代表官方或最終完成的 IETF RFC 標準。
- 平台採用時程顯著分歧:Anthropic 已展開內部工程作業,OpenAI 目標於未來幾個月內推出,Microsoft 於 2027 年 2 月 1 日開始實施,而 Google 則預計於 2027 年提供支援。
近三十年來,Robots 排除協定(Robots Exclusion Protocol)一直主導著自動化網路爬蟲與公開線上內容的互動方式。網站管理員會在根目錄中放置一個簡單的 robots.txt 純文字檔案,定義哪些搜尋引擎使用者代理(user-agent)有權限抓取特定的 URL 路徑。此協定運作於一項基礎的商業協議上:網站發布者允許爬蟲索引其內容,以換取搜尋引擎結果頁面上的曝光度、外部引薦流量與品牌能見度。
生成式人工智慧的快速崛起打破了這個經濟模型。前沿 AI 實驗室部署的自動化擷取工具開始大量吞噬網域以訓練基礎模型,通常直接在回答介面中摘要原始內容,卻未提供引薦點擊給發布者。尋求防止其智慧財產權遭到擷取的內容擁有者,被迫維護破碎且複雜的專屬使用者代理清單,包含 GPTBot、ClaudeBot 與 Google-Extended。這種管理負擔增加了同時管理多個爬蟲指令時發生設定錯誤或意外取消搜尋索引的營運風險。

共用 AI 訓練退出機制的出現,標誌著從破碎的廠商阻擋轉向合作協定治理的重要轉變。透過圍繞共用政策代幣協調支援,各大 AI 提供者旨在降低內容創作者為生成式模型訓練建立明確界線時面臨的技術門檻。根據Google 搜尋中心官方公告,這項單一規則讓網站管理員只需透過一個步驟即可宣告其生成式 AI 訓練立場,而不必追蹤並設定進入市場之每個個別商業 AI 爬蟲的相異指令。
底層架構機制:__usage_ai-training 代幣的運作原理
支援共用偏好訊號的技術架構規範於 IETF 機器可讀訓練偏好訊號網際網路草案中。至關重要的是,該草案並未引入新穎的指令,亦未改變 RFC 9309 所定義之 Robots 排除協定的底層語法。相反地,它透過指派一個保留的政策代幣 __usage_ai-training 來重複使用標準的 User-Agent 記錄。
若要設定退出,網管人員會建立一個普通的規則區塊,將此政策代幣指定為使用者代理,後接標準的 Disallow 與 Allow 規則。以下範例說明了網站擁有者如何在所有網站目錄中表達退出,同時保留公開宣傳資料的例外情況:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
構成「AI 訓練」之定義的語意,錨定在 IETF 工作群組的基礎詞彙規範中。在此框架下,訓練被嚴格定義為利用擷取的網路內容來修改或微調生成式人工智慧模型的已學習權重與參數。非生成式的運算操作(例如標準文件分類、搜尋索引排序、拼字修正與垃圾郵件過濾)則被明確排除在此定義之外。
協定界線:爬蟲 vs. 訓練 vs. 接地
要理解此提案代幣的營運限制,必須區分自動化資料擷取的各個不同階段:
[公開網路內容]
       │
       ▼
[1. HTTP 抓取 / 取得] ──> 受特定爬蟲使用者代理管轄(例如 GPTBot、Bingbot)
       │                    *__usage_ai-training 不管轄 HTTP 取得行為*
       ├────────────────────────────────────────┐
       ▼                                        ▼
[2. 模型訓練用途]                  [3. 即時接地 / RAG]
   *__usage_ai-training: Disallow*          *受頁面標籤與廠商設定管轄*
   發出反對訓練的偏好信號                  向 AI 模型提供即時網路內文
       │                                        │
       ▼                                        ▼
   執行取決於                              資格條件由個別平台政策設定
   參與的 AI 提供者
技術團隊必須評估此草案規範固有的四個結構性界線:
- 訊號管轄訓練,而非爬蟲:政策代幣並非針對網路爬蟲行為的指令。遭遇
__usage_ai-training下之Disallow: /的 AI 爬蟲仍然被允許透過 HTTP 取得 HTML 文件,只是接到指示不將該檢索到的文字餵入模型訓練管線。為防止機器人請求該 URL,管理員必須繼續封鎖該爬蟲的特定身分名稱。 - 萬用字元規則不適用:通用萬用字元區塊(例如
User-Agent: *後接Disallow: /)與政策代幣不符。草案強制要求參與的 AI 提供者不得將通用的萬用字元群組解讀為 AI 訓練偏好的表達。如果檔案省略了明確的__usage_ai-training代幣,標準即解讀該網站未表達任何訓練偏好。 - 無溯及既往的模型解除學習:更新網站的
robots.txt檔案是向前生效的。它為未來的抓取與訓練週期提供訊號,但不會強制 AI 實驗室清除已整合至歷史訓練資料集的資料,或刪除來自預先存在之基礎模型的權重。 - 自願協調勝過技術強制:該訊號表達的是發布者偏好;它不針對未參與或不合規的資料消費者提供技術強制執行。根據 RFC 9309 原則,robots.txt 仍然是合作性質的諮詢機制,而非存取控制防火牆。
提供者實施差異與移轉時程
雖然 Google、Microsoft 與 OpenAI 已宣佈支援共用訊號的計畫,但其技術實施與推出時程卻顯著分歧。每個提供者皆透過自身的產品基礎設施,來平衡搜尋引擎索引、生成式模型訓練與對話式檢索增強生成(RAG)之間的關係。
下表對比了已確認的平台承諾、解讀規則與移轉時程:
| 平台 | 已確認狀態與時程 | 政策代幣解讀 | 接地與檢索處理 | 舊版標籤移轉與例外 |
|---|---|---|---|---|
| 已宣佈支援;計畫於 2027 年推出(確切日期待定) | 當沒有明確的 Google-Extended 規則存在時,解讀為 Google-Extended: Disallow |
預設對應會影響 Gemini Apps 的接地;明確規則具備優先權 | 現有的 Google-Extended 指令維持完全有效;搜尋索引不受影響 |
|
| Microsoft | 已確認承諾;於 2027 年 2 月 1 日開始支援 | 在網路抓取期間被識別為訓練退出機制 | 與訓練脫鉤;透過頁面層級標籤獨立管理 | 於 2027 年 3 月 1 日針對 AI 停用 NoArchive/NoCache;Bing 網管工具臨時設定於 12 月 15 日開放 |
| OpenAI | 承諾於未來幾個月內實施 | 在資料擷取管線中提供直接支援 | 與 GPTBot 指令一同評估 |
現有的 GPTBot 設定維持活躍且可執行 |
| Anthropic | 員工撰寫草案;工作群組清單中回報了開發進度 | 計畫跨服務支援;正式新聞室時程待定 | 與 ClaudeBot 指令一同評估 |
現有的 ClaudeBot 爬蟲控制持續運作 |
Google 計畫在沒有明確的 Google-Extended 規則存在時,將共用 AI 訓練退出機制解讀為 Google-Extended 不允許。由於 Google-Extended 同時管轄 Gemini Apps 中接地的資格,因此這項預設對應可能會影響發布者的內容是否可用於這些體驗。在 Google 的實施中,明確的 Google-Extended 規則優先於共用訊號,但發布者不應假設 Google 現有的控制項為模型訓練與 Gemini Apps 接地提供獨立的退出機制。在 Google-Extended 下允許的內容可能符合 Gemini 接地資格,但不保證一定會被納入或引用。
相較之下,正如官方 Bing 網管更新中所詳細說明,Microsoft Bing 將模型訓練與即時接地視為不同的架構概念。Microsoft 允許發布者退出生成式模型訓練,同時繼續允許在 Copilot 回答中進行即時接地。管理這些偏好的網站可以在 robots.txt 中或透過頁面層級的 HTML 後設標籤與 HTTP 標頭來宣告訓練限制,這些標頭會覆寫個別 URL 的 robots.txt。接地透過頁面層級偏好進行控制,包含一個 DisallowExtended 選項,允許在 Microsoft 自身的工具(例如 Copilot)中進行接地,同時排除由 Microsoft 接地 API 驅動的第三方服務。此外,Microsoft 正逐步淘汰其對用於 AI 控制之 NoArchive 與 NoCache 標籤的歷史依賴;依賴這些標籤的網站必須在 2027 年 3 月 1 日之前移轉至新選項。臨時的 Bing 網管工具接地設定僅適用於截至 2026 年 12 月 15 日使用 NoArchive 或 NoCache 的網站。它將持續有效,直到 Microsoft 重新抓取該頁面並發現新偏好為止,或直到 2027 年 3 月 30 日(以先到者為準)。
工程檢查清單:為代理式網路稽核網站偏好
部署共用 AI 訓練偏好訊號需要在系統架構、內容營運與法律治理團隊之間進行協調。工程領導者必須確保伺服器設定能夠準確反映組織政策,而不會在無意間干擾搜尋引擎的探索。
網管與系統實施檢查清單
- 稽核目前的 Robots 資訊清單:審查現有的
robots.txt檔案以編製特定廠商指令目錄,並驗證GPTBot、ClaudeBot或Google-Extended的規則是否與組織的訓練政策衝突。 - 部署保留的政策代幣:實作
User-Agent: __usage_ai-training區塊,以統一格式在參與的 AI 提供者之間表達全域訓練界線。 - 維持細緻的例外路徑:如果公開資產(例如新聞稿、媒體資料包或開放的開發人員說明文件)旨在供模型取用,請在不允許指令下方宣告明確的
Allow:例外。 - 將抓取阻擋與訓練治理分離:如果主要目標是降低原始伺服器負載或防止未經授權的擷取,請設定基於 IP 的速率限制、CDN 機器人挑戰以及明確的爬蟲使用者代理封鎖。
治理與合規檢查清單
- 審查 Microsoft 接地移轉時程:對於利用
NoArchive或NoCache來控制 Bing Copilot 輸出的網站,請準備在 Microsoft 於 2027 年 3 月 1 日強制執行期限之前,轉移至新的頁面層級標籤。 - 評估搜尋探索的權衡:針對評估對話式回答引擎中能見度的平台,了解廠商特定的預設對應(例如 Google 回退至
Google-Extended)將如何影響即時檢索資格。 - 追蹤 IETF 工作群組更新:在 IETF AIPREF 工作群組中監督
draft-kelley-aipref-training-preference-signal的進展,以考量在 2027 年 5 月預定到期之前可能發生的語法更新。
Share this article