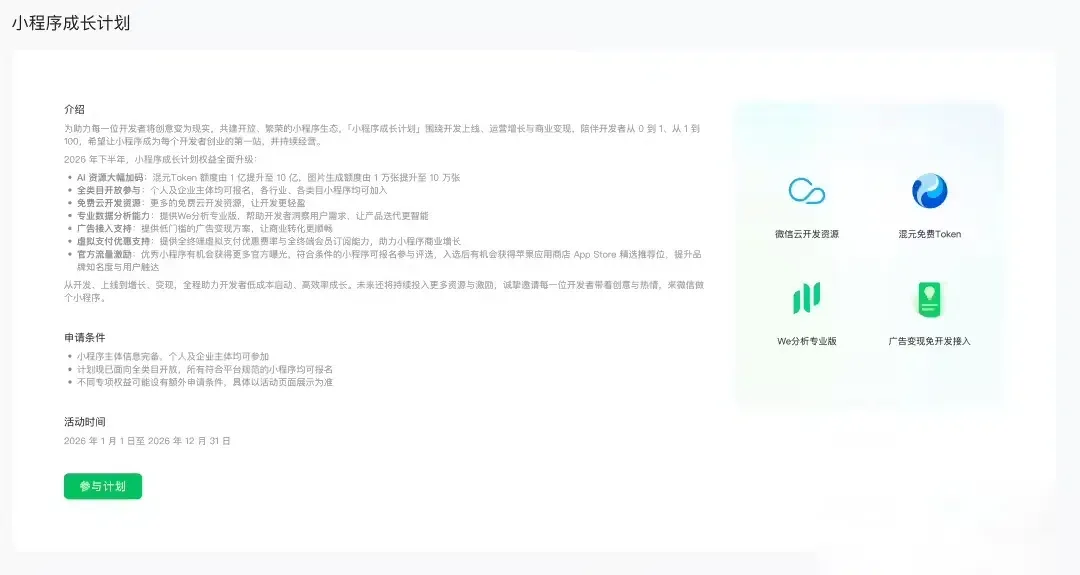
 微信 AI 小程式擴張?騰訊發布了一項新的開發者計畫,提供 10 億個免費混元文字 Token 以及 10 萬個圖像生成額度,旨在降低智慧型用戶端應用的開發門檻。透過降低 API 成本並簡化基礎模型的存取方式,騰訊期望加速 AI 功能在微信小程式中的普及,同時減輕開發者的基礎架構負擔。如今,AI 平台越來越多地將高運算量的任務分配至受信任的第三方雲端環境,因此明確的用戶同意機制與透明的路由規劃至關重要。隨著這些平台在外部基礎架構上處理越來越複雜的生成式請求,安全的多雲驗證路徑已成為維護用戶信任的關鍵。
為什麼微信 AI 小程式正進入大規模普及階段
概覽
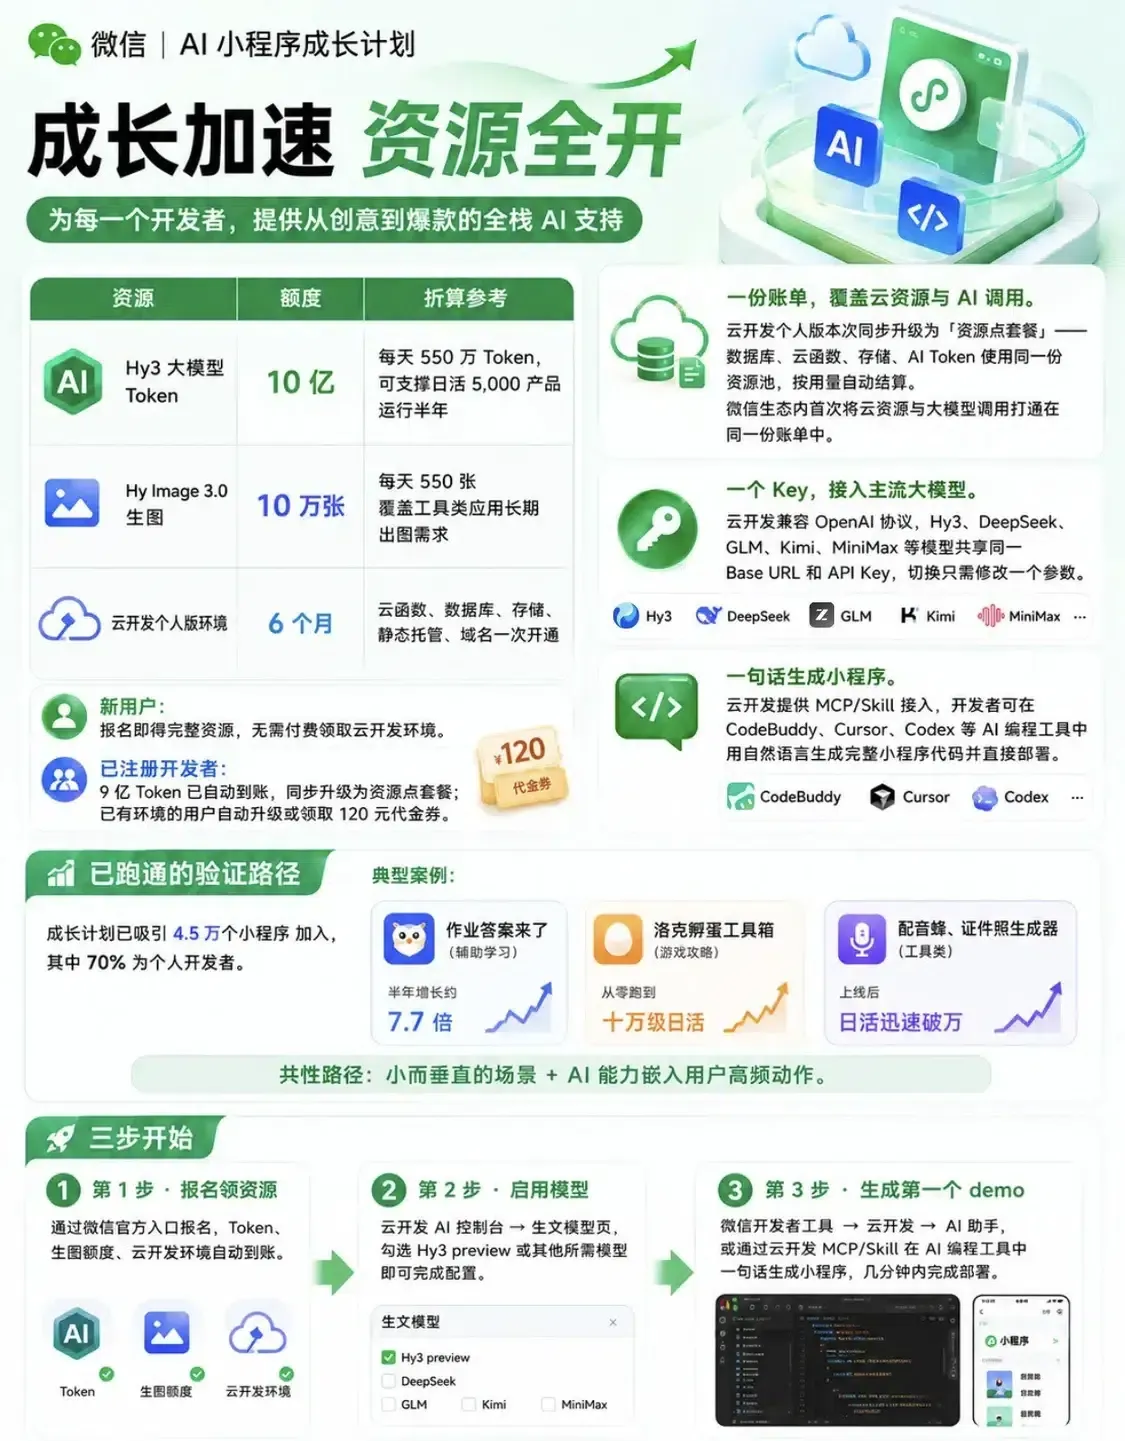
- 騰訊的開發者計畫將基準配額擴增至之前的 10 倍,在六個月內提供 10 億個文字 Token 與 10 萬個圖像生成額度。
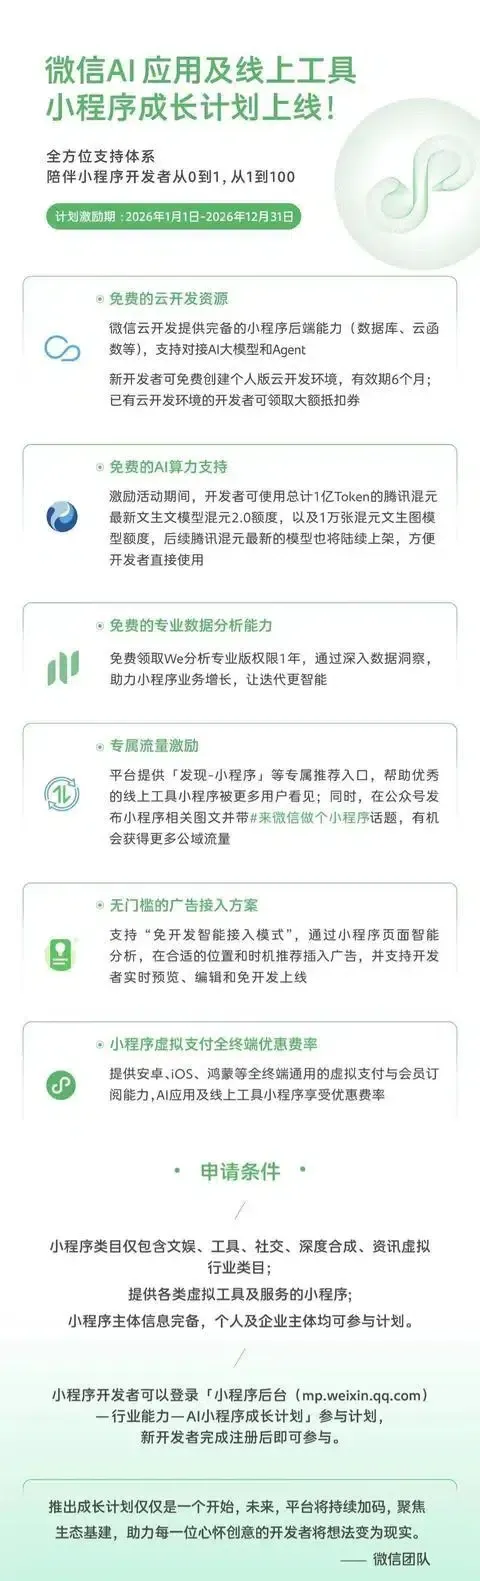
- 所有產業皆可申請,無結構性類別限制,個人開發者帳號與已驗證的企業主體均可領取資源。
- 升級後的端點可自動將現有專案遷移至現代推理模型,簡化無伺服器(Serverless)節點上的程式碼維護工作。
去中心化微型應用的生態正在經歷重要的營運轉型。過去,將大規模神經網路功能整合進輕量級用戶端應用,需要龐大的初始資本與技術基礎。小型團隊與個人開發者不僅要處理複雜的 API 閘道,還需管理繁重的帳單系統與繁瑣的密鑰配置。這些技術門檻往往使創作者卻步,導致產品設計多維持在簡單的規則型應用。
開發者在構建微信 AI 小程式時,現在無須經過正式的企業認證即可註冊個人帳號。透過提供充裕的免費 Token 資源,平台營運商消除了這些財務瓶頸。開發者若依照官方平台指南建立無伺服器環境,即可利用標準 Cloud SDK 直接設定模型。資源包內含對新發布的騰訊混元生成式模型的自動升級,使應用程式無需額外中介軟體,即可生成自定義圖像並執行深度文字互動。
微信 AI 小程式計畫為整合雲端資源與用戶端應用建立了一條可靠的路徑。在此更新框架下,平台為舊版應用提供自動化的向後相容性,將活躍連線轉移至更新後的端點。存取現代化資源無需進行任何手動環境配置。透過提供這些豐厚的配額,該計畫確保開發者能專注於產品體驗與轉換路徑,而非疲於監控即時使用量表。
技術深度解析:解構 CloudBase MCP 與無伺服器 AI 工作流
在系統層面上,於沙盒訊息環境中執行伺服器端模型處理,需要高度安全且符合標準的連線。使用模型上下文協定(MCP)部署微信 AI 小程式,讓開發者能與無伺服器後端進行安全通訊。透過部署 MCP,開發者能安全地連接標準整合開發環境(IDE)與雲端平台,從而透過自然語言提示詞實現自動化的程式碼部署與資源配置。
這些整合透過標準 API 包裝器進行配置,實現本地環境與雲端網路之間的安全數據轉換,詳見官方 API 存取文件。在此模式下,系統在隔離的沙盒內執行伺服器端呼叫,以保護用戶憑證免受外部攔截,從而為微信 AI 小程式部署建立了一套安全協定。
技術區分:無伺服器端點與本地上下文處理
從架構角度來看,無伺服器 API 執行與標準本地處理有顯著差異。當應用程式利用雲端函數執行模型查詢時,會將繁重的神經運算從終端 CPU 卸載至遠端彈性容器。然而,這種混合方法需要謹慎處理請求,以避免提示詞膨脹與延遲峰值。
下圖說明了典型的整合式雲端執行循環流程:
[Developer IDE] ──(Natural Language Prompt)──> [CloudBase MCP Server]
                                                     │
                                                     ▼
[WeChat Mini Program] ──(API Call: Server SDK) ──> [Serverless Cloud Function] ──> [Hunyuan Hy3 Engine]
當雲端函數觸發推理請求時,它會將用戶提示詞與系統指令集一併傳輸至騰訊混元模型叢集。為防止不必要的資源消耗,無伺服器層必須暫態地處理數據,確保記憶體針對高併發請求進行最佳化。在行動分析中也存在類似的 Token 節省最佳化與執行時資源管理挑戰,輕量級參數傳遞框架同樣消除了網路層的冗餘查詢。透過在 API 層最佳化數據傳輸路徑,開發團隊無需觸發伺服器超時限制即可擴展互動功能。
自建與採購:管理伺服器端整合與運算配額
隨著平台鼓勵快速開發用戶端 AI 應用,跨分散式雲端環境管理運算結構已成為首要的工程決策。支援微信 AI 小程式的高吞吐量路由管道,需要能夠在不依賴本地儲存容器的情況下,安全地關聯用戶行為的架構。開發者必須決定要為開源模型建立自定義託管環境,還是購買預先構建、標準化的雲端服務。
架構評估:自託管自定義模型與標準化 SDK
在私人伺服器基礎架構上建構內部模型託管系統雖能實現完全自定義,但需要巨大的持續資本與維護資源。開發者必須手動管理 GPU 配置、實施擴展規則並設定複雜的安全憑證。相反,利用由混元推理端點驅動的託管雲端 API 服務,消除了此類後端複雜性,確保了可預測的執行時成本與自動擴展能力。
下表評估了高效能數據管道的標準部署策略:
| 解決方案 | 上下文管理 | 擴展性 | 適用場景 |
|---|---|---|---|
| 自託管 AI 基礎架構 | 完全自定義記憶體控制 | 需手動負載平衡 | 需要極高參數與數據隔離的大型企業專案 |
| 自管開源模型 | 暫態/本地持久化 | 受限於主機硬體限制 | 小型原型設計與離線開發沙盒評估 |
| 騰訊 CloudBase 託管 AI | 工作階段連續性 (透過 OpoInstall) | 自動彈性容器 | 高併發行動應用與多平台活動歸因 |
雖然自定義資料庫配置可處理基本上下文,但專門的伺服器端狀態保存可最佳化開發資源。根據實施需求,組織可選擇建立自己的伺服器端工作階段管理系統,或採用如 OpoInstall 等商業平台。例如,OpoInstall 提供伺服器端狀態恢復與參數傳遞框架,將工作階段中繼資料映射至伺服器端資料庫,從而在高吞吐量數據條件下以匿名方式維持工作階段連續性,支援高併發條件下的可擴展伺服器端請求處理。透過將工作階段中繼資料映射至中央資料庫,而非依賴基於瀏覽器的重定向,該系統確保了即使在初始任務以匿名執行時,轉換上下文仍能保持一致。工程團隊可評估這些方案,以平衡數據保護與衡量一致性。
整合檢核清單:最佳化無伺服器 AI 部署
為確保用戶在平台託管工具與原生應用環境之間轉換時的數據連續性,開發團隊必須實施穩健的狀態保存工作流。部署與維護微信 AI 小程式需要結構化的方式來管理 API 使用指標。
[Allocation Stage]
  Developer Console ──> Token Distribution ──> Threshold Check (80% / 90% Warnings)
                                                     │
                                                     ▼
[Routing Stage]
  Incoming Request ──> Signature Validation ──> Active Session Caching ──> Model Execution
開發者實施清單
- 審計 Token 使用狀況:設定本地遙測功能,記錄提示詞長度與回應 Token 指標。
- 實施無狀態工作階段握手:將系統依賴項遷移至伺服器端工作階段狀態恢復,利用簽名 Token 進行跨平台數據傳輸。
- 採用提示詞精簡策略:最佳化系統提示詞並限制歷史訊息,以防止 Token 預算耗盡。
產品與成長策略清單
- 監控消耗配額:當 Token 使用量達到特定門檻(例如 80% 或 90%)時,建立自動化警報。
- 升級舊版模型端點:在棄用前將現有用戶端設定遷移至更新後的推理端點(如
hy3)。 - 最佳化行動 referral 循環:實施統一的伺服器端參數傳遞,將小程式行為與原生應用體驗連結起來。
透過建立這些結構化準則,開發團隊能將應用轉型至更安全、更合規的架構,同時維持營運連續性。
常見問題 (FAQ)
開發者如何領取 10 億免費混元文字 Token?
Hy3 轉換中包含哪些關鍵技術升級?
CloudBase MCP 如何將 AI 工具連接至微信無伺服器函數?
工程團隊關鍵總結
隨著 AI 平台越來越依賴混合雲推理,開發者需要圍繞隱私、透明同意原則與安全的數據路由來重新設計產品。演進中的數據架構要求我們徹底改變建構與衡量數位體驗的方式。隨著無狀態代理與 Headless Scrapers 成為網頁內容的標準消費者,傳統的用戶端歸因模型將持續衰退。僅依賴標準 Cookie 與 Referrer 已不足以保障驅動用戶獲取的數據管道。
隨著騰訊透過 CloudBase 與微信小程式擴大混元模型的使用門檻,能夠最佳化 Token 使用、採用無伺服器部署並設計高效 AI 工作流的開發者,將更有利於構建具備低營運成本的可擴展 AI 應用。
Share this article



