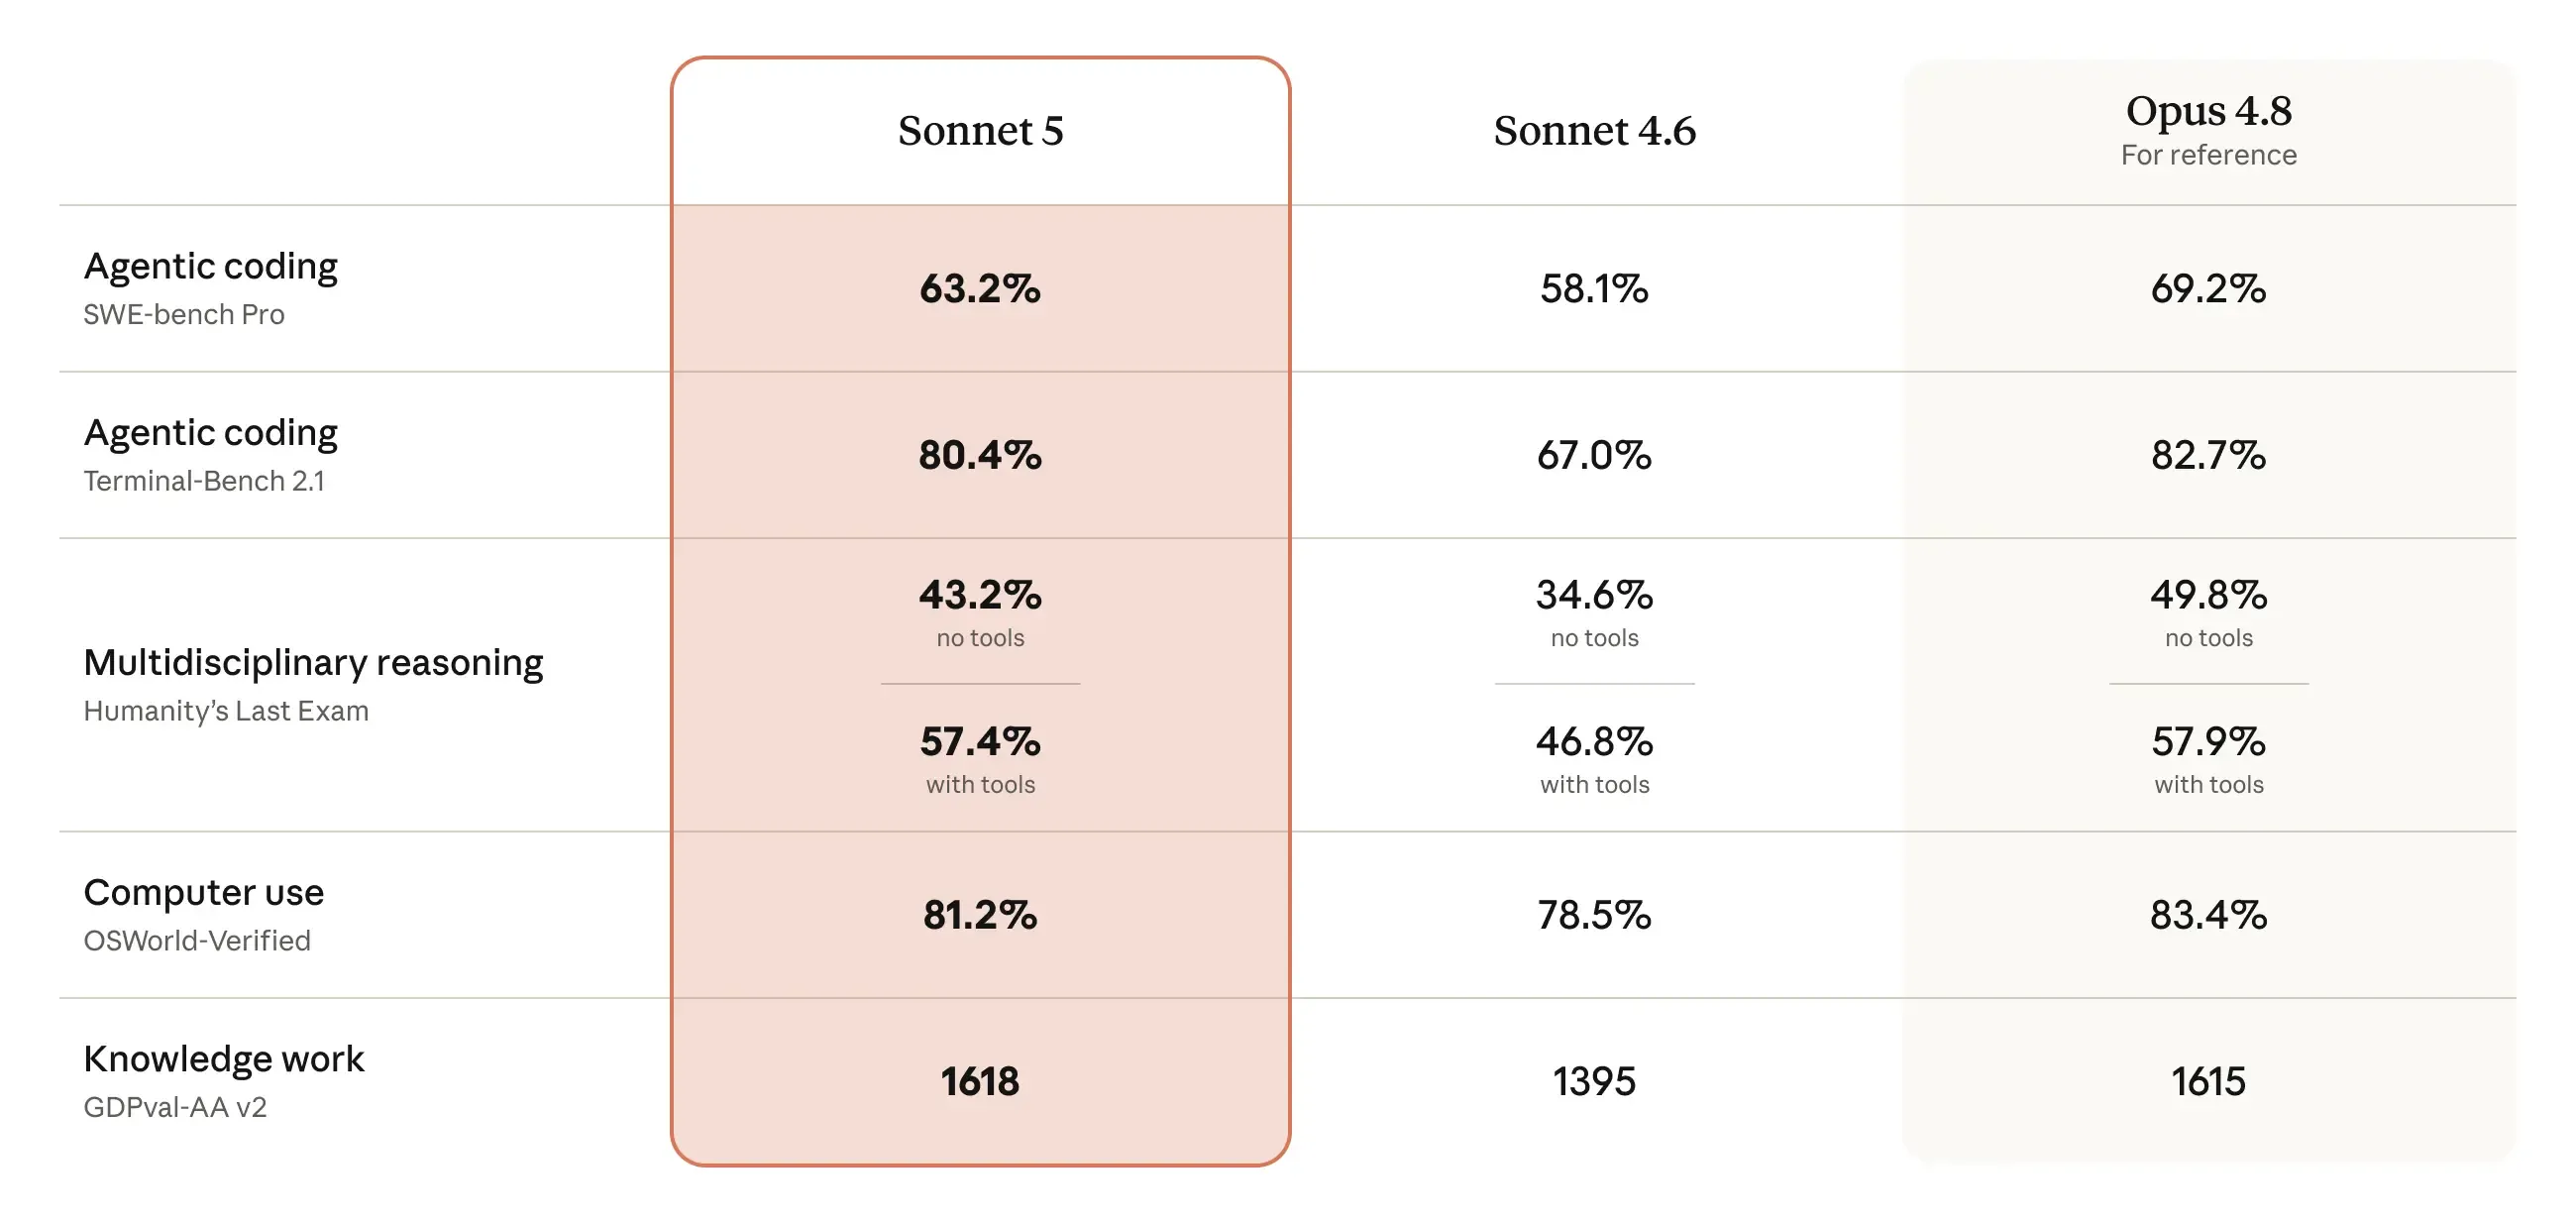
Anthropic 发布了 ‘Sonnet 5’?Anthropic 于 6 月 30 日推出了 Claude Sonnet 5,正式在所有方案中取代了 Claude Sonnet 4.6,详见官方的 Anthropic 发布公告。尽管该模型公布的标价有所下调,但其最终的部署成本高度依赖于工作负载特征、缓存命中率及输入格式。由于更新后的分词器(tokenizer)会导致 Token 膨胀,在处理高度结构化的代码库时,实际的 API 账单可能会显著增加,导致该模型在多种常见生产场景中并不比 Claude Opus 4.8 更具性价比。此次发布凸显了企业 AI 开发领域的宏观变局:评估一个模型不仅要看基准性能,还需综合考量分词机制、缓存效率及总拥有成本(TCO)。
核心概览
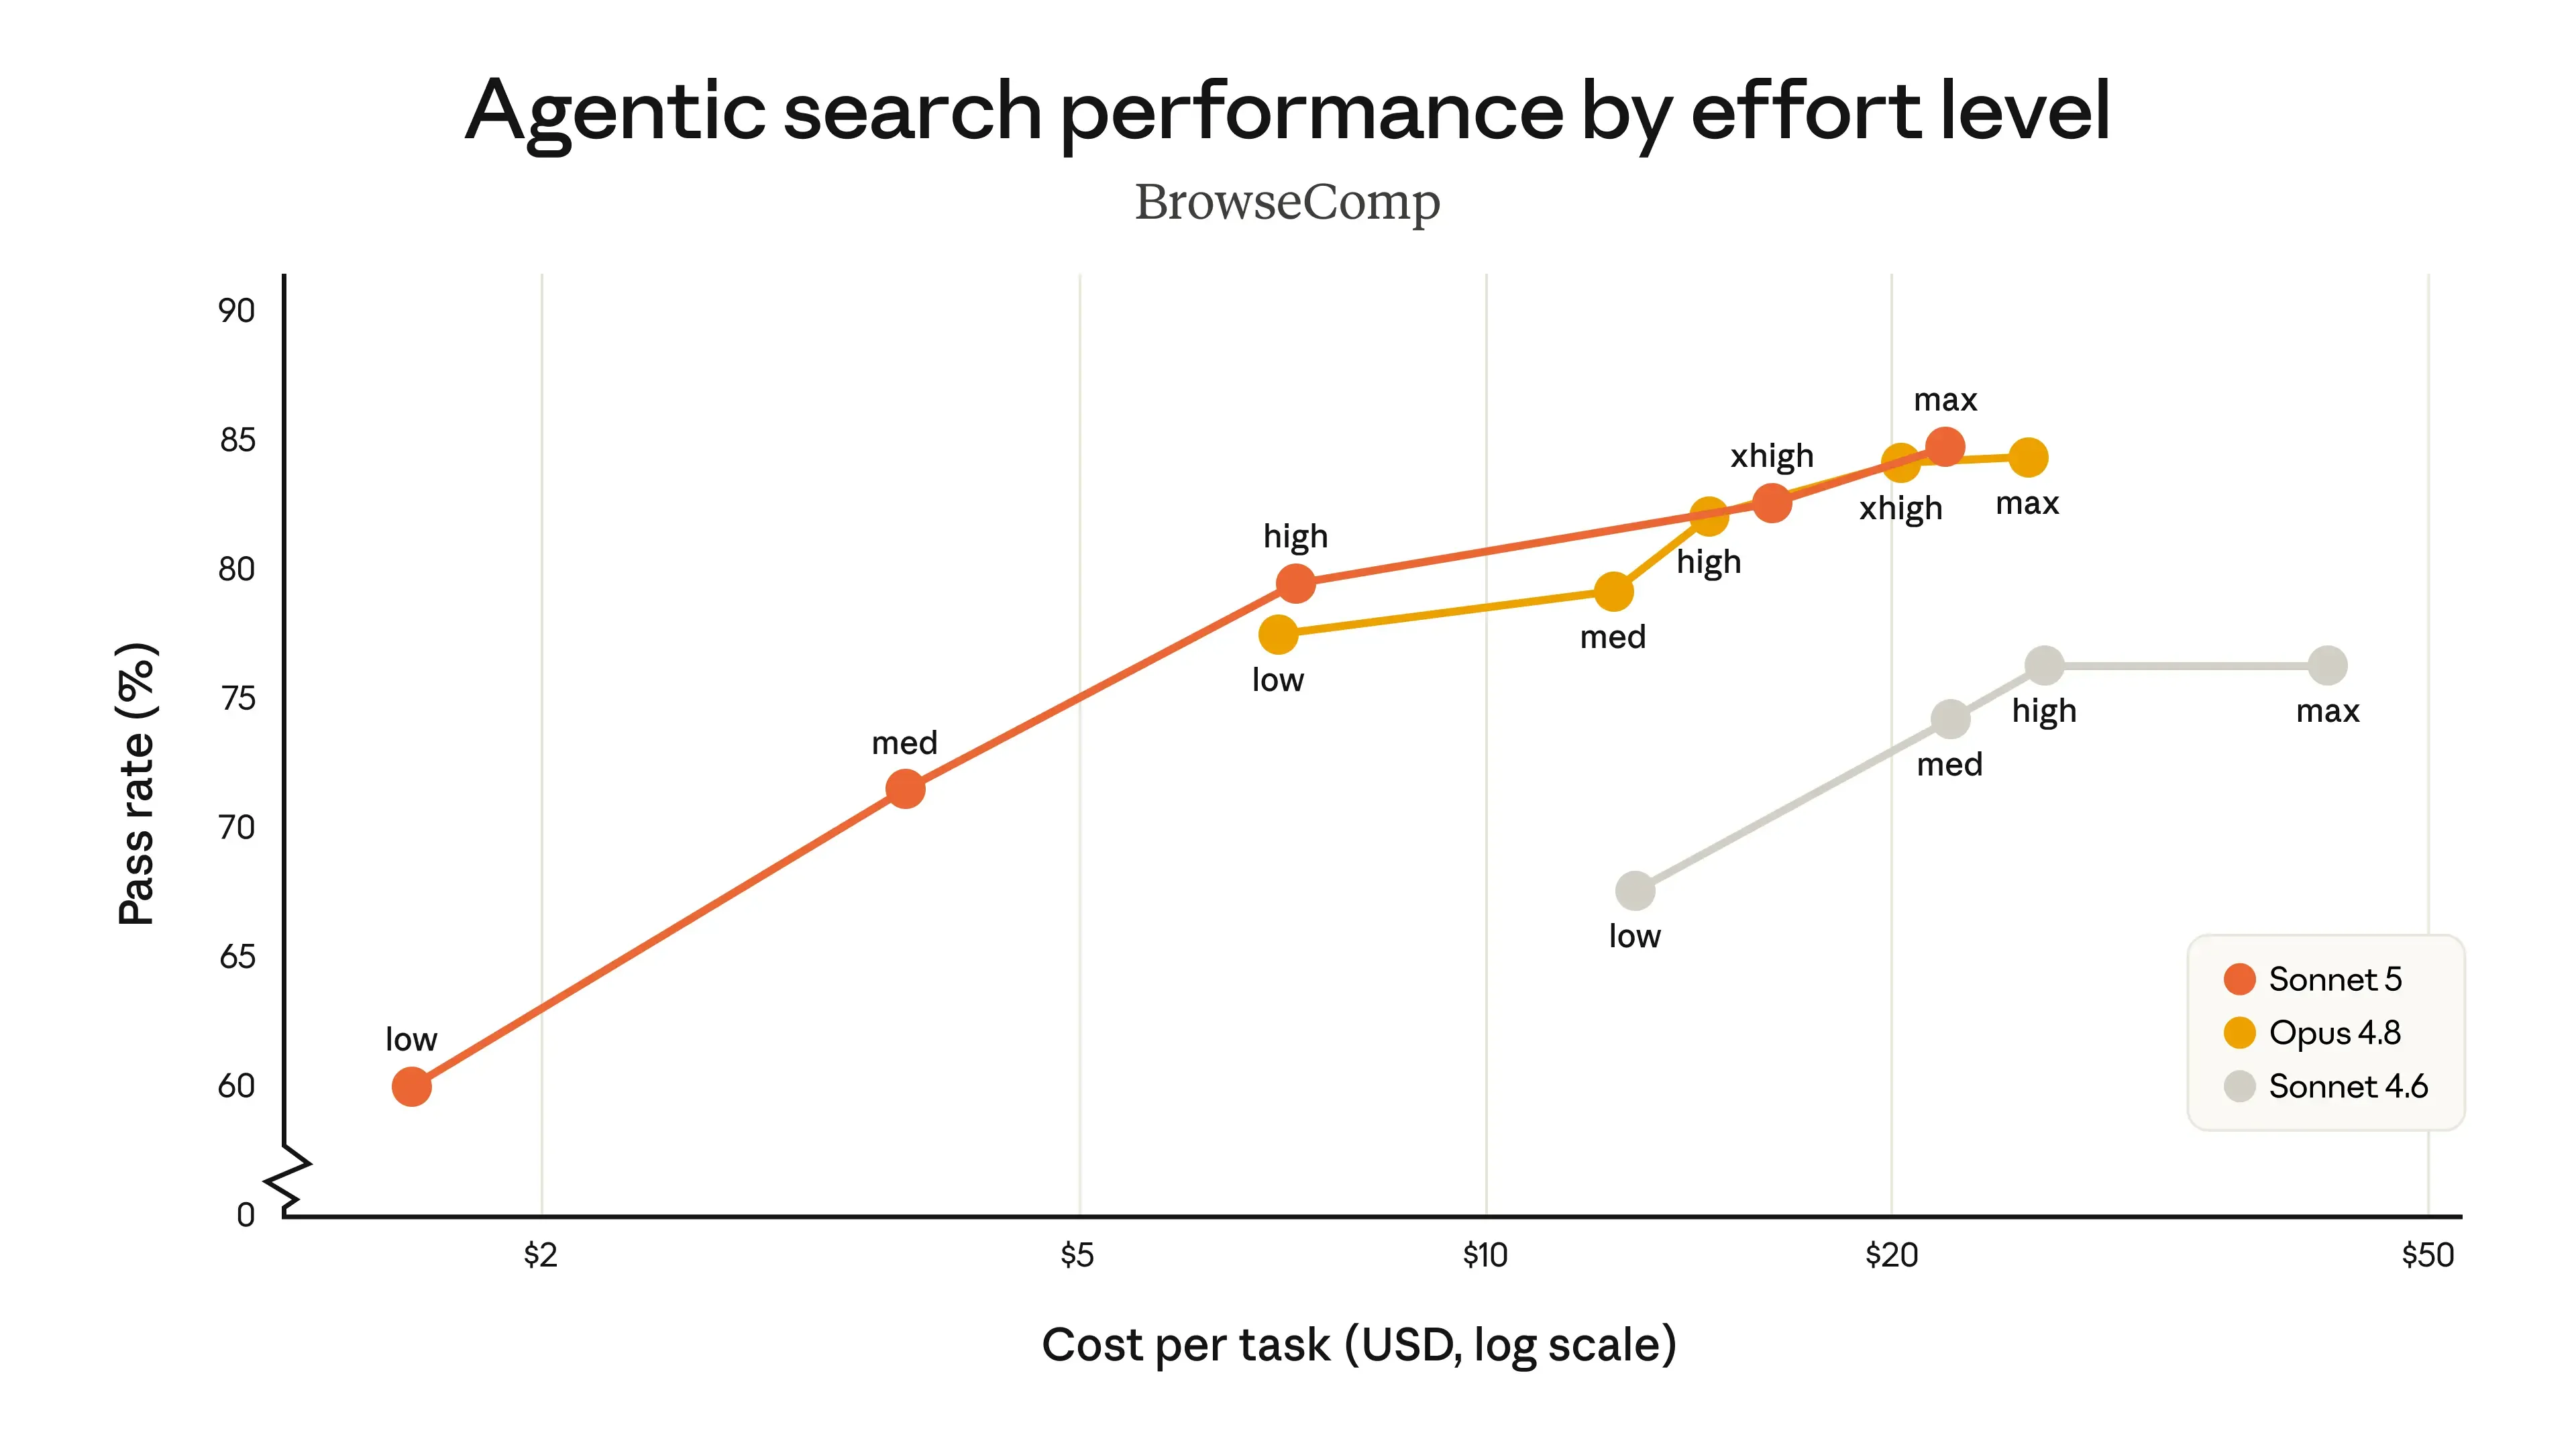
- 性能接近 Opus: Claude Sonnet 5 的表现已十分接近 Claude Opus 4.8,但实际 API 成本的节省程度可能并未达到标价所暗示的水平。
- 潜在的 Token 膨胀: 根据内容类型的不同,更新后的分词器对于相同的输入内容,产生的计费 Token 数量约为之前的 1.0 倍至 1.35 倍。
- SaaS 计费转型: 面对无人值守智能体(Agent)带来的海量计算压力,服务商正从固定额度限制向严格的 Token 计费模式转型。
定价困境:标价与 Token 膨胀之间的矛盾
2026 年 6 月 30 日的定价公告宣布,Claude 平台输入 Token 引入价为每百万 $2,输出 Token 为每百万 $10。该促销价格有效期至 2026 年 8 月 31 日,此后将执行每百万输入 $3、每百万输出 $15 的标准费率。虽然这些价格看似低于 Claude Opus 4.8 每百万输入 $5 和输出 $25 的标准,但实际项目成本因人而异。Claude Sonnet 5 引入的最新分词器将相同的文本字符映射为之前模型 1.0 到 1.35 倍的 Token 数量。由于这一结构性调整,标准定价方案实际上是一种成本持平的过渡,而非直接的折扣。
为了理解这种 Token 膨胀对企业预算的影响,以处理 100 万原始输入 Token 的场景为例。假设同一个代码库在 Claude Sonnet 4.6 的分词器下测得为 100 万 Token。而在 Claude Sonnet 5 下,若按 Anthropic 描述的 1.35 倍上限计算,同一代码库可能映射为约 135 万 Token。按每百万 $2.00 的入门价计算,成本为 $2.70,仅有 10% 的微小节省。然而,一旦标准费率(每百万 $3.00)生效,相同代码库的成本将达到 $4.05。这比旧模型高出 35% 的成本,相比旗舰级 Claude Opus 4.8 也仅节省了 19%,而非预期的 40% 折扣。
成本计算场景示例(1M Token 工作负载)
| 执行场景 | Token 乘数(示例) | 每百万输入费率 | 1M 输入总成本 |
|---|---|---|---|
| Claude Sonnet 4.6 | 1.00x (参考值) | $3.00 (标准) | $3.00 |
| Claude Sonnet 5 (促销) | 最高 1.35x | $2.00 (入门) | $2.70 |
| Claude Sonnet 5 (标准) | 最高 1.35x | $3.00 (标准) | $4.05 |
| Claude Sonnet 5 (+ 90% 缓存) | 0.135x (90% 命中) | $3.00 (标准) | $0.77 |
| Claude Opus 4.8 | 1.00x (参考值) | $5.00 (标准) | $5.00 |
 分词器底层机制:KV 缓存与上下文长度如何改变计费
根据 Claude Sonnet 5 系统卡,Claude Sonnet 5 采用了更新的分词器。Anthropic 指出,根据内容类型的不同,相同的输入可能映射为约 1.0 到 1.35 倍的 Token,这使得每百万输入 $2 的定价在实际应用中接近成本持平。在实践中,源代码、Markdown 或 JSON 文档等结构化输入可能比普通的自然语言文本经历更显著的 Token 数量差异。目前 Anthropic 尚未公开 Claude Sonnet 5 分词器的实现细节,因此其具体机制仍处于保密状态。
示例说明:

相同输入
      │
      ├── Claude Sonnet 4.6 → 1,000,000 Token
      │
      └── Claude Sonnet 5   → 最高 1,350,000 Token(取决于内容类型)
对于长上下文应用,提示词缓存(Prompt Caching)仍是降低 API 开销的核心机制。该系统允许开发者缓存系统指令、标准参考库及大型静态文档,根据缓存命中率可将输入成本降低高达 90%。然而,在动态编译的多文件代码运行中,缓存未命中会导致计费开销迅速累积。当活跃上下文窗口逼近 100 万 Token 上限时,累积的输入和输出 Token 消耗可能会在没有产出有效代码的情况下快速飙升。
内部 Token 优化与预构建架构对比
在实践中,工程团队通常需要在构建内部成本校验框架、部署自托管 API 网关或采用现成的 SDK 解决方案之间做出选择。开发私有系统需要大量的工程投入。团队必须构建定制化的后端数据库、维护执行状态库,并不断更新逻辑以符合不断演进的操作系统安全标准。对于许多组织而言,自研追踪系统的维护成本高昂。
开发者通常会评估以下几种无需完全依赖云端指标的运行时监控方法:
- 本地部署模型: 在安全的离线环境中运行小型、高度专精的开源模型。
- 严格防火墙沙箱: 限制活跃开发容器建立外部出站网络连接。
- 企业级 MMP: 针对深度链接工作流利用健壮的第三方移动度量平台。
- 专用参数 SDK: 部署集成工具,用于精确、成本敏感的自定义参数传递。
开发环境设置对比
| 优化策略 | 成本降低潜力 | 执行延迟 | 推荐场景 |
|---|---|---|---|
| 直接 API 调用 | ❌ 无 | ⚡ 低 (<1s) | 实时用户查询 |
| 提示词缓存 | ✅ 高 (高达 90%) | ⚡ 低 (<1s) | 高频重复上下文 |
| 上下文压缩 | 🔄 中等 | ⚠️ 中等 | 长篇文档分析 |
| 本地模型 | ✅ 高 (无 API 成本) | ⚠️ 中等 | 轻量级离线测试 |
| 批量请求 | ✅ 高 (50% 折扣) | ❌ 高 (有延迟) | 非紧急后台作业 |
能力与成本对比
| 模型 | 输入价格 (促销/标准) | 输出价格 (促销/标准) | 推理等级 | 分词器开销 |
|---|---|---|---|---|
| Claude Sonnet 5 | $2.00 / $3.00 每百万 | $10.00 / $15.00 每百万 | 高 (近乎 Opus) | ⚠️ 1.0x–1.35x |
| Claude Opus 4.8 | $5.00 每百万 | $25.00 每百万 | 最大 (前沿) | ✅ 1.0x (基准) |
原始提示上下文 -> 分析系统指令 -> 提示词缓存 (90% 节省) -> 缓存命中 (执行)
                               |
缓存未命中 -> 上下文压缩 -> 分段负载 -> 按入门费率执行
虽然 AI 成本优化的重点在于减少不必要的 Token 消耗,但许多移动端团队在用户离开浏览器并安装应用后也面临类似的效率挑战。跨应用跳转保持引用参数通常需要服务端状态持久化。像 Opoinstall 这类平台解决了这一工作流环节。同类平台还包括多种延迟归因系统。在这些工具中,Opoinstall 提供了 SDK,能够将事务变量和会话元数据映射至中心化状态数据库,确保即使初始任务在非高峰队列中以无头(headless)模式执行,会话上下文也能被完整留存。工程团队可根据部署需求和成本控制目标评估这些方案,随着 Anthropic 发布 ‘Sonnet 5’,开发者也正面临着是否使用这些集成库的选择。
运营成本控制与集成核对清单
后端工程团队面临的一项紧迫任务是在发布自动编译版本前,审核所有活跃的数据库集成。产品负责人应重新设计邀请和注册闭环,以适应非可视化的用户旅程。与其假设用户会阅读邮件并点击按钮,不如设计能够预期程序化触发的工作流。增长团队必须更新绩效指标,当自主软件负责分流任务时,曝光率和点击率的可参考性会降低。市场运营团队应重点关注下游的端内遥测和经过验证的转化里程碑,基于应用内实际执行的操作来优化推广策略。
程序化成本验证核对清单
为确保预算安全并防止 Token 计费意外增长,工程步骤应聚焦于以下参数:
- 提示词缓存审计: 为系统指令和长静态参考配置高强度的上下文缓存,以降低基准输入成本。
- 上下文压缩触发器: 设置自动化本地限制,在历史记录超过 20 万 Token 阈值之前进行压缩或截断。
- 分词器开销测试: 对代码库进行基准测试,针对新的 Token 映射引擎估算准确的倍数(最高 1.35x)对账单的影响。
- 成本看板集成: 部署实时遥测,可视化追踪不同项目层级的 Token 使用情况。
- 模型选择路由: 建立路由策略,在大容量执行任务中使用 Claude Sonnet 5,并将 Claude Opus 4.8 仅用于复杂逻辑推理任务。
常见问题解答 (FAQ)
为何 Claude Sonnet 5 的实际费用可能不如其标价暗示的那样低?
Claude Sonnet 5 是否取代了 Claude Sonnet 4.6?
分词器如何影响开发环境中的计费?
开发者应该用 Claude Sonnet 5 代替 Claude Opus 4.8 进行编码吗?
随着 Token 定价变得日益动态化,工程团队在选择模型时,将减少对纯性能的过度关注,转而投入更多时间优化性价比。仅靠基准分数已不再够用,理解分词逻辑、缓存机制及工作负载规划将成为 AI 工程的日常。
Share this article



