Anthropic Sonnet 5.5 速度提升 30%?Anthropic 正式发布了 Claude Sonnet 5.5,官方数据显示其输出生成速度提升超过 30%,单项任务成本降低最高 30%。随着生成式 AI 平台从实验原型向大规模生产系统转型,软件工程团队正面临控制 token 消耗和运行延迟的巨大压力。过去,企业架构师往往认为要获得顶尖的编程表现,必须部署规模最大、成本最高的旗舰模型。如今,由于优化的中型架构能够通过更少的操作步骤和工具调用来解决复杂的软件工程挑战,自动化开发者工具的经济逻辑正转向追求执行效率。
生产经济学:为什么任务完成成本比 token 单价更重要
概览
- Anthropic 于 2026 年 9 月 28 日发布 Claude Sonnet 5.5,输出生成速度提升超过 30%,单项任务成本降低最高 30%。
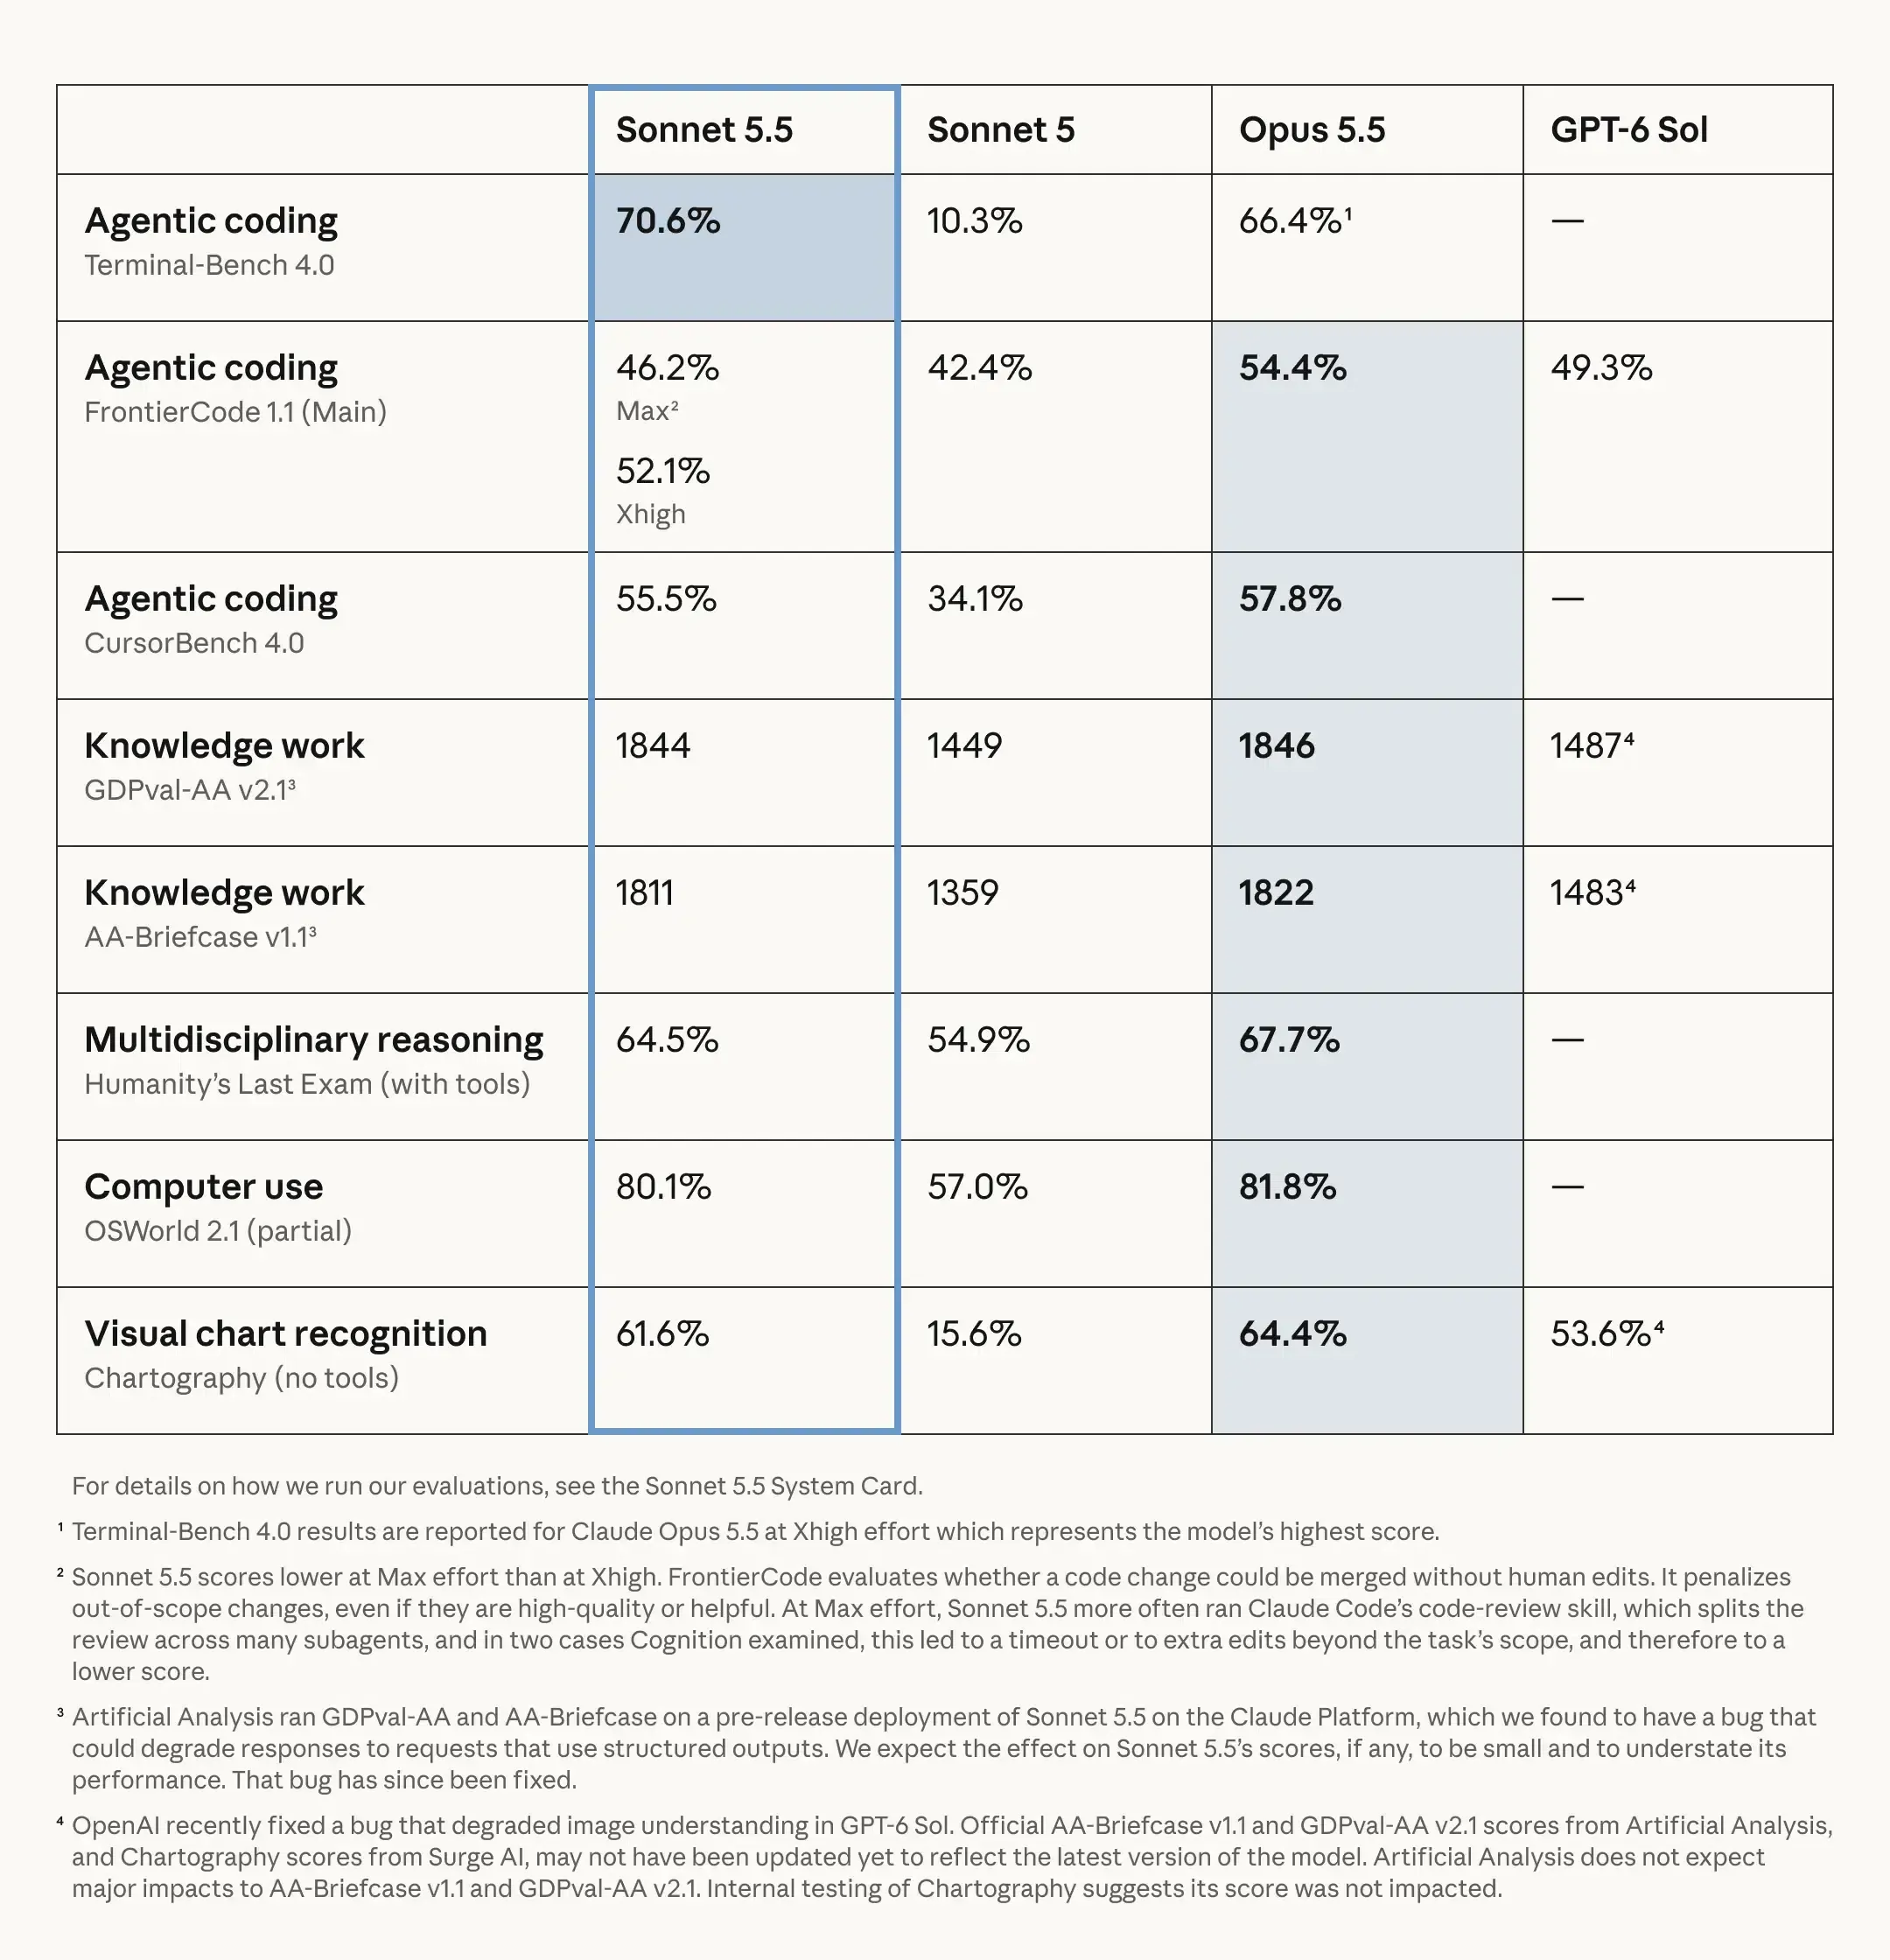
- 在 Terminal-Bench 4.0 代理编码评估中,Sonnet 5.5 取得 70.6% 的分数,超越了旗舰模型 Claude Opus 5.5(66.4%)和 Sonnet 5(10.3%)。
- API token 定价维持在每百万输入 token $2 及每百万输出 token $10,通过减少执行步骤和批量工具调用实现成本优化。
部署自主软件工程代理的商业可行性曾长期受限于严重的经济压力。运行需要检查代码库、执行 shell 命令并迭代修复单元测试的多步开发者工具会消耗海量的 token。虽然顶级前沿模型展现了卓越的推理深度,但其高昂的 token 成本和延迟使得持续的无人值守执行在软件企业扩展时显得代价高昂。
在评估开发者基础设施时,标价往往掩盖了完成任务的真实成本。一个 token 单价较低但需要多次反复调用工具和重试的模型,最终成本远高于一个能通过更少执行步骤解决问题的模型。这一动态在针对 Sonnet 5.5 的行业报道中得到了探讨,强调了任务完成成本如何与原始 token 定价脱钩。
Anthropic 通过 Claude Sonnet 5.5 直接解决了这些运营瓶颈。在保持每百万输入 token $2 及输出 token $10 的基础上,该模型通过减少推理步骤,实现了高达 30% 的净任务成本降低。Anthropic 发布的客户测试报告突显了其在生产工作负载中的效率提升:
- Box 报告称,Sonnet 5.5 运行速度快了 2.4 倍,在重查源文档和识别代码回归时,token 总使用量减少了 12%。
- Zendesk 观察到,支持工单处理速度提升 20%,且自动决策错误比现有生产模型更少。
- Slack 展示了该模型在无需提示词调整的情况下,在离线机器人评估中表现优于 Sonnet 5,且输出 token 消耗降低约 14%。
- Lovable 发现,在自动化应用构建过程中,Sonnet 5.5 所需的工具调用次数减少了约三分之一,shell 执行次数减半。
- Base44 验证了该模型平均在 3.6 次迭代内完成完整应用构建,相比之下 Opus 5 需要 7.7 次。
这些结果说明了执行效率如何从根本上改变开发者生产力。通过减少失败的工具调用并消除冗余迭代,中型模型为持续的企业自动化提供了坚实基础。
技术剖析:评估编码基准与子代理扩展
中型模型在特定技术基准测试中超越旗舰模型,反映了模型训练后阶段的转变。早期的扩展定律表明原始参数量是决定模型智能的主要因素。然而,复杂的代理任务(如导航终端环境和编辑大型代码库)高度依赖于上下文管理、严谨的工具使用规范及范围控制。
如 Opus 5.5 等旗舰模型具备强大的推理能力,擅长处理模糊的架构决策。然而,过度深入的推理有时会为界限清晰的任务带来不必要的运行开销。例如,在 FrontierCode 基准测试中,Anthropic 注意到 Sonnet 5.5 在“最大努力”模式下的得分低于“超高”模式,因为它更频繁地调用了 Claude Code 的代码审查技能。这种技能将审查拆分给多个子代理,导致了基准测试判定中的超时或超范围编辑。相比之下,处于标准执行模式下的 Sonnet 5.5 非常适合受限、目标明确的执行:它能快速解析代码库结构、评估建议变更并严格在文件边界内运作。
基准等效性:Terminal-Bench、CursorBench 与 GDPval-AA
Anthropic 发布的评估显示,Sonnet 5.5 在日常技术领域中匹配甚至超越了顶级基准。在评估多步命令行问题解决能力的 Terminal-Bench 4.0 中,Sonnet 5.5 获得 70.6% 的分数,超过了 Opus 5.5 的 66.4% 和 Sonnet 5 的 10.3%。在源自实际 Cursor 开发者会话的 CursorBench 4.0 中,Sonnet 5.5 达到 55.5%,仅落后 Opus 5.5(57.8%)两个百分点。此外,在针对 44 个职业的实际专业任务 GDPval-AA v2.1 中,Sonnet 5.5 的 Elo 等级分达到 1844,紧跟 Opus 5.5 的 1846。
为考察精简模型如何优化自主执行,请对比工作流差异:
[单体旗舰代理循环]
  用户提示词 ──> 重型推理链 ──> 海量工具调用(高 token 消耗) ──> 过度编辑与超时风险

[精简中型代理循环]
  用户提示词 ──> 范围意图映射 ──> 批量工具调用 ──> 更少执行步骤 ──> 交付精确补丁
这种精简的执行循环能减少上下文漂移和不必要的往返次数。Anthropic 报告称,相比 Sonnet 5,该模型输出速度提升 30% 以上,同时执行步数减少。模型将工具调用批量处理,最大限度地减少了代理运行环境与主机环境之间的网络往返延迟。
Sonnet 5.5 还将顶级安全基础设施引入了中型模型类别。它是首个部署与 Opus 5.5 同级别网络安全防护的 Sonnet 变体。高风险漏洞发现任务会自动回退至早期架构,而经审批的防御者通过网络验证计划(Cyber Verification Program)获得分级权限。此外,系统整合了安全分类器,旨在减少大规模工业推理提取,并保持思考过程绑定于原始账户。
架构策略:跨前沿与中型模型分配工作负载
随着 AI 基础模型分化为超深度推理引擎和敏捷执行模型,工程领导者必须重新评估如何跨软件开发生命周期分配模型层级。在整个工程管道中部署单一旗舰模型会引入不必要的延迟和成本。相反,现代开发者基础设施越来越多地依赖动态模型路由,根据结构复杂度分配任务。
在设计生产工作流时,团队必须权衡深度概念推理与高吞吐量任务解析之间的权衡。虽然旗舰模型在宏观架构规划中依然不可或缺,但中型模型凭借卓越的响应能力处理了绝大多数日常代码执行任务。
下表概述了跨模型层级的技术对齐:
| 工作负载类别 | 首选模型 | 成本配置 | 延迟表现 | 最佳应用场景 |
|---|---|---|---|---|
| 日常 Bug 修复与 PR 审查 | Claude Sonnet 5.5 | 低($2 / $10 每百万 token) | 快(输出速度提升 30%+) | 范围明确的日常软件任务与高频 CI/CD 检查 |
| 全代码库架构与迁移 | Claude Opus 5.5 | 高($4 / $20 每百万 token) | 自适应、深度思维周期 | 复杂、模糊且涉及大型代码库的重构 |
| 交互式原型与 UI 设计 | Claude Sonnet 5.5 | 低($2 / $10 每百万 token) | 快速、响应式迭代 | 设计用户流程、生成图表及前端脚手架 |
| 高级网络安全研究 | 受验证访问的 Claude 模型 | 取决于模型与权限层级 | 全面的多步验证 | 在 Anthropic 验证计划下授权的高风险安全研究 |
Anthropic 通过分级防护手段构建了网络安全能力。当常规漏洞修复在 Sonnet 5.5 上正常进行时,高风险安全任务会自动回退至早期架构。对于进行高级安全研究的授权防御者,访问 Sonnet 5.5、Opus 5.5 及 Mythos 模型扩展能力的权限通过多层级网络验证计划进行管理。
通过建立动态路由规则,工程组织可以将日常拉取请求审查、单元测试生成和 Bug 定位引导至 Sonnet 5.5。这节省了顶级 Opus 算力用于高复杂度架构重构,从而在不牺牲软件可靠性的前提下保持工程预算的可预测性。
集成清单:在企业 CI/CD 中实施 Sonnet 5.5
当软件组织将高速、经济高效的模型(如 Sonnet 5.5)纳入生产管道时,工程团队必须建立稳健的治理时间表。最大化成本节约需要将 API 参数设置与任务复杂度对齐,同时防止未经监控的代理漂移。
开发者实施清单
- 配置动态努力级别:利用模型原生的努力设置——在 Claude 应用和 Claude Code 中默认为中等,在 Claude 平台中默认为高——以平衡推理深度与 token 支出。
- 利用提示词缓存(Prompt Caching):在静态系统提示词和代码库映射上实施提示词缓存,确保缓存读取 token 享有 90% 的折扣(每百万 token $0.20)。
- 部署异步批量处理:通过批量 API 处理非实时评估、自动代码审计和批量迁移,实现标准 token 成本 50% 的优惠。
- 集成故障安全回退:建立程序化断路器,如果自动工具循环超过预设的迭代预算,则优雅地终止或重定向请求。
治理与基础设施清单
- 重新评估订阅单位经济效益:计算每位活跃开发者的边际算力成本,确定高速中型模型是否允许提供更高的使用配额或更低的层级定价。
- 监控迭代比例:测量解决用户任务所需的平均工具执行次数;迭代次数的减少将直接提升开发者满意度。
- 在必要时配置仅限美国境内处理:对于有国内数据驻留要求的受监管企业客户,配置仅限美国的推理端点(在符合条件的企业条款下按 1.1 倍定价)。
- 验证零数据留存资格:向 API 提供商确认零数据留存状态,确保企业合规,同时注意诸如持久化提示词缓存等特殊功能可能适用不同的数据留存条款。
通过采用这些结构化的操作实践,软件组织能将算法速度和 token 效率转化为可预测的开发收益。
常见问题 (FAQ)
既然 Sonnet 5.5 的 token 单价与 Sonnet 5 相同,为什么任务完成成本反而更低?
Claude Sonnet 5.5 能否在软件工程中替代 Opus 5.5?
提示词缓存(Prompt Caching)如何影响编码代理的运营成本?
工程团队核心要点
Claude Sonnet 5.5 的发布反映了行业从无限制参数扩展向运营任务效率的进化。高吞吐量的软件工程平台并不一定需要在每个操作阶段都使用旗舰模型的算力。当一个中型模型能以较少的迭代次数可靠地解决已明确范围的代码库任务时,自动化软件开发的规模化部署将变得显著更具成本效益。
利用这些效率提升需要建立规范的架构:根据复杂度动态分配任务、强制执行工具使用边界,并系统地应用提示词缓存。随着基础模型提供商在优化原始推理的同时持续提升 token 效率,那些设计了模块化、可成本监控管道的工程团队将保持最可持续且可扩展的生产工作流。
参考资料
-
Anthropic. Introducing Claude Sonnet 5.5.
-
Anthropic. Claude Sonnet 5.5 System Card.
-
Anthropic. Claude API Pricing and Data Residency.
-
Anthropic. Commercial Terms of Service and Data Retention Policy.
-
VentureBeat. Anthropic Launches Claude Sonnet 5.5 with 30% Cost Reduction Per-Task.
-
TechCrunch. Anthropic Releases Sonnet 5.5 as a Significantly Cheaper, Faster Work Partner.
-
9to5Mac. Anthropic Upgrades Claude with New Sonnet 5.5 Model.
Share this article



