Google 发布 Gemini 4 Hydrogen?Google DeepMind 于 2026 年 11 月 12 日正式推出了 Gemini 4 Hydrogen,将其定位为一款兼具成本效益与高吞吐量的系统,适用于日常软件工程和多步骤智能体工作流,正如官方的 Google DeepMind 公告中所详细介绍的那样。随着软件团队越来越多地部署自主智能体来导航代码仓库和运行测试,完全依赖大型前沿推理模型会带来明显的延迟和累积的 API 费用。尽管深厚的架构推理对于复杂系统设计仍然必不可少,但诸如编写局部代码修改、运行测试套件以及解析构建日志等日常工程任务则需要快速执行。Hydrogen 既旨在用作高容量开发的独立工具,又可以作为与多模型路由管道中的前沿模型相配合的执行引擎。
核心行业重新对齐:Google 推出面向高吞吐量工作流的 Gemini 4 Hydrogen
概览
- Google DeepMind 推出了 Gemini 4 Hydrogen,这是一款高吞吐量模型,旨在以比前沿层更低的延迟处理日常编码、代码库问答和智能体工作流。
- 该模型在跨输入和输出共享的统一 1,048,576 token 上下文窗口内运行,定价为每百万输入 token 1.50 美元,每百万输出 token 7.50 美元。
- 可用性涵盖 Google AI Studio、Gemini API、Android Studio、Google 搜索和企业平台,访问层级根据免费消费者计划和付费开发者工作空间而有所不同。
软件工程工作流的运营需求已经超越了单提示词代码补全。现代智能体设置通常会触发数十个自主步骤,包括读取目录结构、检查依赖树、提出补丁以及执行回归测试。当开发者将每一个常规操作都通过前沿推理模型进行路由时,任务执行速度就会显著减慢。在迭代环境中,即使单个工具调用的延迟适中,也会在整个自动化开发周期中累积成漫长的延迟。
围绕此次发布的行业讨论反映出人们对模型专业化对于生产可扩展性至关重要的认识日益增强。团队没有将单个通用模型作为每个开发任务的默认选择,而是在评估分层架构。在这些配置中,高容量推理模型负责管理系统设计和模糊的问题界定,而专用的执行引擎则处理重复的代码库操作。Google 设计 Hydrogen 正是为了解决这一运营层面的需求,通过标准的 API 端点和编程环境提供即时的开发者可用性。
Gemini 4 Hydrogen 的基准测试分析与技术边界
Google 将 Hydrogen 描述为改编自 Gemini 4 Carbon。然而,已发布的的技术文档并未披露有关权重转移机制、分词器架构或蒸馏管道的具体内部细节。因此,技术评估必须侧重于可观测的基准数据、记录的上下文边界以及报告的运营限制,而不是推断的内部机制。
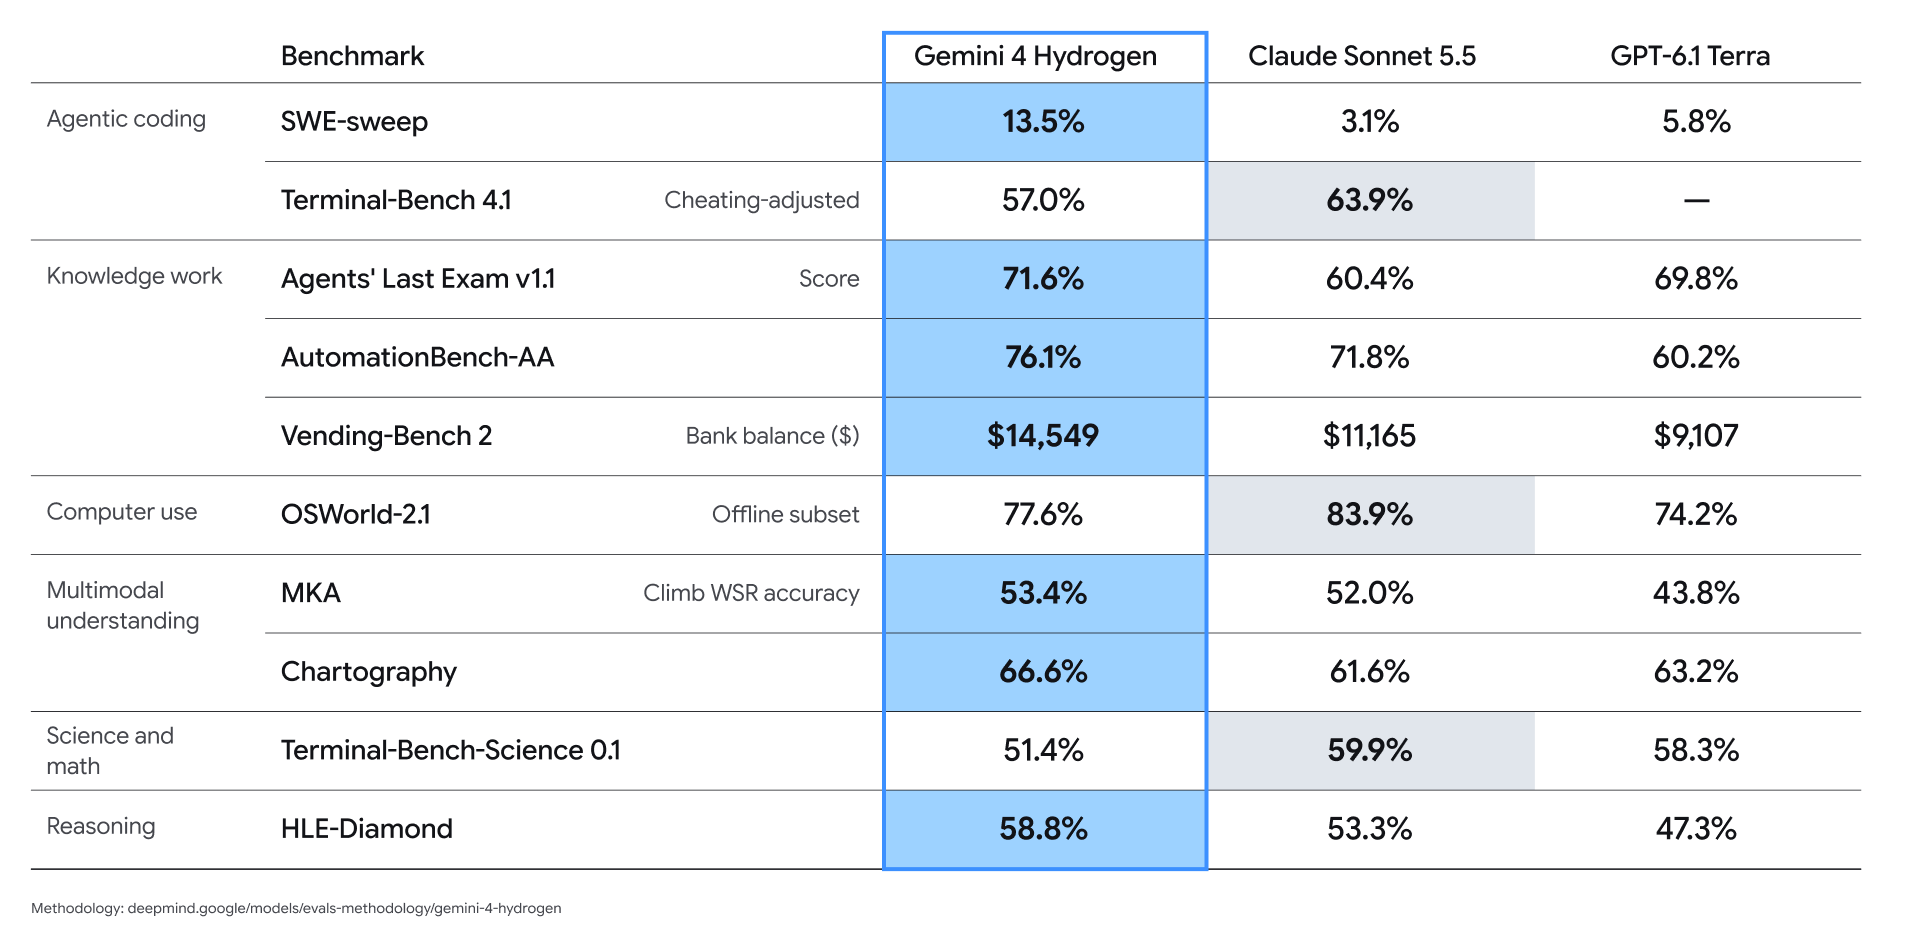
在 Gemini 4 Hydrogen 模型卡中报告的标准评估中,Hydrogen 在各个任务类别中表现出了明显的性能差异。在用于问题解决的 SWE-sweep 基准测试中,Google 报告 Hydrogen 的解决率为 13.5%,相比之下,在指定的评估条件下,Claude Sonnet 5.5 为 3.1%,GPT-6.1 Terra 为 5.8%。相反,在防作弊调整参数下的 Terminal-Bench 4.1 上,Hydrogen 达到了 57.0%,这比 Gemini 3.8 Flash(18.2%)有了大幅提升,但落后于记录了 63.9% 的 Claude Sonnet 5.5。在独立的 Artificial Analysis 智能指数上,Hydrogen 在默认的高思考设置下得分为 51,在超高(xhigh)设置下得分为 54,相比之下,旗舰级的 Gemini 4 Argon 得分为 50。
正如 Google 云模型文档中所记录的,一个关键的架构考量因素是模型的上下文容量。Hydrogen 提供了在所有输入和输出之间共享的 1,048,576 token 的统一上下文上限。这意味着大量的输入文件会减少可用于模型输出的剩余 token 容量。单个前台片段支持最多 65,536 个输出 token。较长的生成过程使用支持的延续机制,包括 SDK 管理的延续、自定义延续 token 循环,或在可用时的服务器管理后台执行。所有片段仍受共享上下文限制的约束。输出 token 包含内部推理 token、生成的工具请求以及可见文本。
[Multi-Model Orchestrator Architecture in Google Antigravity]
                         ┌────────────────────────┐
                         │  Gemini 4 Carbon/Argon │ (Architectural Planning & Complex Reasoning)
                         └───────────┬────────────┘
                                     │ Task Delegation & Plan Review
                                     ▼
                         ┌────────────────────────┐
                         │   Gemini 4 Hydrogen    │ (Parallel Code Generation & Tool Calling)
                         └───────────┬────────────┘
                                     │ Structured Tool Invocations
                                     ▼
                [ Local Runtime / Test Suites / File System ]
为了平衡延迟和分析深度,Hydrogen 包含了四个可配置的推理级别:低、中、高(默认)和超高(xhigh)。较低的设置减少了简单句法调整的响应延迟,而较高的级别则分配更多的内部推理 token 来评估边界情况。开发者应注意,文档记录的限制依然存在:该模型的知识截止日期为 2026 年 3 月,在繁重的后台处理期间可能会遇到偶尔的超时,并且在模糊的提示词上可能会产生幻觉或过度拒绝。
解耦系统与多模型编排权衡
多模型编排允许开发平台将工程工作流拆分到不同的模型层中。在这种模式下,复杂的系统建模和安全评估委托给前沿推理模型,而具体的代码编辑和测试断言则分配给快速执行模型。
Google 使用 Google Antigravity 中的实验性编排器评估了这种方法。在 Terminal-Bench 4.0 的测试中,Google 报告称,Carbon 和 Hydrogen 之间的动态切换实现了接近 Carbon 的任务成功率,同时比单独运行 Carbon 消耗的配额减少了 24%,任务完成速度快了 19%。Google 还报告了早期合作伙伴测试显示,在选定的工作流中,执行速度比 Gemini 3.8 Flash 快 2 倍至 2.8 倍,token 使用量减少 12% 至 23%。例如,Box 报告称在复杂的文档和表格任务上,执行速度大约快 2 倍,token 减少了 12%。这些供应商报告的示例反映了特定的集成设置,并不代表对所有生产部署中节省成本的受控估算。
| 系统组件 | 代表性工具 | 定义的职责 | 运营范围与限制 |
|---|---|---|---|
| 系统协调器 | Gemini 4 Carbon / Argon | 高层架构设计、跨代码库规划、复杂逻辑评估 | 高推理能力;产生更高的每 token 成本和更长的生成延迟 |
| 执行引擎 | Gemini 4 Hydrogen | 局部代码生成、自动化文件编辑、快速工具调用循环 | 高生成吞吐量;可独立运行或在协调器下运行 |
| 验证网关 | 单元测试套件 / 静态检查器 | 确定性规则检查、语法验证、回归测试 | 检查定义的断言和静态规则;保证取决于测试质量、覆盖率和独立审查 |
评估多模型架构要求工程团队在系统复杂性与执行效率之间取得平衡。虽然动态模型路由可以降低重复任务的 token 支出,但它引入了编排开销、子智能体之间的状态同步挑战以及对路由分类器的依赖。工程团队必须根据自身的任务分布、代码库结构和 API 延迟要求来衡量这些权衡取舍。
工程实现与工作流治理检查清单
将 Gemini 4 Hydrogen 集成到自动化开发者工具链中需要清晰的执行边界、token 监控和防御性智能体治理。
开发者实现检查清单
- 将思考级别与运营任务对齐:根据工作负载复杂度配置推理工作量参数。为复杂的算法边界情况保留
xhigh,将high维持为代码库导航的标准基线,并将medium或low用于诸如代码重新格式化或简单文档查找等对延迟敏感的任务。 - 构建并行工具接口:设计工具定义以在运行时支持的情况下接受批处理参数,使工作智能体能够在合并的请求中请求多个文件检查或语法检查,而不是连续的往返。
- 将模型生成与执行解耦:确保模型将工具调用和代码修改作为结构化数据提出,而隔离的客户端运行时或容器化测试运行程序则执行命令并尽可能返回执行结果和可重现的证据。
企业治理检查清单
- 建立会话日志记录:记录工具请求、执行结果、权限决策、代码变更、测试结果和可用的模型摘要。不要将推理摘要视为完整或忠实的执行轨迹。
- 应用分层安全控制:将外部文档、问题跟踪器和合并请求评论视为不受信任的输入。虽然 Hydrogen 在 Gray Swan 间接提示词注入基准测试中表现出 2.3 倍的韧性提升,但自动输入净化和执行权限网关依然必不可少。
- 监控累积的 Token 消耗:使用所选 API 的使用字段跟踪输入 token 和可计费的输出 token(包括思考 token)。当思考 token 已经包含在计费输出总数中时,请勿再次添加思考 token。
常见问题 (FAQ)
Gemini 4 Hydrogen 在生产工作负载中与 Carbon 和 Argon 相比如何?
四个思考级别是什么,开发者何时应该使用 xhigh?
统一的定价模型如何在一百万 token 的上下文窗口中运作?
工程团队的核心要点
在生产环境中部署自动化编码工具需要开发团队超越前沿基准分数,关注迭代工具执行的经济学。通过高延迟推理模型路由每个常规代码修改会引入不必要的运营延迟和预算膨胀。同时,管理执行延迟和任务成功率需要对基准分数和错误恢复行为有切合实际的期望。
通过建立结合了高容量推理模型与快速、可预测的执行引擎的分层架构,工程组织可以可持续地扩展自动化开发工作流。实施纪律严明的多模型路由、结构化测试边界和严格输入验证的团队,将处于构建强大、可维护的 AI 辅助软件管道的有利位置。
参考资料
-
Google DeepMind. Introducing Gemini 4 Hydrogen. 官方公告。
-
Google DeepMind. Gemini 4 Hydrogen Model Card. 技术规范与安全报告。
-
Google Cloud. Gemini 4 Hydrogen Model Documentation. 技术参考。
-
Google Antigravity. Gemini 4 Hydrogen in Google Antigravity. 多模型编排概览。
-
Artificial Analysis. Gemini 4 Hydrogen Intelligence and Latency Benchmark. 独立 AI 评估。
-
Ars Technica. Google Rolls Out Gemini 4 Hydrogen, Finally Replacing 3.8 Flash. 技术分析。
Share this article