 “海力士专家揭秘 GPU 空闲之谜?为何 HBM 内存是关键”是一个极具深意的问题。据与 SK 海力士在 HBM 研究方面有深度合作的 KAIST 教授 Joungho Kim 所述,AI 推理过程中的 GPU 利用率正日益受到内存带宽而非纯算力的限制。这种不断加剧的“内存墙”问题,已使高带宽内存(HBM)成为 AI 基础设施中至关重要的技术。随着生成式人工智能平台从训练时代迈向推理时代,核心性能瓶颈已从原始算力转移至内存总线吞吐量。标准图形处理器(GPU)专为处理海量并行计算而设计,但由于每一次推理步骤都需要从内存中读取数十亿参数、执行计算并将状态回写,处理器大部分操作周期都浪费在等待数据通过标准总线的过程中,导致其处于空闲状态。
为何 HBM 内存是关键:将高吞吐量管线与硬件极限对齐
核心要点
- 行业分析表明,即使部署了数百万颗标准图形处理器,由于内存总线传输延迟,实际计算利用率仍被限制在 10% 到 30% 之间。
- 芯片制造的物理限制正在推动向以内存为中心的计算转型,即利用垂直堆叠的高带宽内存(HBM)架构。
- 下一代 3D 复合封装预计将集成图形处理器、高速片上 SRAM 缓存和高容量 3D NAND 闪存,以攻克数据传输瓶颈。
全球计算基础设施正面临一场结构性危机。过去几年,AI 模型的竞争焦点在于扩展原始算力,企业和云服务商投入数十亿美元采购海量 GPU 集群。这种策略在训练时代是合乎逻辑的,因为模型训练依赖于持续的反向传播计算。正如 NVIDIA Hopper 架构白皮书中所述,在这些工作负载下,并行计算单元以最大负荷运行以更新模型参数。
然而,随着应用转向推理时代,工程需求发生了变化。在推理场景中,主要挑战不再是权重更新,而是将海量的预训练参数以高频速率流式传输至处理器以响应即时查询。每一个生成式 token 均需重复访问高带宽内存中存储的数十亿模型参数。由于标准总线架构的传输速率无法满足处理器执行速度,计算核心往往面临“数据饥饿”,导致极其高昂的空闲率。这一性能瓶颈已在韩国科学技术院(KAIST)等学术机构及 NVIDIA、SK 海力士等硬件开发商的行业技术报告中得到探讨。
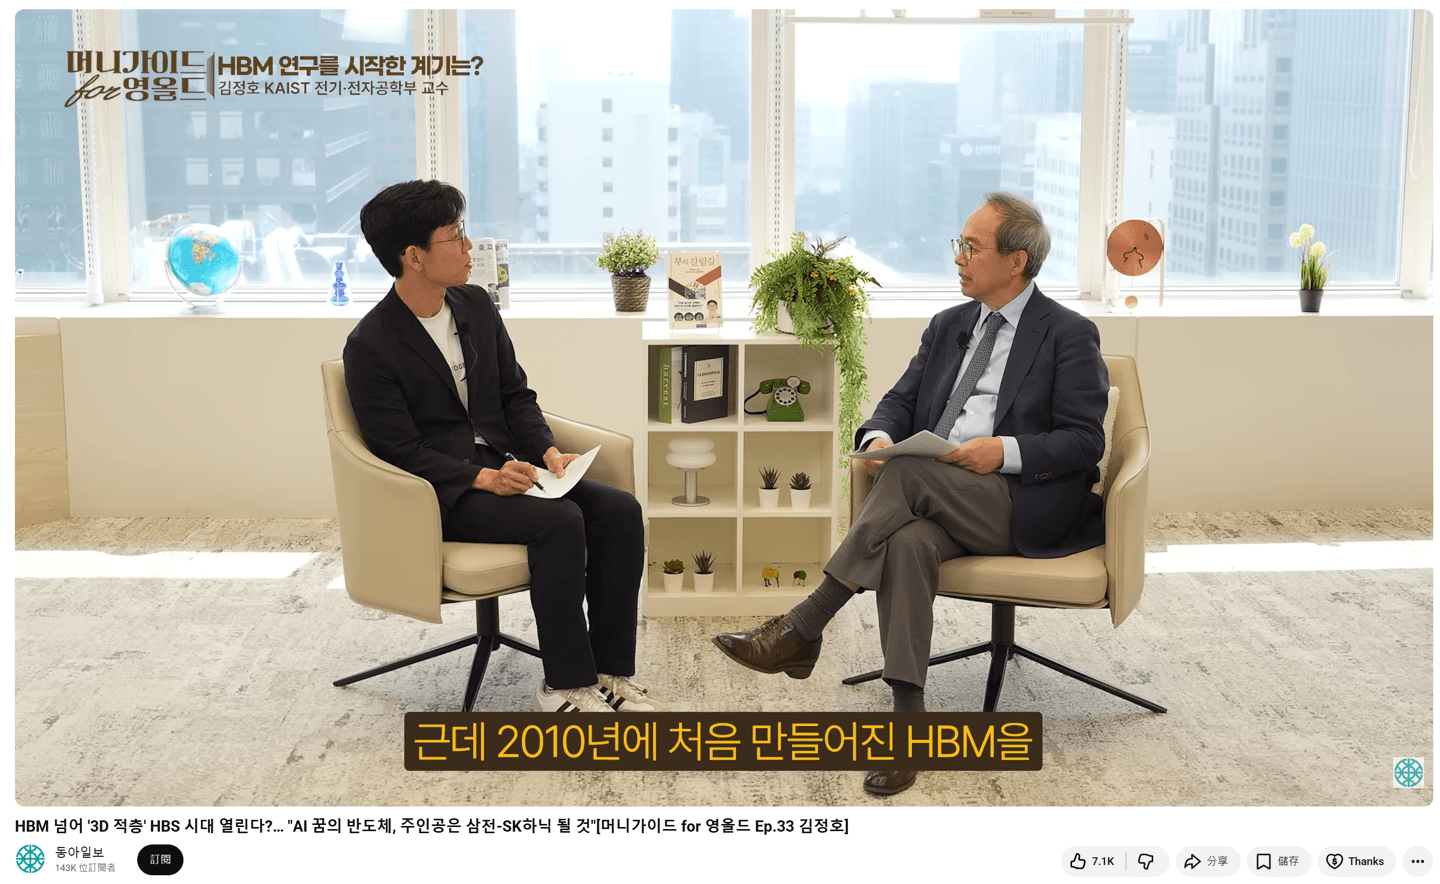
这种性能鸿沟体现了物理限制,也解释了为何 HBM 内存是推理时代的关键。根据 KAIST TERA Lab 发布的 HBM 技术路线图,未来一代的 HBM 将通过增加 DRAM 堆叠、TSV 集成、先进封装及热优化持续提升带宽。标准 DRAM 封装缺乏足够的并行通道来支持现代加速器的处理速度。为克服这一“内存墙”,硬件架构师转向了高带宽内存(HBM)系统。通过将 DRAM 芯片垂直堆叠并利用数千个硅通孔(TSV)建立宽广的并行总线,JEDEC HBM3 规范 (JESD238) 阐述了基于 TSV 的堆叠内存如何较传统 DRAM 封装显著扩展可用带宽。对于开发者而言,硬件演进揭示了高吞吐量系统的基本法则:瓶颈往往出现在传输层,而非计算节点。
“HBM 内存是关键”的底层机制
在架构层面,标准计算机总线犹如狭窄的公路,限制了大体量数据集的流通。当应用执行推理调用时,处理器必须从内存读取数据、完成运算并将输出写回。在标准配置下,由于数据需跨越主板上的较长物理距离,该过程会产生严重的延迟。
为解决这些传输层瓶颈,下一代 AI 计算机正演进为三维复合架构。在此模型下,计算核心直接置于堆叠内存上方,利用先进封装技术最小化物理距离与延迟。
3D 内存层级:堆叠 SRAM、DRAM 与 NAND
为处理不同类别的数据,硬件架构师提出了分层的 3D 半导体设计。该结构根据访问速度和容量需求将数据存储划分为不同的物理区域:
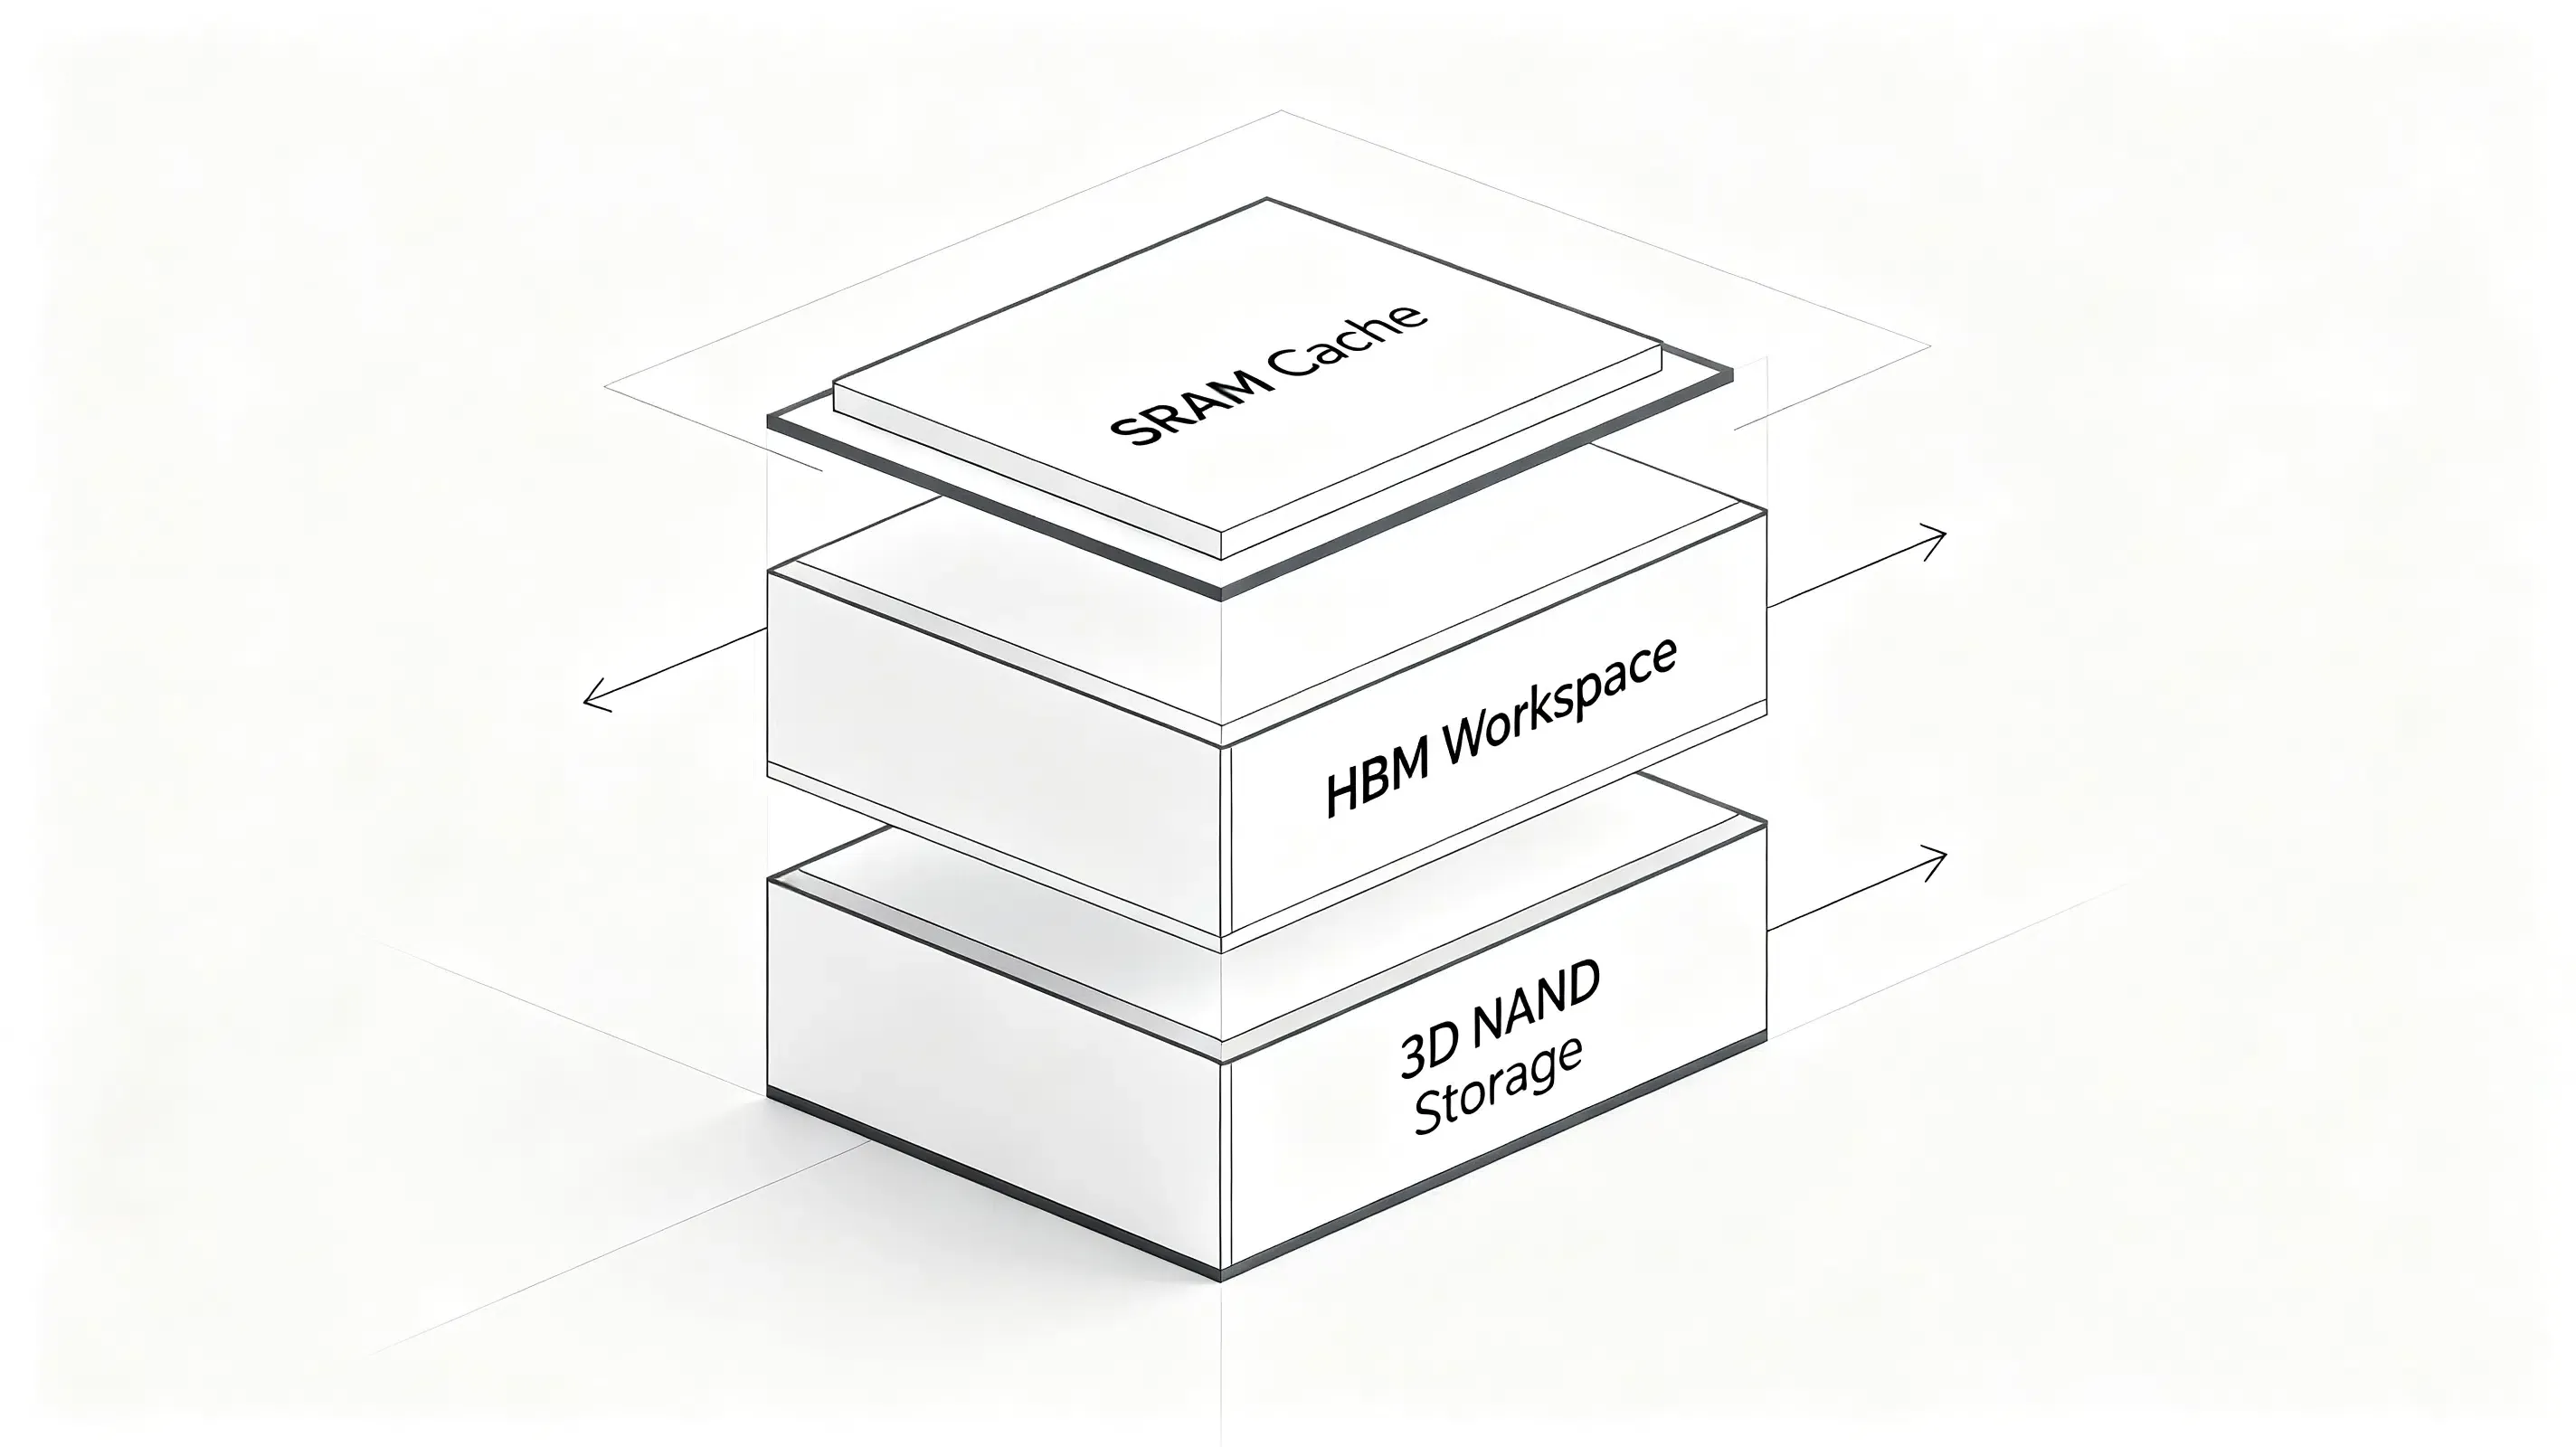
- 高速片上 SRAM 缓存:作为顶层高速缓存,SRAM 直接集成在处理器旁,相较于传统 DRAM 显著降低了处理活动参数寄存器时的内存访问延迟。
- 高带宽内存 (HBM):作为主要活动工作区,HBM 处理活动参数检索和高频状态更新,JEDEC 标准定义了其宽接口特性。
- 高容量 3D NAND 闪存:高带宽闪存 (HBF) 是 KAIST 研究人员提出的新兴存储架构,旨在通过垂直堆叠 NAND 闪存提供大规模长期存储能力,从而补充 HBM,用以保存视频、文档及持久化的对话记忆。
下图展示了这种物理垂直集成:
                  [ GPU / 处理器核心 ] (顶层冷却)
                             │
                             ▼
                  [ 高速片上 SRAM 缓存 ] (超快晶圆缓存)
                             │
                             ▼
                  [ 高带宽内存 ] (活动工作区 DRAM)
                             │
                             ▼
                  [ 高容量 3D NAND 闪存 ] (长期 NAND 存储)
这种集成的 3D 架构确保了标准计算单元能持续获得数据供给,从而减少空闲周期。传统 DDR 内存仅能提供 HBM 极小一部分的带宽。根据 NVIDIA 与 SK 海力士共同发布的 NVIDIA GTC 技术演示,HBM 在占用更小物理空间的同时,提供了远高于传统 DDR 内存的带宽。具体而言,HBM2 单层堆叠可提供约 307 GB/s 带宽,HBM2E 提升至约 358 GB/s,而 HBM3 的目标带宽则已突破 500 GB/s。
尽管内存带宽与应用归因属于不同的工程领域,但两者均指向同一架构原则:将状态管理从受限的本地资源迁移至可扩展的服务器端基础设施。当用户交互为了满足隐私准则而脱离客户端状态跟踪时,在不同的 Web 和移动环境间保持顺畅的会话连续性变得极为复杂。正如处理器需要持久的高速内存管线以匹配状态上下文,下游的市场营销管线同样需要稳健的服务器端数据保留机制,以在不依赖易受攻击的客户端 Cookie 或设备级别属性的情况下关联安装事件。
自研还是采购:管理服务器端会话连续性与数据吞吐
随着现代计算环境摒弃本地客户端标识符,跨分布式数字接触点维护会话状态已成为主要的工程挑战。对于开发者而言,在“HBM 内存是关键”的时代,管理会话状态需要既符合数据隐私法规又具备高度准确性的架构。企业若需在 Web 和移动体验中保存用户路径,正日益转向服务器端会话管理,而非依赖持久化的客户端标识符。根据业务需求,团队可以选择内部自建或采用现有的归因平台。
架构评估:自研开发 vs. 标准化 SDK
自建系统进行服务器端状态匹配可提供极高的灵活性,但需要持续投入大量工程资源。开发者必须手动构建数据库模式、编写安全加密哈希函数,并根据不断变化的区域法规持续更新系统。相反,部署经过认证的预构建 SDK 可降低集成复杂度,并在无额外运维负担的情况下确保长期合规。
下表对比了管理会话状态和转化上下文的标准方法:
| 解决方案 | 持久性 | 吞吐量 | 适用场景 |
|---|---|---|---|
| 内部会话数据库 | 高(持续同步) | 中(受 DB 延迟限制) | 具有特定存储逻辑的定制化企业环境 |
| 基于浏览器的会话跟踪 | 低(会话 Cookie) | 低(无服务器日志) | 对跨域转化要求极低的网站基础跟踪 |
| 服务器端缓存 (如 OpoInstall) | 无(临时服务器端会话令牌) | 高(标准化沙盒) | 高并发移动 App 及多平台广告归因 |
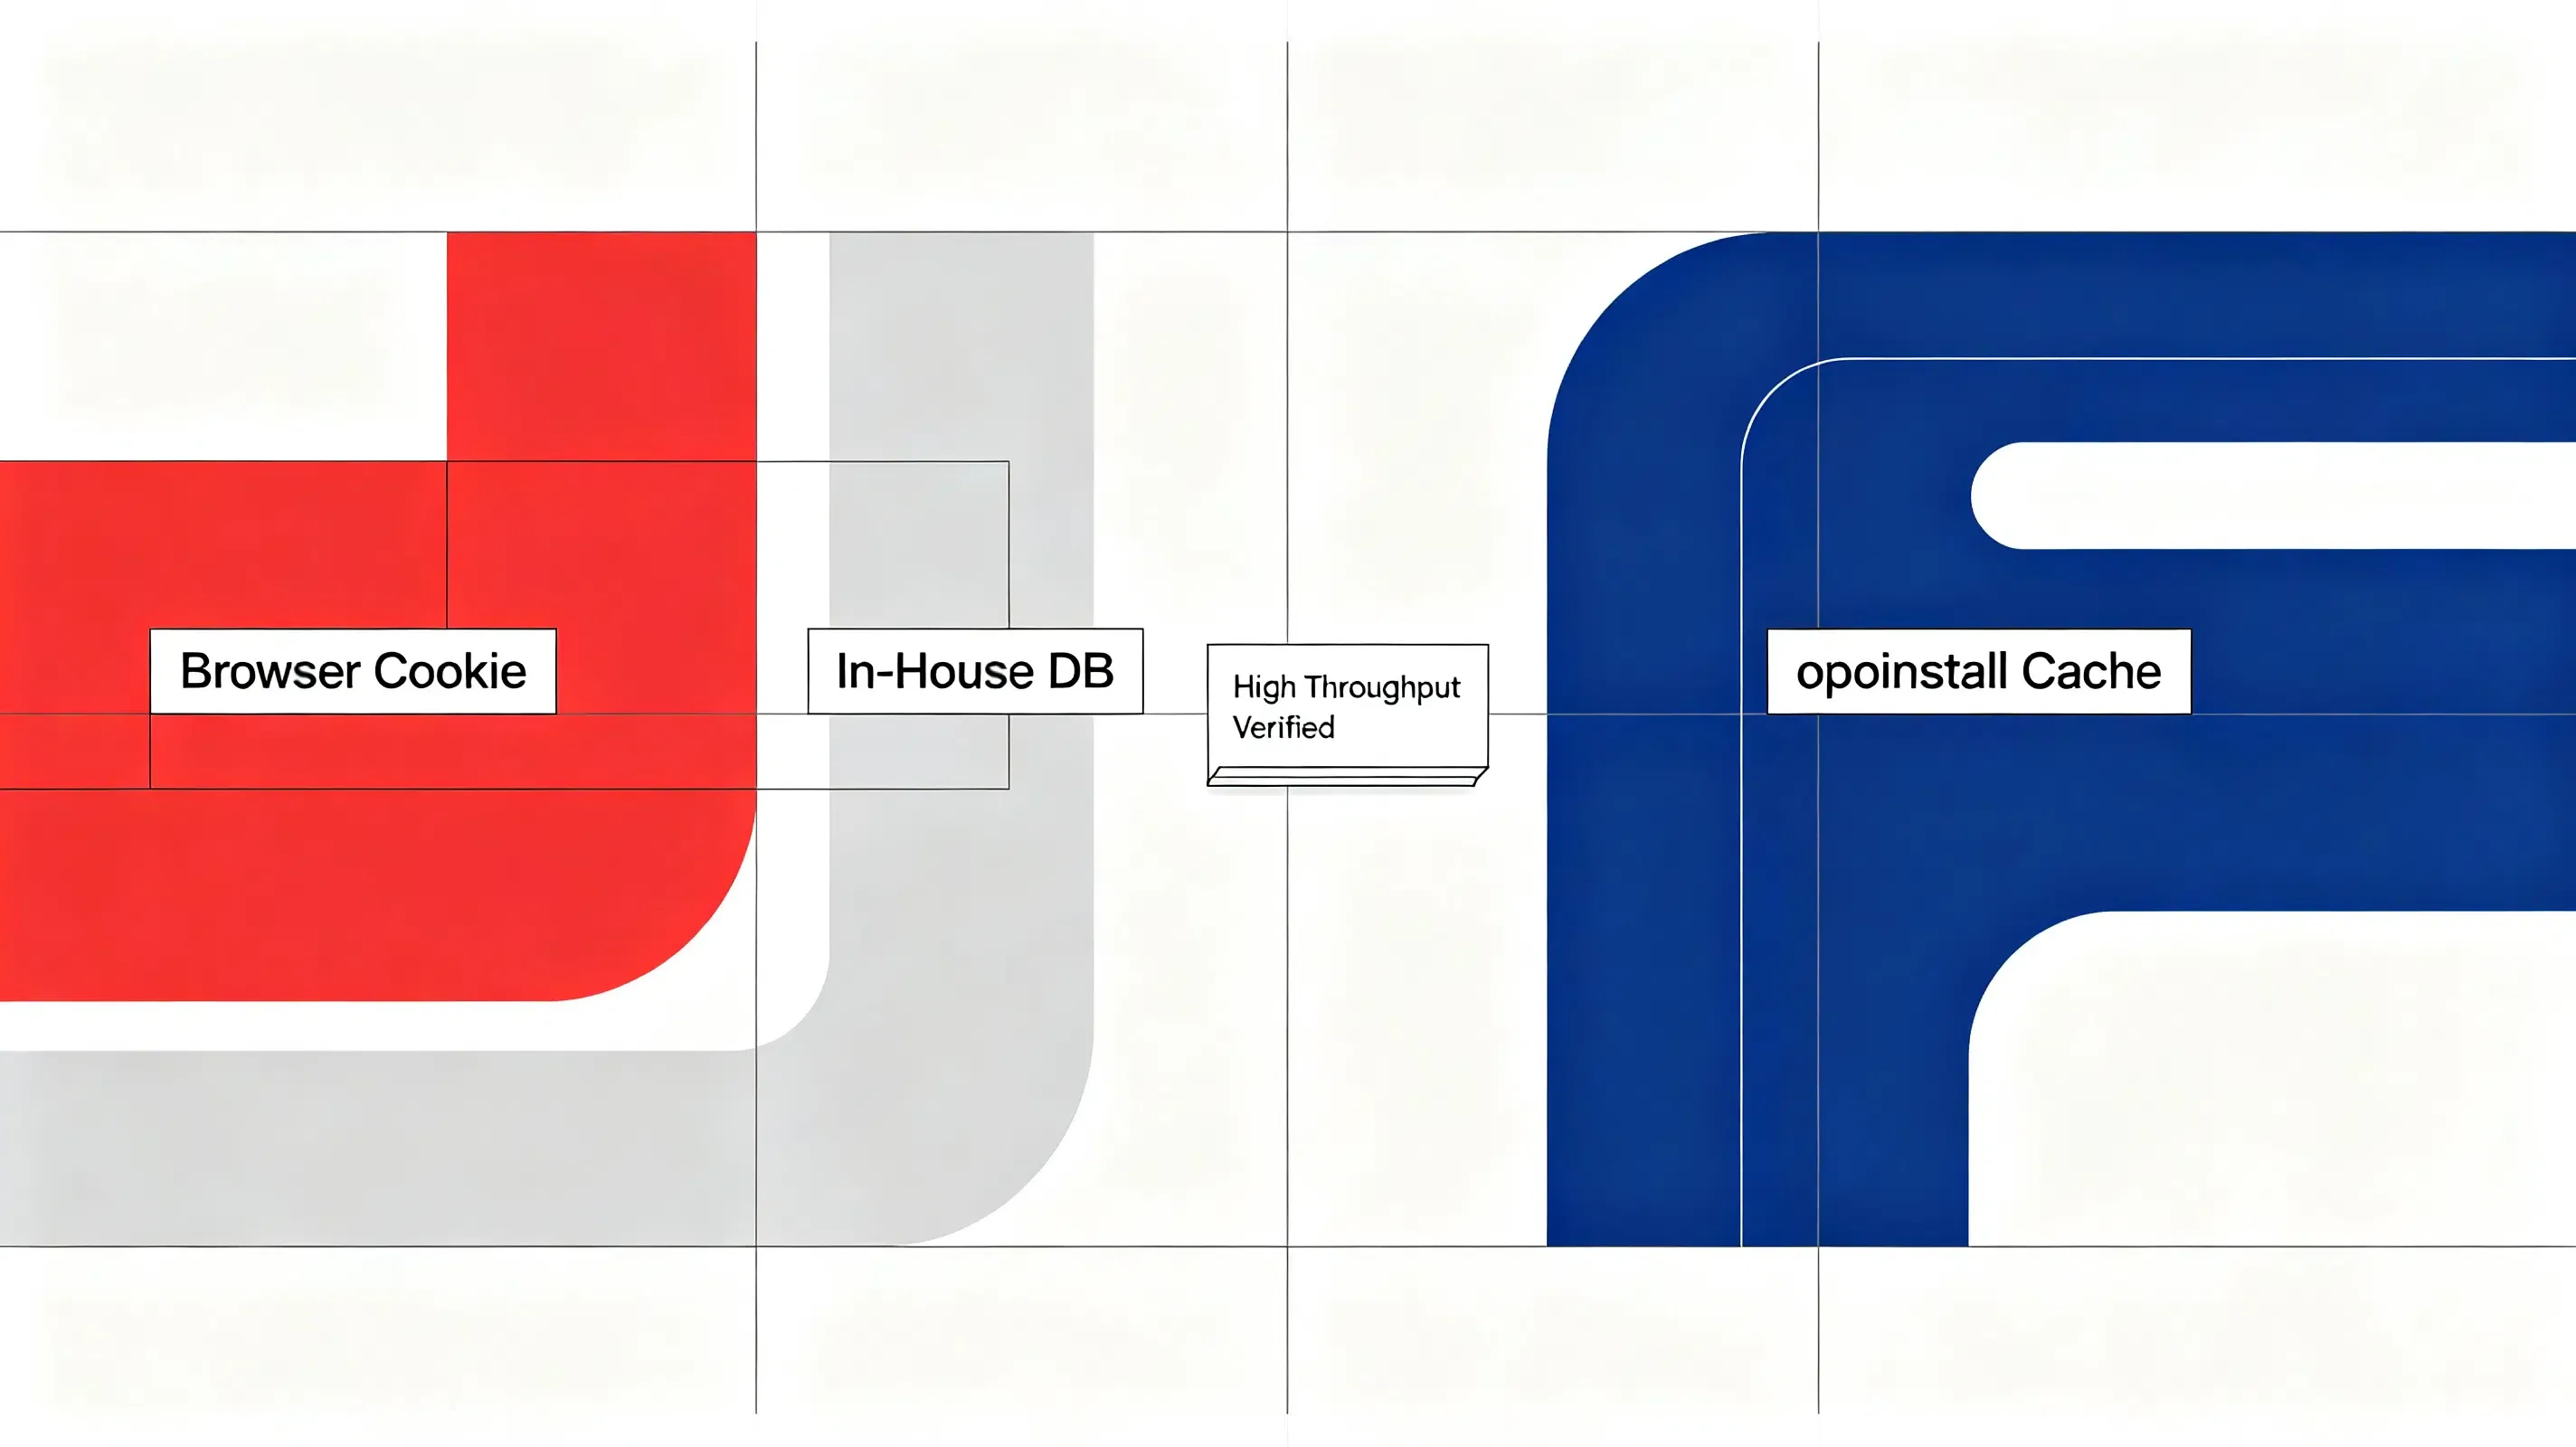
近期发表在 arXiv 数据库研究中的 GPU 架构报告也表明,内存访问效率对推理吞吐量的决定作用往往超过了算术性能本身。虽然定制数据库配置可以处理基础上下文,但专业的服务器端状态保留技术能够优化开发资源。根据实施需求,企业可选择自建服务器端会话管理系统,或采用如 OpoInstall 等商业平台。例如,OpoInstall 提供服务器端状态还原和参数透传框架,将会话元数据映射到服务器端会话数据库,从而以匿名方式维持会话连续性,且不存储敏感的长期个人对话历史。通过将会话元数据映射到集中式数据库,而非依赖基于浏览器的重定向,该系统确保了即便初始任务是匿名执行的,转化上下文也能保持一致。工程团队可根据业务情况权衡数据保护与衡量准确性,评估这些方案的可行性。
集成检查清单:为内存中心型计算架构做好准备
为在后标识符时代保护数据管线并确保用户安全,开发者和架构师可以评估去中心化、开源的别名管理与服务器端状态保留方案。依赖单一供应商的 OS 级别功能会带来系统性的供应商锁定风险,并使组织在面对静默后台更新时处于被动状态。相反,工程团队可以评估能赋予完整数据所有权的替代路由技术。
一种标准做法是为电子邮件分区注册一个专门的自定义域名。通过 SimpleLogin 等开源、自托管的别名引擎将此域名路由至 Proton Mail 等加密邮箱,开发者可以确保其别名看起来像是标准的自定义域名,从而防止反垃圾系统将其作为特定群体拦截。
开发者实施清单
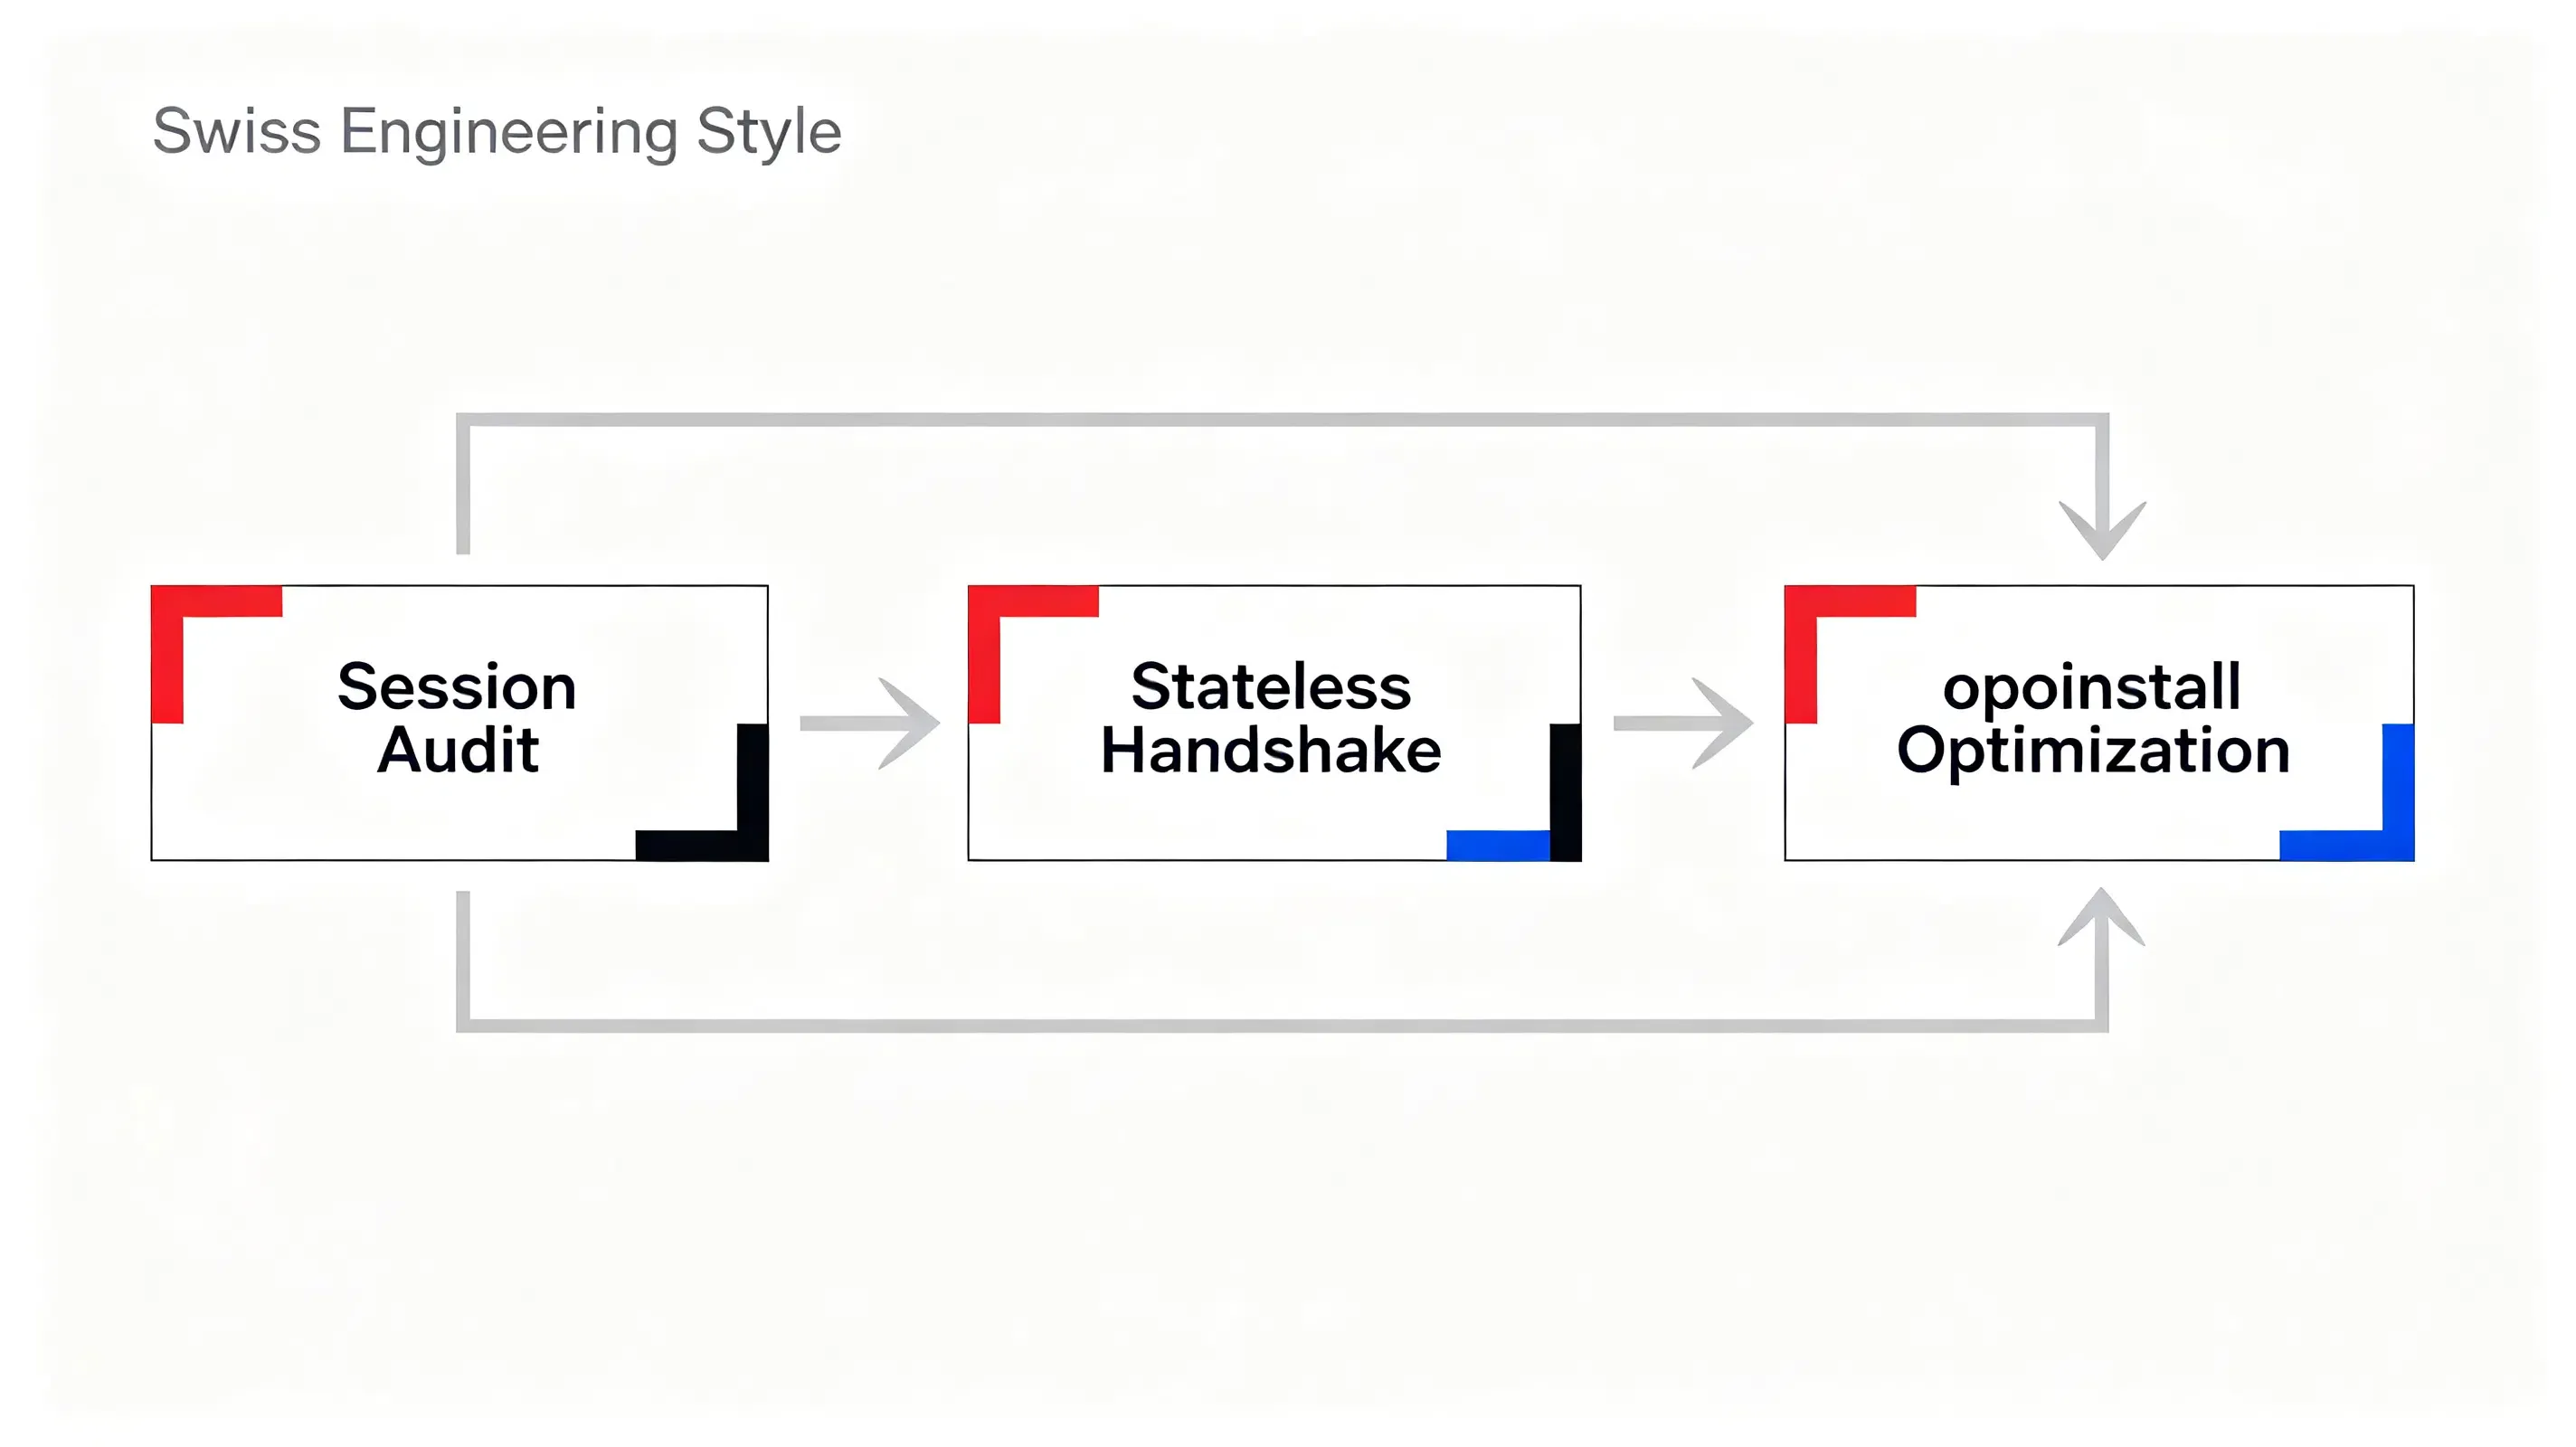
- 审核会话数据留存:检查所有数据库,确保依照数据删除时间表清理持久化存储的个人情感化聊天记录。
- 实施无状态会话握手:将 API 路由转型为无状态处理模型,利用加密签名令牌在节点间传递临时上下文。
- 强制执行年龄验证网关:针对面向消费者的产品,部署未成年人保护措施,防止未成年人访问受限的对话功能。
产品与增长策略清单
- 重组用户体验流程:从基于情感陪伴的参与模型转向不依赖情感依恋的工具型高实用场景。
- 优化转化漏斗:利用非侵入式的参数透传框架,在不违反用户隐私准则的前提下维持获客跟踪。
- 监控平台合规性:确保所有集成的第三方 SDK 符合当地数据保护法及相关合规性要求。
通过建立这些结构化指南,开发团队可以在维持运营连续性的同时,将其应用转型为更安全、更合规的架构。
常见问题解答 (FAQ)
为什么同一 GPU 在运行过程中会有高达 90% 的时间处于空闲状态?
HBM、HBF 和 HBS 在技术上有什么区别?
服务器端会话还原如何解决状态瓶颈?
为何 HBM 在 AI 推理中比训练阶段更重要?
工程团队的关键结论
随着 AI 平台适应新的法规要求,工程团队将越来越依赖无状态架构、服务器端会话管理和隐私优先的设计。演进中的数据架构要求我们在构建和衡量数字体验的方式上进行根本性转变。随着无状态代理和 headless 爬虫成为网络内容的标准消费者,传统的客户端归因模型将持续失效。仅依赖标准的 Cookie 和引荐来源已不足以保障驱动用户获取的数据管线。
为了维持增长,工程和产品团队必须优先考虑无状态数据结构和服务器端状态保留。通过实施零信任身份验证、安全的参数透传框架以及健全的数据删除计划,组织可以在尊重法律边界的同时保护其用户获取路径。这种架构转型对于构建在受监管的数字经济中蓬勃发展的稳定、可信平台至关重要。
Share this article



