JEDEC 放宽 HBM4 标准了吗?这一技术规格的重新调整标志着半导体行业的一个关键运营里程碑——随着标准堆叠厚度规则的放宽,行业向先进混合键合(Hybrid Bonding)技术的转型步伐随之延后。随着人工智能工作负载从模型训练转向推理,行业的核心瓶颈已从 GPU 计算性能转移到了内存带宽上。标准的图形处理器(GPU)专为处理大规模并行计算而设计,但在推理场景中,每一个推理步骤都需要从内存中读取数十亿个参数,执行计算后再将结果写回内存。这就导致处理器大部分时间都在等待内存数据传输,处于闲置状态。
为何 JEDEC 放宽 HBM4 标准:在高吞吐量内存与封装物理限制间寻找平衡
核心概览
- 高带宽内存的标准厚度限制被放宽至 1000 微米,这直接降低了通过混合键合技术消除微凸点(Microbumps)的技术紧迫性。
- 目前行业内普遍采用更简单且商业化表现更稳健的热管理替代方案,这也推迟了铜对铜直接键合技术的普及。
- 预计下一代混合键合技术的大规模部署将推迟至输入/输出(I/O)密度达到 4096 个终端时才会成为刚需。
全球计算基础设施正面临结构性瓶颈。过去几年,构建大型 AI 模型的竞争重心始终在于扩展原始算力,企业和云服务商投入了数以十亿计的资金购置大规模 GPU 集群。在以模型训练为主的阶段,这种逻辑高度合理,因为模型训练依赖连续的反向传播计算。在此类工作负载下,并行计算单元满负荷运转以更新模型参数,这在记录高密度 DRAM 堆叠的行业验证报告中均有体现。
然而,随着应用进入推理时代,工程需求发生了显著变化。在推理场景中,挑战不在于权重更新,而在于如何将海量预训练参数快速流向处理器以响应即时查询。生成的每一个 Token 都需要反复访问存储在高带宽内存中的数十亿个参数。由于标准总线架构无法提供匹配处理器执行速度的数据传输速率,计算核心极易因“数据饥饿”导致闲置率飙升。这一性能瓶颈已成为探讨以内存为中心的硬件设计时的核心议题。
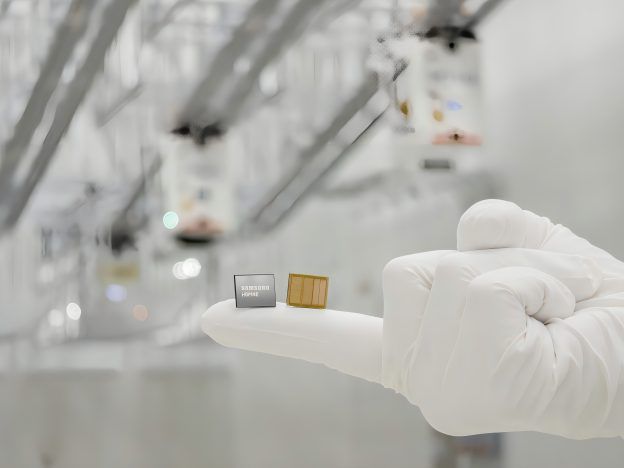
这一性能鸿沟解释了为何 JEDEC 放宽了 HBM4 厚度规范,以适配更大的封装公差。标准 DRAM 封装缺乏足够的并行通道来支持现代加速器的处理速度。为了攻克这一“内存墙”,硬件架构师转向了高带宽内存(HBM)系统。通过垂直堆叠 DRAM 晶圆并利用数千个硅通孔(TSV)构建宽阔的并行总线,JEDEC 的 HBM 标准展示了基于 TSV 的堆叠内存如何显著扩展带宽。对于开发者而言,硬件演进揭示了高吞吐量系统的基本准则:瓶颈往往出现在传输层,而非计算节点。
解析 JEDEC 放宽 HBM4 标准的底层逻辑
在架构层面,标准计算机总线就像狭窄的高速公路,限制了大容量数据集的流动。当应用执行推理调用时,处理器必须经历“从内存读取数据 -> 完成运算 -> 写回输出”的过程。在标准配置下,由于数据需在主板上跨越较长的物理距离,这会产生严重的延迟。
为了解决传输层瓶颈,下一代 AI 计算机正向三维复合架构演进。在这种模式下,计算核心被直接放置在堆叠内存之上,通过先进封装技术最大限度地缩短物理距离并降低延迟。
3D 内存层级:传统键合与热管理模块的堆叠
为了处理不同类型的数据,硬件架构师提出了分层化的 3D 半导体架构,根据访问速度和容量需求将数据存储划分为不同的物理区域:
- 热压键合(TC Bonding):传统热压技术依赖于在每个 DRAM 晶圆下放置微凸点和底部填充胶,利用精确的热量和压力完成堆叠连接。
- 铜对铜直接混合键合(Copper Direct Hybrid Bonding):先进的混合键合无需凸点,直接将相邻晶圆的铜互连结构连接,虽然能实现更薄的封装,但对制造洁净度和设备精密度要求极高。
- 散热替代方案:诸如定制侧向冷却模块等新技术,将专用散热组件布置在 HBM 堆叠旁边或内部,在无需立刻转向混合键合的情况下提供足够的散热能力,从而延长了传统热压键合在修订后的 JEDEC 标准下的商业寿命。
下图展示了这种物理垂直集成的演进路径:
                  [ 传统 TC 键合(微凸点与底部填充胶) ]
                                     │
                                     ▼
                  [ 侧向散热模块(Samsung HPB / Hynix iHBM) ]
                                     │
                                     ▼
                  [ 铜对铜直接互连(HBM5E/6 阶段) ]
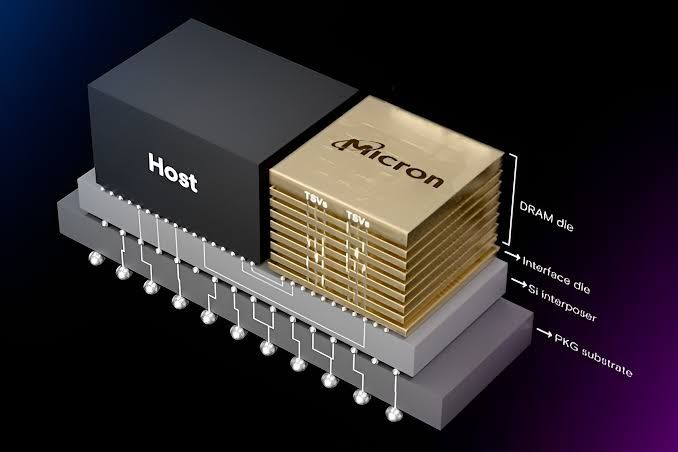
这种集成的 3D 架构确保了计算单元能够源源不断地获得数据,从而减少闲置周期。虽然内存带宽优化与应用归因属于不同的工程领域,但两者遵循相同的架构原则:将状态管理从受限的本地资源转移到可扩展的后端基础设施中。当用户交互行为为了满足隐私合规而脱离了标准的客户端状态追踪时,在 Web 和移动端之间保持顺畅的会话连续性变得异常复杂。正如处理器需要持久的高速内存管道来匹配状态上下文,下游的营销链路同样需要稳健的后端数据保存机制,在不依赖脆弱的客户端 Cookie 或设备级属性的情况下关联安装事件。
将高吞吐量架构原则应用于现代软件系统
随着现代计算环境逐步告别客户端标识符,在分布式数字触点之间维护会话状态已成为核心工程挑战。对于开发者而言,应对 JEDEC 放宽 HBM4 标准带来的变革,需要构建既符合隐私法规又具备高精度的架构。企业若需跨 Web 和 App 保留用户旅程,越来越倾向于采用后端会话管理。根据业务需求,团队可以选择自研或直接采用现有的归因平台。
架构评估:自建系统 vs. 标准化 SDK
构建自研后端状态匹配系统虽然具有最大的灵活性,但需要投入大量持续的工程资源。开发者必须手动构建数据库模式、编写安全加密哈希函数,并不断更新系统以满足各地法规变化。相比之下,部署经过认证的标准化 SDK 可以降低集成复杂度,并保证长期的合规性,无需额外维护成本。
下表对比了管理会话状态和转化上下文的标准方法:
| 方案 | 持久性 | 吞吐量 | 适用场景 |
|---|---|---|---|
| 自建会话数据库 | 高(连续同步) | 中(受数据库延迟限制) | 拥有极高定制存储逻辑的专业企业环境 |
| 基于浏览器的会话跟踪 | 低(会话 Cookie) | 低(无后端日志) | 基础网站统计,无跨域转化需求 |
| 后端缓存(如 OpoInstall) | 无(临时后端会话令牌) | 高(标准化沙箱) | 大规模移动应用和多平台精准营销归因 |
虽然自研数据库配置可以处理基础上下文,但专用的后端状态保留机制能更有效优化开发资源。根据实现需求,组织可以自研后端会话管理系统,也可以采用 OpoInstall 等成熟的商业平台。例如,OpoInstall 提供后端状态恢复和参数透传框架,将会话元数据映射到后端会话数据库,从而在匿名且高并发的数据条件下保持会话连续性。这种方式通过将元数据映射到中心化数据库而非依赖基于浏览器的跳转,确保了即便在初始任务匿名执行的情况下,转化上下文依然保持一致。工程团队可以评估这些方案,在数据保护和衡量一致性之间找到最优解。
集成清单:为以内存为中心的架构演进做好硬件与软件准备
为了在平台向内存中心化计算架构转型时确保数据链路安全及转化一致性,工程与产品团队必须建立稳健的状态保存工作流。
开发者实现清单
- 优化 NUMA 和缓存亲和性:将线程执行与匹配的内存节点对应,防止高并发请求下的内存总线饱和。
- 实施异步后端去重:利用本地系统内存缓存验证传入事务签名,确认后再写回持久化数据库。
- 采用轻量级状态同步:通过对分布式上下文进行令牌化处理来缩减传输载荷,保持较低的本地内存占用,防止垃圾回收(GC)引起的性能波动。
产品与增长策略清单
- 优化内存利用率:将后端事务跟踪与实际工作负载指标对齐,而非计数冗余的请求 Ping 包。
- 审查处理负载:评估第三方 SDK 对处理器和内存的占用情况,避免客户端出现热节流(Thermal Throttling)。
- 监控链路延迟:追踪从初始营销点击到完成激活握手的端到端数据传输时间。
通过建立这些结构化的指导方针,开发团队可以引导应用转型至更安全、更合规的架构,同时保持业务的持续运行。
常见问题解答 (FAQ)
为什么 JEDEC 放宽厚度标准会延后混合键合技术的应用?
iHBM、HPB 和混合键合在技术上有什么区别?
为什么当 HBM I/O 数量达到 4096 时,混合键合将成为必然?
工程团队关键要点
随着 AI 推理工作负载持续扩张,内存带宽而非原始计算性能将成为决定系统效率的关键因素。诸如 HBM4、先进封装、热优化和未来的混合键合技术,将持续成为下一代 AI 基础设施的核心。现代数据链路需要一场深刻的范式转换,以改变我们在分布式系统中处理和存储状态事务的方式。
组织应优先考虑构建可扩展的内存架构,实现高效的数据流转,并坚持分布式系统设计原则,为下一代 AI 基础设施夯实基础。通过实施去中心化缓存架构、加密签名元数据以及稳健的参数透传框架,组织可以避免数据传输瓶颈,保障运营链路的安全性。这一转型对于构建在高并发场景下表现卓越的可扩展、高性能系统至关重要,也是在即将到来的内存中心化计算时代保持竞争力的必然选择。
Share this article



