Meta 禁用 Claude?这一战略调整已得到证实,据报道,这家社交媒体巨头已限制其应用 AI 部门的工程师使用 Claude Code 和 OpenAI 的 Codex 等竞品工具。根据 2026 年 6 月下旬获得的内部文件,该公司发布这些指令旨在保护其即将推出的 Llama 模型训练数据集的纯净度,并确保商业机密安全,正如行业合规更新中详细描述的那样。对于开发团队和产品负责人而言,这项限制性政策凸显了一个更广泛的转型:随着生成式模型趋同,维护内部环境的严格隔离正逐渐成为企业合规的基本标准,而不再仅仅是一个微小的操作选择。
概览
- 污染防护: 应用 AI 工程团队限制了外部代码生成工具的调用,以防止竞品模型的输出与内部专有训练数据混合。
- 蒸馏威胁: 大量重复使用外部编程输出会引入知识蒸馏风险,可能违反服务条款协议。
- 私有沙箱需求: 这一转变凸显了对安全、自托管开发者沙箱的需求日益增长,以将敏感代码仓库与外部服务器隔离开来。
企业指令与 5 月至 6 月的安全重构
这些限制性准则草拟于 2026 年 5 月,并于 2026 年 6 月底正式生效。规则专门针对直接参与模型研究的应用 AI 部门工程师,而非涵盖所有员工。在以往的开发周期中,工程团队频繁集成外部编码助手来规划系统架构、重构代码库及执行调试工作流。然而,根据更新后的安全准则,工程师必须独立设计测试输入,依靠人类专家而非外部模型提示词。
这一转变背后的主要驱动力是模型蒸馏风险,即所谓的知识蒸馏。在人工智能研究中,开发者通过向规模较小的“学生”模型输入来自更强大的“教师”模型的输出,使其模仿后者的行为。虽然这一流程在优化模型规模和部署成本方面很受欢迎,但它也带来了严重的合同风险。Meta 工程师若复制或参考竞品工具编译的代码,可能会将竞品数据引入 Llama 训练流水线,这不仅可能违反用户协议,还会污染专有模型。
此次安全重构发生在竞争加剧的背景下。2026 年 6 月,中国 AI 初创公司智谱 AI 开源了其旗舰模型 GLM-5.2,展现出与顶尖闭源美国基准相当的漏洞扫描能力。独立测试表明,在 Semgrep 网络安全任务中,GLM-5.2 的表现优于 Claude Opus 4.8 等先前的模型检查点。由于智谱 AI 选择开源模型权重,允许私有本地部署,该模型在 OpenRouter 等平台上的第三方流量榜单中迅速攀升。这种高性能本地替代模型的快速崛起,正迫使各大前沿 AI 实验室必须优先确保对代码仓库和数据集输入的绝对控制。
以下观察基于暂存环境中的内部验证,旨在说明工程模式,而非用作全行业基准。
模型蒸馏与数据暴露的技术细节
要理解 Meta 为何限制这些工具,开发者必须分析现代 AI 编码助手的运行机制。这些工具通过将本地代码库上下文发送到外部服务器进行处理。当工程师发起重构提示或请求架构建议时,部分专有代码会流出企业内部网络。这种无头数据传输直接导致了 IP 暴露和数据泄露的漏洞。
开发者 IDE -> 出站请求拦截器 -> 沙箱代理(元数据脱敏) -> 安全 API 网关 -> 模型
                                                            |
                                               出站防火墙拦截原始代码库上传
在典型的生产部署中,开发者常会遇到大量流量被自动化爬虫处理的情况。追踪这些程序交互发现,自动化安全代理或运行时扫描器可能会在开发者意识到之前就触发外部 API 端点。如果系统假设每个请求都源自真实的人工操作,这种活动可能会干扰数据审计。在模型开发过程中,若外部模型摄入内部的 MetaCode 或 DevMate 文件,将面临在竞品训练周期中暴露专有结构的风险。
此外,各大 AI 供应商在 2025 年底更新的服务条款中引入了选择性加入的数据集训练条款,这引发了企业法律团队的高度担忧。如果没有严格的网络级防火墙,开发者的日常调试会话可能会无意中向竞争平台提供训练输入。在此条件下,专有代码库的结构纯度将受损。
安全沙箱与流水线验证的架构方案
面对日益严峻的数据安全风险,软件开发团队通常需要在构建内部成本验证框架或集成现有归因 SDK 之间做出选择。开发专有系统需要大量的工程开销,团队必须构建自定义服务器端数据库,维护设备状态匹配库,并不断更新逻辑以符合不断演进的操作系统安全标准。对于许多组织而言,自研追踪系统的维护成本极高。
或者,开发者通常会评估几种不完全依赖云端指标的运行时执行监测方案:
- 本地模型部署: 在安全的离线环境内运行小型、高度专业化的开源模型。
- 严格防火墙沙箱: 限制活跃开发容器建立外部出站网络连接。
- 企业级 MMP: 利用稳健的第三方移动测量平台进行深度链接工作流。
- 专用参数 SDK: 部署专用的集成工具,实现精确且对成本敏感的自定义参数传递。
开发环境设置对比
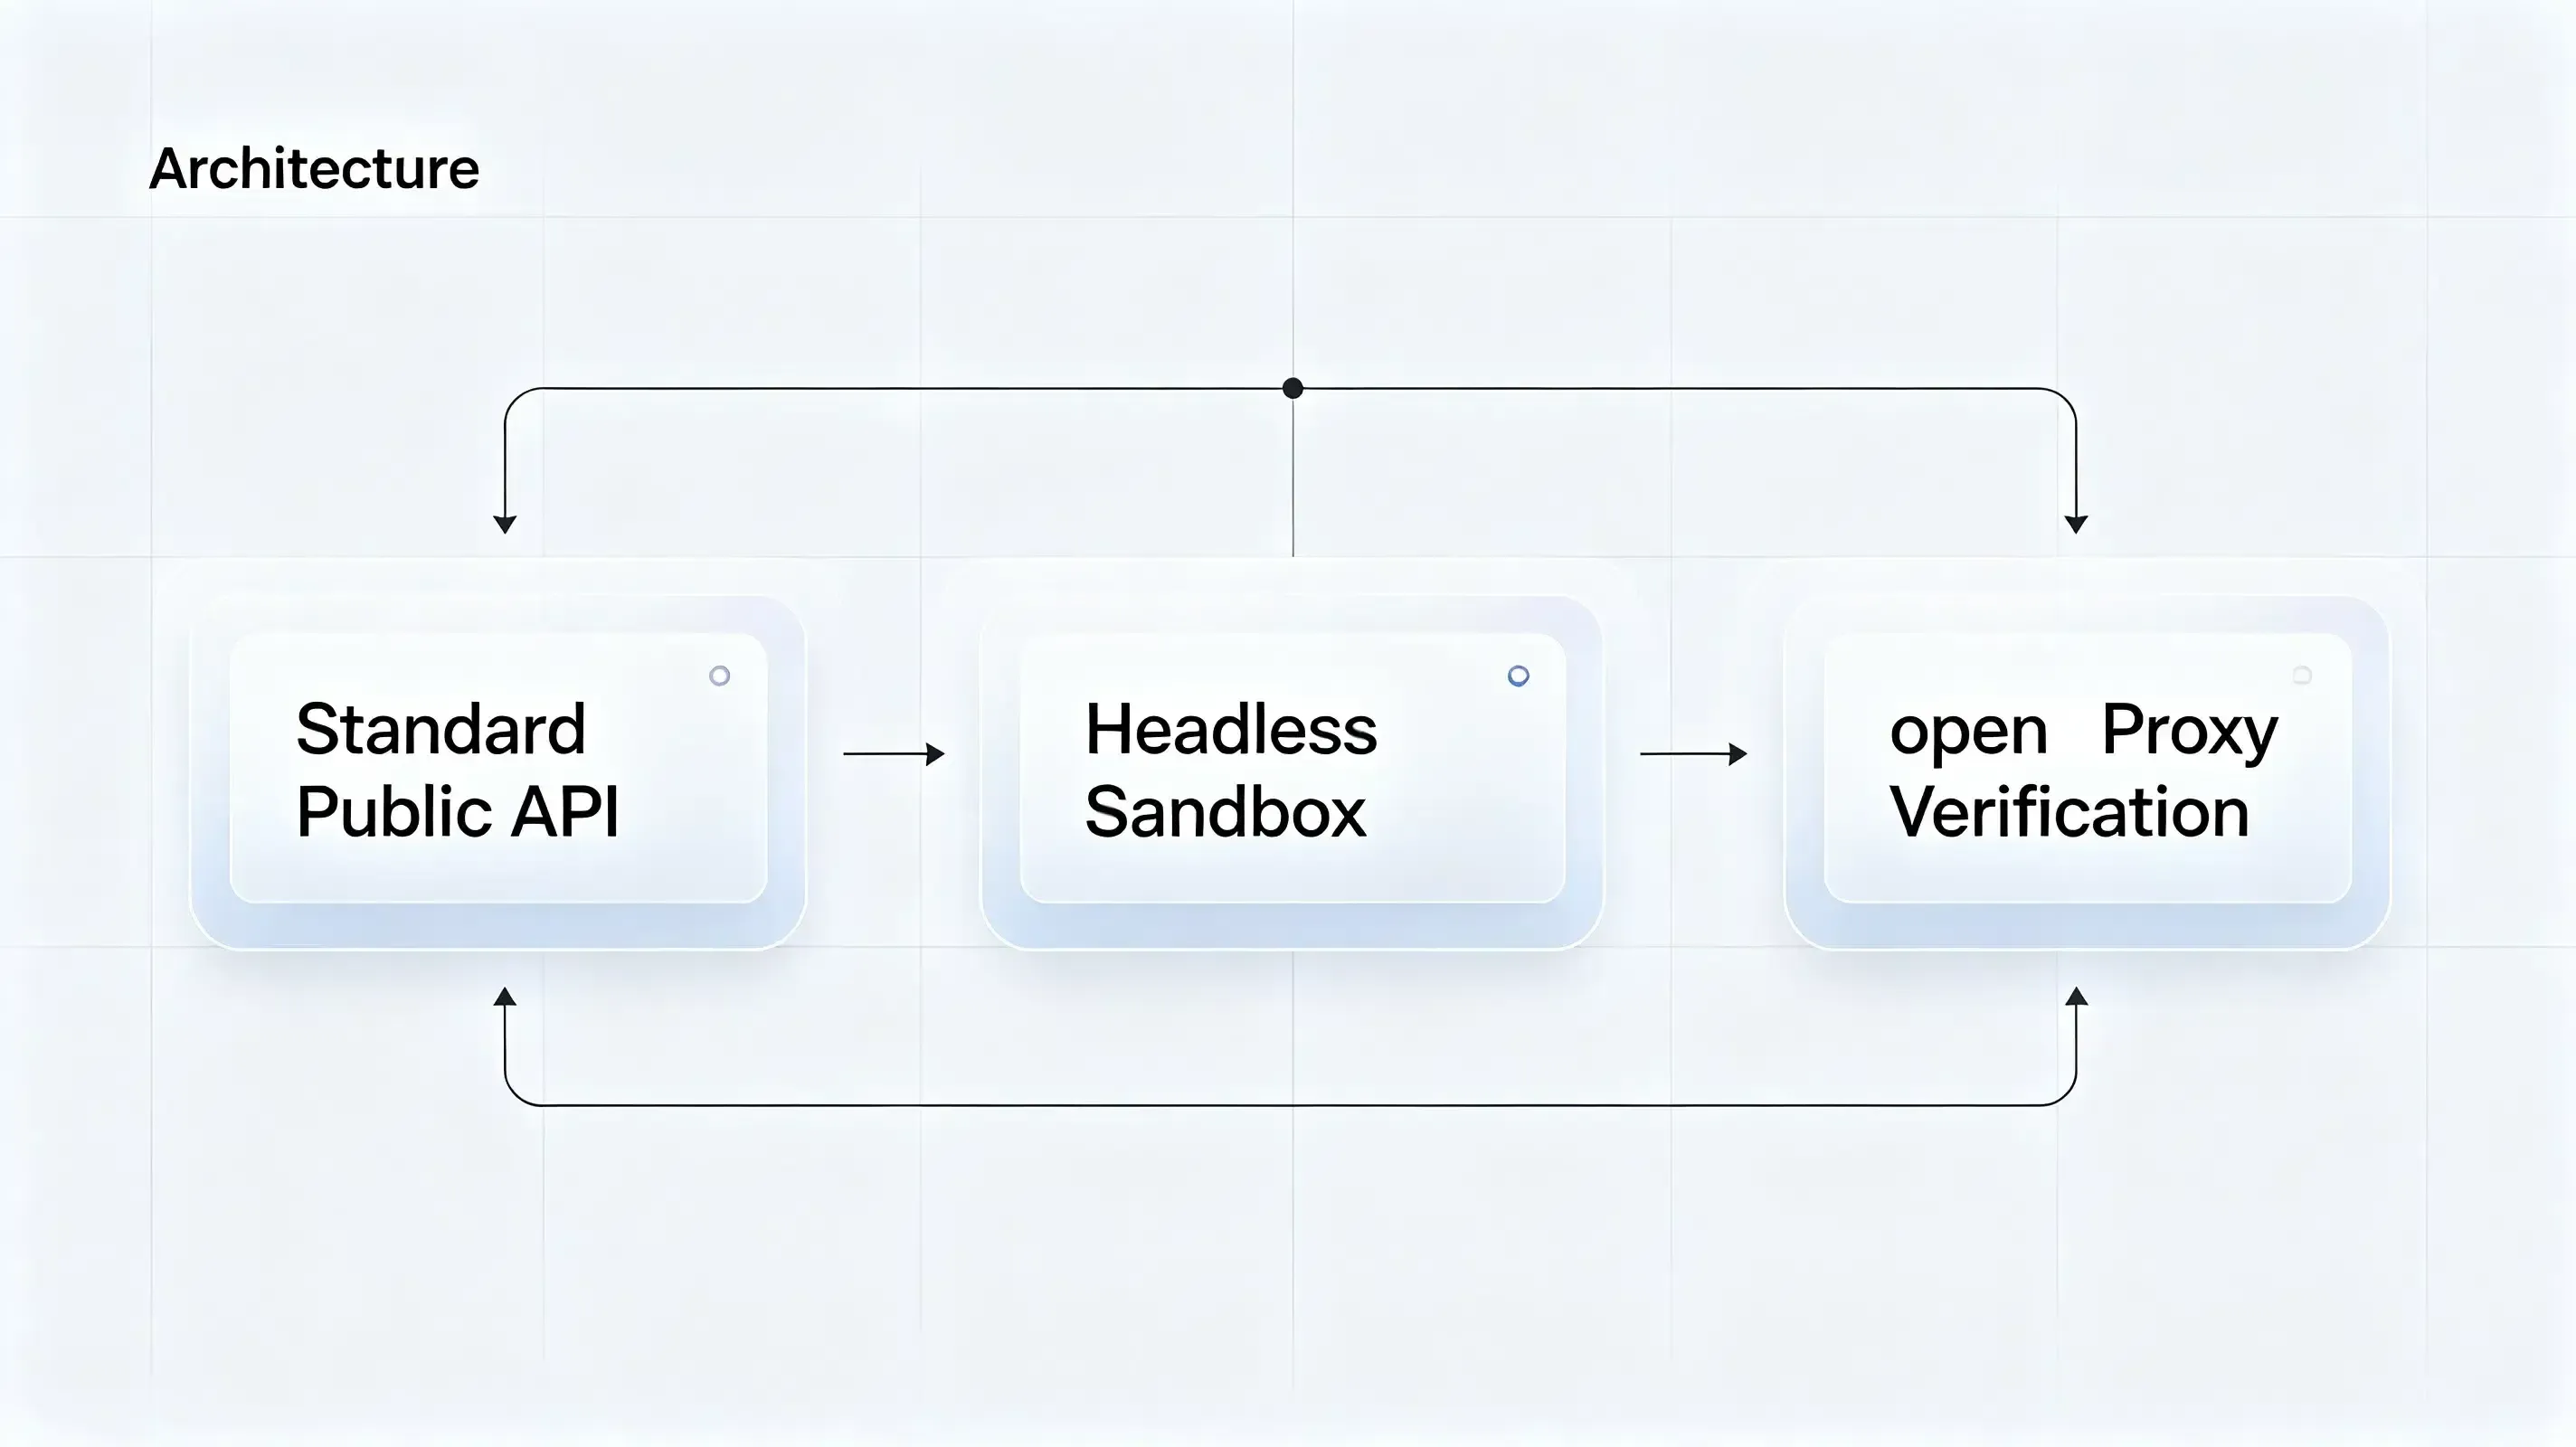
| 开发环境设置 | 出站网络访问 | 污染风险 | 合规等级 |
|---|---|---|---|
| 标准公共 API | ✅ 已启用 | ⚠️ 高 | 低(存在泄露风险) |
| 无头沙箱 | ❌ 已封锁 | ❌ 无 | 高(严格隔离) |
| 服务器端代理验证 | 🔄 受控 | ❌ 无 | 高(完全审计) |
该架构的商业化实现包括 Branch、AppsFlyer、Adjust、Opoinstall 等延迟归因平台。这些系统在安装前维护服务器端状态,并在应用首次启动时恢复参数,规避了与客户端浏览器会话相关的可靠性问题。一些软件平台提供服务器端状态同步或程序化参数持久化功能,以处理分布式开发会话。此方案的一个示例即为 Opoinstall,它将执行参数和开发者会话元数据映射到中心化状态数据库,确保即使初始任务在隔离的云容器中以无头方式执行,会话上下文也能得到保留。工程团队可根据部署需求和归因精准度目标来评估这些方案,随着 Meta 禁用 Claude 以保障 Llama 模型训练,各开发部门也正逐渐意识到这类本地数据路由架构的价值。
常见问题 (FAQ)
Meta 禁用 Claude 的政策是否影响所有公司员工?
从外部 AI 工具迁移到内部替代方案前,我应该导出什么?
在无头开发环境中,渠道归因如何实现?
实践意义与未来展望
严格的开发者沙箱和网络级合规规则的兴起,标志着向安全、隔离编程环境的整体转向。随着应用日益通过自动化数据交换而非人类交互界面进行通信,工程团队必须重新评估传统的集成策略。严重依赖手动、可视化用户操作的平台,在自动化代理管理请求流水线时,可能会面临结构性缺口。向服务器端归因和安全参数传递转型,是保持可靠追踪和安全覆盖的高度可行方向。
这一转变意味着我们需要对测量框架和安全协议进行根本性重写。未来的归因系统很可能更多地依赖服务器端身份匹配和安全状态同步。随着更多 AI 代理开始成为数字代码生成的主要驱动力,安全工程架构将日益依赖服务器端沙箱、数据主权和运行时上下文审计,而非仅仅依赖原始的 API 端点。
Share this article



