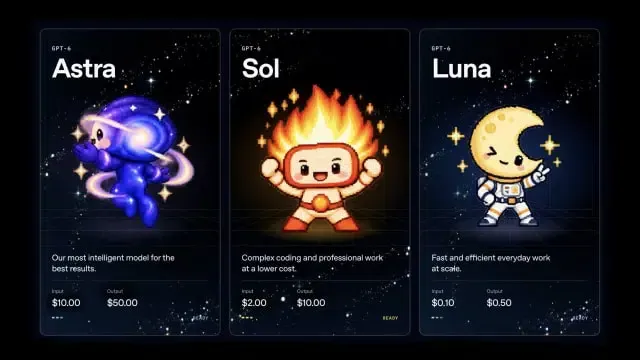
OpenAI 将 Sol API 价格减半?OpenAI 于 2026 年 9 月 22 日正式宣布 GPT-6 Sol 和 GPT-6 Luna 在 API 中商业化可用,在标准端点上,其 API Token 费率较早期的 GPT-5.6 促销定价大幅降低了 50% 甚至更多。针对输入 Token 高达 272K 的标准提示词处理,GPT-6 Sol 的定价为每百万输入 Token 2.00 美元、每百万输出 Token 10.00 美元,而较小的 GPT-6 Luna 模型每百万 Token 的输入和输出价格则分别为 0.10 美元和 0.50 美元。当 OpenAI 在标准开发者层级将 Sol API 价格减半时,结构性的计算成本下降改变了生成式软件的运营限制。更低的单价使得递归智能体循环、后台批量提取以及自主多步工作流在规模化应用中具备了切实的经济可行性。然而,对于系统架构师、可靠性工程师和后端开发人员而言,财务摩擦的减少也暴露了下游的可扩展性挑战,将工程重心从 Token 预算转移到了速率限制边界、并发限制、遥测管道以及反压瓶颈上。
运营问题与财务瓶颈
在企业级 LLM 采用的早期阶段,名义 Token 费用充当了一种非正式的架构调节器。高昂的推理成本迫使开发团队将模型调用视为离散的、由用户发起的事务。应用程序严重依赖人工审批、有限的对话历史记录以及严格节流的定时任务,以确保每月的服务提供商账单保持可预测。永久性中端模型降价的引入对这些历史权衡提出了挑战,将系统工程的关注点从模型定价转移到了后端基础设施的韧性上。
核心概览
- 基准价格下调:2026 年 9 月 22 日,OpenAI 针对高达 272K Token 的提示词标准处理,推出了 GPT-6 Sol(每百万 Token 输入 2.00 美元 / 输出 10.00 美元)和 GPT-6 Luna(每百万 Token 输入 0.10 美元 / 输出 0.50 美元),与 GPT-5.6 促销 API 定价相比,名义降幅达到 50% 甚至更高。
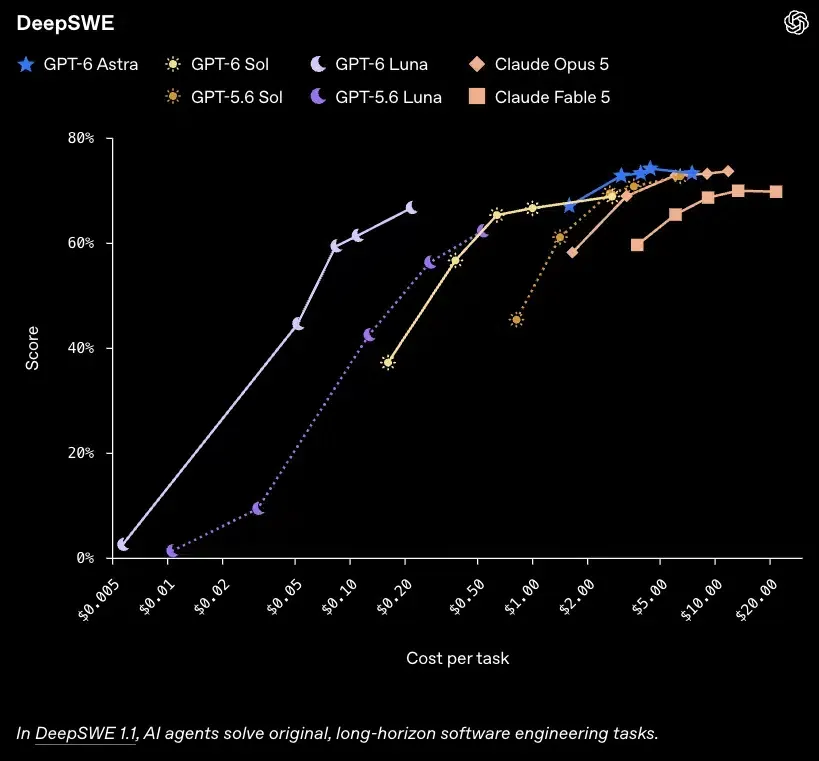
- 任务级基准经济学:在 AutomationBench 1.0.6 上,OpenAI 报告称,配置为 xhigh 推理强度的 GPT-6 Sol 取得了 33.2% 的工作流得分,尝试每个任务的平均报告成本为 0.27 美元,这使得开发者的评估标准从单纯的 Token 定价转向了每个尝试工作单元的成本。
- 提示词缓存机制:该平台对缓存的输入 Token 读取提供自动 90% 的折扣(按基础输入 Token 费用的 0.1 倍计费),而初始缓存写入则按未缓存输入 Token 费用的 1.25 倍计费,这要求进行仔细的前缀归一化,以在动态多步运行中维持高缓存命中率。
正如官方的 OpenAI 开发者 API 定价参考和 OpenAI 社区公告中所详细介绍的那样,这些定价结构源于底层推理管道和 KV 缓存系统的持续改进。然而,当执行自动化任务序列的成本显着下降时,工程团队会扩大其后台任务的范围。此前阻碍后台工作者运行持续轮询、自动化代码审查通道或多阶段文档提取管道的经济门槛已经降低。
在整个市场上,多家基础模型提供商已经降低或重构了开发者层级的 API 价格。Anthropic 发布了 Claude Opus 5.5 以及 Anthropic Claude Opus 5.5 平台规范上的更新规格,报价为每百万输入 Token 4 美元、每百万缓存输入读取 0.20 美元、每百万输出 Token 20 美元,突出了在代码重构基准测试中降低的 Token 消耗。与此同时,Google 维持了其在 Google AI 开发者文档中记录的 Gemini 3.8 Flash 的促销介绍定价,而小米的 MiMo-V2.6-Pro 等开源权重版本则在宽松的软件许可下为自托管团队提供了激进的 Token 成本选项。
当模型成本下降时,开发行为也会随之改变。工程团队部署更深的递归循环,将全面的企业文档注入系统提示词中,并在复杂的任务图中配置自动化重试逻辑。在 API 层面上节省成本的举措,可能会将延迟和流量峰值转移到内部服务。如果编排工作者为单个用户事务发出数十个顺序或并行的模型调用,内部数据库池、辅助存储集群、遥测管道和速率限制器必须承受由此产生的负载。
系统性根本原因与非视觉请求链
当客户端应用程序从交互式聊天界面过渡到非视觉后台自动化时,上游请求配置文件会发生巨大变化。单个业务事件可以触发一个自主管道,该管道在多个连续通道中检查架构、评估环境变量、调用外部工具并验证输出。
+-----------------------------------------------------------------------------------------+
|                  RECURSIVE AGENT EXECUTION & BACKPRESSURE BOTTLENECK                    |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ User Web / App Trigger ]                                                             |
|         |                                                                               |
|         v                                                                               |
|  [ Ingestion API Gateway ]                                                              |
|         |                                                                               |
|         +---> Spawns Autonomous Worker Instance                                         |
|         |                                                                               |
|         v                                                                               |
|  [ Autonomous Orchestration Loop (GPT-6 Sol / Luna) ]                                   |
|         |                                                                               |
|         +--- Step 1: Query Context (Cache Read) -----------------+                      |
|         |                                                        |                      |
|         +--- Step 2: Tool Execution (Uncached Call)              |                      |
|         |                                                        |                      |
|         +--- Step 3: Self-Correction Validation                  |                      |
|         |                                                        v                      |
|         +--- Step 4: Recursive Execution Fork ----> [ Bursting Internal RPCs ]          |
|                                                                  |                      |
|  [ Downstream System Bottlenecks ]                               |                      |
|         |                                                        |                      |
|         +--- Internal Microservices <-- (Connection Starvation) -+                      |
|         +--- PostgreSQL / Cache Stores <-- (Connection Pool Saturation)                 |
|         +--- Distributed Telemetry Stream <-- (Lossy Drop Buffer Applied)               |
|         +--- Audit Compliance Store <-- (Durable / Replayable Queue Lag)                |
|         +--- Upstream Provider Thresholds <-- (HTTP 429 Rate Limit Exhaustion)          |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
递归智能体执行与并发乘数效应
在传统的交互式 Web 系统中,请求量反映了人类的交互节奏。每个 HTTP 线程通常映射到一个明确的用户交互,具有较低的整体扇出,并且其节奏受限于人类的思考时间。客户端运行时发送有效负载,等待响应,并在发起后续交互之前暂停。
概念请求配置文件比较:交互式与智能体式
| 架构指标 | 交互式用户流 | 自主智能体循环 |
|---|---|---|
| 并发模型 | 按人类节奏发起的请求扇出通常较低 | 1 个接入事件 = N 个链式子调用 |
| 执行时机 | 由用户响应和思考时间决定节奏 | 自动进行,直至触及策略限制 |
| 上下文失效 | 每会话使用新鲜有效负载 | 高度依赖缓存的上下文 |
| 错误处理 | 出错时由用户重试 | 自动程序化重试 |
| 系统瓶颈 | 前端网关带宽 | 内部数据库池限制 |
| 故障级联 | 局限于单个会话 | 可能触发队列饱和 |
当系统集成自主智能体时,这种节奏就会解耦。单个触发事件可以生成一系列不间断的自动化调用。如果智能体遇到瞬时错误或格式错误的工具输出,简单的重试逻辑可能会对后端服务产生快速的请求突发。由于降低的 Token 成本使更长的执行运行变得经济实惠,即使活跃用户基数保持平稳,自动化工作流也可以显著扩展后台请求量。
提示词缓存机制:KV 复用、写入开销与前缀稳定性
OpenAI 将 Sol 和 Luna 版本的发布与其提示词缓存子系统的优化结合在了一起。正如 OpenAI 提示词缓存规范中所记录的那样,与缓存前缀匹配的输入 Token 在读取定价上可享受 90% 的折扣。提示词缓存主要用于减少模型端的重新计算,而不是充当通用的网络有效负载压缩机制。在标准的无状态交互中,客户端应用程序传输请求上下文,提供商跳过重新计算匹配前缀的 KV 张量,从而显著降低首字延迟和输入计费。
至关重要的是,将初始前缀写入服务器端缓存的费用按未缓存输入 Token 费率的 1.25 倍计费。最大化成本效益需要在多个查询之间保持前缀稳定性。
精选公开 API 标价 — 无法直接在不同提供商之间进行比较
| 模型标识符 | 输入($/100万 Token) | 输出($/100万 Token) | 缓存读取策略 |
|---|---|---|---|
| OpenAI GPT-6 Luna (Std) | $0.10 | $0.50 | 90% 折扣 (0.10×) |
| OpenAI GPT-6 Sol (Std) | $2.00 | $10.00 | 90% 折扣 (0.10×) |
| OpenAI GPT-6 Astra (Std) | $10.00 | $50.00 | 动态分层定价 |
| Anthropic Opus 5.5 | $4.00 | $20.00 | $0.20/1M 读取 (0.05×) |
| Anthropic Sonnet 5 | $2.00 | $10.00 | 缓存最高 90% 折扣 |
| Google Gemini 3.8 Flash | $0.75 (介绍价) | $3.75 (介绍价) | $0.075/1M 缓存读取 |
| Xiaomi MiMo-V2.6-Pro | $0.435 | $0.87 | $0.0036/1M 缓存读取 |
注意:标准费率适用于短上下文层级(OpenAI 提示词最高支持 272K 输入 Token)。各提供商执行不同的缓存写入开销、上下文限制和有期限的促销条款。
前缀的保留需要对 API 配置选项进行仔细处理。在 OpenAI 的 API 架构中,直接更改推理努力参数或更改工具定义数组将改变渲染的提示词前缀并使先前的缓存状态失效。
为了在多轮会话期间保留缓存的上下文,开发人员必须保持工具架构和基准指令的顺序一致。如果需要运行时调整,开发人员应通过结构化会话控件(例如 configuration_update)更新参数,或者使用 tool_choice 或 allowed_tools 切换工具执行,而不是直接修改工具定义数组。
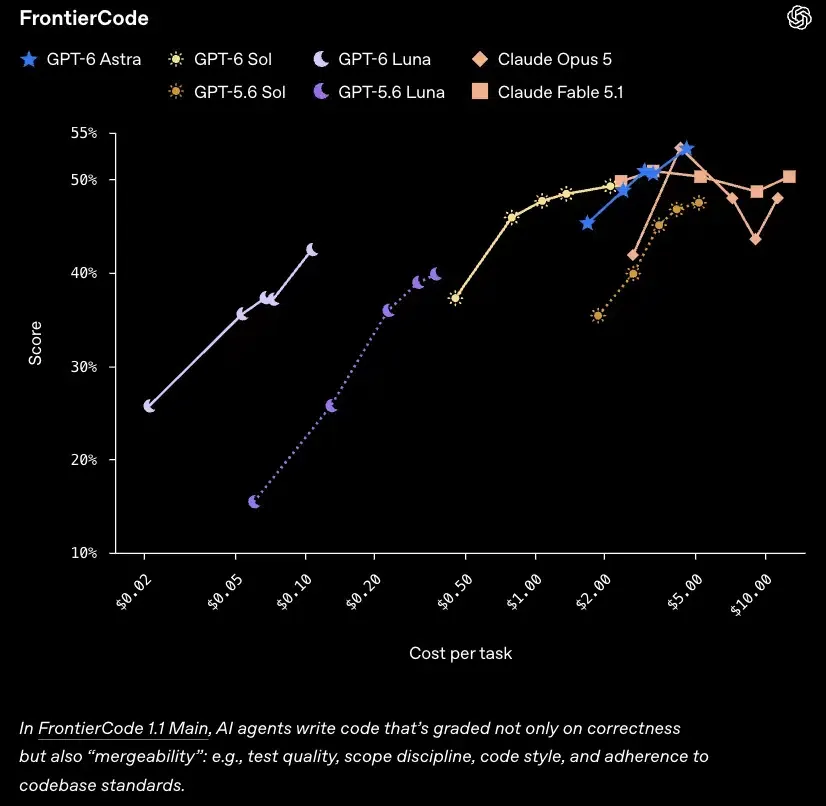
当发生缓存未命中时,上游提供商会在没有 90% 读取折扣的情况下重新处理输入序列。在大规模情况下,这可能会增加推理延迟和超时压力。对于多步骤任务执行,成本评估从简单的 Token 乘数转变为已完成任务的支出,正如 VentureBeat 关于 GPT-6 Sol 和 Luna 基准测试的报道中所见,其中 GPT-6 Sol 在 AutomationBench 1.0.6 上取得了 33.2% 的分数,尝试每个任务的平均成本为 0.27 美元。
遥测架构:将运维指标与合规审计解耦
自动化 LLM 请求的激增给后端可观测性和合规管道带来了巨大压力。高并发智能体工作流要求在运维遥测和法律审计追踪之间进行清晰的架构分离。
企业合规政策通常要求记录会话元数据、工具执行证明和交易记录。将运维遥测和合规数据同等对待会产生严重的工程权衡:
- 合规与安全审计通道:必须提供持久、可重放的交付,具有明确的重试、持久化和故障处理能力,写入一次性、访问受控的审计存储中。有效负载应捕获结构化元数据、调用者身份和密码学状态,同时系统性地净化个人身份信息 (PII) 和密钥。在负载较高时,这些管道必须应用反压或持久排队,而不是丢弃记录。
- 运维遥测通道:跟踪性能指标,例如 Token 数量、提示词缓存命中率和上游响应延迟。由于这些追踪用于实时监控和调试,它们可以通过有界、有损的丢弃缓冲区进行处理。如果下游收集器变慢,应用程序可以安全地卸载多余的运维遥测,以维护核心服务的可用性。
当外部提供商返回 HTTP 429 速率限制错误时,配置不当的重试策略可能会导致严重的运营问题。没有随机抖动的立即重试或同步指数退避例程会产生重试浪潮,这些浪潮可能会通过中间微服务级联,从而消耗线程池和数据库连接。
解决方案比较:自建与采购的权衡
管理由于较低推理成本而产生的运营负载,需要组织评估其 AI 网关和代理架构。团队必须决定是在内部开发自定义路由、速率限制和遥测代理,还是部署专门的第三方基础设施。
+-----------------------------------------------------------------------------------------+
|                 SYSTEM RESILIENCY PIPELINE WITH DECOUPLED TELEMETRY                     |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ Inbound Application Requests ]                                                       |
|         |                                                                               |
|         v                                                                               |
|  [ Sliding-Window Rate Limiter ] <--- Local In-Memory or Distributed Cache              |
|         |                                                                               |
|         +---> Rejects / Delays Excess Concurrency (HTTP 429 Protection)                 |
|         |                                                                               |
|         v                                                                               |
|  [ Prompt Normalization & Cache Alignment Engine ]                                      |
|         |                                                                               |
|         +---> Pins Static System Prompts & Tool Definitions to Base Prefix              |
|         +---> Uses Structured Controls to Modify Session Parameters                     |
|         |                                                                               |
|         v                                                                               |
|  [ Upstream Provider Dispatch (OpenAI / Anthropic / Local API) ]                         |
|         |                                                                               |
|         +---------------------------------------+---------------------------------------+
|         |                                       |                                       |
|         v (Synchronous Fast Path)               |                                       |
|  [ Client Response Assembly ]                   |                                       |
|         |                                       v (Asynchronous Dual Path)              |
|         v                               +-----------------------------------------------+
|  [ Return Payload to App ]              |                                               |
|                                         v (Lossy Ring Buffer)   v (Durable Outbox)      |
|                                    [ Operational Metrics ]  [ Compliance Audit Store ]  |
|                                    (Drops on Congestion)    (Durable / Replayable)      |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
自定义内部韧性管道
开发自定义基础设施使工程团队能够完全控制网络策略、数据净化和路由策略。组织可以构建适合其确切内部微服务拓扑的边缘代理。
// 参考实现:具有分数余数和有界饱和度的同步令牌桶
package com.example.ai.resilience;

import java.math.BigInteger;
import java.time.Duration;

public final class TokenBucketLimiter {
    private final long maxTokenCapacity;
    private final long refillPeriodNanos;
    private long availableTokens;
    private long lastRefillNanos;
    // [0, refillPeriodNanos) 范围内的缩放余数分子
    private long scaledRemainder;

    public TokenBucketLimiter(long maxTokens, Duration refillPeriod) {
        if (maxTokens <= 0 || refillPeriod.isZero() || refillPeriod.isNegative()) {
            throw new IllegalArgumentException("TokenBucketLimiter 的边界配置无效。");
        }
        this.maxTokenCapacity = maxTokens;
        this.refillPeriodNanos = refillPeriod.toNanos();
        this.availableTokens = maxTokens;
        this.lastRefillNanos = System.nanoTime();
        this.scaledRemainder = 0L;
    }

    public synchronized boolean tryAcquire(long requestedUnits) {
        if (requestedUnits <= 0) {
            return false;
        }
        refillTokens();
        if (requestedUnits > availableTokens) {
            return false;
        }
        availableTokens -= requestedUnits;
        return true;
    }

    private void refillTokens() {
        long nowNanos = System.nanoTime();
        long elapsedNanos = nowNanos - lastRefillNanos;

        if (elapsedNanos <= 0) {
            return;
        }

        // 单调推进基准时间戳
        this.lastRefillNanos = nowNanos;

        // 如果桶已经满了,则丢弃未消耗的小数字段信用以防止时间漂移
        if (this.availableTokens >= this.maxTokenCapacity) {
            this.scaledRemainder = 0L;
            return;
        }

        long wholePeriods = elapsedNanos / refillPeriodNanos;
        long remElapsedNanos = elapsedNanos % refillPeriodNanos;

        // 快速路径:如果已经过去了至少一个完整周期,桶将完全恢复到满容量。
        // 这消除了乘法溢出表面 (wholePeriods * maxTokenCapacity)。
        if (wholePeriods > 0) {
            this.availableTokens = maxTokenCapacity;
            this.scaledRemainder = 0L;
            return;
        }

        // 在子周期微小间隔下,使用 BigInteger 算术计算精确的Token小数部分
        BigInteger bigRemNanos = BigInteger.valueOf(remElapsedNanos);
        BigInteger bigCapacity = BigInteger.valueOf(maxTokenCapacity);
        BigInteger bigRemainder = BigInteger.valueOf(scaledRemainder);
        BigInteger bigPeriod = BigInteger.valueOf(refillPeriodNanos);

        // totalWork = (remElapsedNanos * maxTokenCapacity) + scaledRemainder
        BigInteger totalWork = bigRemNanos.multiply(bigCapacity).add(bigRemainder);
        BigInteger[] divAndRem = totalWork.divideAndRemainder(bigPeriod);

        long tokensGenerated = divAndRem[0].longValue();
        this.scaledRemainder = divAndRem[1].longValue();

        if (tokensGenerated > 0) {
            long spaceLeft = maxTokenCapacity - availableTokens;
            if (tokensGenerated >= spaceLeft) {
                this.availableTokens = maxTokenCapacity;
                this.scaledRemainder = 0L;
            } else {
                this.availableTokens += tokensGenerated;
            }
        }
    }
}
然而,内部开发需要持续的工程维护。团队必须手动适应提供商的 API 更新,处理多个供应商不断演变的速率限制,并管理分布式遥测队列。这种维护开销可能会将内部开发人员的资源从核心产品功能上转移开。
商业网关与基础设施工具
为了避免从头开始构建这些功能,许多企业部署了托管 API 代理、LLM 网关和边缘控制平面。一些托管网关提供具有供应商感知能力的速率限制协调、可观测性、策略控制和缓存感知路由;具体功能因供应商而异,并且前缀优化通常仍需要应用级别的请求纪律。
商业平台允许工程团队强制执行每个环境的成本配额,在模型系列之间配置自动故障转移路由,并在记录请求元数据之前剥离敏感的客户信息。专为特定目的构建的网关可管理并发峰值、审计 API 消费趋势,并在复杂的应用程序环境中保护下游微服务。
决策矩阵:内部管道与托管平台
| 评估标准 | 内部韧性工具 | 托管路由基础设施 |
|---|---|---|
| 前期开发工作量 | 高(3-6 个工程周) | 低(通过标准 API 集成) |
| 协议维护 | 持续的团队责任 | 由供应商更新处理 |
| 运营控制 | 完全的堆栈可见性 | 受限于供应商接口 |
| 提示词缓存调优 | 需要自定义代理 | 视供应商而定;通常需要应用程序配合 |
| 遥测隔离 | 自定义队列管理 | 视供应商而定 |
| 财务成本剖析 | 工程薪资开销 | 经常性 SaaS / 使用费 |
集成检查清单与治理日程表
在 GPT-6 Sol 和 Luna 降价后扩大模型使用规模的组织可以使用此运营框架来防止系统性过载:
+-----------------------------------------------------------------------------------------+
|                  ENTERPRISE LLM INFRASTRUCTURE READINESS CHECKLIST                      |
+-----------------------------------------------------------------------------------------+
| [ ] Audit client applications to identify unbounded recursive model calling loops       |
| [ ] Set hard timeout limits and non-linear retry backoffs with randomized jitter        |
| [ ] Implement local and edge token-bucket rate limiters ahead of upstream calls          |
| [ ] Organize prompt structures to maximize prompt caching prefix reuse                   |
| [ ] Separate lossy operational telemetry from durable, replayable audit trails           |
| [ ] Add runtime sampling to strip raw prompt bodies from high-frequency traces          |
| [ ] Monitor HTTP 429 status trends and set automated backpressure triggers              |
| [ ] Configure cost alerts and circuit breakers to catch runaway automated jobs          |
+-----------------------------------------------------------------------------------------+
遥测管道配置
可观测性系统必须将提示词日志记录与实时请求路径解耦。在处理高频智能体工作负载时,应用程序应将遥测元数据写入内存有界的异步队列,如果下游遥测收集器变慢,则可以防止 I/O 停顿。
// 参考实现:带有有损负载卸载的内存有界遥测日志记录器
package com.example.ai.resilience;

import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.BlockingQueue;
import java.util.concurrent.atomic.AtomicLong;

public final class BoundedTelemetryQueue {
    public static final class LogPayload {
        public final String traceId;
        public final String modelId;
        public final long promptTokens;
        public final long completionTokens;
        public final boolean cacheHit;

        public LogPayload(String traceId, String modelId, long pTokens, long cTokens, boolean hit) {
            this.traceId = traceId;
            this.modelId = modelId;
            this.promptTokens = pTokens;
            this.completionTokens = cTokens;
            this.cacheHit = hit;
        }
    }

    private final BlockingQueue<LogPayload> internalQueue;
    private final AtomicLong droppedEvents = new AtomicLong(0);

    public BoundedTelemetryQueue(int maxQueueCapacity) {
        if (maxQueueCapacity <= 0) {
            throw new IllegalArgumentException("队列容量必须为正数。");
        }
        this.internalQueue = new ArrayBlockingQueue<>(maxQueueCapacity);
    }

    public boolean recordEvent(LogPayload payload) {
        if (payload == null) {
            return false;
        }
        // 非阻塞提交:在负载下丢弃遥测以维护应用稳定性
        boolean accepted = internalQueue.offer(payload);
        if (!accepted) {
            droppedEvents.incrementAndGet();
        }
        return accepted;
    }

    public LogPayload pollEvent() {
        return internalQueue.poll();
    }

    public long getDroppedEventCount() {
        return droppedEvents.get();
    }
}
常见问题 (FAQ)
GPT-6 Sol 和 Luna 的官方 API 费率是多少?
提示词缓存如何降低长对话的成本?
为什么更便宜的 Token 会增加后端运营风险?
给工程团队的核心要点
GPT-6 Sol 和 Luna 的推出加速了一个更广泛的趋势:前沿智能正变得越来越便宜、越来越容易获得。随着单元 Token 成本急剧下降,财务限制不再是软件架构的有效控制机制。
随着组织采用高频智能体和多层模型拓扑,运营工程对于企业成功变得至关重要。团队必须超越仅通过名义 Token 价格或基准分数来评估模型的阶段。长期的可靠性将取决于系统管理并发、对齐提示词上下文以进行缓存复用、优雅地处理上游速率限制以及将遥测与关键应用程序路径解耦的有效性。构建弹性基础设施的组织将在不牺牲应用程序正常运行时间或系统稳定性的情况下,成功扩展其自动化智能体工作流。
主要来源与参考文档
-
OpenAI 开发者 API 定价参考:官方开发者费率卡、上下文窗口限制(≤272K 标准阈值)以及 GPT-6 Sol、Luna 和 Astra 的缓存读/写定价时间表。
-
OpenAI 社区公告:确认相对于 GPT-6 促销层级实现 50% 基准价格下调以及里程碑式推出细节的公开披露。
-
OpenAI 提示词缓存规范:关于服务器端键值前缀复用、缓存写入开销和配置失效规则的架构文档。
-
Anthropic Claude Opus 5.5 平台规范:确认 4 美元输入 / 20 美元输出 / 0.20 美元缓存读取 Token 费率以及基准性能的官方发布规范。
-
Anthropic Claude Sonnet 5 概述:官方开发者费率卡和提示词缓存效率指标(2 美元输入 / 10 美元输出 / 缓存最高 90% 折扣)。
-
Google AI 开发者费率卡:Gemini 3.8 Flash 的开发者费率卡和介绍性定价政策概述。
-
小米 MiMo 官方 API 定价与费率表:MiMo-V2.6-Pro 推理的正统海外按需付费 Token 费率(0.435 美元输入 / 0.87 美元输出 / 0.0036 美元缓存命中)。
-
VentureBeat 关于 GPT-6 Sol 和 Luna 基准测试的报道:涵盖发布经济学、永久定价保证以及 AutomationBench 1.0.6 任务成本数据(每个尝试任务 0.27 美元)。
Share this article



