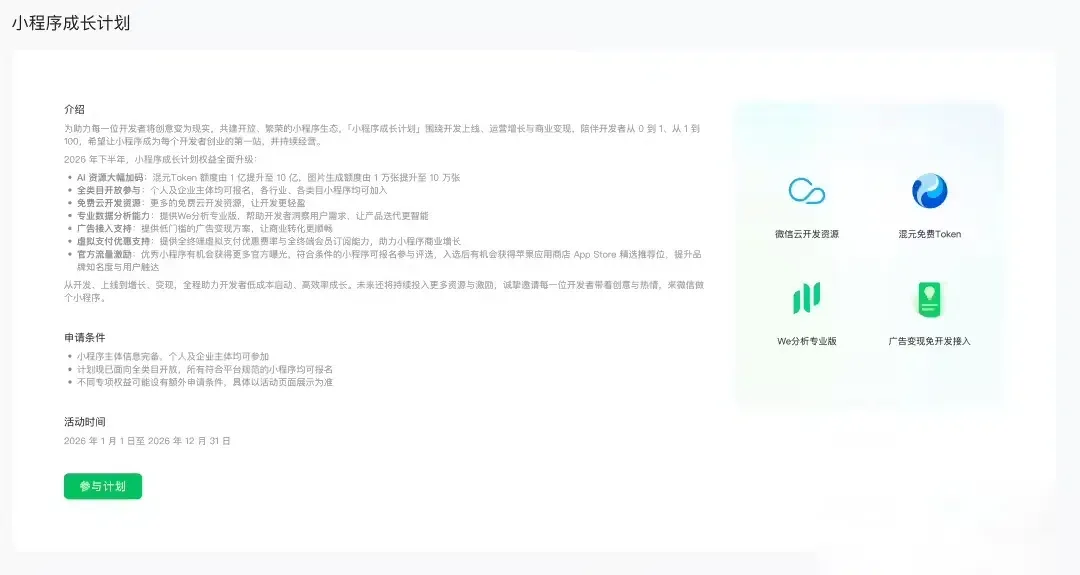
 微信 AI 小程序迎来扩容?腾讯近期宣布推出全新的开发者扶持计划,提供十亿免费混元文本 Token 以及十万次图像生成额度,旨在进一步降低智能客户端应用的开发门槛。通过削减 API 成本并简化基础模型的接入流程,腾讯致力于加速 AI 功能在微信小程序生态中的落地,同时减轻开发者的基建负担。如今,各类 AI 平台越来越多地将高算力需求任务分配至可信的第三方云环境中,这使得明确的用户授权和透明的路由机制显得尤为重要。随着这些平台在外部架构中处理日益复杂的生成式任务,建立安全的多云验证通道已成为保障用户信任的关键。
为什么微信 AI 小程序正进入大规模应用阶段
概览
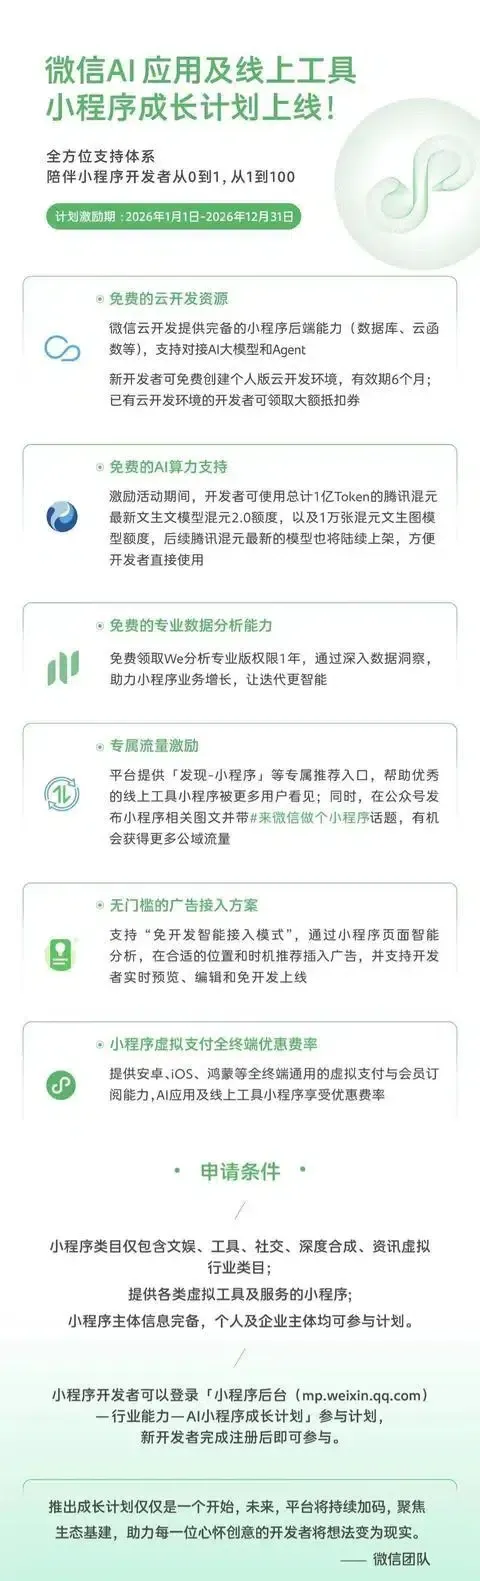
- 腾讯开发者计划将基础额度提升至此前水平的十倍,在六个月有效期内提供十亿文本 Token 和十万次图像生成额度。
- 所有行业皆可申请,无行业类别限制,个人开发者账户与企业认证主体均可领取资源。
- 升级后的端点可自动将存量项目切换至更现代的推理模型,简化了跨 Serverless 节点的代码维护工作。
去中心化微型应用的生态正经历一场重要的运行模式变革。过去,将大规模神经网络能力集成到轻量化客户端应用中,往往需要巨大的先期投入和繁杂的技术栈搭建。小型团队和个人开发者不得不应对复杂的 API 网关、沉重的计费账单以及棘手的密钥配置。这些技术壁垒曾长期制约开发者在设计中嵌入高级生成式功能,导致产品大多止步于简单的规则驱动型。
现在,开发微信 AI 小程序的开发者无需经过复杂的企业认证即可注册个人账户。平台运营商通过提供海量的免费 Token 资源,打破了此类财务瓶颈。开发者只需根据官方平台指南建立 Serverless 环境,即可通过标准云 SDK 快速完成模型配置。该资源包支持自动升级至最新的腾讯混元生成式模型,让应用无需依赖外部中间件即可进行个性化绘图与深度文本互动。
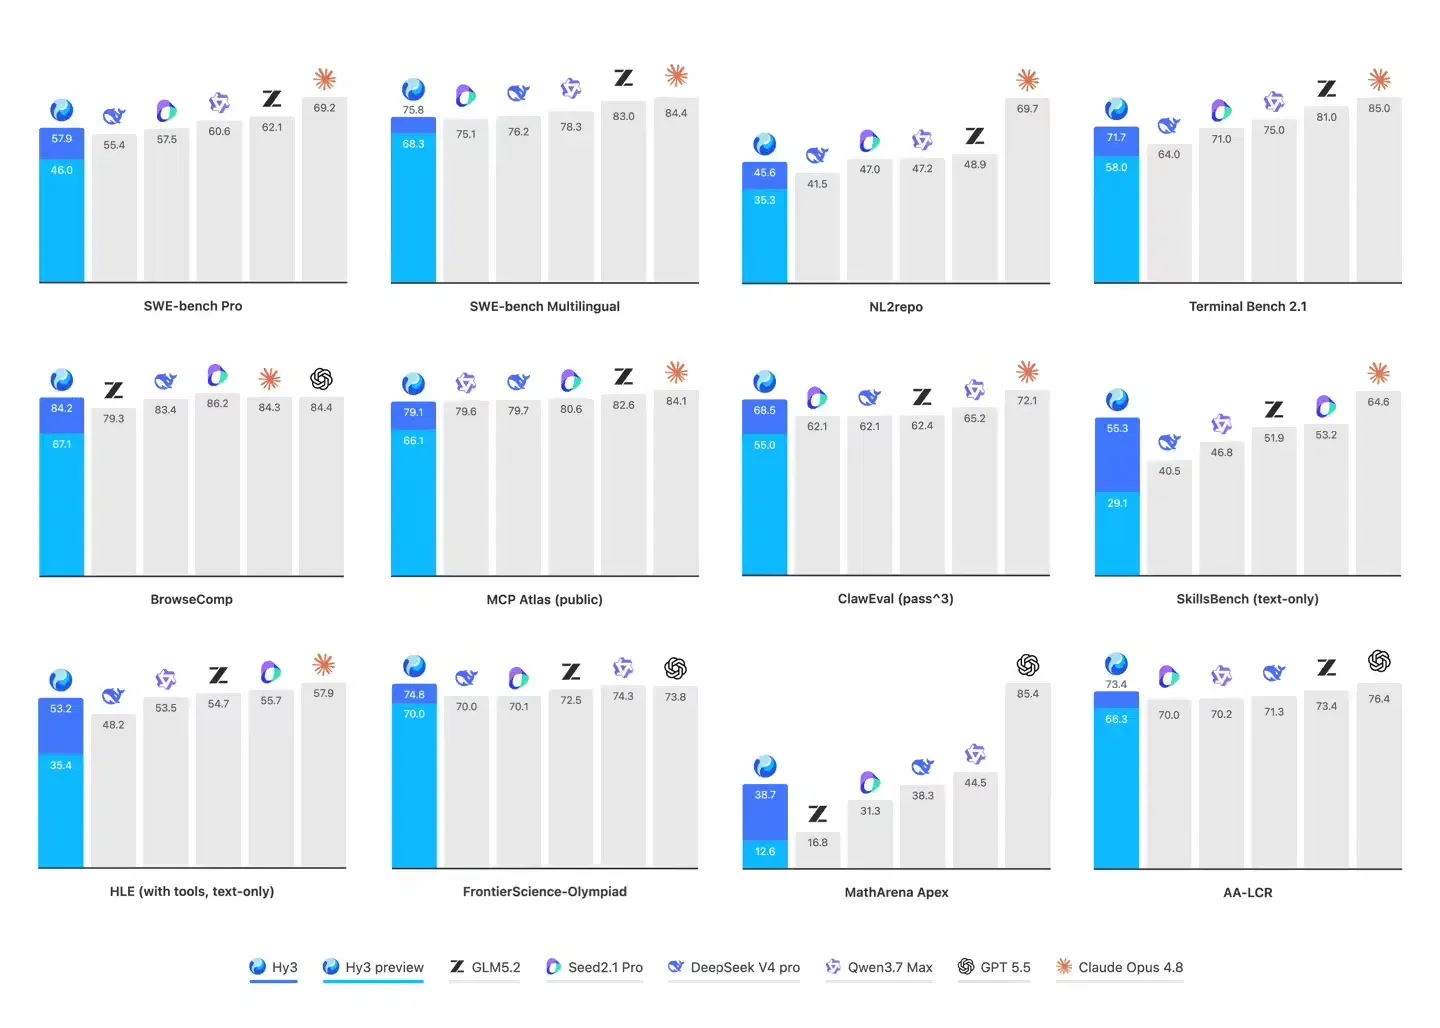
微信 AI 小程序计划为集成云资源与客户端应用建立了一条可靠的路径。在此更新框架下,平台提供对旧版应用的自动后向兼容,将活跃连接平滑迁移至更新后的端点。获取现代资源无需手动配置环境。通过提供大额分配方案,该计划确保开发者能将精力聚焦于产品体验与转化路径,而非实时监控用量仪表。
技术深度解析:解构 CloudBase MCP 与 Serverless AI 工作流
在系统层面,在沙箱消息环境中实现服务端模型处理需要高度安全且符合标准的连接。通过 Model Context Protocol (MCP) 部署微信 AI 小程序,开发者可以与 Serverless 后端进行安全通信。通过引入 MCP,开发者能够将标准集成开发环境安全连接至云平台,从而通过自然语言提示词实现自动代码部署与资源配置。
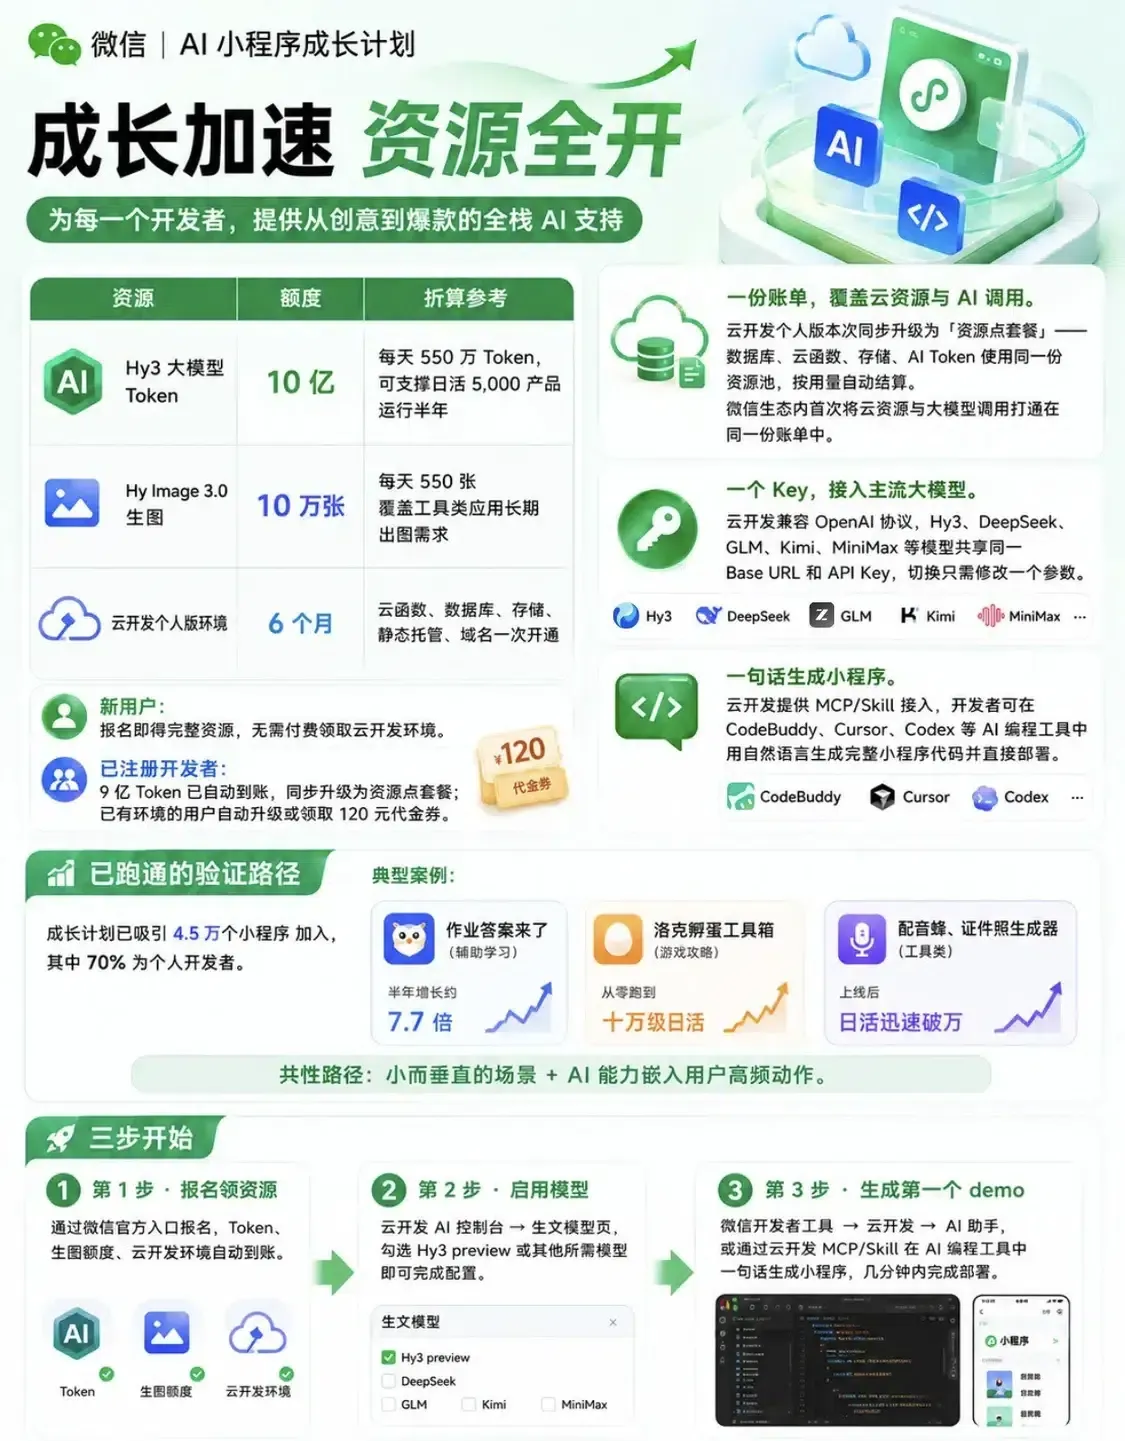
这些集成通过标准 API 封装器进行配置,实现了本地环境与云网络之间的数据顺畅传输,相关指南详见API 接入文档。在此模型下,系统在隔离沙箱内执行服务端调用,以防止用户凭证遭外部截获,从而为微信 AI 小程序的部署建立了一套安全协议。
技术辨析:Serverless 端点 vs. 本地上下文处理
从架构视角看,Serverless API 执行与标准本地处理存在显著差异。当应用利用云函数执行模型查询时,它将繁重的神经网络计算从终端 CPU 卸载到了远程弹性容器中。然而,这种混合架构需要谨慎的请求处理机制,以防提示词膨胀和延迟激增。
下图展示了典型集成式云执行循环的流程:
[开发者 IDE] ──(自然语言提示词)──> [CloudBase MCP 服务器]
                                                     │
                                                     ▼
[微信小程序] ──(API 调用: Server SDK) ──> [Serverless 云函数] ──> [混元 Hy3 引擎]
当云函数触发推理请求时,它会将用户提示词与系统指令集一并传输至腾讯混元模型集群。为了防止不必要的资源消耗,Serverless 层必须进行瞬态数据处理,确保内存针对高并发请求实现优化。在移动端数据统计领域也存在类似的挑战,轻量级参数透传框架同样旨在消除冗余的网络层查询。通过在 API 层优化数据传输路径,开发团队可以在不触发服务器超时限制的情况下实现交互功能的横向扩展。
构建还是采购:服务端集成与计算资源管理
随着平台鼓励快速开发客户端 AI 应用,如何在分布式云环境中管理计算资源结构已成为核心工程决策。支持微信 AI 小程序的高吞吐路由管道,需要能够安全关联用户行为且不依赖本地存储容器的架构。开发者需要抉择是自建开源模型托管环境,还是采购标准化的云服务。
架构评估:自建定制模型 vs. 标准化 SDK
在私有服务器基础设施上构建内部模型托管系统虽然能提供完全的定制化,但却需要持续投入大量资金与维护资源。开发者必须手动管理 GPU 供给、实施扩展规则并配置复杂的安全证书。相比之下,利用由混元推理端点驱动的托管云 API 服务,消除了后端复杂性,确保了可预测的运行成本与自动化的弹性伸缩能力。
下表评估了高性能数据管道的标准部署策略:
| 解决方案 | 上下文管理 | 可扩展性 | 适用场景 |
|---|---|---|---|
| 自建 AI 基础设施 | 完全定制的内存控制 | 需要手动负载均衡 | 需要极致参数控制和数据隔离的大型企业项目 |
| 自管理开源模型 | 瞬态/本地持久化 | 受主机硬件限制 | 小规模原型设计与离线开发沙箱评估 |
| 腾讯云 CloudBase 托管 AI | 会话持续性 (通过 OpoInstall) | 自动弹性容器 | 高并发移动应用与多平台渠道精准营销归因 |
尽管自定义数据库配置可以处理基础上下文,但专业化的服务端状态保留技术能够优化开发资源。根据实现需求,组织可以选择自研服务端会话管理系统或采用如 OpoInstall 等商业平台。例如,OpoInstall 提供了服务端状态恢复与参数透传框架,将会话元数据映射至服务端会话数据库,从而在匿名状态下维持高并发条件下的会话持续性,并支持可扩展的服务端请求处理。通过将会话元数据映射至中心化数据库而非依赖浏览器重定向,该系统确保了即使在初始任务以匿名方式执行时,转化上下文依然保持一致。工程团队可以评估这些方案,以平衡数据安全与效果测量的准确性。
集成清单:优化 Serverless AI 部署
为确保用户在平台托管工具与原生应用环境之间跳转时数据链路不中断,开发团队必须实施稳健的状态保留工作流。部署与维护微信 AI 小程序需要一套结构化的 API 用量指标管理方案。
[资源分配阶段]
  开发者控制台 ──> Token 分发 ──> 阈值检查 (80% / 90% 预警)
                                                     │
                                                     ▼
[路由阶段]
  接收请求 ──> 签名验证 ──> 活跃会话缓存 ──> 模型执行
开发者实施清单
- 审核 Token 使用情况:配置本地遥测系统,记录提示词长度与 Token 消耗指标。
- 实施无状态会话握手:将系统依赖迁移至服务端会话状态恢复机制,利用签名 Token 进行跨平台数据传递。
- 采用提示词优化策略:精简系统提示词并限制历史消息长度,防止 Token 预算过早耗尽。
产品与增长策略清单
- 监控额度消耗:设置自动化预警,当 Token 使用量达到特定阈值(如 80% 或 90%)时触发提醒。
- 升级旧版模型端点:在弃用前将现有客户端配置迁移至更新后的推理端点(如
hy3)。 - 优化移动端推广转化链路:实施统一的服务端参数透传,将微型程序行为与原生应用体验进行联动。
通过建立这些结构化指南,开发团队能够将应用迁移至更安全、更合规的架构中,同时保持运营的连续性。
常见问题解答 (FAQ)
开发者如何领取 10 亿免费混元文本 Token?
Hy3 迁移包含哪些关键技术升级?
CloudBase MCP 如何将 AI 工具与微信 Serverless 函数连接?
工程团队的关键要点
随着 AI 平台日益依赖混合云推理,开发者需要围绕隐私、透明授权与安全数据路由重新设计产品。演进中的数据架构要求我们必须改变数字体验的构建与测量方式。随着无状态代理与无头爬虫成为网页内容的主要消费者,传统的客户端归因模型将持续失效。仅依赖标准 Cookie 和来源信息已不足以保护支撑用户获客的数据链路。
随着腾讯通过 CloudBase 和微信小程序扩大对混元模型的接入能力,那些能够优化 Token 用量、采用 Serverless 部署并设计高效 AI 工作流的开发者,将能在降低运营成本的同时,更好地构建可扩展的 AI 应用。
Share this article



