Wie identifiziert man gefälschte In-App-Events im Conversion-Tracking? Die Identifizierung erfordert den Abgleich ereignisspezifischer Latenz-Baselines mit Rohdaten-Zeitstempeln, die Nutzung von Authentifizierungsstatus der Sicherheitslayer und das Filtern verdächtiger Ausführungsmuster in den Ingestion-Streams.
Betrug durch gefälschte In-App-Events tritt auf, wenn automatisierte Skripte, manipulierte App-Instanzen oder nicht authentifizierte API-Payloads ungültige oder synthetische Conversion-Signale an Attributionsserver übermitteln. Durch die Prüfung der rohen Ereignistelemetrie, die Etablierung empirischer Latenz-Baselines für die Zeit zwischen Klick und Ereignis (Click-to-Event-Time, CTET) und die Auswertung von Authentifizierungsentscheidungen spezialisierter Sicherheitslayer können Technik-Teams ungültige Ereignisströme klassifizieren und filtern, bevor diese in Mess- oder Optimierungsfeeds gelangen.
| Begriff | Definition | Zugehörige Entität | Suchabsicht |
|---|---|---|---|
| Conversion-Tracking | Die systematische Protokollierung und Verarbeitung von User-Milestones nach der Installation. | Rohdatenstrom | Informativ / Technisch |
| Click-to-Event-Time | Eine abgeleitete Metrik zur Messung der Latenz zwischen Touchpoint und Ereigniseingang. | Ereignis-Anomalie-Engine | Technisch / Informativ |
| Anzeigenbetrug | Die gezielte Manipulation von Leistungsmetriken durch nicht-menschlichen Traffic oder manipulierte Payloads. | In-App-Event-Spoofing | Informativ / Sicherheit |
Anatomie von gefälschtem In-App-Event-Betrug in Tracking-Pipelines
Der wirtschaftliche Anreiz: CPA-Event-Auszahlungen vs. CPI-Install-Arbitrage
Leistungsbasierte Marketingkampagnen für Mobilgeräte basieren häufig auf Cost-Per-Action (CPA)-Modellen, bei denen Publisher nur dann Einnahmen erzielen, wenn ein akquirierter Nutzer definierte Milestones erreicht. Diese Meilensteine nach der Installation – wie der Abschluss einer Registrierung, ein Onboarding, der Start eines Abonnements oder ein erster In-App-Kauf – sind wesentlich höher vergütet als einfache App-Installationen.
Diese Finanzstruktur schafft starke Anreize für böswillige Akteure, Interaktionen nach der Installation zu simulieren. Statt große Mengen minderwertiger App-Downloads zu erzeugen, emulieren automatisierte Skripte gezielt hochwertige Conversion-Milestones, um CPA-Provisionen abzugreifen. Wenn eine Ingestion-Pipeline diese manipulierten Ereignisse ungeprüft akzeptiert, zahlen Werbetreibende Provisionen für nicht existierende Aktivitäten aus und überbewerten leistungsschwache Traffic-Quellen.
Bedrohungsvektoren: Nicht authentifizierte S2S-API-Anfragen, modifizierte Clients und automatisierte Skripte
Betrügerische In-App-Events gelangen primär über drei technische Vektoren in die Tracking-Pipelines:
- Direktes API-Spoofing: Angreifer untersuchen den Netzwerkverkehr mobiler Apps mittels Proxy-Tools, um Ingestion-Endpunkte, HTTP-Header-Anforderungen und JSON-Payload-Parameter zu identifizieren. Bei schwach authentifizierten Integrationen senden automatisierte serverseitige Skripte synthetische Ereignisanfragen direkt an die Endpunkte, ohne eine App zu starten oder Client-seitigen Code auszuführen.
- Modifizierte App-Binärdateien: Angreifer dekompilieren, ändern und repaketen Anwendungsdateien, um interne Kontrollen zu umgehen oder automatisierte Ereignis-Dispatching-Schleifen einzuschleusen. Diese modifizierten Clients laufen auf physischen Geräten oder in Virtualisierungsumgebungen und generieren gültige OS-Telemetrie bei gleichzeitiger automatisierter Ereignisausführung.
- Emulator- und Skript-Automatisierung: Virtualisierte Mobilumgebungen führen automatisierte Instanzen aus, die von UI-Skript-Frameworks gesteuert werden. Obwohl der Anwendungscode innerhalb eines echten Betriebssystemprozesses abläuft, spiegeln Interaktionssequenzen, Eingabegeschwindigkeit und Ausführungslatenz automatisierte Skripte wider und nicht echtes menschliches Verhalten.

Die Grenze des Bedrohungsmodells: Warum Client-seitige symmetrische Secrets keine Legitimität garantieren
Eine kritische Sicherheitseinschränkung beim mobilen Conversion-Tracking ist die Annahme, dass die Einbettung eines geteilten symmetrischen Schlüssels (wie ein HMAC-Secret) in eine App-Binärdatei die Authentizität des Payloads garantiert. In Standard-Bedrohungsmodellen für Mobilgeräte laufen Clients in einer unsicheren Umgebung. Angreifer können clientseitige symmetrische Schlüssel durch statisches Reverse Engineering, dynamische Speicherprüfung oder Runtime-Hooking extrahieren.
Wie im OWASP Mobile Application Security Testing Guide (MASTG) hervorgehoben, können symmetrische kryptografische Schlüssel, die innerhalb von Apps gespeichert sind, kompromittiert werden, was es Angreifern ermöglicht, gültige Message Authentication Codes (MACs) für beliebige gefälschte Payloads zu generieren. Folglich bieten clientseitige Schlüssel nur eine Verteidigung in der Tiefe gegen einfache Manipulationen; sie dienen nicht als absolute Vertrauensbasis gegen hochentwickeltes SDK-Spoofing.
Um robuste Anfragen-Authentizität zu erreichen, setzen moderne Architekturen auf plattformspezifische Attestierungsmechanismen:
- Google Play Integrity: Standard-Anfragen geben von der Plattform ausgestellte Integritäts-Token zurück, die kryptografisch über
requestHashan die Anfragedaten gebunden werden können, inklusive automatischer, von Google verwalteter Replay-Protection. - Apple App Attest: Nutzt ein attestiertes, gerätegeneriertes Schlüsselpaar, server-seitige Einmal-Challenges und signierte Client-Assertions, die gegen Assertions-Zähler geprüft werden, um Anfragen an eine validierte App-Instanz zu binden.
Entscheidend ist, dass diese Dienste zwar plattformbasierte Beweise zur Integrität der Binärdatei, des Gerätestatus oder der Anfragen-Bindung liefern, aber keiner dieser Mechanismen beweist, dass die zugrunde liegende Conversion tatsächlich von einem echten menschlichen Nutzer ausgeführt wurde.
Downstream-Kontamination: Wie ungültige Event-Postbacks Ad-Network-Bidding-Algorithmen verzerren
Über unverdiente Publisher-Auszahlungen hinaus beeinträchtigt ungeprüftes Event-Spoofing die Optimierung programmatischer Kampagnen. Programmatische Anzeigenplattformen nutzen Conversion-Postbacks in Echtzeit, um automatisierte Bidding-Algorithmen wie App Event Optimization (AEO) oder Target Cost-Per-Action (tCPA) zu trainieren.
Ungültige Conversion-Signale können die Qualität der Optimierungseingaben verschlechtern, wenn Partner-Bidding-Systeme diese Conversions konsumieren. Die detaillierten Bidding-Feedback-Mechanismen und Budgetallokationsdynamiken werden in Artikel #68 behandelt. Das Filtern oder Zurückhalten von unzulässigen Ereignissignalen reduziert die Exposition ungültiger positiver Signale gegenüber nachgelagerten Optimierungssystemen.
Definition von Click-to-Event-Time als ereignisspezifische Latenzmetrik
Definition des Latenz-Deltas: CTET entspricht Event-Eingangszeit minus Klick-Zeitpunkt
In diesem Artikel wird die Click-to-Event-Time (CTET) operativ über den Zeitpunkt des Servereingangs definiert und stellt die Latenz zwischen Klick und Ereigniseingang dar, nicht die exakte physische Ausführung durch den Nutzer. Mathematisch wird die CTET für ein Ereignis
Hierbei stellt
Unterscheidung zwischen serverautoritativen Zeitstempeln und clientseitigen Uhren
Eine genaue Latenzbewertung erfordert die strikte technische Trennung zwischen client-seitig gemeldeten Zeitstempeln (
Das Vertrauen allein auf client-gemeldete Zeitstempel ermöglicht es Spoofing-Skripten, beliebige historische Zeitstempel einzuschleusen, sodass ein automatisiertes Ereignis so aussieht, als hätte es Stunden oder Tage nach einem Ad-Klick stattgefunden. Ingestion-Gateways müssen sofort nach Erhalt der HTTP-Anfrage einen unveränderlichen Server-Zeitstempel (
Umgang mit Offline-Ereigniswarteschlangen: Unterscheidung von Batch-Uploads und Echtzeitanomalien
Apps, die für unterbrochene Konnektivität entwickelt wurden, speichern Ereignisse lokal zwischen, wenn kein Netzwerkzugriff besteht. Sobald die Verbindung wiederhergestellt ist, lädt der Client die gesammelte Telemetrie in einem Batch hoch.
Wenn eine Attributions-Engine Batch-Events strikt gegen den Server-Zeitstempel (
Bewertung des Latenz-Umfangs: Erstinstallationen vs. Re-Engagement
Der analytische Umfang der CTET hängt vom Attributionskontext ab. Bei der Neukundengewinnung spiegelt
Da Retargeting Store-Downloads und OS-Installationsprozesse umgeht, ist die Basislatenz für In-App-Aktionen nach dem Klick deutlich kürzer als bei Akquise-Workflows. Anomalie-Engines müssen ihre Basismodelle dynamisch an den Kampagnentyp anpassen, um zu verhindern, dass legitime Retargeting-Conversions als Anomalien klassifiziert werden.
Technischer Rahmen für empirische CTET-Latenz-Audits
Ingestion unverarbeiteter Telemetrieströme für die Baseline-Kalibrierung
Der Aufbau eines effektiven CTET-Anomalie-Frameworks erfordert die Ingestion nicht aggregierter Telemetrie. Client-SDKs übermitteln Ereignisauslöser zusammen mit dem Sitzungskontext an Edge-Ingestion-Gateways.
Teams können die aktuelle OpoInstall-Dokumentation für verfügbare Attributions- und SDK-Integrationsfunktionen heranziehen; die hier skizzierten Pipelines und Strukturen stellen Referenzarchitekturen und empfohlene Implementierungsmuster dar, keine verbindlichen Produktions-API-Verträge.
Etablierung ereignisspezifischer und kampagnenkalibrierter Latenzverteilungen
Menschliche Interaktionen mit Apps erzeugen variable Latenzmuster, abhängig vom Ereignis-Meilenstein. Die Registrierung eines Kontos erfordert typischerweise weniger Zeit als der Abschluss einer Identitätsprüfung oder das Erreichen eines hohen Levels.
Anstatt willkürliche, universelle Latenzschwellen zu erzwingen, müssen Teams empirische Latenz-Baselines für jeden Ereignistyp festlegen. Diese Baselines werden durch die Analyse historischer Conversion-Verteilungen innerhalb validierter, risikoarmer Kohorten für spezifische Kampagnentypen und geografische Regionen berechnet.
Empirisches Modell zur Latenz-Baseline-Kalibrierung:

Verteilung der CTET in der policy-konformen Referenz-Kohorte (heterogene Latenzstreuung):
Volumen |        /\
        |       /  \
        |      /    \________  (Empirische Quantilverteilung)
        +-----------------------------------> Zeitverlauf

Unnatürliche Latenz-Cluster (Potenzieller Indikator für Automatisierung):
Volumen |   |      |      |
        |   |      |      |
        |   |      |      |    (Statische Intervall-Spikes: Zur Prüfung markiert)
        +-----------------------------------> Feste Zeitintervalle
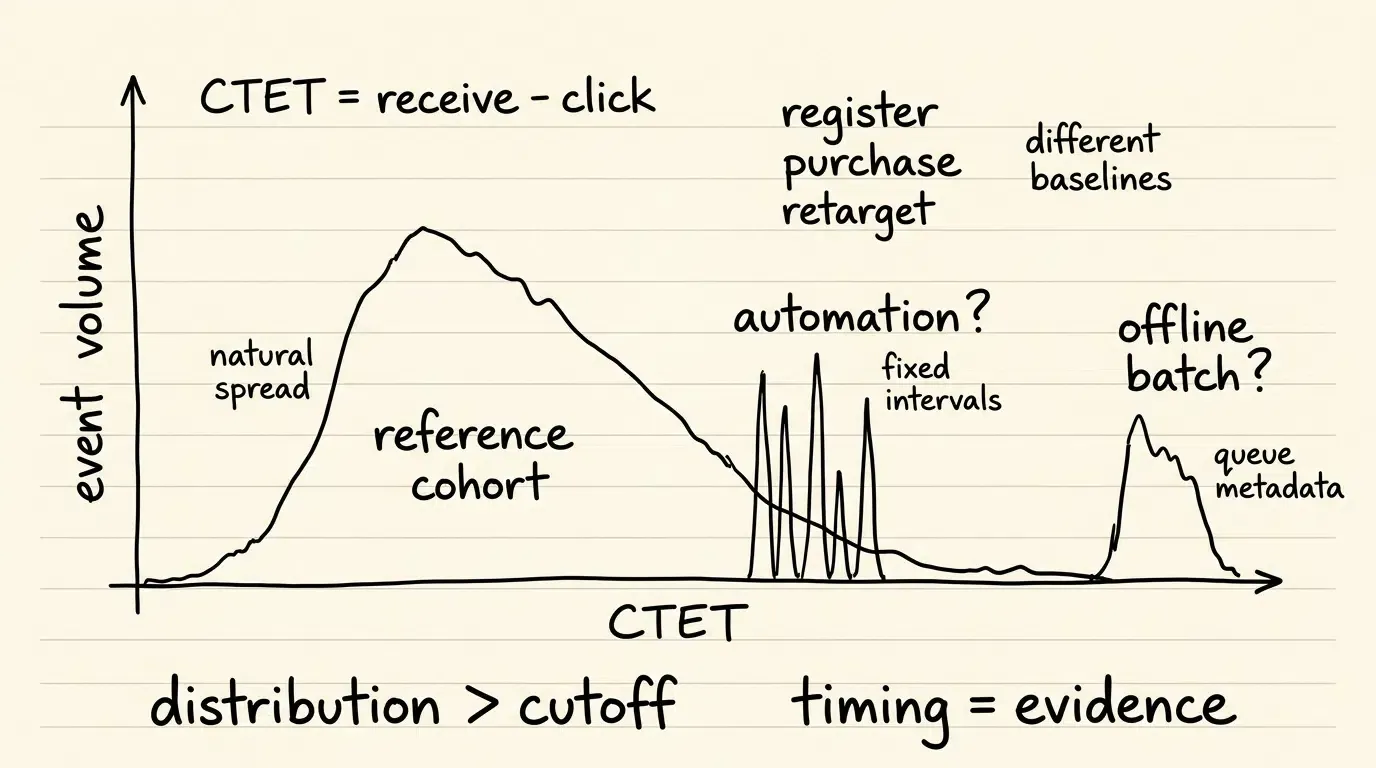
Behandlung von Latenzabweichungen als diagnostisches Indiz
Ein Ereignis, das in ein ungewöhnlich frühes Quantil oder einen Bereich geringer Wahrscheinlichkeit der kalibrierten Baseline fällt, bedarf einer Untersuchung. Anstatt Gauß-Verteilungen anzunehmen oder Werte unter dem Baseline-Mittelwert pauschal als Anomalien zu behandeln – was einen Großteil legitimen Traffics abdecken würde – bewerten Produktionssysteme empirische untere Quantile oder robuste standardisierte Residuen.
Automatisches Hard-Blocking ausschließlich auf Basis eines statischen Zeit-Cutoffs riskiert den Verlust legitimer Nutzer mit schnellen Verbindungen oder solchen, die One-Tap-Authentifizierungen abschließen. Latenz-Scores sollten ein gewichteter diagnostischer Faktor innerhalb einer Multi-Metrik-Engine sein, kein definitiver Beweis für Betrug.
Visualisierung der Ingestion-, Verifizierungs- und Dispositionspipeline
Das Arbeitsablauf-Diagramm unten illustriert, wie rohe Telemetriedaten durch die Edge-Ingestion fließen, mit Sicherheits-Inputs interagieren, Latenz gegenüber Baselines evaluieren und die Richtlinienentscheidung ausführen:
[Anzeigeninteraktion-Klick erfasst (T_click)] ──> [In-App-Ereignis tritt ein]
             │                                            │
             ▼                                            ▼
  Server-protokollierter Zeitstempel                 Client sendet Event-Anfrage
             │                                            │
             └──────────────────────┬─────────────────────┘
                                    │
                                    ▼
                       [Edge Ingestion-Gateway]
                                    │
                                    ├─► Ingest-Sicherheitsentscheidung (Artikel #65)
                                    │   (Authentifizierungsstatus, App Attest / Play Integrity)
                                    │
                                    ├─► Latenz-Audit-Engine (Artikel #69)
                                    │   (Berechnung CTET-Delta vs. kalibrierte Baseline)
                                    │
                                    ▼
               [5-Layer Event-Disposition-Referenzmodell]
                                    │
                  ┌─────────────────┴─────────────────┐
                  ▼                                   ▼
  [Policy-konforme Disposition]       [Anomale Disposition]
  (Erfasst & Postback-berechtigt)     (Markiert, unterdrückt oder verworfen)
Integration geteilter Sicherheitsverifizierungen und Replay-Resistenz
Nutzung von Authentifizierungsentscheidungen aus Sicherheitslayern
Authentifizierungs- und Replay-Schutz-Kontrollen sollten durch den gemeinsamen Ingestion-Sicherheitslayer implementiert werden (siehe Artikel #65). Dieser Artikel verwendet den resultierenden Verifizierungsstatus als Eingabewert für das Ereignis-Risiko.
Anstatt kryptografische Verifizierung, Nonce-Speicherung oder Replay-Schutz innerhalb der Latenz-Engine zu duplizieren, konsumieren Conversion-Pipelines Upstream-Sicherheits-Flags. Diese architektonische Trennung stellt sicher, dass Transportsicherheit und kryptografische Integrität von der funktionalen Geschäftslogik entkoppelt bleiben.
Adressierung von Limitierungen bei clientseitiger Schlüsselspeicherung: Fokus auf Plattform-Integritäts-Assertions
Da clientseitige symmetrische Schlüssel keine Immunität gegen Reverse Engineering garantieren können, verlassen sich moderne Mobilarchitekturen auf Plattform-Attestierungs-Frameworks.
Google Play Integrity Standard-Anfragen bieten plattformseitige Integritäts-Token, die via requestHash an Anfragedaten gebunden werden, während Apple App Attest attestierte Instanz-Schlüssel, Server-Challenges und signierte Assertions nutzt. Beide Mechanismen liefern plattformgestützte Sicherheitsbeweise, aber keiner beweist die menschliche Natur der Conversion. Die detaillierte Implementierung von Payload-Signierung, Schlüssel-Lebenszyklusmanagement und Replay-Abwehr wird in Artikel #65 behandelt.
Für Client-SDK-Builds mit standardmäßigen Telemetriekontrollen können Technik-Teams die SDK-Integrationsressourcen konsultieren.
Strukturierung des 5-Layer-Event-Disposition-Schemas
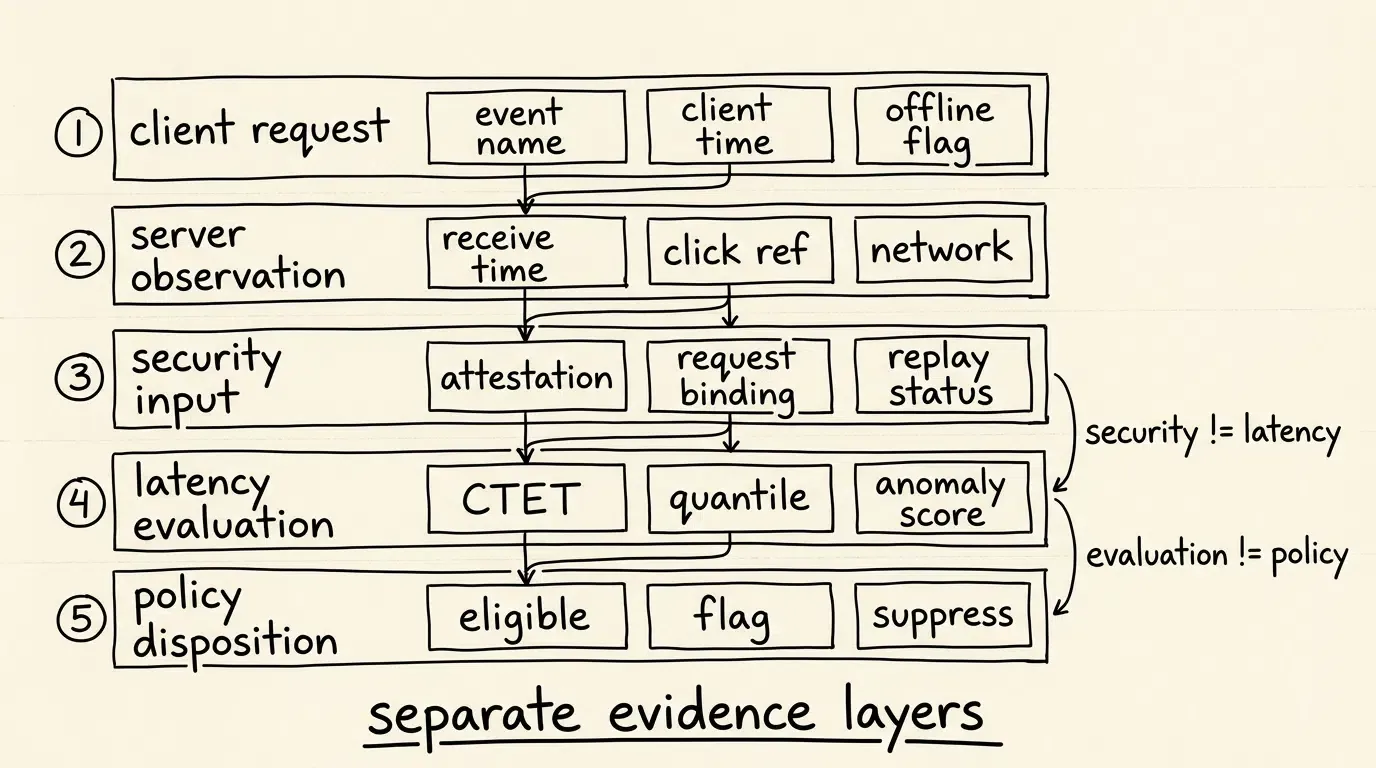
Um die Auditierbarkeit und technische Trennung zwischen Client-Telemetrie, Server-Beobachtungen, Sicherheits-Inputs, Latenzbewertungen und Richtlinienentscheidungen sicherzustellen, sollten Ereignisdatensätze einem strukturierten 5-Layer-Referenzschema folgen.
Der Platzhalter unten illustriert einen Ereignis-Verifizierungsdatensatz, bei dem jede Phase der Analyse-Pipeline für ein Plattformziel sauber isoliert ist:
{
  "reference_architecture": true,
  "event_disposition_record": {
    "layer_1_client_request": {
      "platform": "Android",
      "app_id": "com.example.application",
      "client_event_id": "evt_checkout_99812",
      "event_name": "checkout_completed",
      "event_value_cents": 1999,
      "currency": "USD",
      "client_reported_timestamp_ms": 1785985965120,
      "session_token": "sess_8832a10c-58cc-4372-a567-0e02b2c3d479",
      "offline_queued_flag": false
    },
    "layer_2_server_observation": {
      "server_authoritative_timestamp_utc": "2026-08-06T03:12:45.120Z",
      "ingestion_edge_node_id": "edge_us_east_04",
      "click_reference_timestamp_utc": "2026-08-06T03:10:00.000Z",
      "network_asn": "AS7018",
      "request_ip_classification": "residential_isp"
    },
    "layer_3_security_layer_input": {
      "security_layer_article_reference": "Artikel #65",
      "platform_integrity_evaluation_status": "verified_platform_integrity",
      "attestation_provider": "google_play_integrity",
      "attestation_verdict": "MEETS_DEVICE_INTEGRITY",
      "request_binding_status": "matched_request_hash",
      "replay_protection_mode": "play_integrity_standard_managed",
      "derived_replay_risk_status": "low_risk"
    },
    "layer_4_latency_evaluation": {
      "baseline_model_type": "empirical_quantile_model",
      "calculated_ctet_seconds": 165.12,
      "empirical_quantile_rank": 0.42,
      "illustrative_baseline_mean_seconds": 180.0,
      "illustrative_baseline_stddev_seconds": 45.0,
      "latency_anomaly_score": 0.08,
      "latency_evaluation_verdict": "within_expected_distribution_range"
    },
    "layer_5_policy_disposition": {
      "attribution_decision_source": "upstream_attribution_engine",
      "disposition_state": "policy_eligible_and_processed",
      "attribution_status": "attributed_to_click",
      "ad_network_postback_eligible": true,
      "reason_codes": [
        "PLATFORM_INTEGRITY_CHECK_PASSED",
        "CTET_LATENCY_NORMAL"
      ]
    }
  }
}
Ausführung von Edge-Dispositionsrichtlinien: Still Drop, Audit-Markierung und selektive Unterdrückung
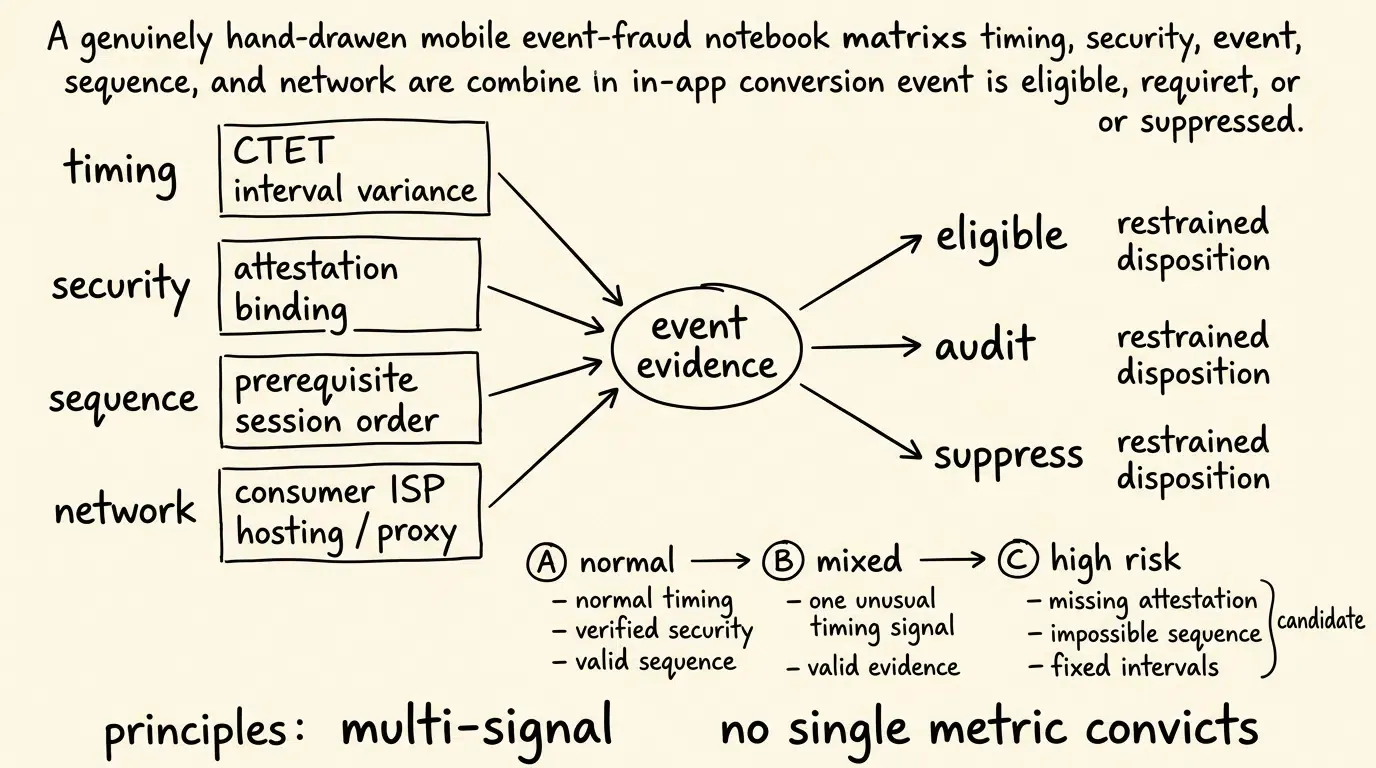
Sobald ein Event-Payload durch die Disposition-Engine ausgewertet wurde, wendet das System eine von drei primären Richtlinien an:
- Policy-konform und verarbeitet: Das Ereignis erfüllt die Latenz-Baseline-Kriterien und besitzt einen verifizierten Sicherheitsstatus. Es wird in Datenbanken protokolliert und ist für nachgelagerte Berichte oder Partner-Postbacks berechtigt.
- Zur Prüfung markiert: Das Ereignis weist leichte zeitliche Abweichungen oder einen ungewöhnlichen Netzwerkkontext auf, besitzt aber einen gültigen Sicherheitsstatus. Es wird im Dashboard zur Prüfung markiert, und Ad-Network-Postbacks können abhängig von Partner-Konfigurationen zurückgehalten werden.
- Unterdrückt oder verworfen: Das Ereignis besteht Integritätsprüfungen nicht oder weist Anomalien mit hoher Konfidenz oder unmögliche Sequenzzustände auf. Die Anfrage wird an der Edge verworfen, um eine Verschmutzung der Datenbank zu verhindern.
Ereignis-Anomalieindikatoren und empirische Bewertungsmatrix
Multidimensionale Telemetrie: Bewertung von Latenz, Netzwerkkontext und Sicherheitssignalen
Eine präzise Anomalieerkennung erfordert die gleichzeitige Auswertung mehrerer Telemetrie-Dimensionen. Die Kombination von Latenz-Deltas mit Netzwerkinfrastruktureigenschaften und Sicherheitsurteilen minimiert Falschmeldungen, während sie gleichzeitig komplexe automatisierte Spoofing-Versuche identifiziert.
Konfiguration diagnostischer Indikatoren für Anomalie-Untersuchungen
Die unten stehende Matrix skizziert wichtige Telemetrie-Indikatoren, potenzielle Anomaliesignale und diagnostische Aktionen für Conversion-Tracking-Pipelines:
| Telemetrie-Dimension | Erwartetes Baseline-Signal | Potenzieller Anomalie-Indikator | Diagnostische Aktion |
|---|---|---|---|
| CTET Latenz-Delta | Innerhalb empirischer Quantile | Beobachtete Latenz liegt im anomalen unteren Bereich | Markieren für CTET-Audit; Offline-Batch-Status prüfen |
| Authentifizierungsstatus | Verifiziert via Plattform-Attestierung / S2S-Schlüssel | Nicht verifizierte Signatur oder fehlende Attestierung | Als unauthentifiziert markieren; ggf. ablehnen |
| Intervall-Varianz | Natürliche Streuung über Sitzungen hinweg | Unnatürliche Spike-Cluster bei exakten Intervallen | Auf automatisierte Timer-Schleifen prüfen |
| Netzwerkkontext | Verteilt über Consumer-ISPs | Konzentrierte Hosting- oder Proxy-Infrastruktur | Mit Netzwerk-Intelligenz-Signalen kreuzverweisen |
| Sequenzlogik | Gefolgt von logischen Voraussetzungen (z.B. Install) | Conversion ohne vorherige Sitzung | Als Waisen-Event-Payload flaggen; Attributionskette prüfen |
Zeitpunkt der Anwendung automatisierter Filter- und Dispositionsrichtlinien
Eignung für automatisierte Filterung
Automatisierte Filterregeln bieten unter folgenden operativen Bedingungen den höchsten Schutzwert:
- Aktive Cost-Per-Action (CPA)-Kampagnen: Marketingprogramme, die monetäre Auszahlungen für Post-Install-Milestones bieten, welche Zielscheibe von Spoofing-Skripten sind.
- Programmatische Optimierungs-Pipelines: Kampagnen, die Ereignissignale an Ad-Network-Auto-Bidding-Algorithmen zurückführen, wo ungültige Signale die Bieter-Modelle verzerren können.
- Ingestion-Architekturen mit hohem Volumen: Umgebungen, in denen manuelle Audits bei großen Ereignismengen nicht durchführbar sind.
Ungeeignete Bedingungen für aggressives Hard-Blocking
Aggressives, automatisiertes Hard-Blocking ohne empirische Kalibrierung kann zu Problemen führen:
- Neu veröffentlichte Apps oder Funktionen: Anwendungen ohne historische Baseline-Daten, bei denen starre Latenzregeln legitime frühe Nutzerinteraktion falsch klassifizieren könnten.
- Offline-First App-Umgebungen: Anwendungen, die legitime Nutzerereignisse bei Offline-Nutzung lokal zwischenspeichern und beim Wiederverbinden in Batches hochladen.
Häufige Fallstricke beim Conversion-Anomalie-Management
- Fallstrick 1: Verlass auf einen universellen Latenz-Cutoff: Ein statisches Zeitlimit über alle Kampagnen hinweg erzeugt Fehlalarme. Latenz-Baselines müssen ereignis- und kampagnenspezifisch kalibriert werden.
- Fallstrick 2: Annahme, dass symmetrische Client-Schlüssel Sicherheit garantieren: Das Speichern eines HMAC-Secret-Keys in einer App-Binärdatei verhindert SDK-Spoofing nicht, da Angreifer diese mittels Reverse-Engineering-Tools extrahieren können. Hochsichere Verifizierung erfordert Plattform-Integritäts-Assertions und serverseitige Validierung.
Häufig gestellte Fragen (FAQ)
Wie umgehen gefälschte In-App-Events einfaches clientseitiges Conversion-Tracking?
Warum sollten Latenzschwellen eher empirisch als über fixe Cutoffs etabliert werden?
Wie schützt die ereignisbasierte Anomalie-Filterung die Bidding-Signale der Werbenetzwerke?
Zusammenfassung und Entscheidungsrahmen
Die Identifizierung und Filterung gefälschter In-App-Events erfordert einen empirischen, mehrschichtigen diagnostischen Rahmen und nicht das Vertrauen auf Client-Secrets oder statische Latenz-Cutoffs. Der Schutz von Conversion-Datenpipelines beruht auf der Trennung von Client-Request-Payloads von server-autoritativen Zeitstempeln, der Nutzung robuster Authentifizierungsentscheidungen durch dedizierte Sicherheitslayer und dem Audit von Ereignislatenzen gegen empirisch kalibrierte Baselines.
Da sich mobile Ökosysteme weiterentwickeln, müssen Technik-Teams Ingestion-Architekturen bereitstellen, die Plattform-Integritäts-Assertions validieren, während sie die saubere Trennung zwischen Sicherheit, Zeitbewertung und Richtliniendurchsetzung beibehalten. Die Integration empirischer Baseline-Prüfungen mit strukturierten Dispositionsregeln ermöglicht es Mobil-Apps, saubere Conversion-Datensätze zu erhalten und das Vertrauen in die ROAS-Messung zu stärken.
Um zu bewerten, wie Rohdaten-Audits und Anomalie-Evaluation Ihre Infrastruktur absichern können, lesen Sie die Dokumentation zum mobilen Conversion-Tracking, konsultieren Sie unsere Referenz zur Implementierung mobiler Attribution oder loggen Sie sich in die OpoInstall-Entwicklerkonsole ein, um verfügbare Kontrollen zur Betrugsüberwachung und Anomalie-Berichterstattung zu prüfen.
Verwandte Materialien
-
Konzepte: Click-to-Event-Time, abgeleitete Latenz-Metriken, In-App-Event-Spoofing, Richtlinien zur Ereignis-Disposition
-
Technologien: Ingestion roher Telemetriedaten, Plattform-Integritäts-APIs, 5-Schichten-Ereignisschemata, Anomalie-Engine
-
Standards: RFC 2104 HMAC-Spezifikation & Shared-Secret-Limits, OWASP MASTG Kryptografie-Prüfrichtlinien
-
APIs: Ereignis-Ingestion-Schnittstellen (Referenzarchitektur), Google Play Integrity Standard Requests, Apple App Attest API
-
Offizielle Dokumentationen & Referenzen:
Share this article



