GitHub kündigt Copilot Fusion an? GitHub hat am 28. Oktober 2026 offiziell die allgemeine Verfügbarkeit von Copilot Fusion bekannt gegeben und damit einen Laufzeit-Modell-Router und -Orchestrator eingeführt, der mehrere KI-Modelle für Softwareentwicklungsufträge koordiniert. Das System wurde auf der jährlichen GitHub Universe Konferenz in San Francisco vorgestellt und verlagert die Modellauswahl weg von einzelnen Entwicklern, sodass die Plattform die Anforderungen von Aufgaben analysieren und Arbeit dynamisch an verschiedene Basismodelle delegieren kann. Da Softwareentwicklungsteams mit steigenden API-Kosten und kognitiver Erschöpfung durch das ständige Umschalten zwischen verschiedenen Frontier-Modellen konfrontiert sind, entwickelt sich die automatisierte Modell-Orchestration zu einem operativen Standardarchitekturmuster.
Zentrale Branchenneuausrichtung: GitHub stellt Copilot Fusion auf der Universe vor
Auf einen Blick
- GitHub hat Copilot Fusion am 28. Oktober 2026 für Visual Studio Code, die Copilot CLI, JetBrains-IDEs und die GitHub Copilot-Desktop-Anwendung allgemein verfügbar gemacht.
- Das System kombiniert eine aus Project HydraFusion abgeleitete Laufzeit-Koordination mehrerer Modelle mit optimierten Algorithmen zur automatischen Modellauswahl.
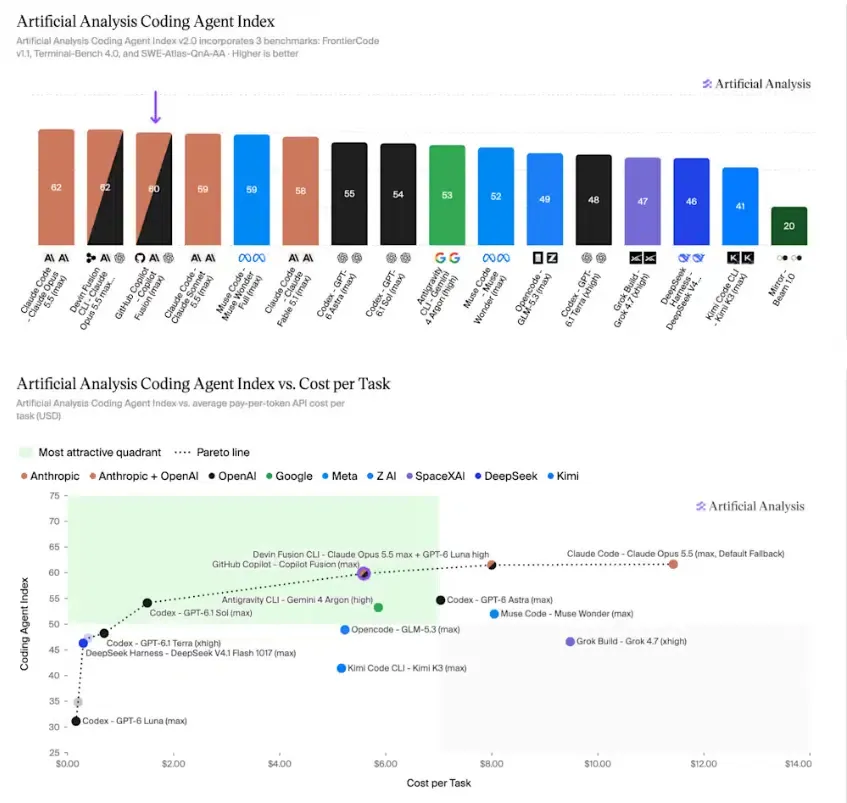
- In unabhängigen Evaluierungen durch Artificial Analysis erreichte Fusion Max einen Gesamtwert von 60 im Coding Agent Index v2.0 und lag damit nur zwei Punkte hinter Claude Code mit Opus 5.5 Max, während die Task-Kosten um ca. 51 % gesenkt wurden.
Softwareentwicklungsteams, die KI-Programmierassistenten einsetzen, haben in der Vergangenheit in einem manuellen Auswahlparadigma gearbeitet. Programmierer wählten ein einzelnes Modell – wie GPT-4o, Claude Sonnet oder ein o1-basiertes Reasoning-Modell – aus einem IDE-Dropdown-Menü aus und behielten diese Auswahl während einer gesamten Coding-Sitzung bei. Zwar ist dies für isolierte Prompts effektiv, doch bringt dieser Ansatz operative Nachteile mit sich. Entwickler wählen häufig teure Frontier-Modelle mit hoher Latenz für komplexe architektonische Planungen und vergessen dann, bei alltäglichen Aufgaben wie dem Generieren von Unit-Tests oder Boilerplate-Dokumentationen wieder auf leichtgewichtige Modelle umzuschalten.
Dieser manuelle Ansatz kann die API-Ausgaben von Unternehmen in die Höhe treiben und Kontext-Token ineffizient verbrauchen. Um diese Workflows zu optimieren, hat GitHub Copilot Fusion entwickelt, wie in der offiziellen GitHub-Ankündigung beschrieben. Anstatt KI-Programmierung als Interaktion mit einem einzigen statischen Modell zu behandeln, fungiert Fusion als Laufzeit-Koordinator. Entwickler legen einen übergeordneten Grad an logischem Denkaufwand fest, und das System wählt autonom das am besten geeignete zugrunde liegende Modell oder eine Kombination von Modellen für jeden einzelnen Schritt einer Aufgabe aus.

Die strategische Neuausrichtung der Veröffentlichung von GitHub Copilot Fusion konzentriert sich auf die Wirtschaftlichkeit auf Aufgabenbasis und nicht auf reine Parameterskalierung. Laut Benchmarkergebnissen von Artificial Analysis schloss Copilot Fusion Max, getestet über die Copilot CLI im Coding Agent Index v2.0, Programmieraufgaben zu durchschnittlichen Kosten von $5.59 pro Task ab, verglichen mit $11.42 für Claude Code mit Anthropic Claude Opus 5.5 bei maximaler Einstellung. Die evaluierte Konfiguration verbrauchte etwa 7,2 Millionen Token pro Task – etwa die Hälfte des Token-Volumens der eigenständigen Opus-Konfiguration – und erledigte Aufgaben in etwa 40 % kürzerer Zeit.
Die Leistung variierte bei den einzelnen Benchmark-Komponenten: Fusion Max führte bei Terminal-Bench 4.0 mit einer Punktzahl von 71 an, erzielte jedoch 51 bei FrontierCode (hinter den 56 von Claude Code) und 57 bei SWE-Atlas-QnA-AA. Darüber hinaus bezifferte die Microsoft-Führung interne DeepSWE-Evaluierungen, die potenzielle Kosteneinsparungen von bis zu 77 % aufzeigten; dieser Wert stellt jedoch ein separates, vom Unternehmen maximal gemeldetes Szenario dar und keinen unabhängigen Benchmark-Durchschnitt. Diese Ergebnisse bestätigen, dass eine dynamische Multi-Modell-Orchestrierung die Entwicklungskosten für unterstützte Workflows deutlich senken kann, wobei die tatsächlichen Einsparungen von der jeweiligen Aufgabenmischung, den Prüfanforderungen und den Mustern der Unternehmensnutzung abhängen.
Architekturmuster: Ausführungstopologien für Einzel-, Kaskaden- und Kritik-Modi
Copilot Fusion arbeitet nicht als eigenständiges Basismodell. Stattdessen fungiert es als intelligente Steuerungsebene (Control Plane), die in den Entwickler-Client integriert ist. Wenn ein Benutzer eine Anweisung zu Logik, Code-Generierung, Debugging oder Tool-Nutzung übermittelt, gleicht Fusion die eingehenden Absichtssignale mit dem Systemstatus in Echtzeit, der Verfügbarkeit und der semantischen Komplexität ab.
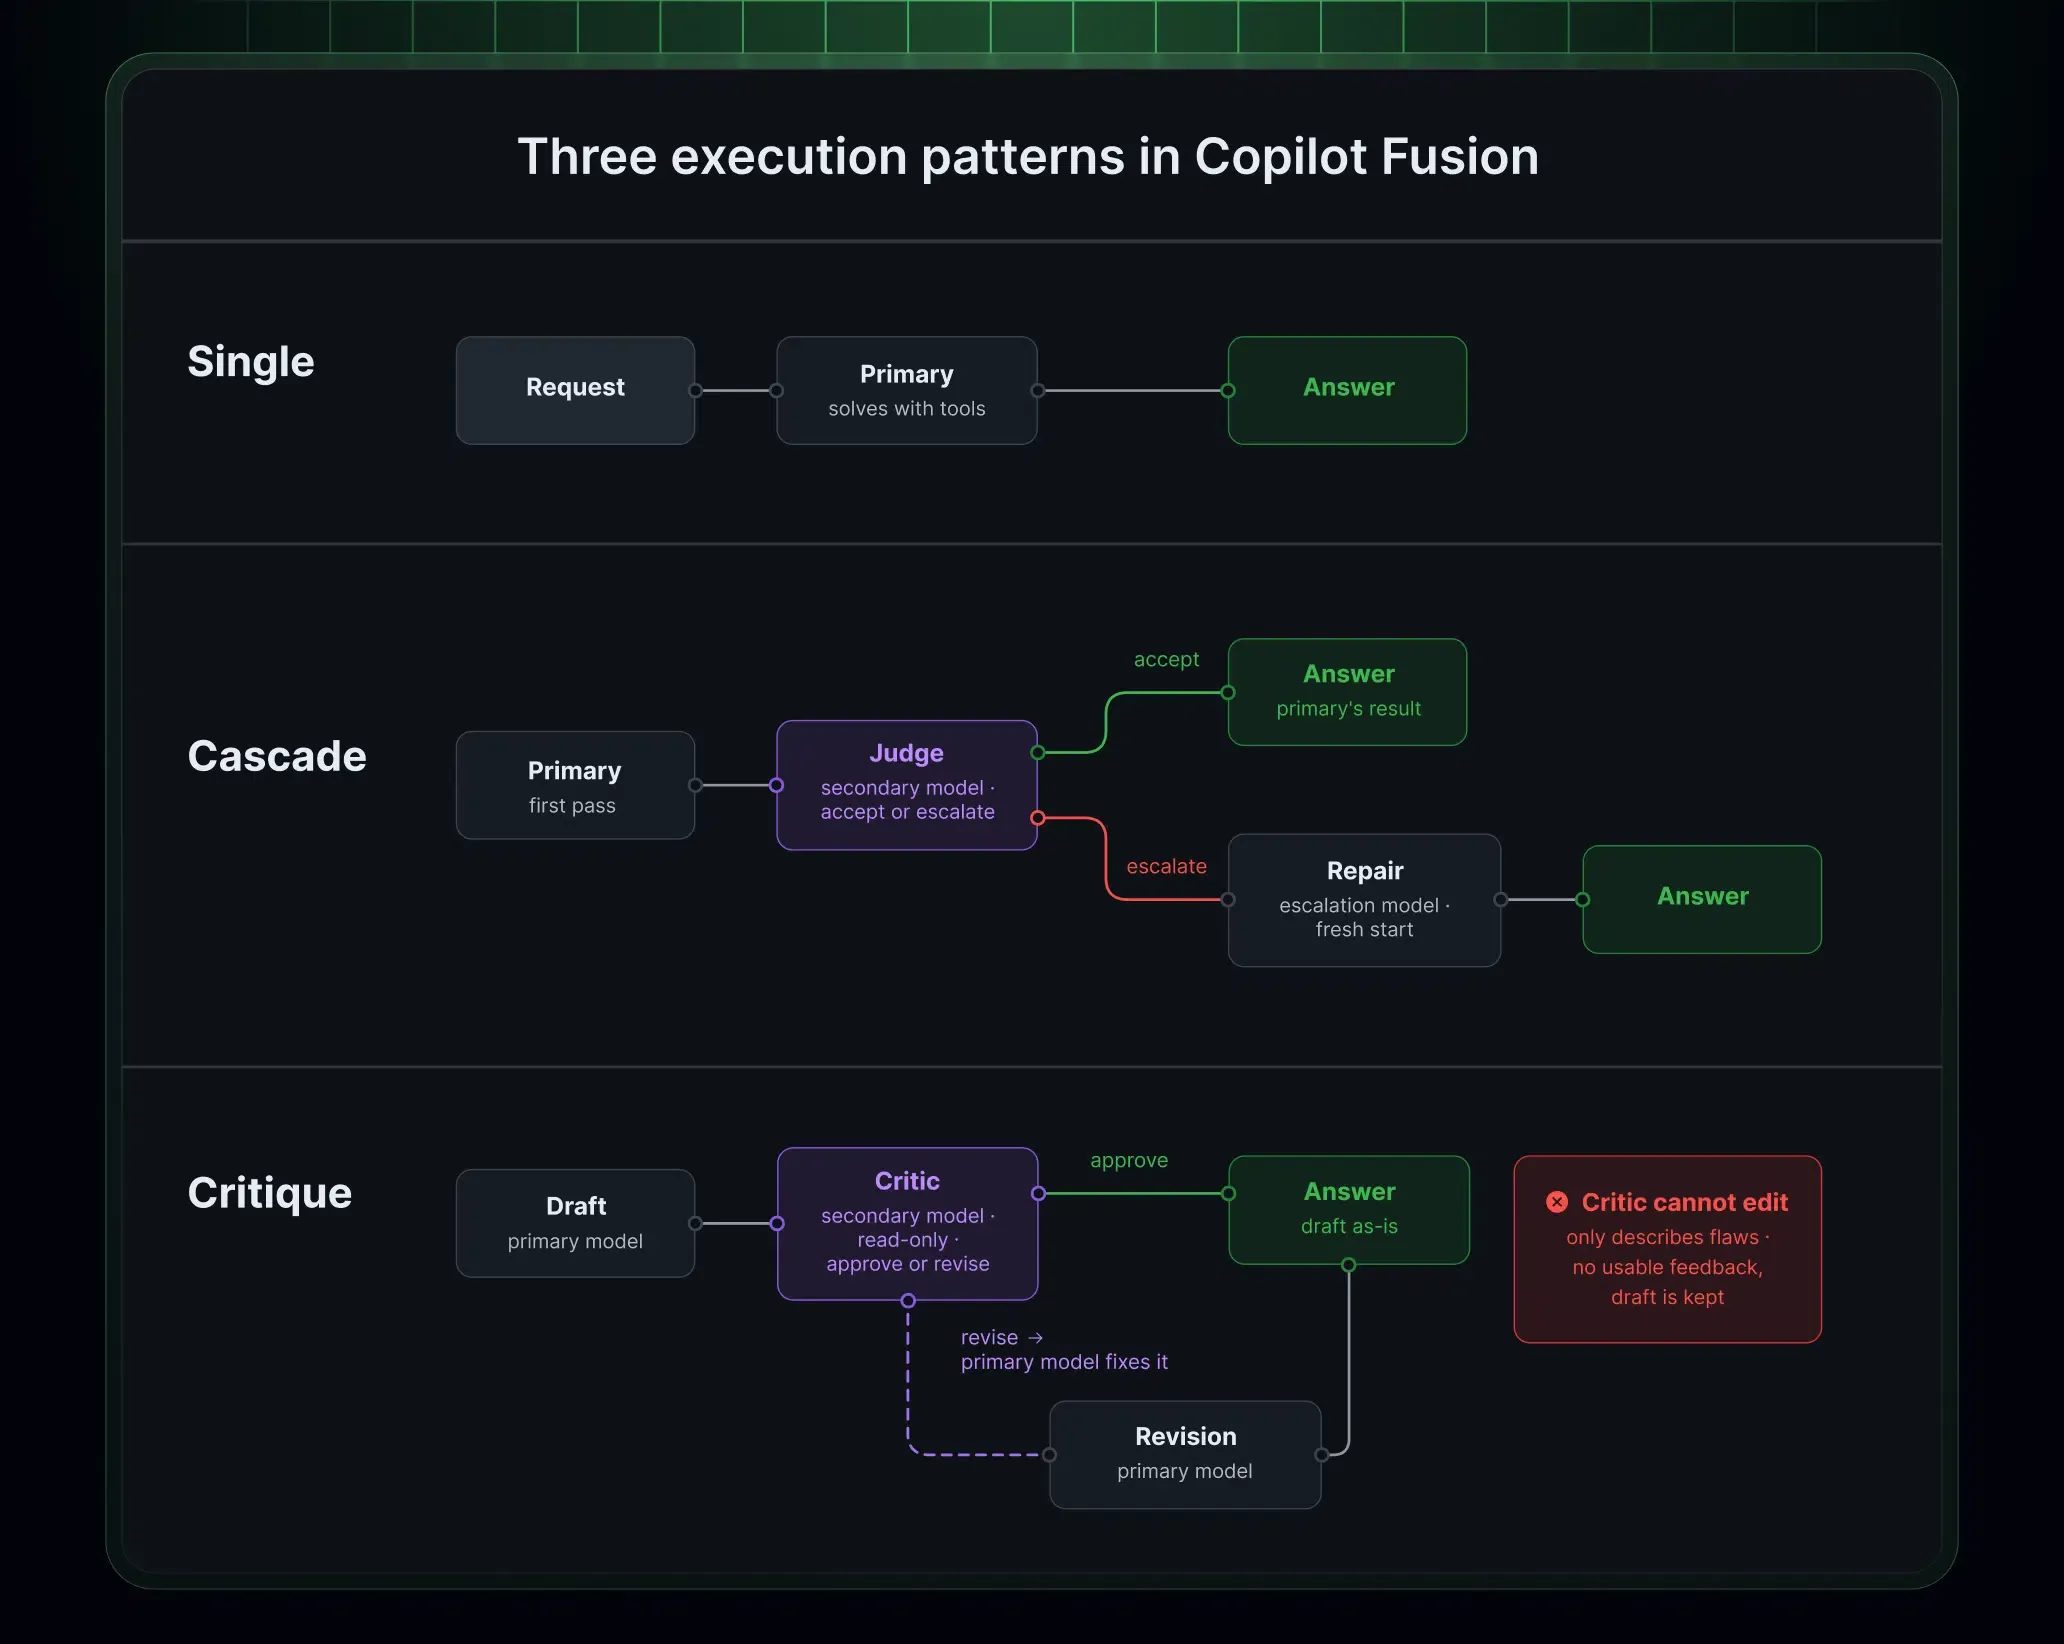
Je nach Aufgabenmerkmalen und der gewählten Aufwandstufe wählt das System dynamisch eines von drei Ausführungsmustern aus:
- Single Pattern: Ein einzelnes Modell erhält den Prompt und schließt die Aufgabe direkt ab, ohne zusätzlichen Überprüfungsaufwand. Dieses Muster eignet sich für unkomplizierte Code-Generierung, syntaktische Abfragen und grundlegende Refactorings.
- Cascade Pattern: Ein leichtgewichtiges Modell entwirft einen ersten Lösungsansatz. Ein sekundäres Beurteilungsmodell (Judge Model) prüft den vorgeschlagenen Code und entscheidet, ob die Ausgabe akzeptiert oder die Aufgabe zur Verfeinerung an ein leistungsfähigeres Modell eskaliert wird.
- Critique Pattern: Ein primäres Modell erstellt einen ersten Entwurf, während ein oder mehrere Prüfmodelle den Code parallel und unabhängig voneinander bewerten. Der Orchestrator fasst deren Feedback zusammen, und das primäre Modell überarbeitet den Code entsprechend, bevor das finale Ergebnis an den Benutzer zurückgegeben wird.
[Single Pattern]
  Prompt ──> Primäres Modell ──> Einzelne Ausführung ──> Finaler Code-Output

[Cascade Pattern]
  Prompt ──> Leichtgewichtiges Modell ──> Erster Entwurf ──> Judge-Modell ──[Akzeptieren]──> Finaler Code-Output
                                                             └──[Eskalieren]──> Stärkeres Modell ──> Finaler Output

[Critique Pattern]
  Prompt ──> Erstellendes Modell ──> Erster Entwurf ──┬─> Reviewer-Modell A ──┐
                                                   └─> Reviewer-Modell B ──┴─> Feedback-Aggregator ──> Finale Revision
Diese Ausführungstopologien bringen klare Kompromisse zwischen Ausführungsgeschwindigkeit, Verifizierungsstrenge und Rechenkosten mit sich. Anstatt Prompts fest an bestimmte Muster zu binden, bildet GitHub diese Arbeitsabläufe über auswählbare Aufwandsstufen ab:
- Fusion Standard: Bringt Kosten, Qualität und Latenz für das tägliche Programmieren ins Gleichgewicht. Die aktuelle Implementierung wählt in der Regel ein Modell pro Aufgabe aus.
- Fusion High: Priorisiert eine stärkere Leistungsfähigkeit und tiefere Logikprüfung für umfangreiche Programmieraufgaben bei gleichzeitiger Berücksichtigung der Token-Effizienz. Wenn gerechtfertigt, kann eine Multi-Modell-Orchestrierung eingesetzt werden.
- Fusion Max: Priorisiert höchste Leistungsfähigkeit für besonders anspruchsvolle Aufgaben, wobei zusätzliche Überprüfungs- oder Eskalationsschritte dort dynamisch gewählt werden, wo es sinnvoll ist.
- Fusion Fast: Eine spezialisierte, für den Benutzer nicht direkt auswählbare Aufwandsstufe, die in unterstützten latenzsensitiven Inline-Chat-Szenarien von Visual Studio Code verwendet wird.
Die Verwaltung von Kontextgrenzen über dynamische Workflows hinweg erfordert eine spezialisierte Speicherverwaltung. Copilot Fusion verfügt über kein eigenes, einheitliches Kontextfenster. Stattdessen arbeitet jeder Ausführungsschritt strikt innerhalb der Kontextlimits des spezifischen Modells, das diesen Teilschritt ausführt. Die in der IDE angezeigte Kontextkapazität spiegelt das konservativste Limit unter den beteiligten Modellen wider. Um zudem die Effizienz des Prompt-Caching zu maximieren, hält Fusion den primären Konversationsthread nach Möglichkeit auf einem einzigen primären Modell und leitet nur die notwendigen, isolierten Kontextfenster an unterstützende Reviewer-Modelle weiter.
Unternehmensgovernance und lokale Modellintegration in Entwickler-Flotten
Die Bereitstellung autonomer Modell-Orchestrierung in großen Ingenieurteams von Unternehmen wirft Fragen zu Governance, Compliance und Budgets auf. Wenn ein KI-System dynamisch zwischen Modellen von Anthropic, OpenAI und anderen Anbietern wechselt, müssen Administratoren sicherstellen, dass die unternehmensinternen Datenhoheits- und Sicherheitsrichtlinien intakt bleiben.
Unternehmensadministratoren können die für Copilot Fusion zugelassenen Modelle über unterstützte GitHub Copilot-Modellrichtlinien und unternehmensgesteuerte Einstellungen verwalten, wie im Copilot Fusion-Administratorhandbuch dokumentiert ist. Administratoren können die Liste der für Fusion verfügbaren Modelle einsehen, Standardaufwandsstufen für Entwickler-Arbeitsplätze festlegen und bestimmte Modelle für Fusion deaktivieren, ohne sie im gesamten Unternehmen abzuschalten. Fusion berücksichtigt die geltenden Abonnements, Organisations-, Datenresidenz-, FedRAMP-bezogenen und Evaluierungsmodell-Beschränkungen. Diese Kontrollen regeln die Berechtigung von Modellen innerhalb des Systems, ersetzen jedoch nicht die unternehmenseigenen Compliance-Prüfungen, Data-Governance- oder Sicherheitsvalidierungsprozesse.
Die folgende Tabelle zeigt, wie verschiedene Ausführungsarchitekturen Ausführungsflächen, Prüfmechanismen und Token-Ausgaben ausgleichen:
| Ausführungsmuster | Primärer Aufruf | Prüfmechanismus | Token-Kostenprofil | Optimal für |
|---|---|---|---|---|
| Single Mode | Ein dediziertes Modell | Keiner | Standard-Preise des Basismodells | Unkomplizierte Code-Änderungen und Syntaxfragen |
| Cascade Mode | Effizientes Entwurfsmodell | Prüfung durch Judge-Modell & Eskalation | Gering bis moderat (bedingte Eskalation) | Klar abgegrenzte Fehlerbehebungen und strukturierte Anpassungen |
| Critique Mode | Primärer Generator | Parallele, unabhängige Reviewer-Modelle | Höher (mehrere gleichzeitige Modellaufrufe) | Komplexe Architekturen und sicherheitskritischer Code |
| Local Model Hybrid | Unterstütztes lokales On-Device-Modell | Cloud-koordinierte Modellauswahl | Reduzierter Cloud-Token-Verbrauch bei lokalen Schritten | Zulässige On-Device-Inferenz mit Cloud-koordiniertem Routing |
GitHub hat ein lokal modellbewusstes Routing als optionale experimentelle Vorschau eingeführt, wie im GitHub Changelog zur lokalen Modellauswahl angekündigt. Bei konfiguriertem lokalen Modell kann Copilot Fusion Standard für berechtigte Aufgaben die On-Device-Inferenz wählen und so die Cloud-Modellnutzung für diese Schritte reduzieren. Auf Windows-Systemen mit kompatibler Hardware können Entwickler MAI Code 1.1 Flash über die Windows ML-Verwaltung innerhalb der Copilot-App, der Copilot CLI oder von Visual Studio Code installieren und ausführen. Plattformübergreifende Nutzer unter Windows, macOS und Linux können lokale Modelle wie Qwen3.8 Flash Next in der Copilot CLI über lokale Modellanbieter wie Ollama konfigurieren, indem sie die CLI mit dem Flag --experimental starten.
Copilot Fusion ist jedoch weiterhin auf Cloud-basierte Routing-Entscheidungen angewiesen, und bei Bedarf können Cloud-Modelle verwendet werden. Die Unterstützung lokaler Modelle macht Copilot Fusion daher nicht zu einer vollständig offline nutzbaren Programmierumgebung; Entwickler, die eine isolierte Offline-Sicherheit (Air-Gapping) benötigen, sollten stattdessen dedizierte Offline-Tools evaluieren.
Engineering-Checkliste: Einführung der Multi-Modell-Orchestration in der Produktion
Die Integration der Multi-Modell-Laufzeit-Orchestration in Softwareentwicklungsworkflows erfordert Anpassungen bei den Entwicklergewohnheiten, den IDE-Konfigurationen und den finanziellen Abläufen im Unternehmen. Die technische Führungsebene muss klare Betriebsprotokolle etablieren, um Token-Ein Effizienzen zu nutzen und gleichzeitig Stolpersteine in den Arbeitsabläufen zu vermeiden.
Checkliste für Entwickler
- Workspace-Diffs vor Commits prüfen: Das Verwerfen eines KI-Entwurfs macht Änderungen an Workspace-Dateien nicht automatisch rückgängig; Entwickler müssen alle nicht commiteden Dateiänderungen überprüfen, bevor sie Code einreichen.
- Aufwandsstufen an die Aufgabenkomplexität anpassen: Reservieren Sie Fusion Max für komplexe algorithmische Logik und Sicherheitsaudits und nutzen Sie Fusion Standard für die tägliche Programmierung, um unnötigen KI-Guthabenverbrauch zu verhindern.
- Multi-Modell-Fortschrittsströme überwachen: Beobachten Sie die IDE-Fortschrittsanzeigen, um nachzuvollziehen, welche spezifischen Modelle zu den generierten Codeblöcken beitragen, und so für Transparenz über die Ausführungsschritte zu sorgen.
- Unterstützte lokale Modelle konfigurieren: Richten Sie für berechtigte Aufgaben unter Fusion Standard unterstützte lokale Modelle wie MAI Code 1.1 Flash unter Windows oder Qwen3.8 Flash Next über Ollama ein und aktivieren Sie bei Bedarf experimentelle Einstellungen.
Checkliste für Unternehmens-Governance und FinOps
- Unternehmensmodellrichtlinien konfigurieren: Legen Sie im Unternehmens-Dashboard fest, welche Modelle für das Fusion-Routing berechtigt sind, und stimmen Sie die Modellliste mit den Compliance- und Datenresidenzanforderungen des Unternehmens ab.
- Nutzungsbasiertes KI-Guthaben überwachen: Verfolgen Sie den teamweiten Guthabenverbrauch über Aufwandsstufen hinweg unter Berücksichtigung der Tatsache, dass die Ausführung mehrerer Modelle in Fusion High und Max pro Aufgabe mehr Guthaben verbrauchen kann als Einzelmodell-Ausführungen.
- Werbe-Abrechnungszeiträume berücksichtigen: Beziehen Sie den 30-prozentigen Aktionsrabatt von GitHub auf die Modellkosten für kostenpflichtige Copilot-Abonnenten bis zum 30. November 2026 bei der Budgetierung ein.
- Menschliche Code-Review-Schleifen etablieren: Behalten Sie obligatorische Peer-Code-Reviews für alle von Agenten generierten Pull Requests bei, um sicherzustellen, dass automatisierte Kritikschleifen die menschliche Entwickleraufsicht ergänzen und nicht ersetzen.
Häufig gestellte Fragen (FAQ)
Wie berechnet GitHub die Abrechnung, wenn Copilot Fusion mehrere Modelle aufruft?
Was passiert, wenn Copilot Fusion einen temporären Code-Entwurf verwirft?
Können Unternehmensadministratoren einschränken, welche Modelle Copilot Fusion auswählt?
Wichtige Erkenntnisse für Engineering-Teams
Die Einführung von GitHub Copilot Fusion bestätigt, dass die Abhängigkeit von einem einzigen monolithischen KI-Modell für komplexe Softwareentwicklungsaufgaben unnötige operative Kompromisse mit sich bringt. Moderne Entwicklungsworkflows umfassen vielfältige kognitive Anforderungen, die von sofortiger Syntaxvervollständigung bis hin zu komplexem repository-übergreifendem Denken reichen. Den gesamten Bereich mit einer einzigen Modellarchitektur abdecken zu wollen, kann zu steigenden Modellkosten oder beeinträchtigter Ausführungsqualität führen.
Unabhängige Benchmarkergebnisse legen nahe, dass eine Multi-Modell-Orchestration bei bestimmten Workloads eine wettbewerbsfähige Programmierleistung zu geringeren Modellkosten liefern kann. Die tatsächlichen Ergebnisse hängen von der Aufgabenkomplexität, dem Orchestrierungsverhalten, den ausgewählten Modellen und den Nutzungsmustern des Unternehmens ab. Durch die Entkopplung der Aufgabenverteilung von manuellen Entwicklerentscheidungen schafft die Laufzeit-Modell-Orchestration einen pragmatischen operativen Weg. Wenn Softwareorganisationen automatisierte Coding-Agenten skalieren, wird das primäre Wettbewerbsdifferenzierungsmerkmal nicht der Zugriff auf ein einzelnes Basismodell sein, sondern die Governance, Zuverlässigkeit und architektonische Strenge der sie verbindenden Orchestrierungsschicht.
Referenzen
-
GitHub: Route and Orchestrate Models with GitHub Copilot Fusion – Offizielle Release-Notes und Funktionsübersicht von der GitHub Universe 2026.
-
GitHub: Copilot Fusion Now Supports Selection of Local Models – Offizielle Ankündigung zur On-Device-Inferenz für berechtigte Aufgaben mit lokalem Modell-Routing.
-
GitHub Docs: About GitHub Copilot Fusion Concepts and Configuration – Offizielle technische Dokumentation zu Ausführungsmustern, Aufwandsstufen und Abrechnungsregeln.
-
GitHub Docs: Configuring Models Available for Copilot Fusion – Administrativer Leitfaden zur Verwaltung von Unternehmensmodellrichtlinien und Standardeinstellungen.
-
Artificial Analysis: GitHub Copilot Fusion Benchmark Evaluation – Unabhängige Analyse zu Task-Kosten, Token-Effizienz und Coding Agent Index-Werten.
-
The New Stack: GitHub Debuts Copilot Fusion Multi-Model System – Technischer Bericht zur Integration von Project HydraFusion und der Implementierung bei Unternehmenskunden.
-
VentureBeat: GitHub Copilot Fusion Mixes Models for Cost Efficiency – Technisches Interview mit der GitHub-Produktleitung zu Laufzeit-Routing-Architekturen.
Share this article