OpenAI und Google unterstützen gemeinsamen Opt-out für KI-Training? OpenAI, Google und Microsoft gaben am 30. Oktober 2026 Pläne bekannt, ein einziges, gemeinsames Richtlinientoken in der robots.txt zu berücksichtigen, mit dem Websitebetreiber ihre Präferenzen für das Training generativer KI-Modelle über mehrere Anbieter hinweg gleichzeitig ausdrücken können. Der vorgeschlagene Mechanismus geht auf einen Internet-Draft zurück, der von Anthropic-Entwickler Kevin Kelley bei der IETF-Arbeitsgruppe für KI-Präferenzen eingereicht wurde. Während die Initiative Herausgebern eine vereinfachte Methode bietet, um Trainings-Opt-outs mithilfe der Standard-Syntax für Allow und Disallow zu deklarieren, bleiben die Implementierungszeitpläne bis 2027 gestaffelt, und jede große Plattform plant, das Signal beim Modelltraining und beim Live-Konversations-Grounding unterschiedlich zu interpretieren und anzuwenden.
Wichtige Branchenausrichtung: Große KI-Labore stimmen sich über Robots.txt-Standards ab
Auf einen Blick
- OpenAI, Google und Microsoft kündigten am 30. Oktober 2026 koordinierte Pläne an, ein gemeinsames robots.txt-Richtlinientoken,
__usage_ai-training, zur Verwaltung von Präferenzen für das Training generativer Modelle zu erkennen. - Das Signal ist in einem Internet-Draft der IETF definiert, der vom Anthropic-Entwickler Kevin Kelley verfasst wurde, und etabliert eine standardisierte Syntax, ohne einen offiziellen oder finalisierten IETF-RFC-Standard darzustellen.
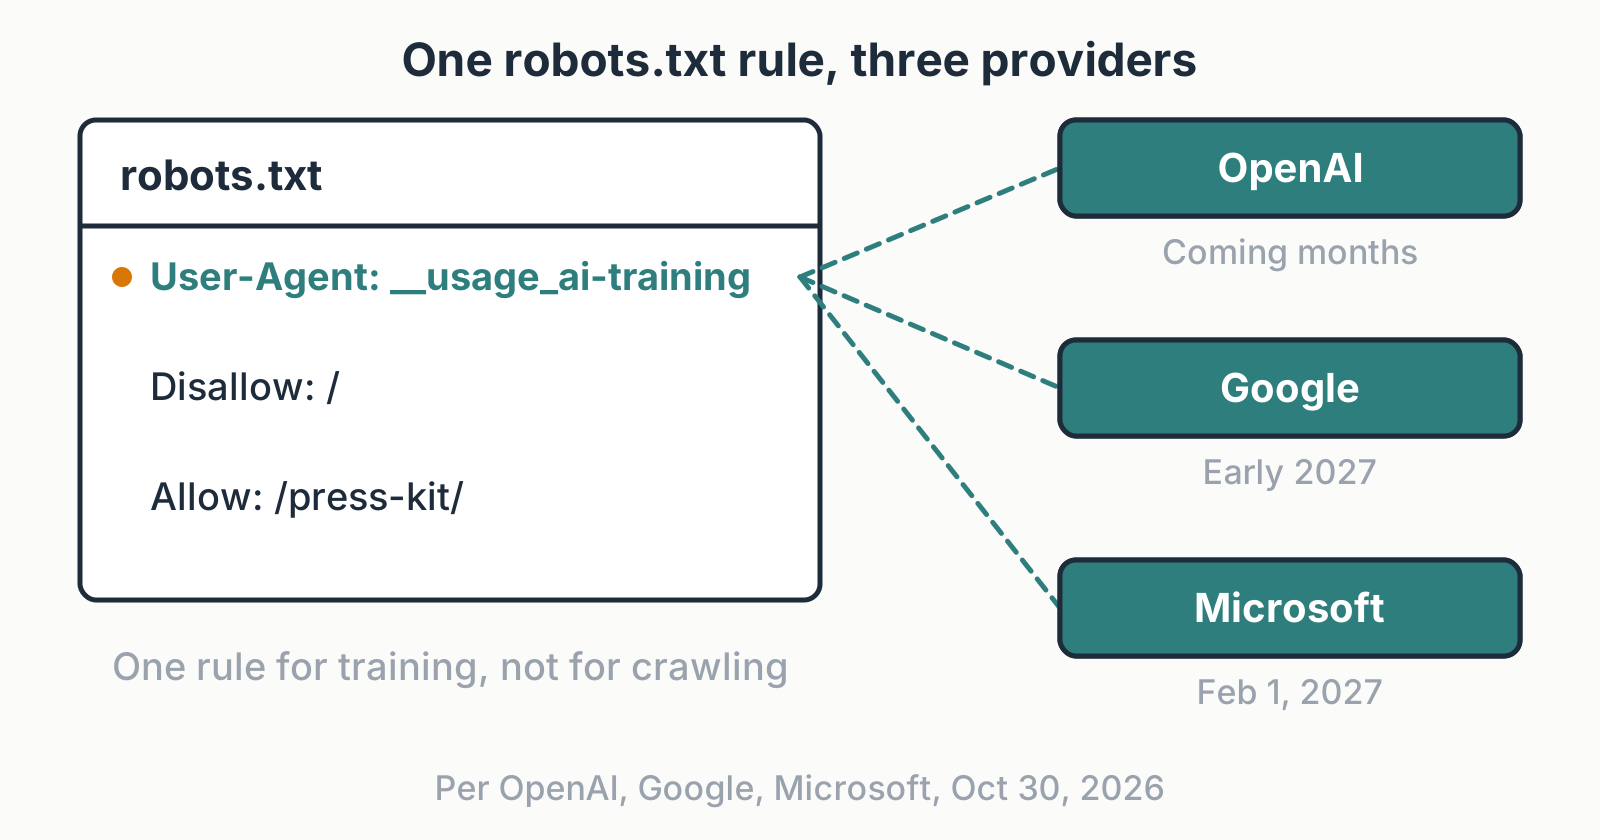
- Die Einführungstermine der Plattformen gehen stark auseinander: Anthropic hat interne Entwicklungsarbeiten begonnen, OpenAI plant die Einführung in den kommenden Monaten, Microsoft startet am 1. Februar 2027 und Google prognostiziert die Unterstützung für das Jahr 2027.
Fast dreißig Jahre lang regelte das Robots Exclusion Protocol, wie automatisierte Web-Crawler mit öffentlichen Online-Inhalten interagierten. Website-Administratoren platzierten eine einfache robots.txt-Textdatei in ihrem Stammverzeichnis, in der festgelegt war, welche User-Agents von Suchmaschinen die Berechtigung hatten, bestimmte URL-Pfade abzurufen. Dieses Protokoll basierte auf einem grundlegenden kommerziellen Kompromiss: Website-Herausgeber erlaubten Crawlern, ihre Inhalte zu indizieren, im Austausch für Auffindbarkeit, ausgehenden Empfehlungsverkehr und Markenpräsenz auf den Ergebnisseiten von Suchmaschinen.
Der rasantere Aufstieg der generativen künstlichen Intelligenz störte dieses Wirtschaftsmodell. Automatisierte Crawler, die von führenden KI-Laboren eingesetzt wurden, begannen, Web-Domänen einzulesen, um Basismodelle zu trainieren, wobei sie originale Inhalte oft direkt in Antwortoberflächen zusammenfassten, ohne Verweis-Klicks an die Herausgeber zu liefern. Inhaber von Inhalten, die verhindern wollten, dass ihr geistiges Eigentum eingelesen wird, waren gezwungen, fragmentierte, komplexe Listen proprietärer User-Agents wie GPTBot, ClaudeBot und Google-Extended zu pflegen. Dieser administrative Aufwand erhöhte das operative Risiko von Konfigurationsfehlern oder versehentlicher Such-Deindizierung bei der gleichzeitigen Verwaltung mehrerer Crawler-Anweisungen.

Das Aufkommen eines gemeinsamen KI-Trainings-Opt-outs markiert einen bedeutenden Wandel von der fragmentierten Anbieterblockierung hin zu einer kooperativen Protokoll-Governance. Durch die Koordinierung der Unterstützung um ein gemeinsames Richtlinientoken wollen große KI-Anbieter die technische Hürde für Inhaltsersteller senken, die klare Grenzen bezüglich des Trainings generativer Modelle festlegen möchten. Laut der offiziellen Ankündigung von Google Search Central ermöglicht diese einzelne Regel Website-Administratoren, ihre Haltung zum Training generativer KI in einem Schritt zu deklarieren, anstatt für jeden einzelnen kommerziellen KI-Crawler, der neu auf den Markt kommt, unterschiedliche Richtlinien zu verfolgen und zu konfigurieren.
Technische Architektur unter der Haube: Funktionsweise des Tokens __usage_ai-training
Die technische Architektur hinter dem gemeinsamen Präferenzsignal ist im IETF Internet-Draft zu maschinenlesbaren Signalen für Trainingspräferenzen spezifiziert. Entscheidend ist, dass der Entwurf keine neuartigen Direktiven einführt oder die zugrundeliegende Grammatik des in RFC 9309 definierten Robots Exclusion Protocol ändert. Stattdessen wird der Standard-Eintrag User-Agent durch die Zuweisung eines reservierten Richtlinientokens wiederverwendet: __usage_ai-training.
Um einen Opt-out zu konfigurieren, erstellt ein Webmaster einen gewöhnlichen Regelblock, der dieses Richtlinientoken als User-Agent festlegt, gefolgt von den Standardregeln Disallow und Allow. Das folgende Beispiel veranschaulicht, wie ein Website-Eigentümer einen Opt-out für alle Website-Verzeichnisse ausdrückt und gleichzeitig eine Ausnahme für öffentliches Werbematerial beibehält:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Die semantische Definition dessen, was ein „KI-Training“ ausmacht, ist in den grundlegenden Vokabularspezifikationen der IETF-Arbeitsgruppe verankert. In diesem Rahmen ist das Training streng definiert als die Nutzung von gecrawlten Web-Inhalten zur Modifikation oder Feinabstimmung der gelernten Gewichtungen und Parameter eines Modells für generative künstliche Intelligenz. Nicht-generative Rechenoperationen wie Standard-Dokumentenklassifizierung, Suchindex-Ranking, Fehlerkorrektur und Spam-Filterung sind von dieser Definition ausdrücklich ausgenommen.
Protokollgrenzen: Crawling vs. Training vs. Grounding
Um die operativen Grenzen dieses vorgeschlagenen Tokens zu verstehen, müssen die verschiedenen Phasen der automatisierten Datenerfassung getrennt werden:
[Öffentliche Web-Inhalte]
       │
       ▼
[1. HTTP-Crawl / Abruf] ──> Gesteuert durch spezifische Crawler-User-Agents (z. B. GPTBot, Bingbot)
       │                    *__usage_ai-training steuert NICHT das HTTP-Abrufverhalten*
       ├────────────────────────────────────────┐
       ▼                                        ▼
[2. Verwendung für Modelltraining]       [3. Live-Grounding / RAG]
   *__usage_ai-training: Disallow*          *Gesteuert durch Seitentags & Anbietereinstellungen*
   Signalisiert Präferenz gegen Training    Versorgt KI-Modelle mit Echtzeit-Webkontext
       │                                        │
       ▼                                        ▼
   Die Durchsetzung hängt von               Berechtigungskriterien werden durch
   teilnehmenden KI-Anbietern ab            individuelle Plattformrichtlinien festgelegt
Technische Teams müssen vier strukturelle Grenzen bewerten, die diesem Entwurf zugrunde liegen:
- Das Signal steuert das Training, nicht das Crawling: Das Richtlinientoken ist keine Direktive für das Netzwerk-Crawling-Verhalten. Ein KI-Crawler, der bei
__usage_ai-trainingaufDisallow: /stößt, darf das HTML-Dokument weiterhin über HTTP abrufen. Er wird lediglich angewiesen, diesen abgerufenen Text nicht in Modell-Trainingspipelines einzuspeisen. Um zu verhindern, dass ein Bot die URL überhaupt anfordert, müssen Administratoren die spezifische Identität des Crawlers weiterhin blockieren. - Platzhalterregeln (Wildcards) gelten nicht: Allgemeine Platzhalterblocks wie
User-Agent: *gefolgt vonDisallow: /stimmen nicht mit dem Richtlinientoken überein. Der Entwurf schreibt vor, dass teilnehmende KI-Anbieter eine universelle Platzhaltergruppe nicht als Ausdruck einer KI-Trainingspräferenz interpretieren dürfen. Wenn eine Datei das explizite__usage_ai-training-Token auslässt, interpretiert der Standard die Website so, dass keine Trainingspräferenz ausgedrückt wird. - Kein rückwirkendes Modell-Unlearning: Die Aktualisierung der
robots.txt-Datei einer Website wirkt in die Zukunft. Sie liefert ein Signal für zukünftige Crawling- und Trainingszyklen, zwingt ein KI-Labor jedoch nicht dazu, Daten zu löschen, die bereits in historische Trainingsdatensätze integriert wurden, oder Gewichtungen aus bereits existierenden Basismodellen zu entfernen. - Freiwillige Koordination statt technischer Durchsetzung: Das Signal drückt eine Präferenz des Herausgebers aus; es bietet keine technische Durchsetzung gegen nicht teilnehmende oder nicht konforme Datennutzer. Nach den Prinzipien von RFC 9309 bleibt robots.txt ein kooperativer beratender Mechanismus und keine Zugriffskontroll-Firewall.
Unterschiede bei der Anbieterimplementierung und Migrationszeitpläne
Obwohl Google, Microsoft und OpenAI angekündigt haben, das gemeinsame Signal zu unterstützen, weichen ihre technischen Implementierungen und Einführungszeitpläne erheblich voneinander ab. Jeder Anbieter nähert sich dem Gleichgewicht zwischen Suchmaschinen-Indizierung, generativem Modelltraining und konversationeller Retrieval-Augmented Generation (RAG) über seine eigene Produktinfrastruktur.
Die folgende Matrix stellt bestätigte Plattformzusagen, Interpretationsregeln und Migrationszeitpläne gegenüber:
| Plattform | Bestätigter Status & Zeitplan | Interpretation des Richtlinientokens | Grounding- & Retrieval-Handhabung | Migration alter Tags & Ausnahmen |
|---|---|---|---|---|
| Unterstützung angekündigt; geplant für 2027 (genaues Datum steht noch aus) | Wird als Google-Extended: Disallow interpretiert, wenn keine explizite Google-Extended-Regel vorhanden ist |
Standardzuordnung betrifft Gemini Apps Grounding; explizite Regeln haben Vorrang | Bestehende Google-Extended-Richtlinien bleiben voll gültig; Suchindizierung unberührt |
|
| Microsoft | Bestätigte Zusage; Berücksichtigung ab dem 1. Februar 2027 | Wird beim Web-Crawling als Trainings-Opt-out anerkannt | Vom Training entkoppelt; separate Verwaltung über seitenbasierte Tags | Stellt NoArchive/NoCache für KI am 1. März 2027 ein; temporäre Bing Webmaster Tools-Einstellung öffnet am 15. Dez. |
| OpenAI | Implementierung in den kommenden Monaten zugesagt | Direkte Unterstützung in Datenerfassungspipelines | Wird zusammen mit GPTBot-Richtlinien ausgewertet |
Bestehende GPTBot-Konfigurationen bleiben aktiv und durchsetzbar |
| Anthropic | Entwurf von Mitarbeitern verfasst; Entwicklung in der Arbeitsgruppen-Miste gemeldet | Beabsichtigte Unterstützung über Dienste hinweg; formaler Zeitplan für Newsroom steht noch aus | Wird zusammen mit ClaudeBot-Richtlinien ausgewertet |
Bestehende ClaudeBot-Crawler-Steuerungen funktionieren weiter |
Google plant, einen gemeinsamen KI-Trainings-Opt-out als Google-Extended-Disallow zu interpretieren, wenn keine explizite Google-Extended-Regel vorhanden ist. Da Google-Extended auch die Berechtigung für das Grounding in Gemini Apps steuert, kann sich diese Standardzuordnung darauf auswirken, ob die Inhalte eines Herausgebers für diese Erlebnisse verfügbar sind. Eine explizite Google-Extended-Regel hat in Googles Implementierung Vorrang vor dem gemeinsamen Signal, aber Herausgeber sollten nicht davon ausgehen, dass Googles aktuelle Kontrollen unabhängige Opt-outs für das Modelltraining und das Gemini Apps Grounding bieten. Inhalte, die unter Google-Extended erlaubt sind, können für das Gemini-Grounding berechtigt sein, ohne jegliche Garantie für die Aufnahme oder Zitation.
Im Gegensatz dazu behandelt Microsoft Bing das Modelltraining und das Echtzeit-Grounding als unterschiedliche architektonische Konzepte, wie in der offiziellen Aktualisierung der Bing Webmaster Tools detailliert beschrieben. Microsoft ermöglicht es Herausgebern, sich gegen das Training generativer Modelle zu entscheiden und gleichzeitig das Live-Grounding in Copilot-Antworten weiterhin zuzulassen. Websites, die diese Präferenzen verwalten, können Trainingseinschränkungen in der robots.txt oder über HTML-Metatags auf Seitenebene und HTTP-Header deklarieren, die die robots.txt für einzelne URLs überschreiben. Das Grounding wird über seitenbasierte Präferenzen gesteuert, einschließlich einer DisallowExtended-Option, die das Grounding in Microsofts eigenen Tools (wie Copilot) erlaubt, während von Microsoft-Grounding-APIs unterstützte Dienste von Drittanbietern ausgeschlossen werden. Darüber hinaus schränkt Microsoft seine historische Abhängigkeit von NoArchive- und NoCache-Tags für die KI-Steuerung schrittweise ein; Websites, die sich auf diese Tags verlassen, müssen vor dem 1. März 2027 auf die neuen Optionen migrieren. Die temporäre Grounding-Einstellung der Bing Webmaster Tools ist nur für Websites verfügbar, die Stand 15. Dezember 2026 NoArchive oder NoCache verwenden. Sie bleibt wirksam, bis Microsoft die Seite erneut crawlt und die neue Präferenz entdeckt, oder bis zum 30. September 2027, je nachdem, was zuerst eintritt.
Engineering-Checkliste: Überprüfung von Web-Präferenzen für das agentische Web
Die Bereitstellung des gemeinsamen Signals für KI-Trainingspräferenzen erfordert eine Koordination zwischen Systemarchitektur, Inhaltsoperationen und rechtlichen Governance-Teams. Engineering-Leiter müssen sicherstellen, dass Serverkonfigurationen die Unternehmensrichtlinien genau widerspiegeln, ohne die Auffindbarkeit in Suchmaschinen unabsichtlich zu stören.
Implementierungscheckliste für Webmaster und Systeme
- Aktuelle Robots-Manifeste überprüfen: Überprüfen Sie bestehende
robots.txt-Dateien, um anbieterspezifische Richtlinien zu katalogisieren, und verifizieren Sie, ob Regeln fürGPTBot,ClaudeBotoderGoogle-Extendedim Widerspruch zu den Trainingsrichtlinien des Unternehmens stehen. - Reserviertes Richtlinientoken bereitstellen: Implementieren Sie den Block
User-Agent: __usage_ai-training, um globale Trainingsgrenzen über teilnehmende KI-Anbieter hinweg in einem einheitlichen Format auszudrücken. - Granulare Ausnahmepfade beibehalten: Wenn öffentliche Assets wie Pressemitteilungen, Medien-Kits oder offene Entwicklerdokumentationen für die Modellnutzung bestimmt sind, deklarieren Sie explizite
Allow:-Ausnahmen unterhalb der Disallow-Direktive. - Abrufblockierung von der Trainings-Governance trennen: Wenn das primäre Ziel darin besteht, die Last auf dem Ursprungsserver zu reduzieren oder unbefugtes Scraping zu verhindern, konfigurieren Sie IP-basiertes Rate-Limiting, CDN-Bot-Challenges und explizite Crawler-User-Agent-Blockaden.
Governance- und Compliance-Checkliste
- Migrationszeitpläne für das Microsoft-Grounding überprüfen: Bereiten Sie für Websites, die
NoArchiveoderNoCachezur Steuerung der Bing Copilot-Ausgabe verwenden, den Übergang zu den neuen seitenbasierten Tags vor der Durchsetzungsfrist von Microsoft am 1. März 2027 vor. - Kompromisse bei der Such-Auffindbarkeit bewerten: Erkennen Sie bei Plattformen, die die Sichtbarkeit in konversationellen Antwort-Engines bewerten, wie anbieterspezifische Standardzuordnungen (wie Googles Fallback auf
Google-Extended) die Berechtigung für das Echtzeit-Retrieval beeinflussen. - Aktualisierungen der IETF-Arbeitsgruppe verfolgen: Überwachen Sie den Fortgang von
draft-kelley-aipref-training-preference-signalinnerhalb der IETF-AIPREF-Arbeitsgruppe, um mögliche Syntax-Aktualisierungen vor dem geplante Ablauf im Mai 2027 zu berücksichtigen.
Share this article