¿OpenAI y Google respaldan la exclusión voluntaria compartida del entrenamiento de IA? OpenAI, Google y Microsoft anunciaron planes el 30 de octubre de 2026 para respetar un token de política único y compartido en robots.txt que permite a los operadores de sitios web expresar sus preferencias de entrenamiento de modelos de inteligencia artificial generativa en múltiples proveedores simultáneamente. El mecanismo propuesto se origina a partir de un borrador de Internet individual enviado al grupo de trabajo de Preferencias de IA del IETF por el ingeniero de Anthropic, Kevin Kelley. Si bien la iniciativa ofrece a los editores un método simplificado para declarar la exclusión voluntaria del entrenamiento mediante el uso de la sintaxis estándar Allow y Disallow, los calendarios de implementación se extienden de manera escalonada hasta 2027, y cada plataforma principal planea interpretar y aplicar la señal de forma distinta en el entrenamiento de modelos y la vinculación conversacional en vivo.
Reajuste central de la industria: los principales laboratorios de IA se coordinan en los estándares de Robots.txt
Resumen
- OpenAI, Google y Microsoft anunciaron planes coordinados el 30 de octubre de 2026 para reconocer un token de política compartido en robots.txt,
__usage_ai-training, para la gestión de preferencias de entrenamiento de modelos generativos. - La señal está definida en un borrador de Internet individual del IETF redactado por el ingeniero de Anthropic, Kevin Kelley, lo que establece una sintaxis estandarizada sin representar un estándar oficial o finalizado de la RFC del IETF.
- Los cronogramas de adopción de las plataformas difieren significativamente: Anthropic ha iniciado el trabajo de ingeniería interno, OpenAI apunta a su lanzamiento en los próximos meses, Microsoft comienza el 1 de febrero de 2027 y Google proyecta su soporte para 2027.
Durante casi treinta años, el Protocolo de exclusión de robots rigió la forma en que los rastreadores web automatizados interactuaban con el contenido público en línea. Los administradores de sitios web colocaban un archivo de texto plano simple llamado robots.txt en su directorio raíz, definiendo qué agentes de usuario de motores de búsqueda tenían permiso para recuperar rutas de URL específicas. Este protocolo operaba sobre un acuerdo comercial fundamental: los editores de sitios web permitían que los rastreadores indexaran su contenido a cambio de visibilidad, tráfico de referencia saliente y exposición de marca en las páginas de resultados de los motores de búsqueda.
El rápido auge de la inteligencia artificial generativa alteró ese modelo económico. Los extractores automatizados desplegados por laboratorios de IA de vanguardia comenzaron a ingerir dominios web para entrenar modelos fundacionales, resumiendo a menudo el contenido original directamente en las interfaces de respuesta sin generar clics de referencia para los editores. Los propietarios de contenido que buscaban evitar la ingesta de su propiedad intelectual se veían obligados a mantener listas fragmentadas y complejas de agentes de usuario propietarios, incluidos GPTBot, ClaudeBot y Google-Extended. Esta carga administrativa incrementó el riesgo operativo de errores de configuración o de la desindexación accidental en las búsquedas al gestionar múltiples directivas de rastreo de forma simultánea.

La aparición de una opción de exclusión voluntaria compartida para el entrenamiento de IA marca un cambio significativo desde el bloqueo fragmentado de proveedores hacia la gobernanza cooperativa de protocolos. Al coordinar el soporte en torno a un token de política compartido, los principales proveedores de IA buscan reducir la barrera técnica para los creadores de contenido que desean establecer límites claros con respecto al entrenamiento de modelos generativos. Según el anuncio oficial de Google Search Central, esta única regla permite a los administradores de sitios web declarar su postura sobre el entrenamiento de inteligencia artificial generativa en un solo paso, en lugar de rastrear y configurar directivas distintas para cada rastreador comercial de IA individual que ingresa al mercado.
Mecánica arquitectónica interna: cómo funciona el token __usage_ai-training
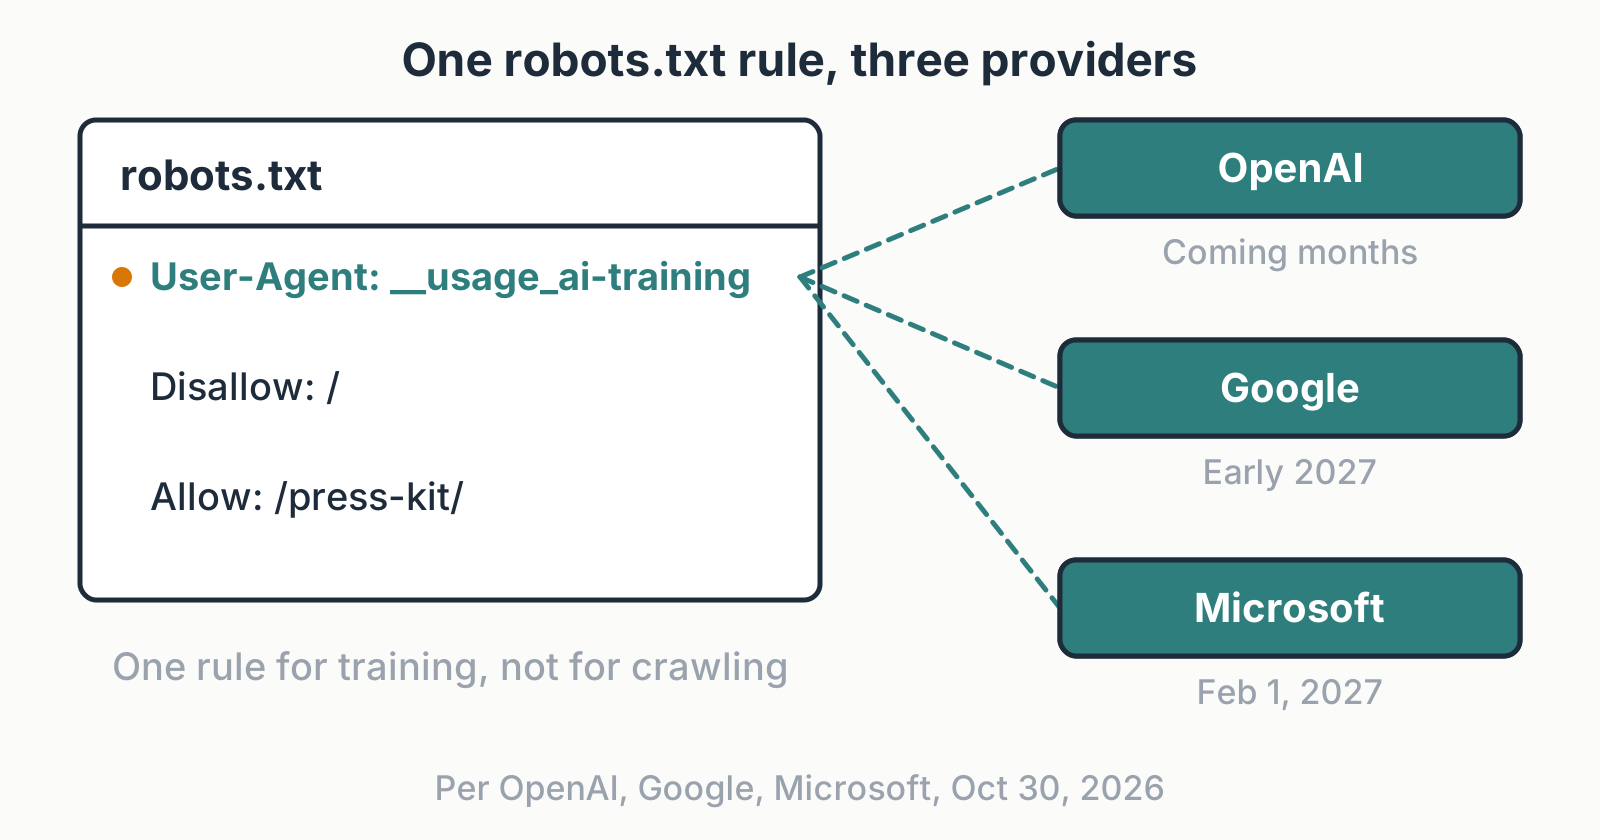
La arquitectura técnica detrás de la señal de preferencia compartida se especifica en el borrador de Internet del IETF sobre señales de preferencia de entrenamiento legibles por máquina. De manera crucial, el borrador no introduce directivas novedosas ni altera la gramática subyacente del Protocolo de exclusión de robots definido en la RFC 9309. En su lugar, reutiliza el registro estándar User-Agent mediante la asignación de un token de política reservado: __usage_ai-training.
Para configurar una exclusión voluntaria, un webmaster crea un bloque de reglas ordinario que designa este token de política como el agente de usuario, seguido de las reglas estándar Disallow y Allow. El ejemplo a continuación ilustra cómo el propietario de un sitio web expresa una exclusión voluntaria en todos los directorios del sitio mientras mantiene una excepción para los materiales promocionales públicos:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
La definición semántica de lo que constituye «entrenamiento de IA» está anclada en las especificaciones de vocabulario fundamentales del grupo de trabajo del IETF. Bajo este marco, el entrenamiento se define estrictamente como el uso de contenido web extraído para modificar o ajustar los pesos aprendidos y los parámetros de un modelo de inteligencia artificial generativa. Las operaciones computacionales no generativas, tales como la clasificación estándar de documentos, la jerarquización de índices de búsqueda, la corrección ortográfica y el filtrado de correo no deseado, quedan explícitamente excluidas de esta definición.
Límites del protocolo: rastreo frente a entrenamiento y vinculación (grounding)
Comprender los límites operativos de este token propuesto requiere separar las distintas etapas de la ingesta automatizada de datos:
[Contenido Web Público]
       │
       ▼
[1. Rastreo / Obtención HTTP] ──> Regido por Agentes de Usuario de rastreo específicos (ej. GPTBot, Bingbot)
       │                    *__usage_ai-training NO rige el comportamiento de obtención HTTP*
       ├────────────────────────────────────────┐
       ▼                                        ▼
[2. Uso para Entrenamiento de Modelos]   [3. Vinculación en Vivo / RAG]
   *__usage_ai-training: Disallow*          *Regido por etiquetas de página y ajustes del proveedor*
   Señala preferencia en contra del          Suministra contexto web en tiempo real a los modelos de IA
   entrenamiento                            │
       │                                        ▼
       ▼                                  Criterios de elegibilidad establecidos por
   La aplicación depende de                 las políticas individuales de cada plataforma
   los proveedores de IA participantes
Los equipos técnicos deben evaluar cuatro límites estructurales inherentes a esta especificación de borrador:
- La señal rige el entrenamiento, no el rastreo: El token de política no es una directiva para el comportamiento de rastreo en la red. Un rastreador de IA que encuentre
Disallow: /bajo__usage_ai-trainingaún tiene permitido obtener el documento HTML a través de HTTP. Simplemente se le instruye que no alimente ese texto recuperado en los flujos de trabajo de entrenamiento de modelos. Para evitar que un bot solicite la URL por completo, los administradores deben continuar bloqueando el nombre de identidad específico del rastreador. - Las reglas con comodines no aplican: Los bloqueos generales con comodines, tales como
User-Agent: *seguidos deDisallow: /, no coinciden con el token de política. El borrador exige que los proveedores de IA participantes no interpreten un grupo de comodines universal como la expresión de una preferencia de entrenamiento de IA. Si un archivo omite el token explícito__usage_ai-training, el estándar interpreta que el sitio no expresa ninguna preferencia de entrenamiento. - No existe el desaprendizaje retrospectivo de modelos: La actualización del archivo
robots.txtde un sitio web opera hacia adelante en el tiempo. Proporciona una señal para futuros ciclos de rastreo y entrenamiento, pero no obliga a un laboratorio de IA a depurar los datos ya integrados en conjuntos de datos de entrenamiento históricos ni a eliminar pesos de modelos fundacionales preexistentes. - Coordinación voluntaria por encima de la aplicación técnica: La señal expresa la preferencia de un editor; no proporciona una aplicación técnica en contra de consumidores de datos que no participen o no cumplan con la norma. Bajo los principios de la RFC 9309, robots.txt sigue siendo un mecanismo de asesoramiento cooperativo más que un cortafuegos de control de acceso.
Diferencias de implementación entre proveedores y calendarios de migración
Si bien Google, Microsoft y OpenAI han anunciado planes para respaldar la señal compartida, sus implementaciones técnicas y cronogramas de lanzamiento difieren significativamente. Cada proveedor aborda el equilibrio entre la indexación de motores de búsqueda, el entrenamiento de modelos generativos y la generación aumentada por recuperación (RAG) conversacional a través de su propia infraestructura de productos.
La matriz a continuación contrasta los compromisos confirmados de las plataformas, las reglas de interpretación y los cronogramas de migración:
| Plataforma | Estado confirmado y cronograma | Interpretación del token de política | Gestión de vinculación (grounding) y recuperación | Migración de etiquetas heredadas y excepciones |
|---|---|---|---|---|
| Soporte anunciado; planeado para 2027 (fecha exacta por definir) | Se interpreta como Google-Extended: Disallow cuando no existe una regla explícita de Google-Extended |
La asignación predeterminada afecta la vinculación en Gemini Apps; las reglas explícitas tienen prioridad | Las directivas existentes de Google-Extended siguen siendo plenamente válidas; la indexación de búsqueda no se ve afectada |
|
| Microsoft | Compromiso confirmado; comienza a respetarse el 1 de febrero de 2027 | Se reconoce como una exclusión voluntaria de entrenamiento durante el rastreo web | Desacoplado del entrenamiento; se gestiona por separado mediante etiquetas a nivel de página | Retira NoArchive/NoCache para IA el 1 de marzo de 2027; la configuración temporal de Bing Webmaster Tools se abre el 15 de diciembre |
| OpenAI | Comprometido con la implementación en los próximos meses | Soporte directo en flujos de trabajo de ingesta de datos | Evaluado junto con las directivas de GPTBot |
Las configuraciones existentes de GPTBot permanecen activas y aplicables |
| Anthropic | Borrador redactado por un empleado; desarrollo reportado en la lista del grupo de trabajo | Soporte previsto en todos los servicios; cronograma formal de prensa por definir | Evaluado junto con las directivas de ClaudeBot |
Los controles de rastreo existentes de ClaudeBot continúan operando |
Google planea interpretar una exclusión voluntaria compartida del entrenamiento de IA como una directiva de no permitir de Google-Extended (Google-Extended disallow) cuando no esté presente ninguna regla explícita de Google-Extended. Debido a que Google-Extended también rige la elegibilidad para la vinculación en Gemini Apps, esta asignación predeterminada puede influir en si el contenido de un editor está disponible para dichas experiencias. Una regla explícita de Google-Extended tiene prioridad sobre la señal compartida en la implementación de Google, pero los editores no deben asumir que los controles actuales de Google ofrecen exclusiones voluntarias independientes para el entrenamiento de modelos y la vinculación en Gemini Apps. El contenido permitido bajo Google-Extended puede ser elegible para la vinculación en Gemini, sin ninguna garantía de inclusión o citación.
Por el contrario, Microsoft Bing trata el entrenamiento de modelos y la vinculación en tiempo real como conceptos arquitectónicos distintos, tal como se detalla en la actualización oficial de Bing Webmaster. Microsoft permite a los editores excluirse del entrenamiento de modelos generativos al tiempo que continúan permitiendo la vinculación en vivo en las respuestas de Copilot. Los sitios que administran estas preferencias pueden declarar restricciones de entrenamiento en robots.txt o mediante metaetiquetas HTML a nivel de página y cabeceras HTTP, las cuales tienen prioridad sobre robots.txt para URLs individuales. La vinculación se controla mediante preferencias a nivel de página, incluida una opción DisallowExtended que permite la vinculación en las herramientas propias de Microsoft (como Copilot) a la vez que excluye servicios de terceros impulsados por las API de vinculación de Microsoft. Además, Microsoft está eliminando gradualmente su dependencia histórica de las etiquetas NoArchive y NoCache para los controles de IA; los sitios que dependen de esas etiquetas deben migrar a las nuevas opciones antes del 1 de marzo de 2027. La configuración temporal de vinculación en Bing Webmaster Tools está disponible únicamente para los sitios que utilicen NoArchive o NoCache a partir del 15 de diciembre de 2026. Permanece vigente hasta que Microsoft vuelva a rastrear la página y descubra la nueva preferencia, o hasta el 30 de septiembre de 2027, lo que ocurra primero.
Lista de verificación de ingeniería: auditoría de preferencias web para la Web de agentes
Implementar la señal de preferencia de entrenamiento de IA compartida requiere la coordinación entre la arquitectura de sistemas, las operaciones de contenido y los equipos de gobernanza legal. Los líderes de ingeniería deben asegurarse de que las configuraciones del servidor reflejen con precisión las políticas organizacionales sin interrumpir involuntariamente el descubrimiento en los motores de búsqueda.
Lista de verificación para webmasters y sistemas de implementación
- Auditar los manifiestos de robots actuales: Revisar los archivos
robots.txtexistentes para catalogar las directivas específicas de cada proveedor, verificando si las reglas paraGPTBot,ClaudeBotoGoogle-Extendedentran en conflicto con las políticas de entrenamiento de la organización. - Desplegar el token de política reservado: Implementar el bloque
User-Agent: __usage_ai-trainingpara expresar límites de entrenamiento globales en los proveedores de IA participantes en un formato unificado. - Mantener rutas de excepción granulares: Si los activos públicos (tales como comunicados de prensa, kits de medios o documentación abierta para desarrolladores) están destinados al consumo por parte de modelos, declarar excepciones explícitas de
Allow:debajo de la directiva de exclusión. - Separar el bloqueo de obtención de la gobernanza del entrenamiento: Si el objetivo principal es reducir la carga en el servidor de origen o prevenir la extracción no autorizada de datos, configurar la limitación de velocidad basada en IP (rate limiting), desafíos de bots en redes de entrega de contenido (CDN) y bloques explícitos de agentes de usuario de rastreadores.
Lista de verificación de gobernanza y cumplimiento
- Revisar los calendarios de migración de vinculación de Microsoft: Para los sitios que utilizan
NoArchiveoNoCachepara controlar la salida de Bing Copilot, prepararse para realizar la transición a las nuevas etiquetas a nivel de página antes de la fecha límite de aplicación de Microsoft del 1 de marzo de 2027. - Evaluar las compensaciones en el descubrimiento de búsquedas: Para las plataformas que evalúan la visibilidad en motores de respuesta conversacionales, reconocer cómo las asignaciones predeterminadas específicas de cada proveedor (como el respaldo de Google a
Google-Extended) afectan la elegibilidad de recuperación en tiempo real. - Rastrear las actualizaciones del grupo de trabajo del IETF: Monitorear la progresión de
draft-kelley-aipref-training-preference-signaldentro del grupo de trabajo AIPREF del IETF para dar cuenta de posibles actualizaciones de sintaxis antes de su expiración programada en mayo de 2027.
Share this article