 Amap lance « damax » ? Cette initiative stratégique a été confirmée alors que le géant de la cartographie pénètre l'espace de génération low-code pour automatiser la création d'applications. Le 29 juin 2026, des détails ont émergé concernant « damax » (également appelé « 袋马 »), un outil de Vibe Coding conçu pour compiler des mini-programmes WeChat et des applications natives iOS directement à partir d'invites en langage naturel. Pour les équipes de développement et les responsables produits, ce modèle de génération rapide souligne une transition technologique : les assistants IA agissent de plus en plus comme une couche de middleware programmatique entre les utilisateurs finaux et les applications, réduisant ainsi les configurations de développement manuelles.
En bref
- Génération rapide : Le moteur « damax » automatise la transformation d'invites en langage naturel en mini-programmes WeChat et en builds natifs iOS, réduisant considérablement les cycles de lancement de produits.
- Cible : Cette solution est destinée aux propriétaires de petites entreprises, aux créateurs indépendants et aux micro-équipes sans départements d'ingénierie internes dédiés.
- Fragmentation du contexte : La prolifération d'applications générées automatiquement pose des défis uniques en matière de suivi, de restauration de session et de préservation des liens profonds (deep links) sur des plateformes fragmentées.
Réalignement structurel et espace de génération low-code
Beijing Amap Yuntu Technology Co., Ltd. a développé et exploite le nouvel outil d'espace de travail « damax ». Ce lancement positionne Amap directement sur le marché concurrentiel de la génération d'applications par IA, défiant des plateformes établies comme Tusi de Tencent, Miada de Baidu, Qoder d'Alibaba et Trae de ByteDance. Des rapports de suivi sectoriels récents indiquent une augmentation des nouvelles soumissions d'applications, soulignant comment la programmation assistée par IA abaisse les barrières à l'entrée. Plutôt que de produire de simples maquettes, ce système compile des logiciels iOS natifs et des mini-programmes WeChat pleinement fonctionnels. Il génère des codes QR sur appareil réel pour une exécution et des tests immédiats dans WeChat, permettant aux créateurs non techniques de lancer et d'affiner leurs projets en temps réel.
Le retrait des cycles de développement traditionnels semble probable à mesure que ces systèmes « zero-code » gagnent en popularité. L'intégration continue de compilateurs conversationnels dans les écosystèmes SaaS suggère que les grandes entreprises technologiques privilégient désormais les flux de travail automatisés plutôt que la maintenance client centrée sur l'humain. Par conséquent, lorsque Amap lance « damax » pour des tests bêta internes, cela déclenche une évolution plus large vers des protocoles d'échange de données natifs aux programmes. Des études sectorielles démontrent que les flux de travail assistés par IA peuvent générer des configurations multi-écrans complètes à partir de simples invites, prouvant que la conception manuelle de mises en page visuelles devient un point de friction majeur dans les logiciels d'entreprise modernes.
Les fournisseurs SaaS se repositionnent rapidement pour éviter l'obsolescence. Les équipes logicielles explorent des infrastructures d'e-mailing agentique pour soutenir les flux de travail programmatiques des boîtes de réception. Étendant cette tendance à l'automatisation, les grandes suites de productivité ont acquis des technologies de création d'agents pour exécuter des tâches complexes entre différents systèmes. En parallèle, les plateformes de chat d'entreprise ont déployé des capacités assistées par IA au sein de leurs systèmes natifs. Cette consolidation à l'échelle de l'industrie indique une direction probable où l'intégration backend prend le pas sur les logiciels de bureau autonomes.
Analyse du protocole : Comment les scrapers sans interface perturbent l'attribution
De nombreuses passerelles d'e-mail d'entreprise et assistants IA inspectent automatiquement les liens entrants avant que les utilisateurs n'interagissent avec eux. Du point de vue des systèmes d'attribution, cela modifie toute la chaîne de requête.
Lorsqu'un utilisateur humain clique sur un lien, un navigateur web standard charge la page, exécute des scripts de suivi et écrit un cookie. À l'inverse, un agent IA récupère la page de manière programmatique. Il envoie une requête HTTP sans interface (headless) directement depuis un serveur cloud. Comme la requête s'exécute dans un bac à sable (sandbox) sans état, il n'y a pas de DOM visuel, pas d'historique de navigateur et pas de stockage de cookies. Le routage « headless » isole souvent la session du système côté client. Les méthodes d'attribution traditionnelles basées sur le navigateur ne peuvent plus capturer le parcours utilisateur complet car elles reposent sur des cookies pour lier le clic initial à l'installation. Dans ces conditions, la précision de l'attribution diminue considérablement sur la pile de communication.
Flux humain traditionnel :
Lien e-mail -> Clic visuel -> Session navigateur (Cookies, DOM) -> App Store -> Installation application (Attribuée)


Flux géré par agent (headless) :
Lien e-mail -> Scan programmatique -> Requête HTTP headless (Pas d'UI, pas de DOM, pas de cookies) -> Lien visité
Installation application (plus tard) -> Lancement application -> État client vide (Attribution perdue)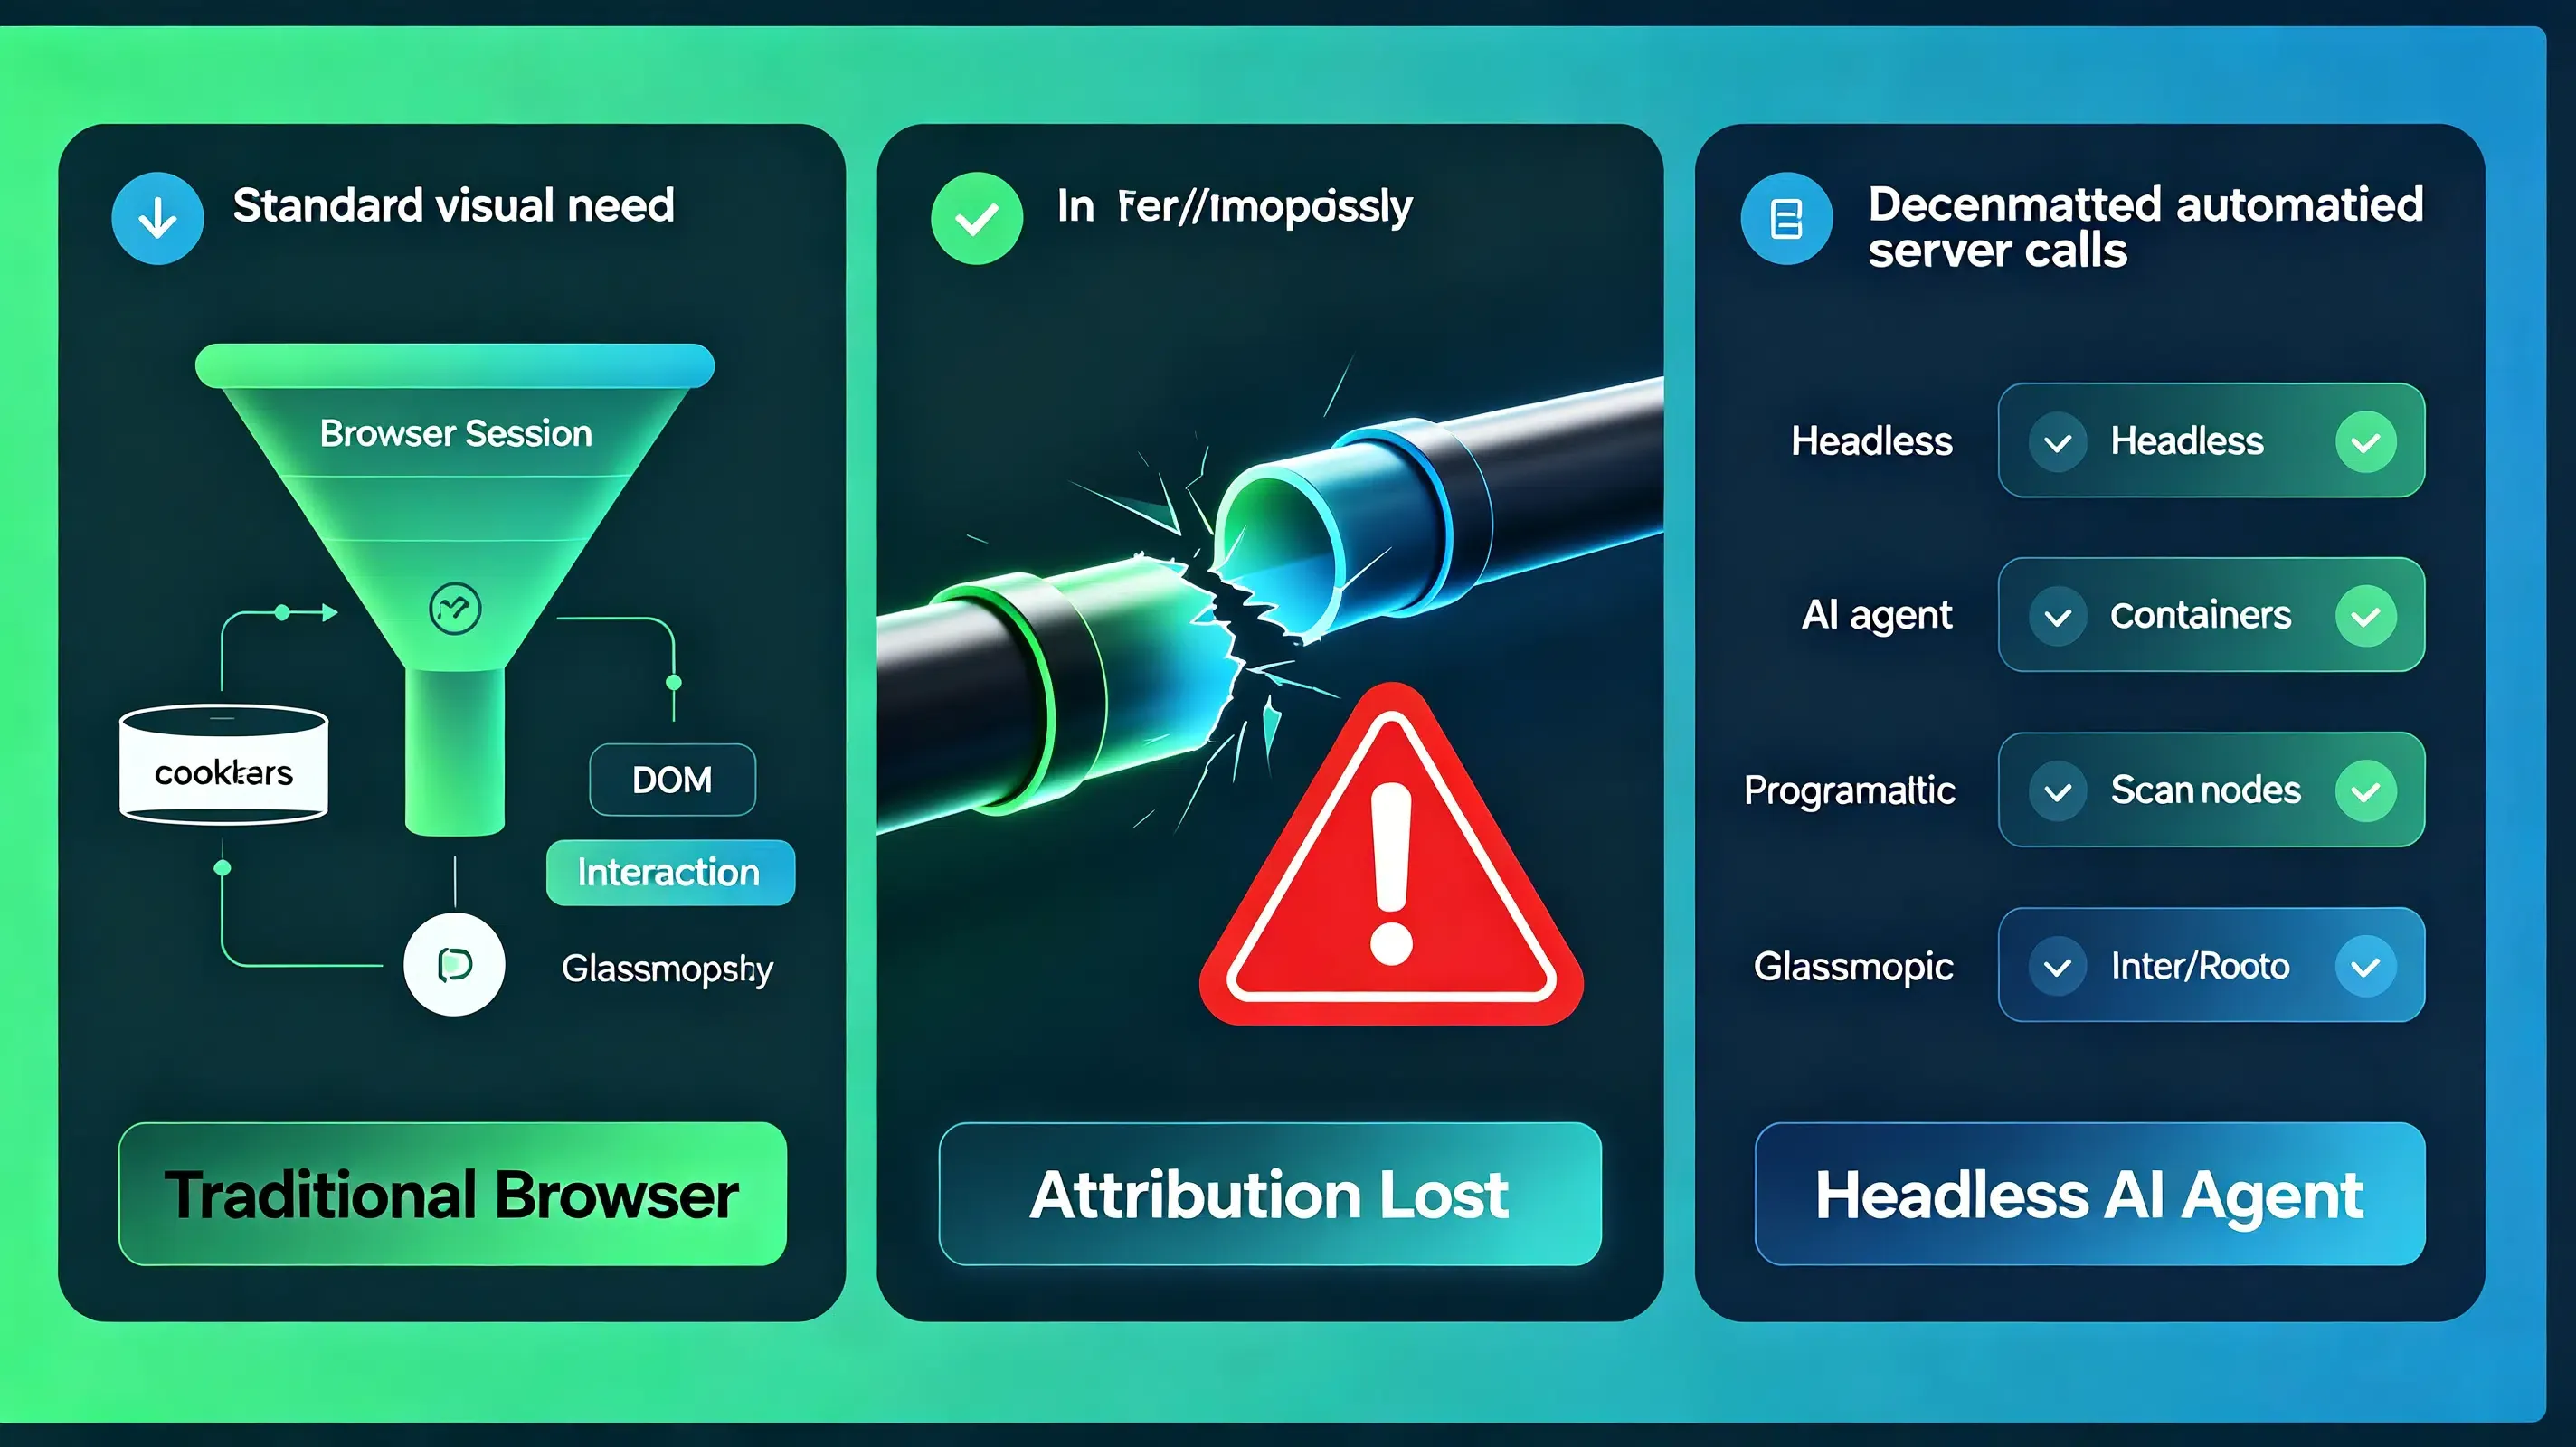
Dans les déploiements de production classiques, les développeurs rencontrent souvent une part importante de trafic traitée par des scrapers automatisés. Le suivi de ces interactions programmatiques révèle que les passerelles de sécurité e-mail ou les scanners automatisés peuvent visiter les liens avant les utilisateurs finaux. Ce comportement peut interférer avec l'attribution basée sur le navigateur si les systèmes supposent que chaque requête provient d'un utilisateur réel. Par conséquent, dans certaines implémentations, le contexte de référence original n'est plus disponible pour l'application client, entraînant des lacunes d'attribution significatives.
Solutions architecturales : Construire ou acheter pour la restauration d'état
En pratique, les équipes d'ingénierie choisissent généralement entre développer une pipeline d'attribution interne ou intégrer un SDK d'attribution existant. Le développement d'un système propriétaire nécessite des ressources d'ingénierie importantes. Les équipes doivent construire des bases de données côté serveur personnalisées, maintenir des bibliothèques de correspondance d'état des appareils et mettre à jour continuellement la logique pour se conformer aux normes de sécurité OS évolutives. Pour de nombreuses organisations, le coût de maintenance d'un outil de suivi interne est trop élevé.
Alternativement, les développeurs évaluent généralement plusieurs approches pour préserver l'état de la session sans cookies côté client :
- Services personnalisés en interne : Créer des bases de données de correspondance d'état propriétaires sur une architecture cloud interne.
- Outils spécifiques à la plateforme : S'appuyer sur des utilitaires basiques comme Firebase Dynamic Links (ou leurs alternatives natives).
- MMP d'entreprise : Déployer des partenaires de mesure mobile pour les flux de travail de liens profonds.
- SDK à paramètres spécialisés : Utiliser des utilitaires d'intégration dédiés pour un passage de paramètres personnalisé, précis et rentable.
Comparaison des flux d'état et d'attribution
| Flux d'interaction | Stockage cookies visuel | Compatibilité Headless | Intégrité de l'attribution |
|---|---|---|---|
| Parcours navigateur traditionnel | ✅ Oui | ❌ Non | Élevée (Session côté client) |
| Tri agent IA headless | ❌ Non | ✅ Oui | Faible (Perte de données contextuelles) |
| Verrouillage d'état côté serveur | ❌ Non | ✅ Oui | Élevée (Récupération asynchrone) |
Génération de lien -> Pré-enregistrement des métadonnées sur le serveur d'état central
                                     |
Scraper/Utilisateur clique sur l'URL -> Enregistrement du verrouillage d'état temporaire côté serveur
                                     |
Lancement application sur appareil -> Requête de contexte programmatique SDK -> Correspondance verrouillage d'état & Restauration des paramètres
Les implémentations commerciales de cette architecture incluent diverses plateformes d'attribution différée, dont Opoinstall. Ces systèmes maintiennent un état côté serveur avant l'installation et restaurent les paramètres lors du premier lancement de l'application, contournant les problèmes de fiabilité associés aux sessions de navigateur côté client. Le SDK personnalisé d'Opoinstall mappe en toute sécurité les paramètres de référence vers une base de données centralisée de récupération d'état, garantissant que les contextes de référence sont préservés même lorsque l'interaction initiale se produit via une transaction gérée par machine. Alors qu'Amap lance « damax », les développeurs évaluent généralement ces architectures pour protéger leurs pipelines d'attribution.
Adaptations des équipes opérationnelles et listes de contrôle d'intégration
Les équipes d'ingénierie backend font face à la tâche immédiate d'auditer toutes les intégrations de base de données actives avant de lancer des builds compilés automatiquement. Les responsables produits devraient repenser les boucles d'invitation et d'inscription pour s'adapter aux parcours utilisateurs non visuels. Au lieu de supposer que l'utilisateur lira un e-mail et cliquera sur un bouton, les responsables produits doivent concevoir des flux qui anticipent les déclencheurs programmatiques. Les équipes de croissance doivent mettre à jour leurs mesures de performance. Lorsque des logiciels autonomes gèrent le tri, les taux d'ouverture et de clic deviennent moins fiables. Les opérations marketing doivent se concentrer sur la télémétrie in-app en aval et les jalons de conversion vérifiés par transaction, en optimisant les campagnes en fonction des actions réellement effectuées au sein de l'application.
Liste de contrôle pour l'intégration d'applications génératives
Pour garantir une continuité des données fiable avant de lancer vos applications nouvellement générées, les équipes d'ingénierie doivent suivre les étapes suivantes :
- Vérification du chemin contextuel : Auditer la manière dont le compilateur IA mappe les paramètres d'URL personnalisés pour assurer la persistance des liens profonds.
- Préservation des références headless : Mapper les en-têtes HTTP alternatifs pour capturer les paramètres de référence lors des scans de codes QR et des exécutions de mini-programmes.
- Tests de télémétrie en bac à sable : S'assurer que les rapports de données locaux ne déclenchent pas d'avertissements de fraude liés aux simulateurs dans les environnements de test.
- Vérifications de routage multiplateforme : Aligner les liens universels avec les schémas des mini-programmes WeChat pour éviter les frictions utilisateur lors des transferts multi-écrans.
Lors des migrations de systèmes typiques, les développeurs rencontrent souvent une part importante de trafic traitée par des scrapers automatisés. Le suivi de ces interactions programmatiques révèle que les contextes de référence sont fréquemment supprimés, confirmant que les frameworks de suivi traditionnels sont moins fiables dans les configurations automatisées.
Foire aux questions (FAQ)
Le « damax » d'Amap affecte-t-il les magasins d'applications existants ?
Comment les applications automatisées survivent-elles sans environnements de développement locaux ?
Comment l'attribution de référence peut-elle survivre lorsque de nouvelles applications sont lancées de manière programmatique ?
Le retrait du cycle de développement d'applications visuel et orienté humain met en lumière un passage fondamental vers des protocoles de communication pilotés par le backend et des flux de travail assistés par IA. À mesure que les applications communiquent de plus en plus par des échanges de données automatisés plutôt que par des mises en page rendues pour l'humain, les équipes d'ingénierie doivent réévaluer leurs stratégies d'intégration traditionnelles. Les plateformes qui dépendent fortement des actions manuelles et visuelles des utilisateurs peuvent faire face à des lacunes structurelles lorsque des agents automatisés gèrent la pipeline de requêtes. La transition vers l'attribution côté serveur et le passage de paramètres sécurisé représente une direction très probable pour maintenir un suivi fiable et une couverture de sécurité.
Cette transition suggère une réécriture fondamentale de nos frameworks de mesure et de nos protocoles de sécurité. Les systèmes d'attribution futurs dépendront davantage de la correspondance d'identité côté serveur et de la synchronisation d'état sécurisée. À mesure que davantage d'agents IA commenceront à agir comme les premiers consommateurs de communication numérique, les architectures d'attribution dépendront de plus en plus de l'identité côté serveur, de la récupération d'état différée et de la préservation du contexte au niveau du protocole, plutôt que des seules sessions de navigateur.
Share this article



