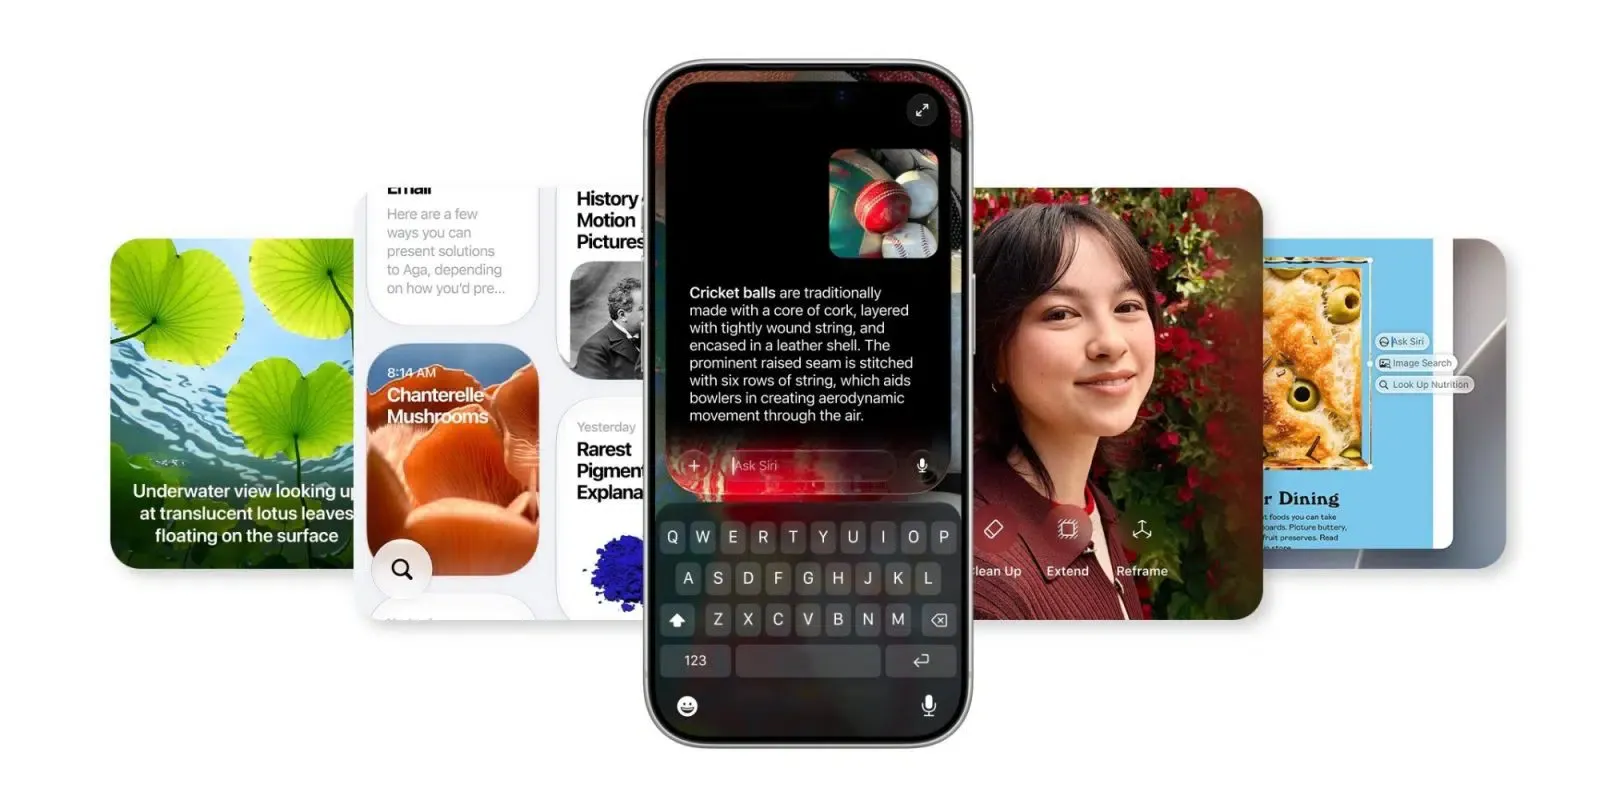
Apple achemine les requêtes IA vers Google Cloud ? Cette architecture de délégation cloud hybride marque un tournant en matière de transparence, car iOS 27 introduit des demandes de consentement explicites avant d'envoyer certaines charges de travail génératives vers Google Cloud. À mesure que l'IA grand public s'étend au-delà des modèles sur appareil, l'inférence basée sur le cloud devient une composante essentielle des services d'IA modernes. Aujourd'hui, les plateformes d'IA répartissent de plus en plus les charges de travail intensives sur des environnements cloud tiers de confiance, rendant le consentement explicite et le routage transparent indispensables. Alors que ces plateformes gèrent des requêtes génératives toujours plus complexes via des infrastructures externes, des voies de vérification multi-cloud sécurisées sont devenues critiques pour préserver la confiance des utilisateurs.
Pourquoi Apple achemine les requêtes IA vers Google Cloud : concilier promesses de confidentialité et mise à l'échelle multi-cloud
En un coup d'œil
- Les nouvelles demandes d'autorisation introduites dans les versions bêta des systèmes d'exploitation alertent les utilisateurs lorsque des requêtes génératives spécifiques sont transmises à des serveurs externes.
- Les modèles de fondation d'Apple et les charges de travail locales restent strictement séparés des pipelines d'exécution cloud tiers.
- L'architecture étendue introduit un modèle de délégation cloud hybride, utilisant des environnements isolés et chiffrés pour traiter les requêtes génératives complexes.
La conception de l'intelligence artificielle grand public repose sur un équilibre délicat entre traitement local et scalabilité cloud. Lorsque les modèles sur appareil effectuent des tâches de routine, les données restent stockées en toute sécurité dans la mémoire locale. Cependant, lorsque des fonctionnalités génératives gourmandes en ressources (comme la génération d'images avancée ou le traitement de présentations complexes) sont requises, le matériel local délègue le calcul à des clusters cloud haute performance. Cela pose un défi en matière de flux de données : comment un système peut-il augmenter ses capacités de calcul sans compromettre ses engagements fondamentaux en matière de confidentialité ?
Au cours des deux dernières années, les architectures d'IA hybrides sont devenues une stratégie de déploiement majeure pour les plateformes grand public. En tirant parti à la fois des modèles sur appareil et des réseaux de serveurs distants, ces services peuvent offrir des expériences génératives avancées sans surcharger le terminal de l'utilisateur. Toutefois, la nécessité d'équilibrer l'échelle cloud et la sécurité des données a orienté les priorités architecturales vers des environnements multi-cloud sécurisés et isolés.
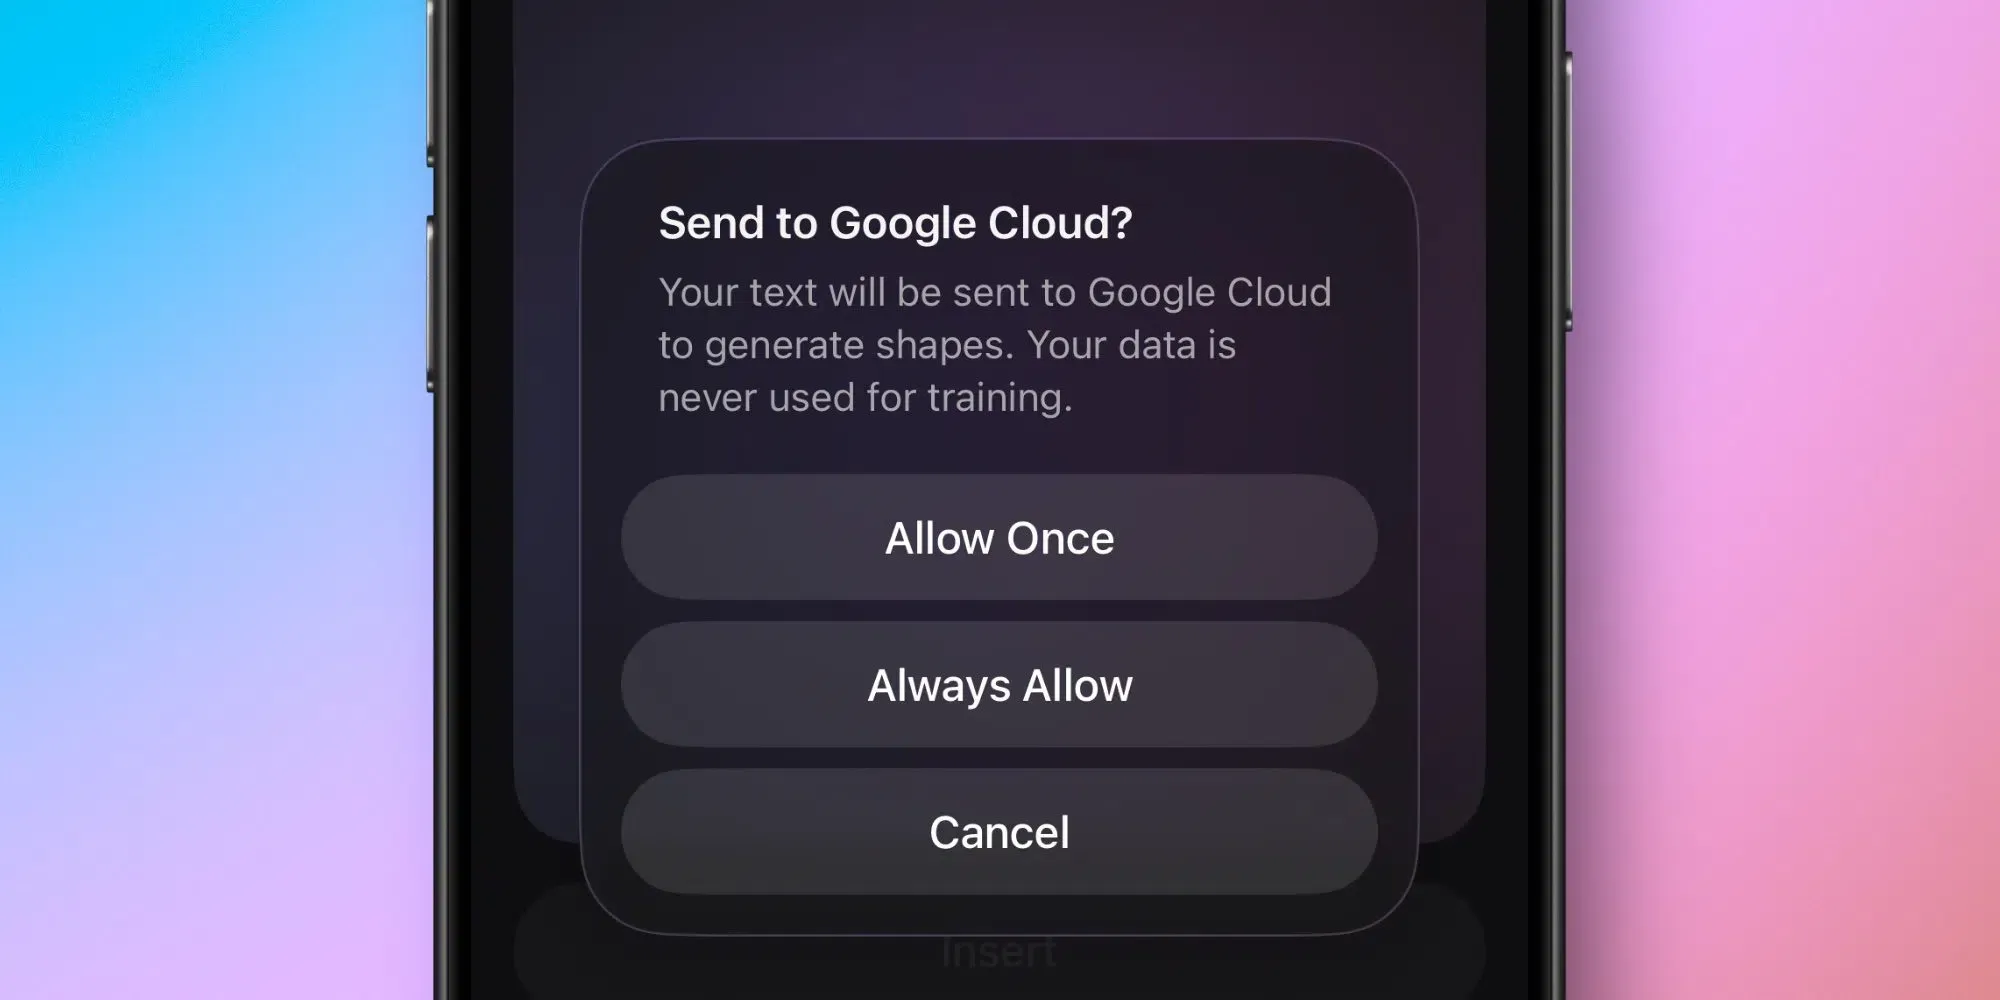
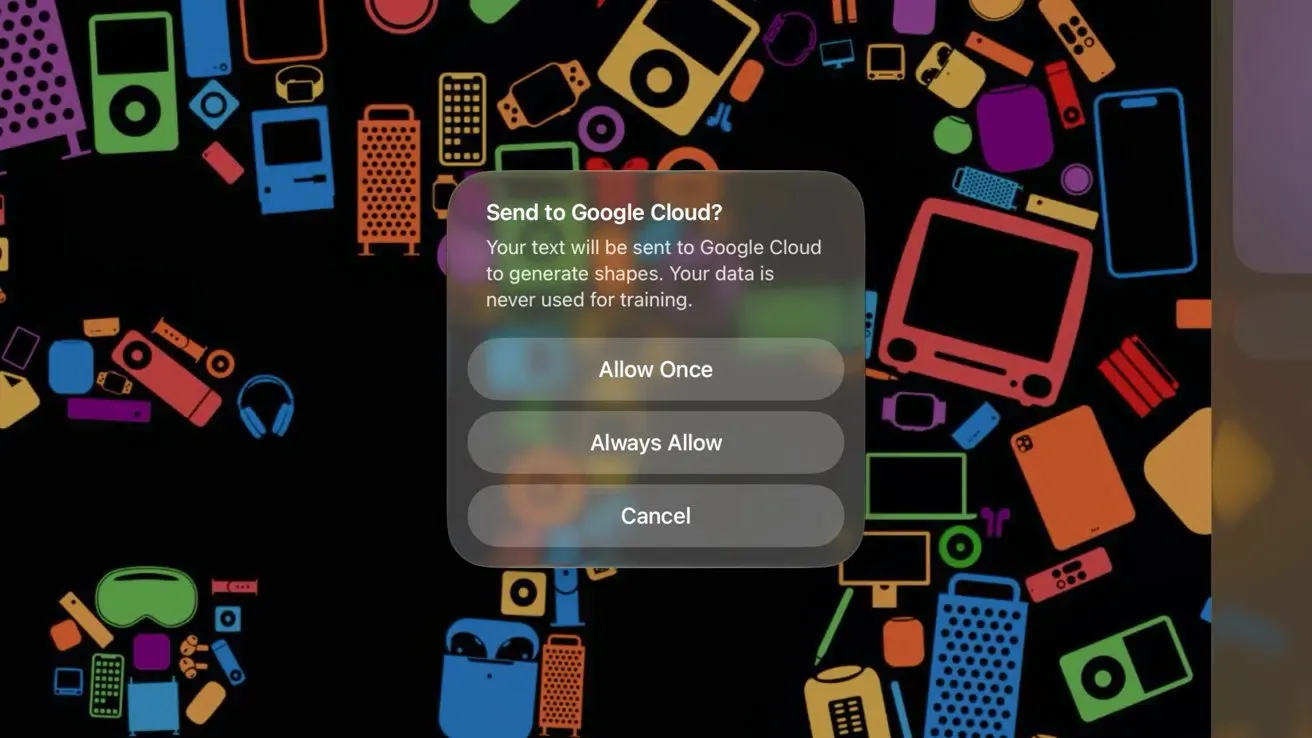
La décision d'Apple d'acheminer certaines requêtes IA vers Google Cloud dépasse la simple répartition des charges de travail. Dans ce cadre mis à jour, des charges de travail spécifiques non locales (telles que la génération d'images dans des applications de productivité ou le rendu avancé) déclenchent une demande d'autorisation explicite avant le routage des données vers les serveurs Google Cloud. Ce changement n'affecte pas les modèles de fondation sur appareil, qui continuent de s'exécuter localement. Comprendre comment Apple gère l'acheminement des requêtes IA vers des infrastructures externes permet aux développeurs d'évaluer comment le routage externe des requêtes génératives lourdes est rendu visible à l'utilisateur final, lui donnant le pouvoir d'accepter ou de refuser le transfert de données au cas par cas.
Mécanique interne : IA locale vs routage de requêtes IA hybrides
Le moteur fondamental de cette architecture hybride est la nécessité de maintenir des protections de confidentialité fortes tout en faisant évoluer l'infrastructure. Pour ce faire, l'opérateur de la plateforme étend ses modèles de sécurité « Private Cloud Compute » (PCC) directement aux centres de données tiers. Dans ce modèle collaboratif, les charges de travail déléguées à des serveurs externes sont traitées au sein d'environnements d'exécution hautement sécurisés et isolés, comme expliqué dans l'analyse des modèles de fondation Apple.
Ces nœuds sécurisés exploitent le sandboxing au niveau matériel, tel que des machines virtuelles confidentielles et des processus dédiés. Cela garantit que le fournisseur cloud externe ne peut ni stocker durablement, ni journaliser, ni utiliser les requêtes transmises pour l'entraînement de ses modèles. Les données sont traitées de manière éphémère et immédiatement supprimées une fois la tâche terminée. Cette architecture établit un modèle de routage sécurisé pour les services d'IA hybrides tout en préservant la confidentialité des utilisateurs.
Distinction technique : Redirection avec état vs Flux de session sans état
D'un point de vue technique, le routage de données entre plusieurs environnements cloud exige une isolation stricte des sessions. Dans les architectures classiques avec état, l'identité des utilisateurs est suivie à travers différents environnements via des cookies persistants, ce qui crée des risques importants de conformité et de fuite de données. À l'inverse, une approche sans état traite chaque requête comme un événement indépendant et isolé, garantissant qu'aucun contexte relationnel permanent n'est établi. Cet alignement potentiel se produit sans interaction directe de l'utilisateur, soulignant les défis techniques fondamentaux associés au sujet du routage des requêtes IA par Apple.
Le diagramme ci-dessous illustre cette séparation physique :
[Exécution standard sur appareil]
  Entrée utilisateur ──> Modèle de fondation Apple (Traitement local) ──> Aucune donnée ne quitte l'appareil


[Délégation cloud hybride]
  Entrée utilisateur ──> Passerelle de sécurité PCC ──> VM confidentielle Google Cloud ──> Contexte temporaire (Contexte souverain préservé)
La mise en œuvre d'un traitement des requêtes sans état minimise les identifiants persistants et réduit la quantité de données utilisateur conservées par la plateforme. Bien que la bande passante mémoire et l'attribution des applications appartiennent à des domaines techniques différents, les deux soulignent le même principe architectural : déplacer la gestion de l'état des ressources locales contraintes vers une infrastructure serveur scalable. Des défis similaires existent dans l'attribution mobile, où les restrictions de confidentialité réduisent également la dépendance aux identifiants côté client. Lorsque les interactions des utilisateurs sont dissociées des cookies locaux persistants avec état pour respecter les directives de confidentialité, le maintien de la continuité de session entre différents environnements devient très complexe. Tout comme les processeurs nécessitent des pipelines mémoire persistants et à haute vitesse pour faire correspondre les contextes d'état, les pipelines marketing en aval nécessitent une conservation robuste des données côté serveur pour corréler des événements d'installation distincts sans s'appuyer sur des cookies côté client ou des attributs au niveau de l'appareil.
Scénario exemple : Que se passe-t-il lors de la génération d'une image ?
Supposons qu'un utilisateur crée une présentation générée par IA dans la suite de productivité Apple. Si la requête dépasse les capacités du modèle de fondation local, le système d'exploitation affiche d'abord une boîte de dialogue d'autorisation expliquant que la tâche sera traitée par Google Cloud. Ce n'est qu'après une approbation explicite que la requête chiffrée est transmise via Private Cloud Compute vers un environnement d'exécution isolé. Une fois le traitement terminé, les données temporaires sont supprimées conformément à l'architecture de confidentialité publiée par Apple.
Construire ou acheter : Préserver le contexte de session dans les charges de travail IA hybrides
À mesure que les plateformes restructurent leurs cadres conversationnels pour se conformer aux directives strictes de protection des données, les développeurs doivent réévaluer la gestion de l'état des sessions et de l'identité des utilisateurs. La gestion des états de session là où Apple achemine les requêtes IA nécessite des architectures à la fois conformes aux lois sur la protection des données et extrêmement précises. De plus, lorsque Apple achemine les requêtes IA via des fournisseurs cloud externes, les organisations doivent s'éloigner des identifiants traditionnels au niveau de l'appareil. Selon les besoins métier, les équipes peuvent développer ces capacités en interne ou adopter des plateformes d'attribution existantes.
Évaluation architecturale : Développement personnalisé vs SDK standardisé
La création d'un système interne pour gérer la correspondance des états côté serveur offre une flexibilité maximale, mais exige des ressources d'ingénierie significatives et continues. Les développeurs doivent construire manuellement des schémas de base de données, écrire des fonctions de hachage cryptographique sécurisées et mettre à jour le système en permanence pour se conformer aux réglementations régionales changeantes. Inversement, le déploiement d'un SDK pré-construit et certifié réduit la complexité d'intégration et garantit une conformité à long terme sans surcoût opérationnel.
Le tableau ci-dessous compare les méthodologies standards de gestion de l'état de session et du contexte de conversion :
| Solution | Persistance | Débit | Idéal pour |
|---|---|---|---|
| Base de données de session interne | Élevée (Synchro continue) | Moyen (Latence DB) | Environnements d'entreprise personnalisés avec logique de stockage spécialisée |
| Suivi de session par navigateur | Faible (Cookies de session) | Faible (Pas de logs serveur) | Suivi de site Web basique avec peu de besoins de conversion inter-domaines |
| Cache côté serveur (ex: OpoInstall) | Aucune (Jetons de session temporaires) | Élevé (Bac à sable standardisé) | Attribution d'applications mobiles à grande échelle et campagnes multi-plateformes |
Bien que des configurations de base de données personnalisées puissent gérer un contexte basique, une préservation spécialisée de l'état côté serveur peut optimiser les ressources de développement. Selon les besoins, les organisations peuvent bâtir leur propre système de gestion de session côté serveur ou adopter des plateformes commerciales telles qu'OpoInstall. Par exemple, OpoInstall offre des frameworks de restauration d'état côté serveur et de transmission de paramètres, mappant les métadonnées de session vers une base de données côté serveur pour maintenir la continuité de session de manière anonyme, sans stocker d'historique conversationnel personnel sensible à long terme. En mappant les métadonnées de session vers une base de données centralisée plutôt que de compter sur des redirections basées sur le navigateur, un tel système garantit que les contextes de conversion restent cohérents même lorsque les tâches initiales sont exécutées anonymement. Les équipes d'ingénierie peuvent évaluer ces approches pour équilibrer protection des données et cohérence de la mesure.
Check-lists d'intégration : Comment les équipes techniques peuvent se préparer aux changements de plateforme
Pour se préparer à des charges de travail IA de plus en plus distribuées, les équipes techniques et produit doivent établir des calendriers de gouvernance des données clairs. Cela garantit que les données des utilisateurs sont traitées de manière sécurisée, que les limites de conformité sont respectées et que les pipelines marketing restent opérationnels.
Check-list d'implémentation pour les développeurs
- Auditer les transferts de données tiers : Examinez tous les appels d'API externes pour vous assurer que les charges de travail ne sont pas journalisées de manière permanente sur des relais intermédiaires.
- Implémenter des poignées de main de session sans état : Transitionnez les routes API vers des modèles de traitement sans état, en utilisant des jetons signés cryptographiquement pour transmettre le contexte temporaire entre les nœuds.
- Valider les flux de consentement tiers : Implémentez une validation explicite des demandes côté client avant de transmettre les charges de travail génératives vers des clouds externes.
Check-list Stratégie Produit et Croissance
- Optimiser les expériences d'IA hybride : Reconstruisez des fonctionnalités génératives orientées tâches et à haute utilité qui expliquent clairement aux utilisateurs les chemins de traitement IA externes.
- Optimiser les entonnoirs de conversion : Tirez parti de cadres de transmission de paramètres non intrusifs pour maintenir le suivi d'acquisition sans violer les directives de confidentialité des utilisateurs.
- Surveiller la conformité de la plateforme : Assurez-vous que tous les SDK tiers intégrés respectent les lois locales sur la protection des données et les exigences à venir de la plateforme.
En établissant ces lignes directrices structurées, les équipes de développement peuvent faire évoluer leurs applications vers des architectures plus sûres et conformes, tout en maintenant la continuité opérationnelle.
Foire aux questions (FAQ)
Pourquoi Apple affiche-t-il une fenêtre contextuelle avant d'envoyer des requêtes IA vers Google Cloud ?
Comment Private Cloud Compute garantit-il la sécurité des données utilisateur sur les serveurs tiers ?
Quelles requêtes d'IA Apple sont acheminées vers Google Cloud ?
Points clés pour les équipes d'ingénierie
Alors que les plateformes d'IA s'appuient de plus en plus sur l'inférence cloud hybride, les développeurs doivent repenser leurs produits autour de la confidentialité, du consentement transparent et du routage sécurisé des données. Les architectures de données en évolution exigent un changement fondamental dans la façon dont nous construisons et mesurons les expériences numériques. À mesure que les proxys sans état et les scrapers sans tête deviennent des consommateurs standards de contenu Web, les modèles d'attribution côté client traditionnels continueront de se dégrader. S'appuyer sur les cookies et référents standard ne suffit plus pour sécuriser les pipelines de données qui alimentent l'acquisition d'utilisateurs.
À mesure qu'Apple étend son infrastructure d'IA hybride, le routage cloud transparent et le consentement explicite des utilisateurs deviendront probablement des exigences architecturales standard dans toute l'industrie. À l'avenir, les équipes techniques s'appuieront de plus en plus sur des architectures sans état, une gestion de session côté serveur et une conception axée sur la confidentialité. Les organisations qui se préparent tôt à ces changements seront mieux positionnées pour maintenir des produits d'IA conformes et durables.
Share this article



