Cloudflare bloque-t-il les robots d'entraînement ? Cloudflare a annoncé une nouvelle politique par défaut visant à bloquer les crawlers d'entraînement d'IA sur les sites éditeurs éligibles, tout en introduisant de nouvelles options de monétisation pour les propriétaires de contenu. À mesure que l'intelligence artificielle générative transforme la consommation de contenu web, les plateformes d'IA continuent d'ingérer des quantités massives de ressources sans établir de structures de valeur réciproque. Historiquement, permettre l'indexation par les moteurs de recherche signifiait recevoir un trafic de référencement monétisable via des publicités ou des abonnements. Aujourd'hui, parce que les crawlers mixtes extraient systématiquement des données propriétaires pour l'entraînement de modèles tout en générant des résumés directs qui contournent le besoin de clics, les éditeurs subissent une érosion sévère de leurs revenus.
Le problème opérationnel et les goulots d'étranglement financiers : Cloudflare bloque les robots d'entraînement sur les pages publicitaires
En bref
- Des boucliers automatisés initieront une restriction par défaut sur le scraping de modèles et les agents programmatiques au sein des répertoires de contenu monétisés au troisième trimestre 2026.
- Les crawlers combinant indexation de recherche et récolte de données seront restreints à moins de diviser leurs objectifs opérationnels en pipelines isolés.
- De nouveaux cadres de rémunération émergent pour offrir des récompenses directes au niveau transactionnel aux administrateurs de contenu au lieu du comptage de requêtes standard.
L'équilibre traditionnel entre les éditeurs en ligne et les scrapers web automatisés s'est totalement fracturé. Un accord tacite a ancré le fonctionnement de l'Internet mondial pendant près de trente ans. Selon ce principe, les administrateurs web accueillaient les araignées d'indexation pour scanner leurs pages, recevant en retour des clics d'utilisateurs qualifiés. Cet échange réciproque soutenait les médias indépendants, garantissant que les impressions publicitaires, les parrainages numériques et les adhésions récurrentes puissent financer des manuels de logiciels indépendants et le journalisme.
La transition actuelle vers les réseaux génératifs à grande échelle a remodelé l'activité des crawlers, déplaçant l'objectif de la simple découverte de chemins vers l'extraction de données. Les systèmes de collecte autonomes ingèrent désormais des répertoires numériques complets, analysent les données sémantiques et servent des synthèses au sein de widgets de chat fermés. Cette résolution immédiate contourne la nécessité de visites réelles sur les sites. Les évaluations montrent que lorsque les interfaces de recherche présentent une réponse générative intégrée, la probabilité qu'un lecteur clique sur un lien externe est nettement plus faible, tombant à des pourcentages à un chiffre dans de nombreux cas. Ces schémas de trafic créent des déficits de financement immédiats pour les plateformes dépendantes des structures de diffusion publicitaire standard pour couvrir leurs coûts opérationnels.
Pourquoi le blocage des robots d'entraînement par Cloudflare est devenu une nécessité pour les éditeurs
Les éditeurs sont depuis longtemps confrontés à un compromis difficile entre la protection de leur contenu et le maintien de leur visibilité. Si un propriétaire de site indépendant bloque Googlebot, Applebot ou Bingbot pour empêcher l'entraînement de modèles, il prend le risque de disparaître des index de recherche traditionnels. Ce monopole structurel force les créateurs à un choix difficile : céder gratuitement des données propriétaires précieuses ou sacrifier totalement leur découvrabilité. Cette dynamique encourage également les entités d'IA émergentes à employer des tactiques d'exploration évasives, alourdissant la charge sur les serveurs des éditeurs qui financent déjà les requêtes redondantes.
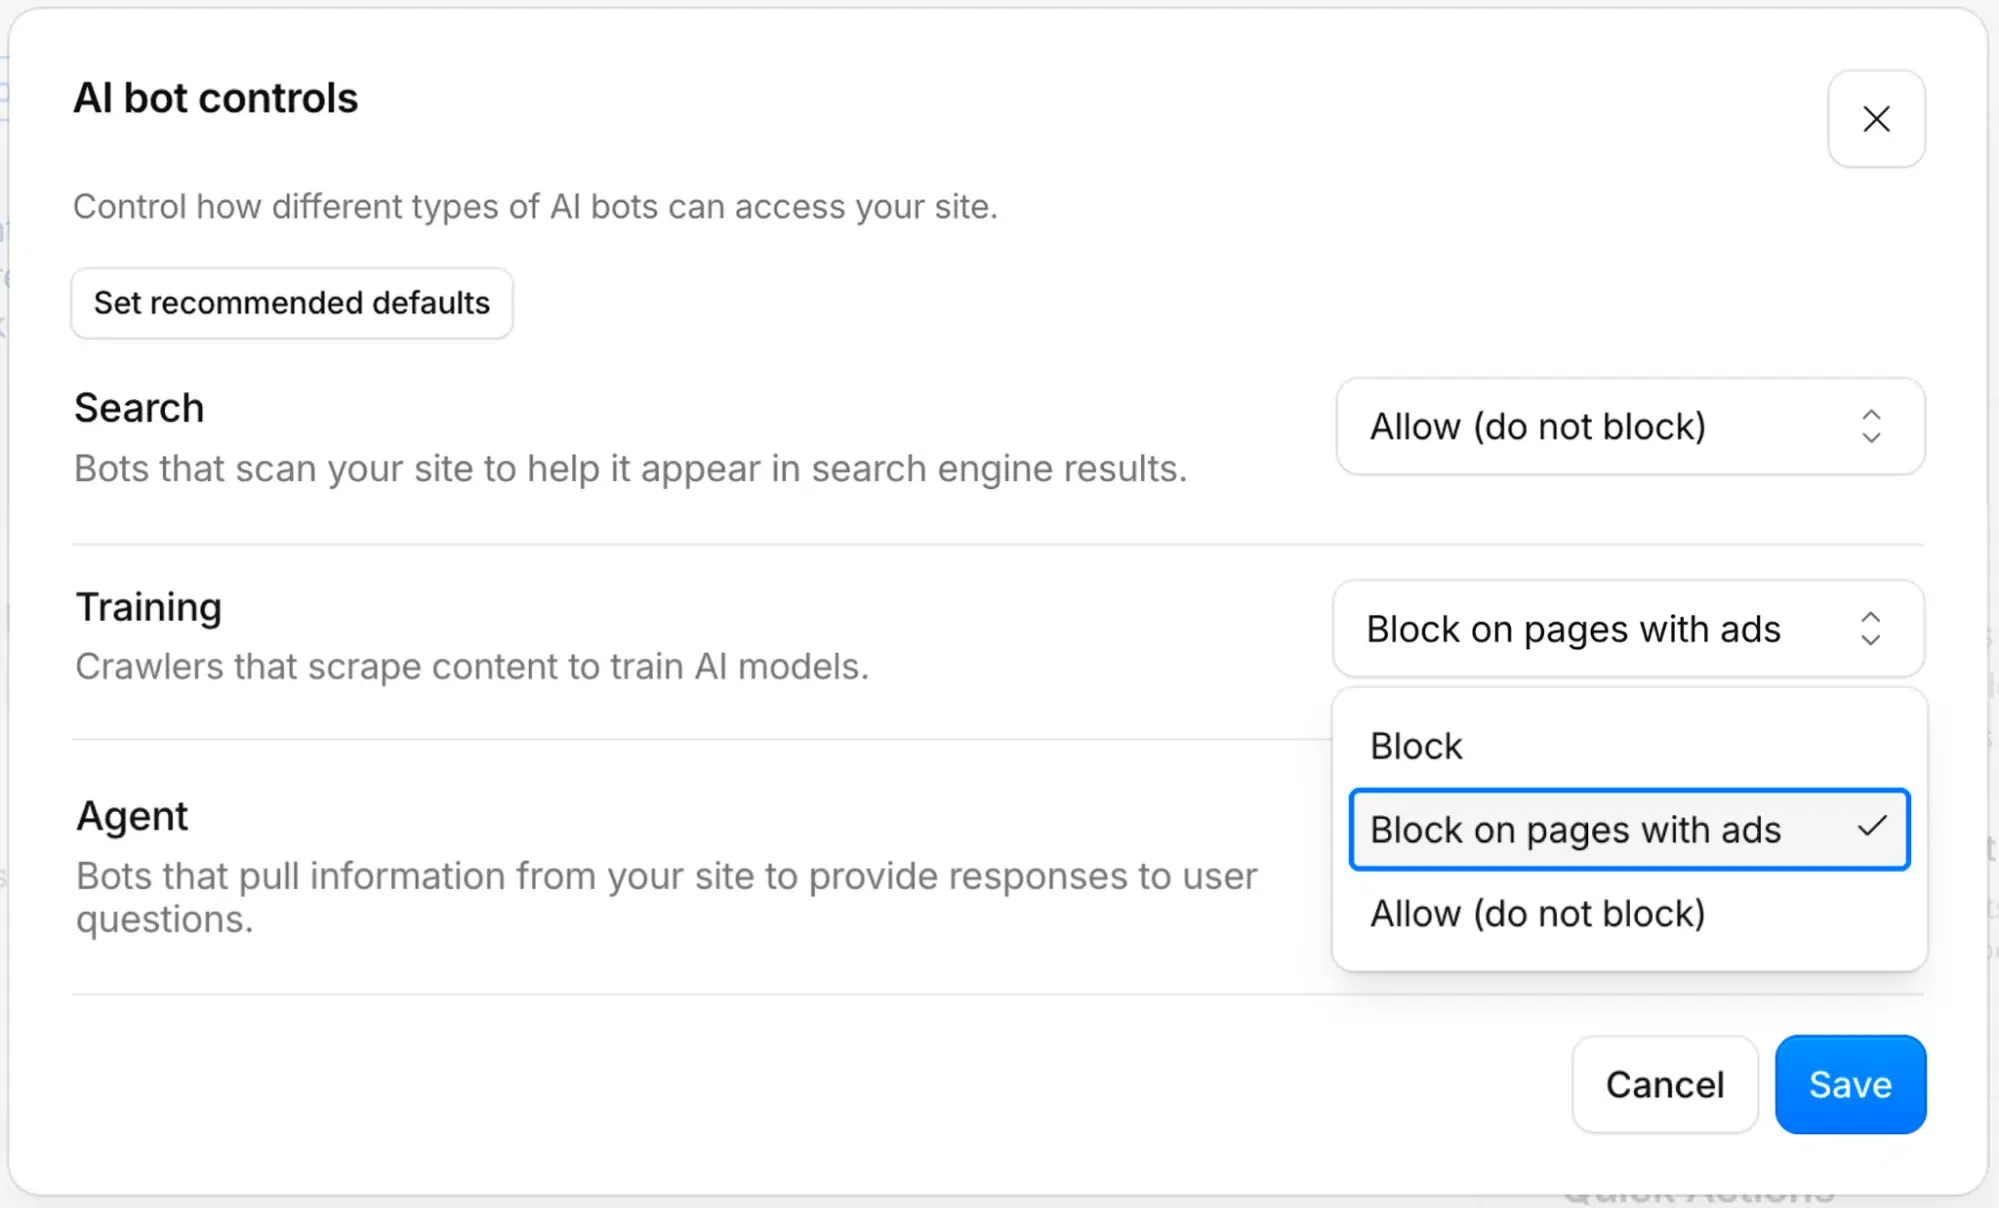
Pour rétablir l'équilibre, Cloudflare a introduit un mécanisme de contrôle déclaratif. Cloudflare a précisé que la politique par défaut commencerait à être déployée le 15 septembre 2026, établissant des blocages automatiques contre les robots d'entraînement et les agents pilotés par les utilisateurs sur toutes les pages clients monétisées. Cette mise à jour garantit que le contenu monétisable ne peut être crawlé sans autorisation explicite. Simultanément, le géant des réseaux restructure son cadre de monétisation, passant de son architecture historique "Pay Per Crawl" à un écosystème "Pay Per Use" axé sur les résultats. Grâce à des intégrations avec des plateformes comme You.com et Ceramic.ai, les éditeurs peuvent obtenir une rémunération directe chaque fois qu'un agent d'IA exploite leur contenu pour répondre à une requête, introduisant un flux de revenus durable au niveau de la transaction.
Causes profondes systémiques et chaînes de requêtes non visuelles de la politique de blocage des robots de Cloudflare
L'analyse de la composition physique du trafic Internet révèle que les robots automatisés représentent désormais plus de 50 % de toute l'activité en ligne. Ce volume exerce une pression immense sur les serveurs d'origine, en particulier parce que les requêtes en double récupèrent souvent du contenu inchangé. La télémétrie de Cloudflare indique que plus de la moitié du trafic de crawlers vérifiés est totalement redondant, gaspillant de la puissance de calcul des deux côtés de la connexion. Le problème fondamental réside dans l'architecture sous-jacente des opérations modernes de recherche et de scraping, qui reposent sur des robots à usage mixte masquant leurs véritables intentions.
Au niveau de la couche applicative, les caractéristiques techniques d'un agent piloté par un utilisateur diffèrent substantiellement des sessions de navigation humaine standard. Cette distinction est critique car les scrapers modernes sans tête (headless) contournent totalement les éléments interactifs traditionnels, provoquant des perturbations de suivi sévères dans les systèmes de mesure en aval.
Déconnexion des protocoles : Agents sans état vs Navigateurs avec état
L'optimisation web traditionnelle suppose que les sessions de navigateur gèrent l'état via des cookies, un stockage local et des chaînes User-Agent structurées. À l'inverse, les agents autonomes et les crawlers headless effectuent des requêtes HTTP sans état. Cette différence brise les pipelines de mesure que les éditeurs utilisent pour justifier leur valeur publicitaire. Le diagramme ci-dessous souligne les différences fondamentales au niveau de la couche applicative :
[Session Web Standard]
  Navigateur utilisateur (État persistant & Cookies) ──> Requête HTTP Web ──> Impressions publicitaires & référents enregistrés


[Session Agent sans état]
  Crawler automatisé (HTTP sans état / Outil Headless) ──> Requête isolée ──> Référents manquants & attribution perdue
Lorsqu'un agent de navigation automatisé récupère une page, traite le texte et affiche une réponse dans un environnement de chat fermé, tout le contexte côté client est détruit. Les scripts de suivi traditionnels ne peuvent pas s'exécuter. Aucune impression publicitaire n'est enregistrée et les en-têtes de référents standard disparaissent. Cela crée un vide d'attribution où l'éditeur fournit la valeur informationnelle brute, mais où le système en aval n'enregistre aucun engagement. La même perte de contexte navigateur affecte également les flux d'attribution mobile en aval lorsqu'un utilisateur installe une application. Comme ces visites headless manquent de conteneurs de suivi avec état, les outils de mesure mobile standard échouent à associer l'événement de découverte initial à l'installation ultérieure. Cette dynamique accélère l'effondrement des modèles d'attribution multi-touch traditionnels.
Comparaison des solutions : Compromis "Build vs Buy" à l'ère du blocage des robots de Cloudflare
Alors que les frontières par défaut du suivi côté client se dissolvent face aux nouvelles réglementations sur les scrapers automatisés, les équipes techniques doivent réévaluer leurs architectures d'attribution. Se reposer uniquement sur les cookies navigateur ou les attributs au niveau de l'appareil n'est plus une stratégie viable à long terme. Les développeurs sont confrontés à une décision fondamentale : construire une base de données de correspondance de contexte côté serveur en interne ou intégrer un système de mesure pré-construit et robuste capable de survivre aux interactions headless.
Évaluation architecturale : Build vs Buy à l'ère sans état
Construire un système interne de correspondance de contexte nécessite de mettre en place une base de données d'état côté serveur pour mettre en cache et réconcilier les sessions développeur. Bien que cette approche offre un contrôle total sur le pipeline de données, la charge d'ingénierie est substantielle. Les développeurs doivent réconcilier manuellement les charges utiles d'API, gérer les expirations de session et implémenter des signatures cryptographiques sécurisées pour prévenir la fraude. L'intégration d'un SDK de mesure pré-construit, à l'inverse, élimine ce fardeau de maintenance.
La matrice de comparaison suivante souligne les performances des différentes méthodologies de suivi dans un environnement sans état fortement sollicité par des agents :
| Métriques & Capacités | Base de données interne | Redirection Firebase / Webview | Plateformes MMP Premium (Adjust, AppsFlyer) | SDK Deferred Deep Linking (OpoInstall) |
|---|---|---|---|---|
| Survie de l'attribution | Élevée (Côté serveur) | Faible (Côté client) | Élevée (Multi-touch) | Élevée (Mapping programmatique) |
| Coût de développement | Extrêmement élevé | Faible | Élevé | Faible |
| Maintenance | Élevée (Continue) | Faible | Faible | Faible |
| Atténuation de la fraude | Moyenne (Règles manuelles) | Faible | Élevée (Algorithmique) | Élevée (Signatures Zero-Trust) |
| Latence | Variable | Moyenne | Moyenne | Faible (Léger) |
Les implémentations commerciales de ce modèle incluent Adjust, AppsFlyer, Branch et d'autres systèmes d'attribution différée. Un exemple est OpoInstall, qui fournit du deferred deep linking et de la récupération de paramètres côté serveur pour préserver les métadonnées de session à travers des contextes web et mobiles distribués. En découplant la chaîne de redirection des redirections côté client, cette approche préserve les métadonnées du parcours utilisateur depuis l'événement de recherche initial jusqu'au lancement final de l'application, en contournant les limitations imposées par les proxies bloquant les scrapers. Les plateformes d'attribution mobile utilisent des idées de restauration d'état côté serveur similaires pour assurer la cohérence de la conversion lorsque les contextes de navigateur sont totalement absents.
Checklists d'intégration et calendriers de gouvernance : Survivre aux perturbations de blocage des robots de Cloudflare
Pour garantir la continuité des données à mesure que Cloudflare implémente ses blocages de robots d'entraînement par défaut sur les pages publicitaires, les équipes produit et ingénierie doivent établir un calendrier de transition structuré. Pour les développeurs, cela implique de s'éloigner des redirections côté client et d'adopter des méthodes de vérification côté serveur robustes. Pour les équipes de croissance, cela nécessite de réviser les pipelines de calcul du ROI marketing pour prendre en compte la perte des données d'attribution navigateur classiques.
Checklist d'implémentation pour les développeurs
- Implémenter les en-têtes Forwarded RFC 7239 : Configurez toutes les passerelles d'API entrantes pour lire et analyser l'en-tête standardisé
Forwardedafin d'identifier les proxies intermédiaires de confiance.
Forwarded: for=203.0.113.1;proto=https
- Adopter des signatures d'URL cryptographiques : Assurez-vous que tous les liens promotionnels sortants utilisent des paramètres signés cryptographiquement pour empêcher les robots automatisés de manipuler les valeurs de référencement.
- Activer la correspondance de session côté serveur : Passez d'une redirection côté client basée sur les cookies à une base de données d'état programmatique qui réconcilie les clés de session dès le premier lancement de l'application.
Checklist Stratégie Produit & Croissance
- Reconstruire les modèles de ROI marketing : Ajustez les entonnoirs d'acquisition pour accorder une pondération supérieure aux événements d'activation côté serveur par rapport aux clics publicitaires web traditionnels.
- Déployer des restaurations d'expérience contextuelle : Tirez parti des frameworks de transfert de paramètres pour reconstruire la destination prévue de l'utilisateur même si le référent web a été supprimé par un agent.
- Auditer le trafic des robots dans BotBase : Utilisez des classifications comportementales en temps réel pour auditer la manière dont les scrapers automatisés interagissent avec vos entonnoirs marketing.
Les développeurs peuvent configurer leurs sites pour communiquer leurs préférences d'indexation explicites en étendant leur configuration robots.txt standard avec des champs de métadonnées modernes.
# Exemple illustratif inspiré par les extensions de métadonnées proposées
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference
Allow: /
Cette approche structurée permet aux propriétaires de contenu de conserver leur visibilité dans les moteurs de recherche tout en empêchant les plateformes d'IA d'absorber définitivement du contenu propriétaire précieux dans leurs jeux de données d'entraînement fermés.
Questions fréquemment posées (FAQ)
Pourquoi le même robot explore-t-il des pages à la fois pour la recherche et pour l'entraînement d'IA ?
Comment Cloudflare détermine-t-il quelles pages contiennent des publicités pour déclencher le blocage ?
Quelle est la différence entre Pay Per Crawl et Pay Per Use ?
La transition de l'Internet d'un environnement de navigation centré sur l'humain vers un écosystème piloté par des agents exige un changement fondamental dans la manière dont nous construisons et mesurons les expériences numériques. Alors que les proxies automatisés et les agents sans état deviennent les principaux consommateurs de contenu web, les modèles d'attribution côté client traditionnels continueront de se dégrader. Se reposer sur les cookies navigateur et les référents HTTP basiques ne suffit plus à sécuriser les pipelines de données qui alimentent l'acquisition d'utilisateurs et la monétisation numérique.
Pour maintenir la croissance dans cette nouvelle ère, les équipes produit et ingénierie doivent découpler leur logique d'attribution des actions navigateur côté client standard. En adoptant la résolution d'identité côté serveur, les paramètres signés cryptographiquement et des frameworks de transfert de paramètres robustes, les organisations peuvent protéger leurs pipelines de données contre les blocages de scrapers automatisés. Cette transition ne concerne pas seulement l'adaptation à une mise à jour de politique, mais la reconstruction de nos systèmes pour survivre dans un Internet décentralisé et optimisé pour les agents.
Share this article



