Comment identifier les événements in-app frauduleux dans le suivi des conversions ? L'identification des faux événements in-app nécessite d'auditer les bases de référence de latence spécifiques à chaque événement par rapport aux horodatages bruts, d'utiliser les statuts d'authentification des requêtes au niveau de la couche de sécurité et de filtrer les modèles d'exécution suspects dans les flux de données entrants.
La fraude aux événements in-app survient lorsque des scripts automatisés, des instances d'applications modifiées ou des charges utiles API non authentifiées transmettent des signaux de conversion invalides ou potentiellement synthétiques aux serveurs d'attribution. En auditant la télémétrie brute, en établissant des bases de référence empiriques de latence « clic-vers-événement » (CTET - Click-to-Event-Time) et en exploitant les verdicts d'authentification des requêtes provenant de couches de sécurité dédiées à l'ingestion, les équipes techniques peuvent classer et filtrer les flux d'événements invalides avant qu'ils n'intègrent les processus de mesure ou d'optimisation.
| Terme | Définition | Entité associée | Intention de recherche |
|---|---|---|---|
| Suivi des conversions | Enregistrement et traitement systématiques des jalons atteints par l'utilisateur après l'installation. | Flux de données brutes | Informationnel / Technique |
| Click-to-Event-Time (CTET) | Métrique dérivée mesurant la latence entre le point de contact et la réception de l'événement. | Moteur d'anomalies | Technique / Informationnel |
| Fraude publicitaire | Manipulation délibérée des métriques de performance via du trafic non humain ou des charges utiles usurpées. | Usurpation d'événements in-app | Informationnel / Sécurité |
Anatomie de la fraude aux événements in-app dans les pipelines de conversion
L'incitation commerciale : Paiements CPA vs Arbitrage sur les installations (CPI)
Les campagnes de marketing à la performance mobile reposent souvent sur des modèles au coût par action (CPA), où les éditeurs ne sont rémunérés que lorsqu'un utilisateur acquis atteint des jalons spécifiques. Ces jalons post-installation — comme terminer une inscription, compléter un parcours d'onboarding, souscrire à un essai ou effectuer un premier achat in-app — génèrent des paiements nettement plus élevés que de simples installations.
Cette structure financière crée des incitations économiques fortes pour que des acteurs malveillants simulent l'engagement post-installation. Plutôt que de générer d'importants volumes de téléchargements à faible valeur, des scripts automatisés imitent des jalons de conversion spécifiques pour extraire des commissions CPA. Si un pipeline d'ingestion d'événements accepte ces événements usurpés sans validation structurelle, les annonceurs règlent des commissions pour une activité commerciale inexistante tout en surévaluant des sources de trafic peu performantes.
Vecteurs de menace : Requêtes API S2S non authentifiées, clients modifiés et automatisations par script
Les événements in-app frauduleux pénètrent dans les pipelines de suivi de conversion principalement via trois vecteurs techniques :
- Usurpation via ingestion directe d'API : Les attaquants inspectent le trafic réseau de l'application mobile à l'aide d'outils de proxy pour identifier les points de terminaison d'ingestion, les en-têtes HTTP requis et les paramètres de charge utile JSON. Dans les intégrations faiblement authentifiées, des scripts serveur transmettent des requêtes d'événements synthétiques directement aux points d'ingestion, sans lancer de processus applicatif ni exécuter de code client.
- Binaires d'application client modifiés : Les attaquants décompilent, modifient et repackagent les paquets d'applications pour contourner les contrôles internes ou injecter des boucles de répartition d'événements automatisées. Ces clients modifiés tournent sur des appareils physiques ou des environnements virtualisés, générant une télémétrie système valide tout en effectuant des appels d'événements automatisés.
- Émulateurs et automatisation de périphériques par script : Des environnements mobiles virtualisés exécutent des instances automatisées contrôlées par des frameworks de script d'interface utilisateur (UI). Bien que le code de l'application s'exécute au sein d'un processus système réel, les séquences d'interaction, la vitesse de saisie et la latence reflètent des scripts d'automatisation plutôt qu'une interaction humaine.

La limite du modèle de menace : Pourquoi les clés symétriques stockées côté client ne garantissent pas la légitimité
Une limite de sécurité critique dans le suivi des conversions mobiles est l'hypothèse selon laquelle l'intégration d'une clé symétrique partagée (telle qu'un secret HMAC) dans un binaire client garantit l'authenticité de la charge utile. Dans les modèles de menaces mobiles standard, les binaires s'exécutent dans un environnement non fiable. Les attaquants peuvent extraire ces clés par ingénierie inverse statique, inspection dynamique de la mémoire ou frameworks de hooking à l'exécution.
Comme le souligne le guide OWASP Mobile Application Security Testing Guide (MASTG), les clés cryptographiques symétriques stockées dans les applications peuvent être compromises, permettant à un attaquant de générer des codes d'authentification de message (MAC) valides pour des charges utiles falsifiées. Par conséquent, les clés détenues par le client n'offrent qu'une défense en profondeur contre une altération occasionnelle ; elles ne constituent pas une racine de confiance absolue contre l'usurpation sophistiquée de SDK.
Pour obtenir des entrées d'authenticité robustes, les architectures modernes s'appuient sur des mécanismes d'attestation au niveau de la plateforme :
- Google Play Integrity : Les requêtes standard renvoient des jetons d'intégrité émis par la plateforme, liés cryptographiquement aux données de la requête via un
requestHash, avec une protection contre le rejeu gérée automatiquement par Google lors de la vérification du jeton. - Apple App Attest : Utilise une paire de clés générée par l'appareil, des défis ponctuels émis par le serveur et des assertions client signées, évaluées par rapport à des compteurs pour lier les requêtes sensibles à une instance d'application validée.
Il est crucial de noter que, bien que ces services fournissent des preuves sur l'intégrité du binaire, l'état de l'appareil ou la liaison de la requête, aucun mécanisme ne prouve que la conversion métier sous-jacente a été physiquement effectuée par un véritable utilisateur humain.
Contamination en aval : Comment les postbacks invalides désalignent les algorithmes d'enchères
Au-delà des paiements non mérités, l'usurpation d'événements non validés dégrade l'optimisation des campagnes publicitaires programmatiques. Les plateformes publicitaires utilisent les postbacks de conversion en temps réel pour entraîner des algorithmes d'enchères automatiques, comme l'optimisation par événement d'application (AEO) ou le coût par action cible (tCPA).
Les signaux de conversion invalides peuvent dégrader la qualité des données d'entrée là où les systèmes d'enchères partenaires consomment ces conversions ; les mécanismes détaillés de rétroaction des enchères et la dynamique d'allocation budgétaire sont traités dans l'article n°68. Filtrer ou suspendre les signaux d'événements inéligibles réduit l'exposition des systèmes d'optimisation en aval aux faux signaux positifs.
Définir le « Click-to-Event-Time » (CTET) comme métrique de latence dérivée
Définition du delta temporel : Le CTET correspond au temps de réception moins le temps d'enregistrement du clic
Dans cet article, le CTET est défini opérationnellement par la limite de réception du serveur, représentant la latence entre le clic et la réception de l'événement plutôt qu'une mesure infaillible du moment exact de l'exécution physique par l'utilisateur. Mathématiquement, le CTET pour un événement
Où
Différencier les horodatages serveurs des horloges client
Une évaluation précise de la latence nécessite une séparation technique stricte entre les horodatages rapportés par le client (
Se fier exclusivement aux horodatages client permet aux scripts d'usurpation d'injecter des temps historiques arbitraires, faisant paraître un événement automatisé comme s'il s'était produit des heures ou des jours après le clic publicitaire. Les passerelles d'ingestion doivent assigner un horodatage serveur immuable (
Gestion de la mise en file d'attente hors ligne : Différencier les lots réseau des anomalies en temps réel
Les applications conçues pour une connectivité intermittente mettent en file d'attente les événements post-installation localement lorsque l'accès réseau est indisponible. Une fois la connexion rétablie, le client télécharge la télémétrie accumulée en un lot agrégé.
Si un moteur d'attribution évalue ces événements strictement par rapport à l'horodatage serveur (
Évaluer la portée de la latence : Acquisitions vs contextes de réengagement
La portée analytique du CTET dépend entièrement du contexte d'attribution. Pour l'acquisition de nouveaux utilisateurs,
Étant donné que le retargeting contourne les téléchargements sur le store et les processus d'installation système, la latence de base pour les actions in-app post-clic est nettement plus courte que dans les flux d'acquisition. Les moteurs d'anomalies de latence doivent ajuster dynamiquement leurs modèles de base selon le type de campagne pour éviter de classer à tort des conversions légitimes de retargeting comme des anomalies.
Cadre technique pour l'audit empirique des bases de référence de latence CTET
Ingestion de flux télémétriques non traités pour l'étalonnage
La construction d'un cadre efficace d'évaluation des anomalies CTET nécessite l'ingestion de télémétrie non agrégée. Les SDK clients transmettent les déclencheurs d'événements ainsi que le contexte de session aux passerelles d'ingestion à la périphérie (edge).
Les équipes peuvent consulter la documentation actuelle d'OpoInstall pour connaître les capacités d'attribution et d'intégration SDK disponibles ; les pipelines d'ingestion d'événements et les structures à 5 couches décrites dans cet article représentent des architectures de référence et des modèles d'implémentation recommandés plutôt que des contrats d'API de production documentés.
Établir des distributions de latence calibrées par événement et par campagne
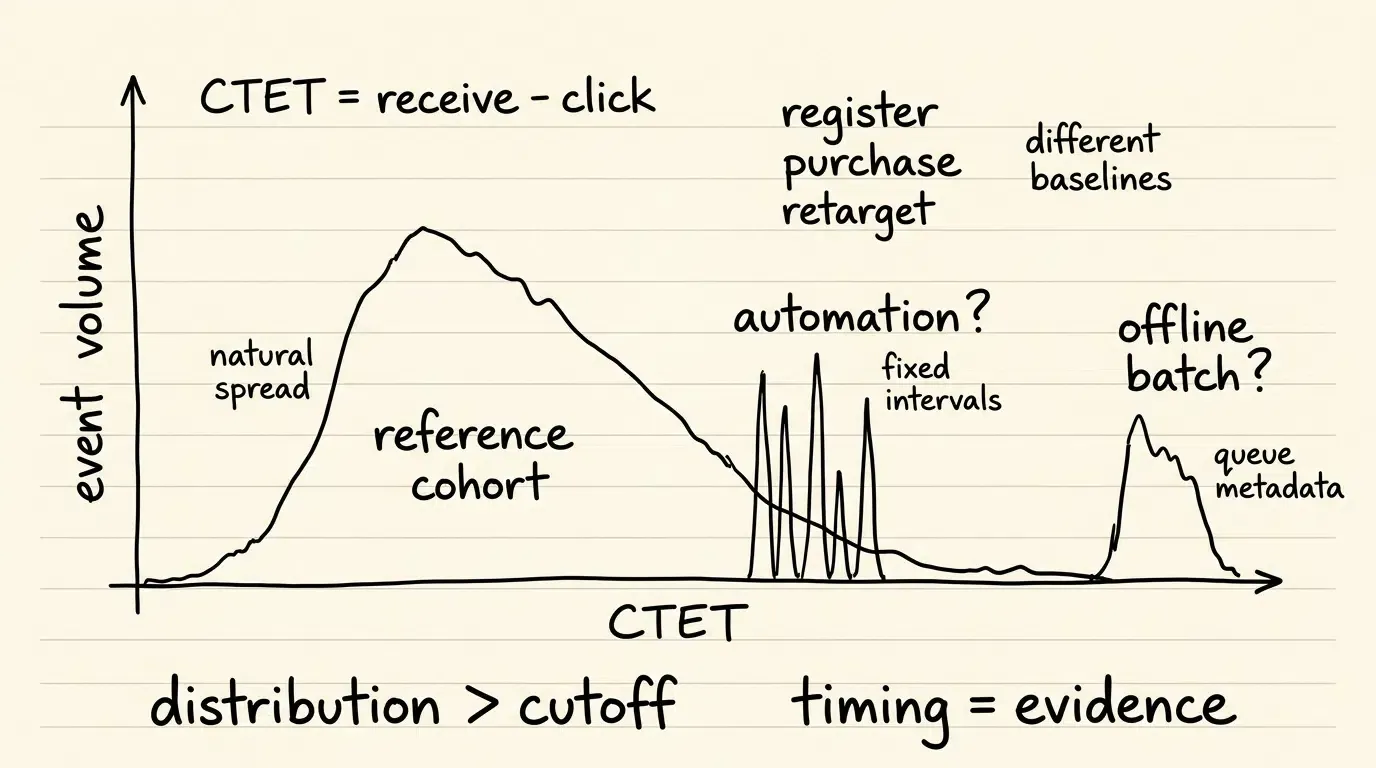
L'interaction humaine avec les applications mobiles produit des modèles de latence variables selon le jalon d'événement spécifique. L'inscription à un compte nécessite généralement moins de temps que la réalisation d'un flux de vérification d'identité ou l'atteinte d'un jalon élevé dans un jeu mobile.
Plutôt que d'imposer des seuils de latence universels et arbitraires, les équipes d'ingénierie doivent établir des bases de référence empiriques pour chaque type d'événement. Ces bases sont calculées en analysant les distributions historiques de conversion au sein de cohortes historiques à faible risque, segmentées par type de campagne et région géographique.
Modèle d'étalonnage de base de référence empirique :

Distribution CTET des cohortes qualifiées (étalement de latence hétérogène) :
Volume |        /\
       |       /  \
       |      /    \________  (Distribution empirique des quantiles)
       +-----------------------------------> Temps écoulé

Regroupement de latence non naturel (Indicateur d'automatisation potentiel) :
Volume |   |      |      |
       |   |      |      |
       |   |      |      |    (Pics d'intervalles statiques : signalés pour audit)
       +-----------------------------------> Intervalles de temps fixes
Traiter les écarts de latence comme des preuves diagnostiques plutôt que des coupures universelles
Un événement tombant dans un quantile anormalement précoce ou dans la queue de distribution à faible probabilité justifie une enquête. Plutôt que de supposer des distributions gaussiennes ou de traiter les valeurs inférieures à la moyenne comme des anomalies — ce qui exclurait une grande partie du trafic légitime — les systèmes de production évaluent les quantiles inférieurs empiriques ou les résidus standardisés robustes.
Le blocage automatique basé uniquement sur un seuil temporel statique risque d'exclure des utilisateurs convertissant rapidement de manière légitime, comme ceux bénéficiant de connexions haut débit ou réalisant des authentifications de compte en un clic. Les scores de latence doivent agir comme un facteur diagnostique pondéré au sein d'un moteur de disposition multi-métriques, et non comme une preuve définitive de fraude.
Visualisation du pipeline d'ingestion, de vérification et de disposition
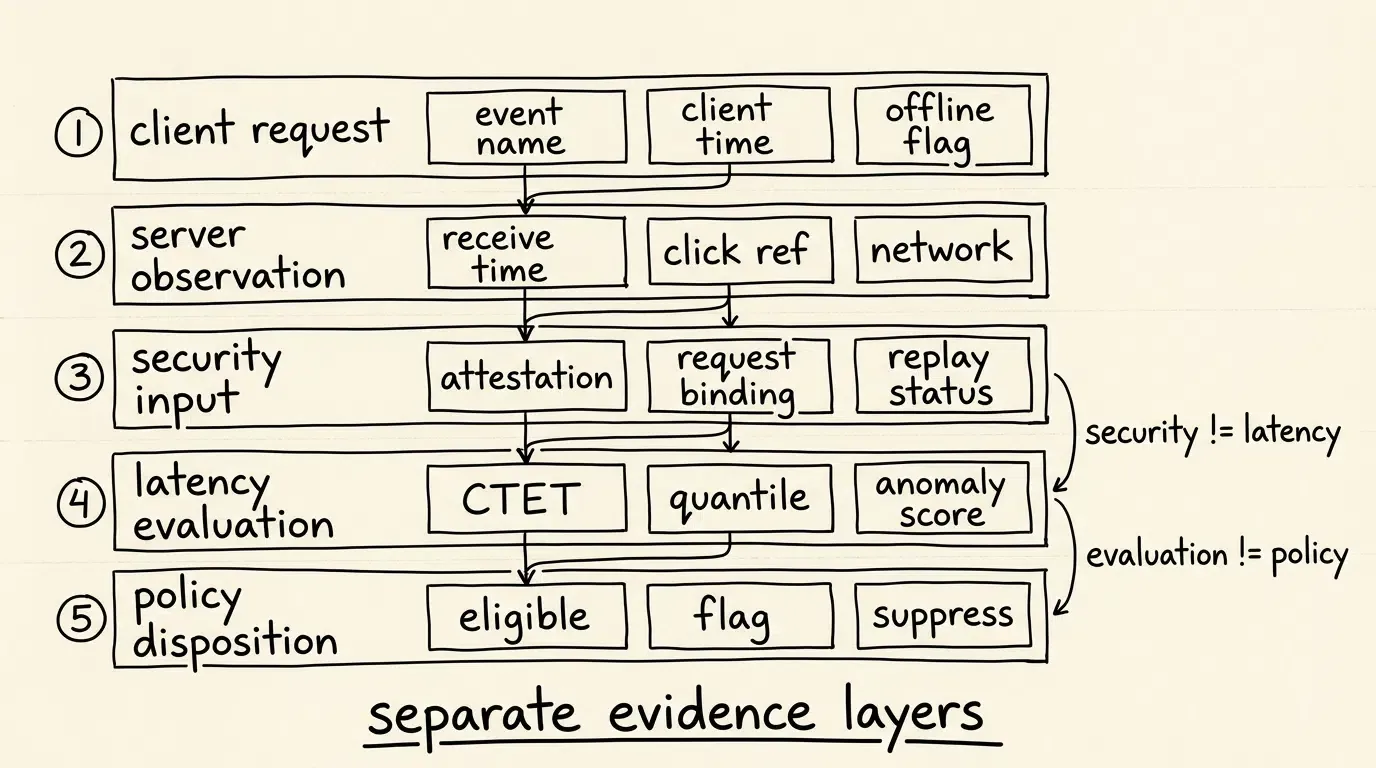
Le diagramme de workflow ci-dessous illustre comment la télémétrie brute des événements transite par l'ingestion à la périphérie, interagit avec les entrées de vérification de sécurité, évalue la latence par rapport aux bases empiriques et exécute la disposition des politiques :
[Clic d'engagement publicitaire enregistré (T_click)] ──> [Événement in-app survient]
             │                                            │
             ▼                                            ▼
  Horodatage serveur enregistré                   Le client transmet la requête d'événement
             │                                            │
             └──────────────────────┬─────────────────────┘
                                    │
                                    ▼
                       [Passerelle d'ingestion edge]
                                    │
                                    ├─► Verdict de sécurité d'ingestion (Article #65)
                                    │   (Statut d'authentification, App Attest / Play Integrity)
                                    │
                                    ├─► Moteur d'audit de latence (Article #69)
                                    │   (Calcul delta CTET vs. base calibrée)
                                    │
                                    ▼
               [Modèle de disposition d'événements à 5 couches]
                                    │
                  ┌─────────────────┴─────────────────┐
                  ▼                                   ▼
  [Disposition Événement Éligible]     [Disposition Événement Anomalie]
  (Enregistré & Éligible au postback)          (Signalé, supprimé ou abandonné)
Intégrer les vérifications de sécurité partagées et les entrées de résistance au rejeu
Consommer les verdicts d'authentification des couches de sécurité dédiées
Les contrôles d'authentification des requêtes et de résistance au rejeu doivent être implémentés par la couche de sécurité partagée décrite dans l'article n°65. Cet article consomme le statut de vérification résultant comme une entrée de risque d'événement.
Plutôt que de tenter de dupliquer la vérification cryptographique, le stockage de nonces ou la protection contre le rejeu au sein du moteur de latence, les pipelines de conversion ingèrent les drapeaux de sécurité en amont. Cette séparation architecturale garantit que la sécurité du transport et l'intégrité cryptographique restent découplées du traitement fonctionnel des événements métier.
Limites du stockage des clés côté client : Se fier aux attestations d'intégrité de plateforme
Étant donné que les clés symétriques côté client ne peuvent garantir l'immunité contre l'ingénierie inverse, les architectures mobiles modernes s'appuient sur des frameworks d'attestation au niveau de la plateforme.
Les requêtes Google Play Integrity Standard fournissent des jetons liés aux données de la requête via requestHash, tandis qu'Apple App Attest utilise des clés d'instance d'application attestées, des défis serveur et des assertions signées. Les deux mécanismes fournissent des preuves de sécurité originaires de la plateforme, mais aucun ne prouve que la conversion sous-jacente a été générée par un humain. L'implémentation détaillée de la signature de charge utile, de la gestion du cycle de vie des clés et des protocoles de défense contre le rejeu est traitée dans l'article n°65.
Pour obtenir des builds de SDK client intégrant les contrôles de télémétrie standard, les équipes d'ingénierie peuvent consulter les ressources d'intégration SDK.
Structurer le schéma de disposition d'événement à 5 couches
Pour garantir la traçabilité et maintenir une séparation technique claire, les enregistrements d'événements doivent adhérer à un schéma de référence structuré à 5 couches.
L'espace réservé ci-dessous illustre un enregistrement de vérification où chaque étape est isolée pour une cible de plateforme unique :
{
  "reference_architecture": true,
  "event_disposition_record": {
    "layer_1_client_request": {
      "platform": "Android",
      "app_id": "com.example.application",
      "client_event_id": "evt_checkout_99812",
      "event_name": "checkout_completed",
      "event_value_cents": 1999,
      "currency": "USD",
      "client_reported_timestamp_ms": 1785985965120,
      "session_token": "sess_8832a10c-58cc-4372-a567-0e02b2c3d479",
      "offline_queued_flag": false
    },
    "layer_2_server_observation": {
      "server_authoritative_timestamp_utc": "2026-08-06T03:12:45.120Z",
      "ingestion_edge_node_id": "edge_us_east_04",
      "click_reference_timestamp_utc": "2026-08-06T03:10:00.000Z",
      "network_asn": "AS7018",
      "request_ip_classification": "residential_isp"
    },
    "layer_3_security_layer_input": {
      "security_layer_article_reference": "Article #65",
      "platform_integrity_evaluation_status": "verified_platform_integrity",
      "attestation_provider": "google_play_integrity",
      "attestation_verdict": "MEETS_DEVICE_INTEGRITY",
      "request_binding_status": "matched_request_hash",
      "replay_protection_mode": "play_integrity_standard_managed",
      "derived_replay_risk_status": "low_risk"
    },
    "layer_4_latency_evaluation": {
      "baseline_model_type": "empirical_quantile_model",
      "calculated_ctet_seconds": 165.12,
      "empirical_quantile_rank": 0.42,
      "illustrative_baseline_mean_seconds": 180.0,
      "illustrative_baseline_stddev_seconds": 45.0,
      "latency_anomaly_score": 0.08,
      "latency_evaluation_verdict": "within_expected_distribution_range"
    },
    "layer_5_policy_disposition": {
      "attribution_decision_source": "upstream_attribution_engine",
      "disposition_state": "policy_eligible_and_processed",
      "attribution_status": "attributed_to_click",
      "ad_network_postback_eligible": true,
      "reason_codes": [
        "PLATFORM_INTEGRITY_CHECK_PASSED",
        "CTET_LATENCY_NORMAL"
      ]
    }
  }
}
Exécution des politiques de disposition : Suppression silencieuse, signalement d'audit et postbacks sélectifs
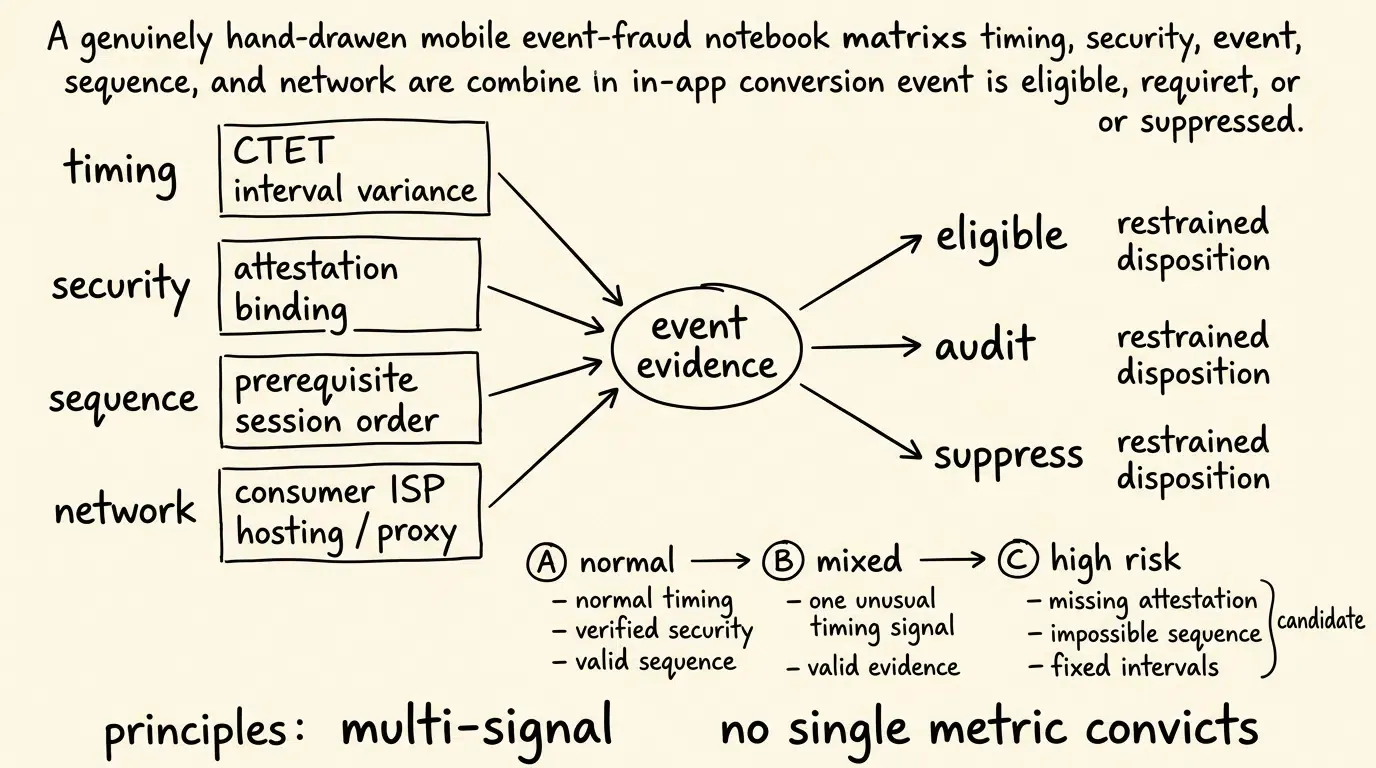
Une fois qu'une charge utile d'événement est évaluée par le moteur de disposition, le système applique l'une des trois politiques principales :
- Éligible et traité : L'événement respecte les critères de latence et possède un statut d'authentification vérifié. Il est enregistré dans les bases de données et devient éligible aux rapports ou aux postbacks partenaires.
- Signalé pour audit : L'événement présente de légers écarts temporels ou un contexte réseau inhabituel, mais possède un statut de sécurité valide. Il est consigné avec un drapeau d'anomalie, tandis que les postbacks publicitaires peuvent être suspendus en fonction de la configuration.
- Supprimé ou abandonné : L'événement échoue aux contrôles d'authentification ou présente des anomalies multi-signaux à haute confiance ou des séquences impossibles. La requête est abandonnée à la périphérie pour éviter de polluer les données.
Indicateurs d'anomalies d'événements et matrice d'évaluation empirique
Télémétrie multidimensionnelle : Évaluer latence, contexte réseau et signaux de sécurité
La détection précise des anomalies repose sur l'évaluation simultanée de multiples dimensions. Combiner les deltas de latence avec les propriétés de l'infrastructure réseau et les verdicts de sécurité de la plateforme minimise les faux positifs tout en identifiant des tentatives d'usurpation automatisées sophistiquées.
Configuration des indicateurs de diagnostic pour l'enquête sur les anomalies
La matrice ci-dessous décrit les principaux indicateurs télémétriques, signaux d'anomalies potentiels et actions de diagnostic pour les pipelines de conversion :
| Dimension télémétrique | Signal de référence attendu | Indicateur d'anomalie potentiel | Action d'évaluation |
|---|---|---|---|
| Delta de latence CTET | Quantiles inférieurs/supérieurs empiriques | Latence observée dans la région inférieure anormale | Signaler pour audit CTET ; croiser avec le statut de lot hors ligne |
| Statut d'authentification | Vérifié via attestation plateforme / clé S2S | Signature non vérifiée ou attestation manquante | Marquer comme requête non authentifiée ; rejeter si nécessaire |
| Variance d'intervalle | Dispersion naturelle sur les sessions utilisateurs | Regroupement de pics à intervalles exacts | Inspecter pour automatisation par boucle de minuterie |
| Contexte réseau | Distribué sur les FAI grand public | Concentration sur infrastructure hébergée ou proxy | Croiser avec les signaux d'intelligence réseau |
| Logique de séquence | Précédé de prérequis logiques (ex. Installation) | Conversion sans session antécédente | Signaler comme payload orphelin ; inspecter chaîne d'attribution |
Quand appliquer le filtrage automatisé et les politiques de disposition
Conditions adaptées au filtrage automatisé
Les règles de filtrage automatisé offrent une protection maximale dans des conditions spécifiques :
- Campagnes CPA actives : Programmes offrant des paiements pour des jalons post-installation, attirant des scripts d'usurpation ciblés.
- Pipelines d'optimisation programmatique : Campagnes réinjectant des signaux d'événements vers les systèmes d'enchères automatiques, où les signaux invalides peuvent fausser les algorithmes.
- Architectures d'ingestion à haut volume : Environnements traitant de gros volumes où l'audit manuel est impossible.
Conditions inadaptées au blocage agressif
L'application d'un blocage agressif sans étalonnage empirique peut causer des problèmes dans certains contextes :
- Apps ou fonctionnalités nouvellement déployées : Applications manquant de données historiques, où des règles de latence rigides pourraient classer à tort un engagement légitime comme frauduleux.
- Environnements « Offline-first » : Applications mettant en file d'attente des événements légitimes lors d'une utilisation hors ligne et les téléchargeant par lots lors de la reconnexion.
Pièges courants dans la gestion des anomalies de conversion
- Piège 1 : Se fier à un seuil de latence universel unique : Appliquer une limite temporelle statique à toutes les campagnes crée des faux positifs sur divers environnements et campagnes de retargeting. Les bases de référence doivent être calibrées par type d'événement et contexte de campagne.
- Piège 2 : Croire que les clés symétriques garantissent l'authenticité : Stocker une clé HMAC dans un binaire ne prévient pas l'usurpation de SDK, car les attaquants peuvent extraire ces clés par ingénierie inverse. Une vérification de haute assurance nécessite des attestations d'intégrité de plateforme et une validation côté serveur.
Questions fréquemment posées (FAQ)
Comment les événements in-app usurpés contournent-ils le suivi des conversions côté client ?
Pourquoi établir les seuils de latence empiriquement plutôt que via des seuils fixes ?
Comment le filtrage des anomalies protège-t-il les signaux d'enchères publicitaires ?
Résumé et cadre de décision
L'identification et le filtrage des faux événements in-app nécessitent un cadre de diagnostic empirique et multicouche plutôt qu'une dépendance à des secrets côté client ou des seuils de latence statiques. La protection des pipelines de données de conversion repose sur la séparation des charges utiles des requêtes client et des horodatages faisant autorité côté serveur, la consommation de verdicts d'authentification robustes provenant de couches de sécurité dédiées et l'audit de la latence des événements par rapport à des bases de référence calibrées empiriquement.
À mesure que les écosystèmes mobiles évoluent, les équipes d'ingénierie doivent déployer des architectures d'ingestion qui valident les attestations d'intégrité de plateforme tout en maintenant une séparation nette entre sécurité, évaluation temporelle et application des politiques. L'intégration de contrôles de référence empiriques avec des règles de disposition structurées permet aux applications mobiles de maintenir des datasets de conversion propres et d'améliorer la confiance dans la mesure du retour sur investissement publicitaire (ROAS).
Pour évaluer comment l'audit des événements bruts et l'évaluation des anomalies peuvent sécuriser votre infrastructure de suivi des conversions, consultez la documentation sur le suivi des conversions mobiles, référez-vous à la documentation d'implémentation de l'attribution mobile, ou connectez-vous à la console développeur OpoInstall pour examiner les contrôles disponibles contre la fraude et les rapports d'anomalies.
Matériels connexes
-
Concepts : Click-to-Event-Time, Métriques de latence dérivées, Usurpation d'événements in-app, Politique de disposition des événements
-
Technologies : Ingestion de télémétrie brute, API d'intégrité de plateforme, Schémas d'événements à 5 couches, Moteur d'anomalies
-
Normes : Spécification RFC 2104 HMAC & Limites des secrets partagés, Guide OWASP MASTG sur le test de la cryptographie
-
API : Interfaces d'ingestion d'événements (Architecture de référence), Requêtes Google Play Integrity Standard, API Apple App Attest
-
Documentation officielle & Références :
Share this article



