 La question soulevée par un expert de Hynix concernant l'inactivité des GPU est d'une importance capitale. Selon une présentation du professeur Joungho Kim du KAIST, qui a collaboré étroitement avec SK Hynix sur la recherche HBM, l'utilisation des GPU lors de l'inférence IA est de plus en plus limitée par la bande passante mémoire plutôt que par la capacité de calcul brute. Ce « mur de la mémoire » croissant a fait de la mémoire à large bande passante (HBM) l'une des technologies les plus cruciales pour l'infrastructure IA. À mesure que les plateformes d'intelligence artificielle générative passent de l'ère de l'entraînement à celle de l'inférence, le principal goulot d'étranglement des performances s'est déplacé de la capacité de calcul brute du processeur vers le débit du bus mémoire. Les unités de traitement graphique (GPU) standard sont conçues pour gérer des calculs parallèles massifs. Cependant, comme chaque étape d'inférence nécessite la lecture de milliards de paramètres en mémoire, l'exécution du calcul et la réécriture des états, les processeurs passent la majeure partie de leurs cycles opérationnels en veille, en attente du transfert de données sur les bus classiques.
Pourquoi la mémoire HBM est déterminante : aligner les pipelines à haut débit sur les limites matérielles
En un coup d'œil
- L'analyse du secteur suggère que même avec des millions d'unités de traitement graphique standard déployées, l'utilisation réelle du calcul est limitée à dix ou trente pour cent en raison des délais de transfert du bus mémoire.
- Les limites physiques de la mise à l'échelle des puces entraînent un changement de paradigme vers une informatique centrée sur la mémoire, utilisant des architectures de mémoire à large bande passante (HBM) empilées verticalement.
- Le conditionnement composite 3D de nouvelle génération devrait permettre d'empiler les unités de traitement graphique, le cache SRAM haute vitesse intégré et le stockage flash 3D NAND haute capacité pour résoudre les goulots d'étranglement des transferts de données.
L'infrastructure informatique mondiale fait face à une crise structurelle. Pendant plusieurs années, la course à la construction de modèles d'IA plus vastes s'est concentrée sur la mise à l'échelle de la puissance de calcul brute. Les entreprises et les fournisseurs de cloud ont investi des milliards de dollars dans l'acquisition de clusters massifs de GPU. Cette approche était logique durant l'ère initiale de l'entraînement, lorsque la formation des modèles dépendait de calculs continus de rétropropagation. Dans ces charges de travail, les unités de calcul parallèle fonctionnaient à capacité maximale pour mettre à jour les paramètres du modèle, comme détaillé dans le livre blanc sur l'architecture Hopper de NVIDIA.
Cependant, avec le passage des applications à l'ère de l'inférence, les besoins techniques ont évolué. Dans les scénarios d'inférence, le défi principal ne réside plus dans la mise à jour des poids, mais dans le streaming massif de paramètres pré-entraînés vers le processeur pour répondre aux requêtes immédiates. Chaque jeton généré nécessite un accès répété à des milliards de paramètres de modèle stockés dans la mémoire à large bande passante. Comme les architectures de bus standard ne peuvent pas déplacer les données assez rapidement pour correspondre aux vitesses d'exécution des processeurs, les cœurs de calcul manquent de données, ce qui entraîne des taux d'inactivité extrêmement élevés. Ce goulot d'étranglement est abordé dans des rapports techniques, notamment les recherches publiées par des organismes universitaires tels que le Korea Advanced Institute of Science and Technology (KAIST) et des développeurs de matériel comme NVIDIA et SK Hynix.
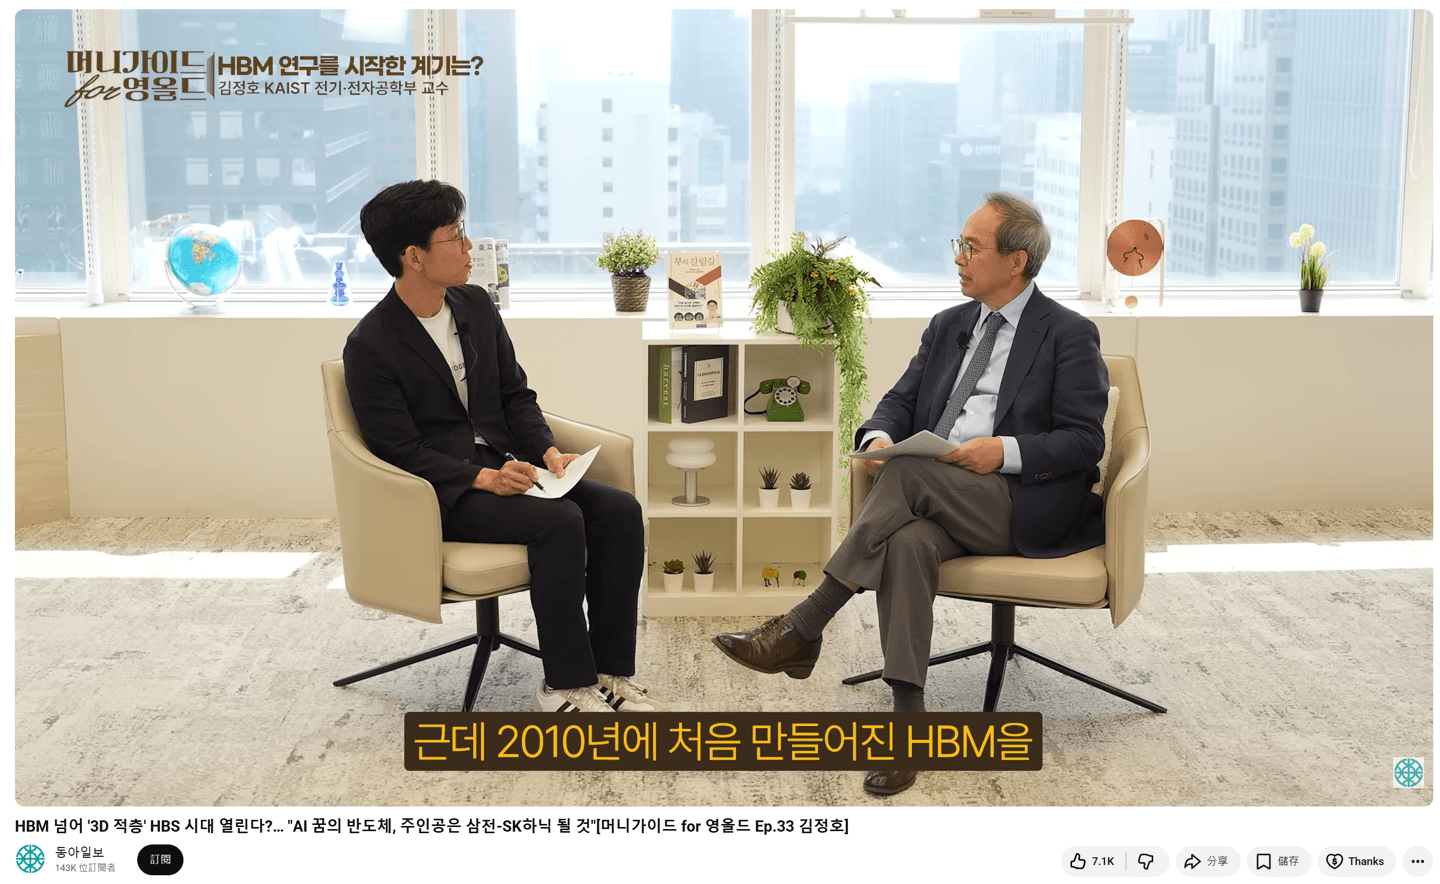
Cet écart de performance démontre les contraintes physiques qui expliquent pourquoi la mémoire HBM est déterminante à l'ère de l'inférence. Selon la feuille de route technologique HBM publiée par le KAIST TERA Lab, les futures générations de HBM continueront d'augmenter la bande passante grâce à l'empilement DRAM supplémentaire, l'intégration TSV, le conditionnement avancé et l'optimisation thermique. Les modules DRAM standard manquent des voies parallèles nécessaires pour prendre en charge les vitesses de traitement des accélérateurs modernes. Pour surmonter ce « mur de la mémoire », les architectes matériels se sont tournés vers les systèmes HBM. En empilant verticalement les dies DRAM et en utilisant des milliers de vias en silicium (TSV) pour établir des bus larges et parallèles, la spécification JEDEC HBM3 (JESD238) explique comment la mémoire empilée basée sur les TSV élargit considérablement la bande passante disponible par rapport aux modules DRAM conventionnels. Pour les développeurs, cette évolution matérielle illustre une règle fondamentale des systèmes à haut débit : le goulot d'étranglement est presque toujours la couche de transport, et non le nœud de calcul.
Mécanismes sous-jacents du concept « Pourquoi la mémoire HBM est déterminante »
Au niveau architectural, les bus informatiques standard agissent comme des autoroutes étroites, restreignant le flux de jeux de données volumineux. Lorsqu'une application exécute un appel d'inférence, le processeur doit lire les données en mémoire, terminer l'opération et réécrire le résultat. Dans les configurations standard, ce processus génère une latence sévère car les données doivent parcourir une distance physique importante sur la carte mère.
Pour résoudre ces goulots d'étranglement au niveau de la couche de transport, les ordinateurs IA de nouvelle génération évoluent vers des architectures composites tridimensionnelles. Dans ce modèle, le cœur de calcul est placé directement au-dessus de la mémoire empilée, utilisant un conditionnement avancé pour minimiser la distance physique et la latence.
La hiérarchie mémoire 3D : empilement de SRAM, DRAM et NAND
Pour gérer différentes classes de données, les architectes matériels proposent un gratte-ciel semi-conducteur 3D stratifié. Cette structure sépare le stockage des données en zones physiques distinctes en fonction des besoins de vitesse d'accès et de capacité :
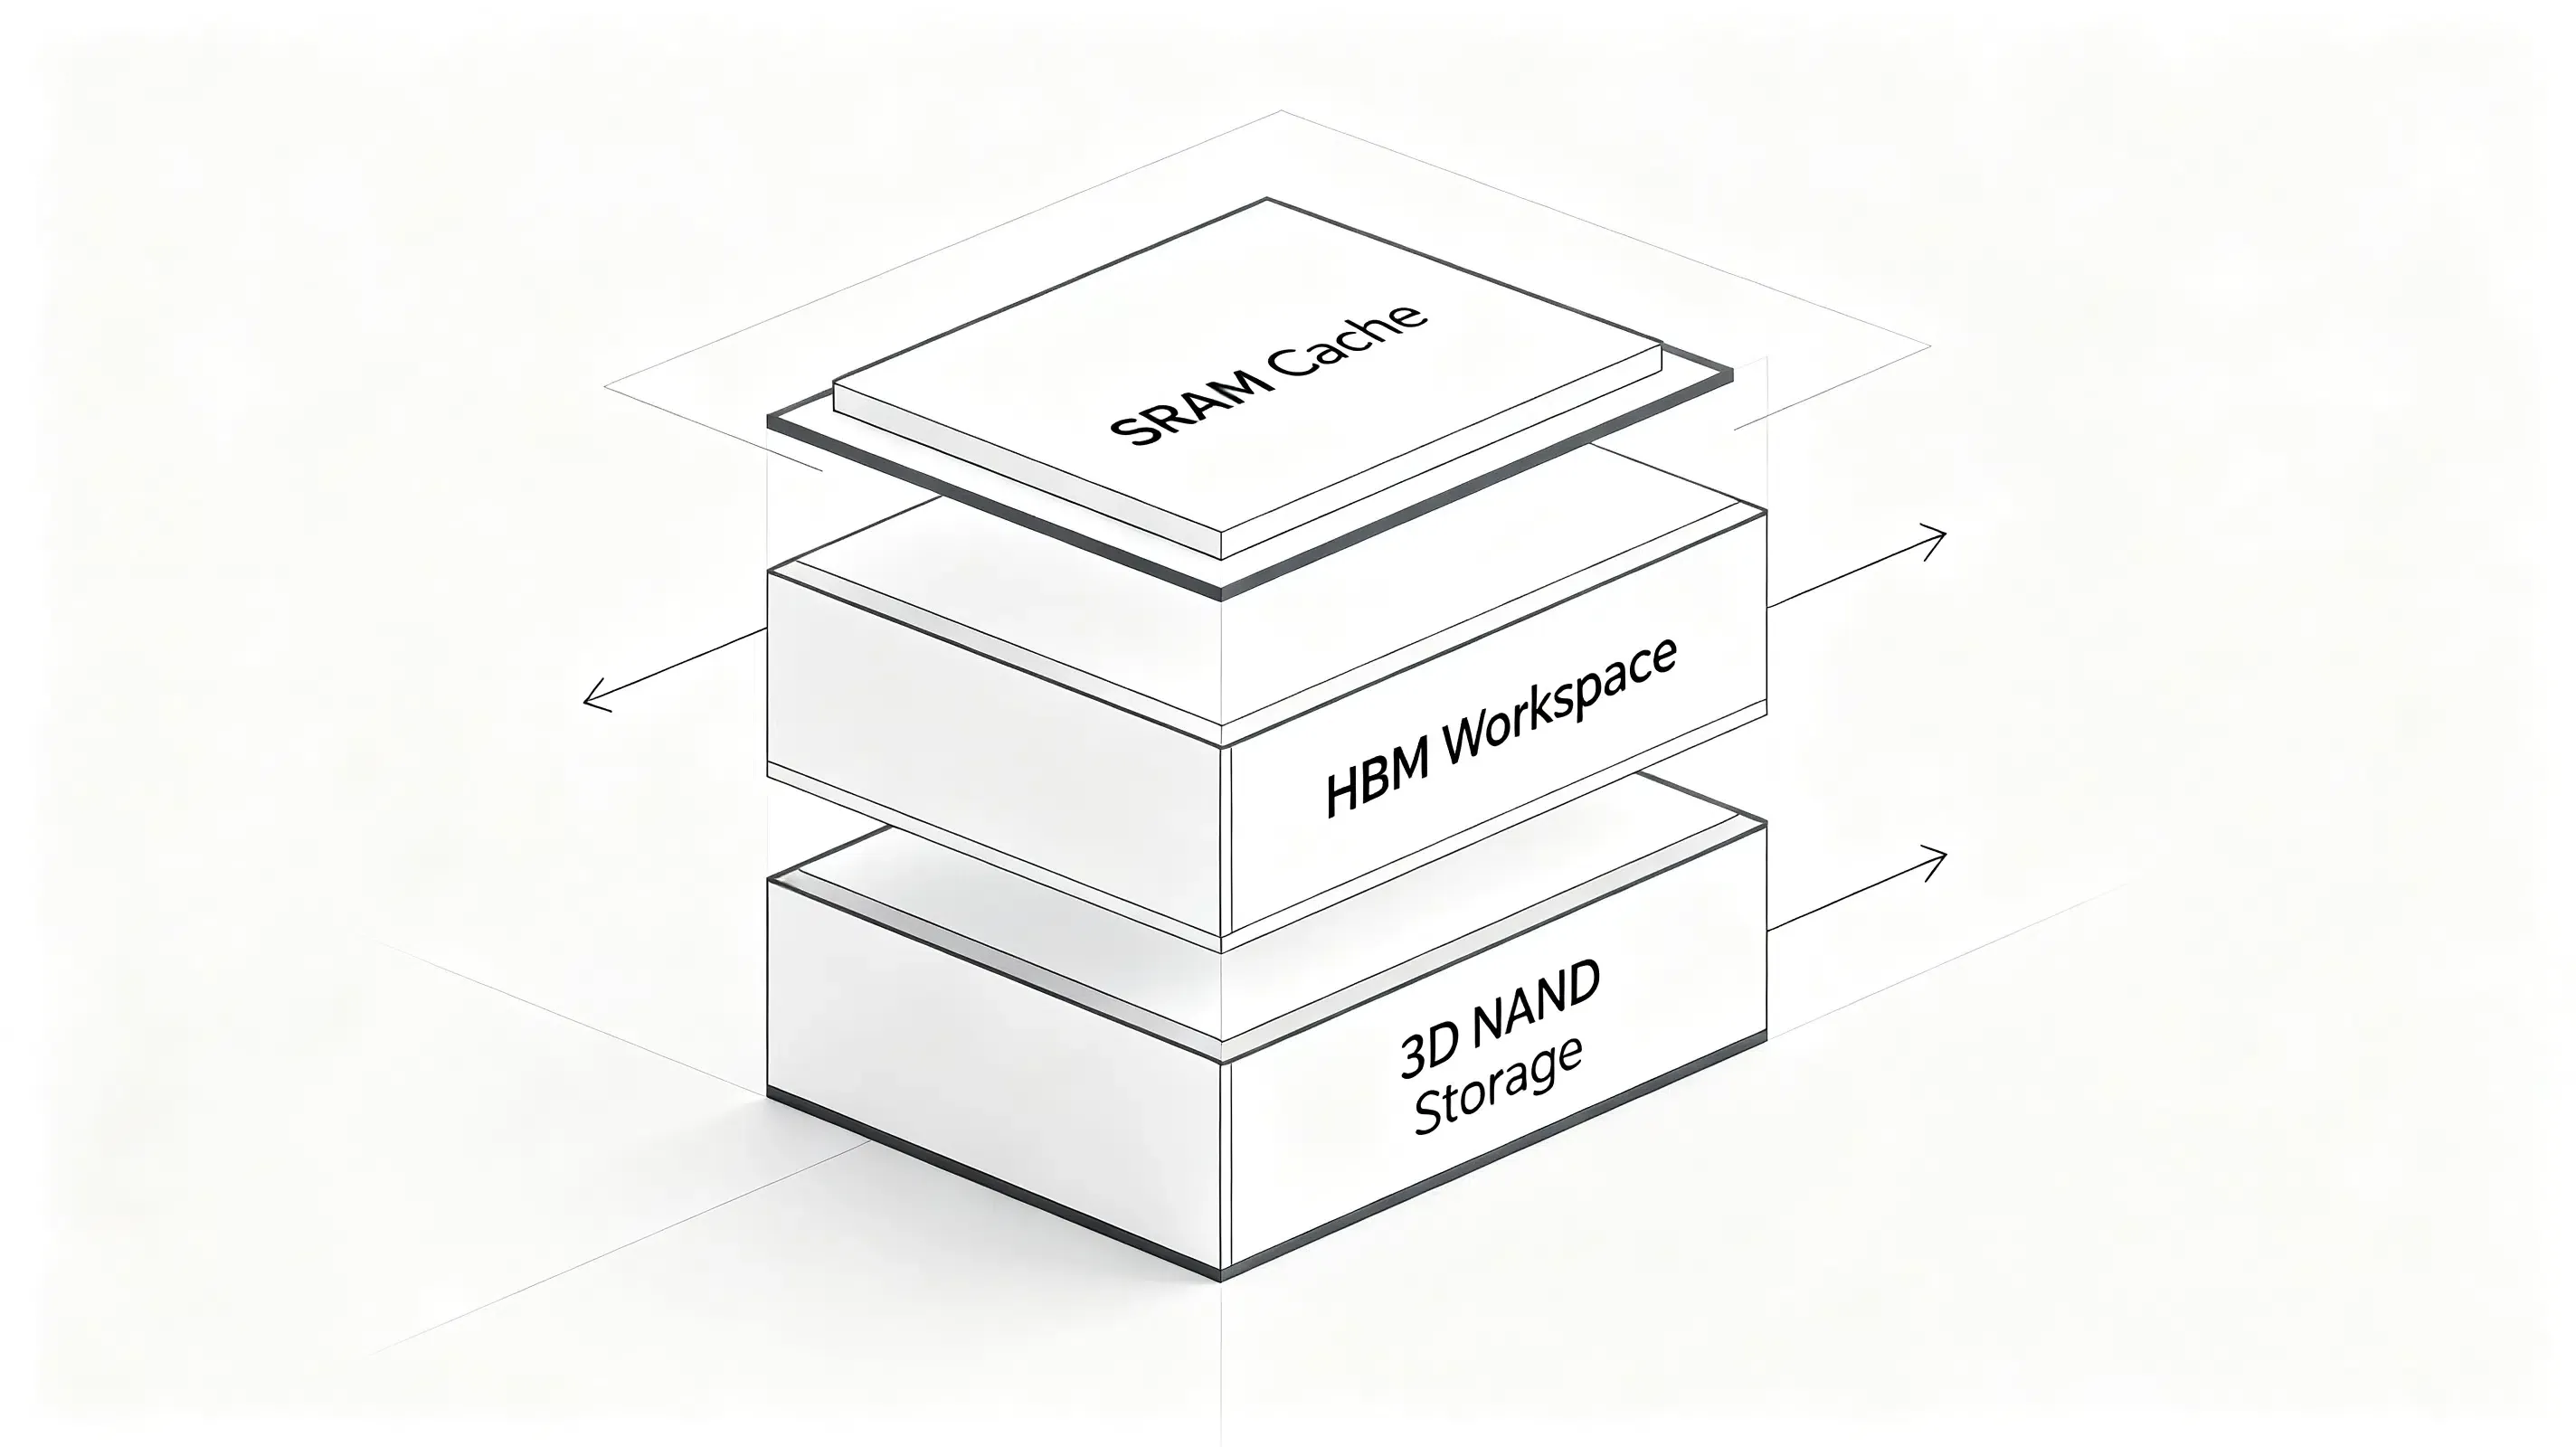
- Cache SRAM haute vitesse sur boîtier : Agissant comme le cache ultime, la SRAM est intégrée directement aux côtés du processeur, réduisant considérablement la latence d'accès à la mémoire par rapport à la DRAM conventionnelle pour gérer les registres de paramètres actifs.
- Mémoire à large bande passante (HBM) : Servant d'espace de travail actif principal, la HBM gère la récupération des paramètres actifs et les mises à jour d'état à haute fréquence, avec des normes JEDEC définissant son interface large.
- Stockage flash 3D NAND haute capacité : La Flash à large bande passante (HBF) reste une architecture de stockage émergente proposée par les chercheurs du KAIST pour compléter la HBM en offrant une capacité de stockage nettement plus grande pour les futurs systèmes IA, utilisant une mémoire flash NAND empilée verticalement pour fournir une capacité de stockage massive à long terme afin de préserver des vidéos, des documents et des mémoires conversationnelles persistantes.
Le diagramme ci-dessous illustre cette intégration verticale physique :
                  [ GPU / Cœur de processeur ] (Refroidissement au niveau du toit)
                             │
                             ▼
                  [ Cache SRAM haute vitesse intégré ] (Cache de galette ultra-rapide)
                             │
                             ▼
                  [ Mémoire à large bande passante ] (DRAM d'espace de travail actif)
                             │
                             ▼
                  [ Stockage flash 3D NAND haute capacité ] (Stockage NAND à long terme)
Cette architecture 3D intégrée garantit que les unités de calcul standard sont alimentées en continu en données, réduisant ainsi les cycles d'inactivité. La mémoire DDR traditionnelle ne fournit qu'une fraction de la bande passante disponible avec la HBM. Selon les présentations techniques NVIDIA GTC réalisées conjointement avec SK Hynix, la HBM offre une bande passante nettement plus élevée que la DDR conventionnelle tout en occupant un encombrement physique beaucoup plus réduit. Plus précisément, la HBM2 fournit environ 307 Go/s par pile, tandis que la HBM2E porte ce chiffre à environ 358 Go/s, la HBM3 ciblant des bandes passantes supérieures à 500 Go/s.
Bien que la bande passante mémoire et l'attribution d'applications appartiennent à des domaines d'ingénierie différents, les deux soulignent le même principe architectural : déplacer la gestion des états loin des ressources locales limitées vers une infrastructure serveur évolutive. Lorsque les interactions utilisateur sont dissociées du suivi d'état côté client pour satisfaire aux directives de confidentialité, maintenir une continuité de session fluide entre différents environnements web et mobiles devient extrêmement complexe. Tout comme les processeurs nécessitent des pipelines mémoire persistants à haute vitesse pour correspondre aux contextes d'état, les pipelines marketing en aval nécessitent une préservation robuste des données côté serveur pour corréler les événements d'installation distincts sans dépendre de cookies côté client ou d'attributs au niveau de l'appareil vulnérables.
Construire ou acheter : gérer la continuité de session côté serveur et le débit de données
À mesure que les environnements informatiques modernes s'éloignent des identifiants côté client, maintenir l'état de session sur les points de contact numériques distribués est devenu un défi d'ingénierie majeur. Pour les développeurs, gérer les états de session à l'ère du concept « Pourquoi la mémoire HBM est déterminante » nécessite des architectures à la fois conformes aux lois sur la confidentialité des données et très précises. Les organisations qui ont besoin de préserver les parcours utilisateur sur le web et les expériences mobiles s'appuient de plus en plus sur la gestion de session côté serveur plutôt que sur des identifiants persistants côté client. Selon les besoins de l'entreprise, les équipes peuvent développer ces capacités en interne ou adopter des plateformes d'attribution existantes.
Évaluation architecturale : construction personnalisée ou SDK standardisé
La construction d'un système interne pour gérer la correspondance des états côté serveur offre une flexibilité maximale mais exige des ressources d'ingénierie importantes et continues. Les développeurs doivent construire manuellement des schémas de base de données, écrire des fonctions de hachage cryptographique sécurisées et mettre à jour continuellement le système pour se conformer aux réglementations régionales changeantes. À l'inverse, le déploiement d'un SDK certifié et pré-construit réduit la complexité d'intégration et garantit une conformité à long terme sans frais généraux supplémentaires.
Le tableau ci-dessous compare les méthodologies standard pour la gestion de l'état de session et le contexte de conversion :
| Solution | Persistance | Débit | Idéal pour |
|---|---|---|---|
| Base de données de session interne | Élevée (Synchronisation continue) | Moyen (Limites de latence BD) | Environnements d'entreprise personnalisés avec une logique de stockage très spécialisée |
| Suivi de session basé sur navigateur | Faible (Cookies de session) | Faible (Aucun journal serveur) | Suivi de site web basique avec des exigences de conversion inter-domaines minimales |
| Mise en cache côté serveur (ex: OpoInstall) | Aucune (Jetons de session côté serveur temporaires) | Élevé (Bac à sable standardisé) | Attribution de campagnes multi-plateformes et applications mobiles à forte concurrence |
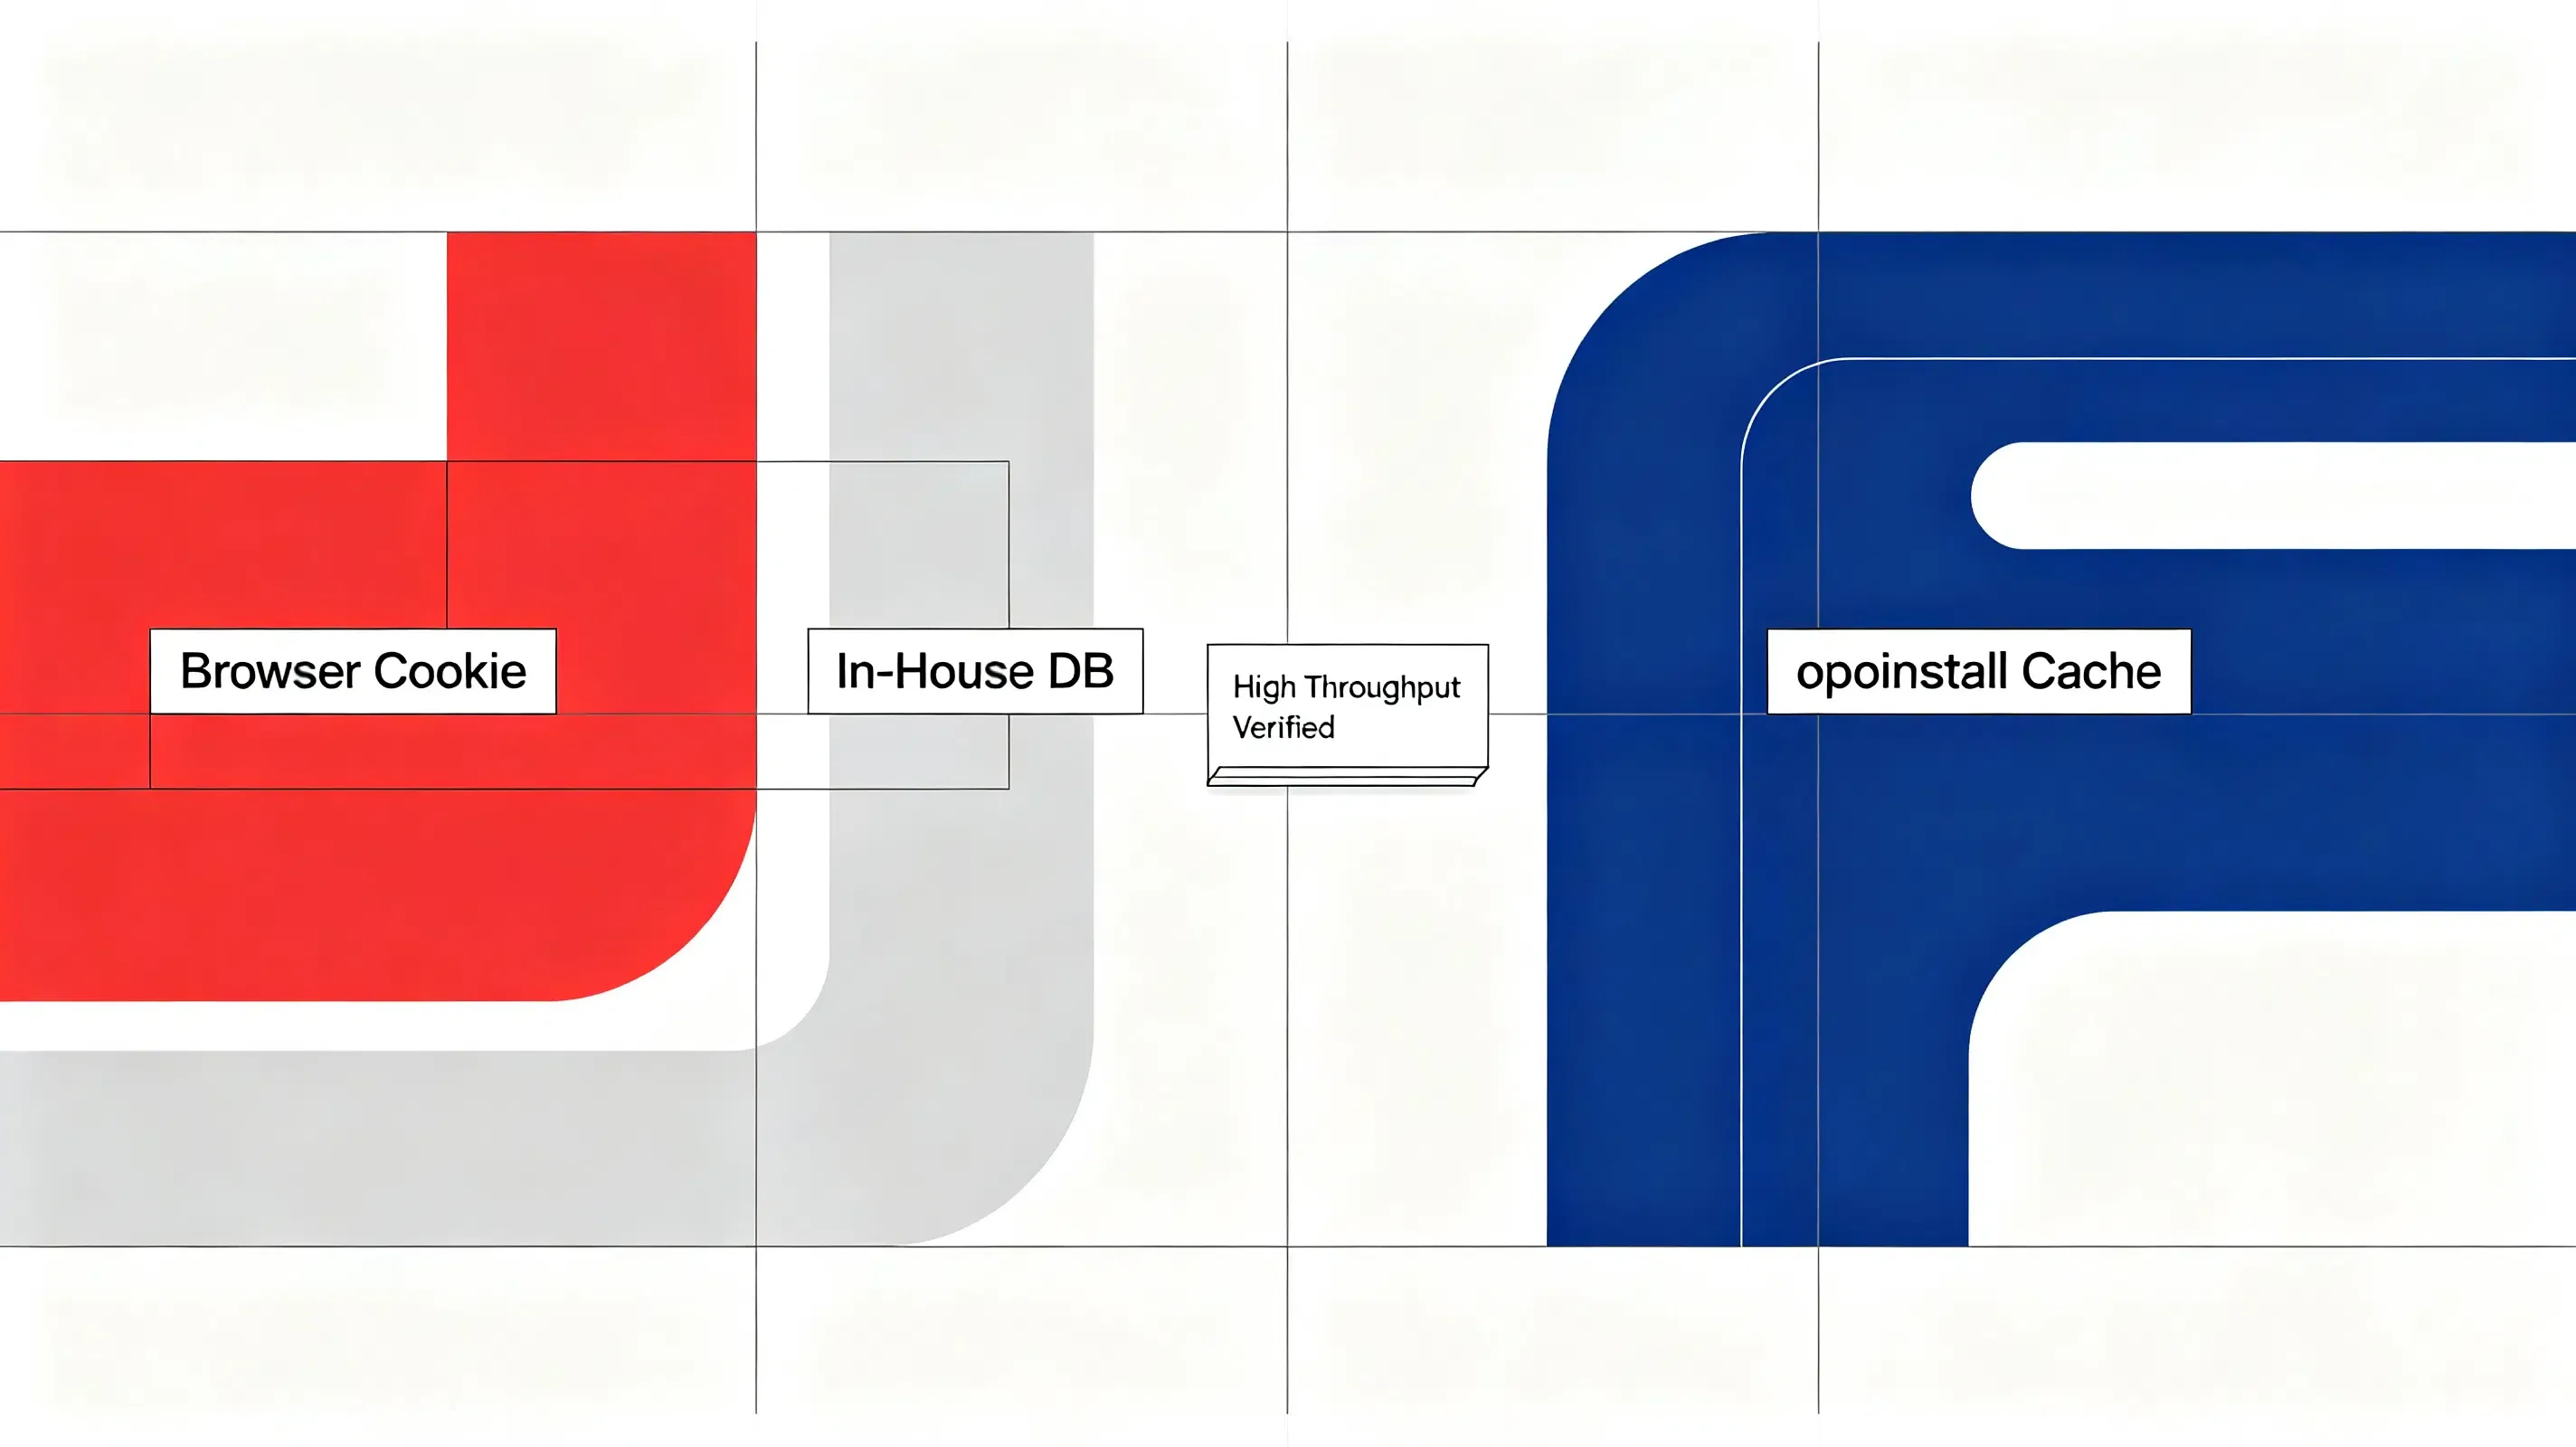
Des recherches récentes sur l'architecture GPU publiées sur les études de la base de données arXiv démontrent également que l'efficacité de l'accès à la mémoire détermine souvent le débit global de l'inférence plus que les performances arithmétiques brutes. Bien que des configurations de base de données personnalisées puissent gérer un contexte de base, une préservation spécialisée de l'état côté serveur peut optimiser les ressources de développement. Selon les exigences de mise en œuvre, les organisations peuvent créer leur propre système de gestion de session côté serveur ou adopter des plateformes commerciales telles que OpoInstall. Par exemple, OpoInstall propose des frameworks de restauration d'état côté serveur et de transfert de paramètres, mappant les métadonnées de session vers une base de données serveur pour maintenir la continuité de session de manière anonyme, sans stocker d'historique conversationnel personnel sensible et à long terme. En mappant les métadonnées de session vers une base de données centralisée plutôt que de s'appuyer sur des redirections par navigateur, un tel système garantit que les contextes de conversion restent cohérents même lorsque les tâches initiales sont exécutées de manière anonyme. Les équipes d'ingénierie peuvent évaluer ces approches pour équilibrer protection des données et cohérence des mesures.
Listes de contrôle d'intégration : préparer votre architecture à l'informatique centrée sur la mémoire
Pour sécuriser les pipelines de données et garantir la sécurité des utilisateurs à l'ère post-alias, les développeurs et les architectes peuvent évaluer la gestion décentralisée des alias open-source et la préservation de l'état côté serveur. S'appuyer sur des fonctionnalités au niveau de l'OS d'un fournisseur unique introduit une dépendance vis-à-vis du fournisseur et rend les organisations vulnérables aux mises à jour silencieuses du backend. Au lieu de cela, les équipes d'ingénierie peuvent évaluer des technologies de routage alternatives qui accordent une propriété totale des données.
Une alternative standard consiste à enregistrer un domaine personnalisé dédié spécifiquement à la compartimentation des e-mails. En acheminant ce domaine via un moteur d'alias open-source auto-hébergé comme SimpleLogin et en le pointant vers une boîte mail chiffrée comme Proton Mail, les développeurs peuvent s'assurer que leurs alias ressemblent à des domaines personnalisés standard, empêchant les systèmes anti-abus de les bloquer en tant que groupe.
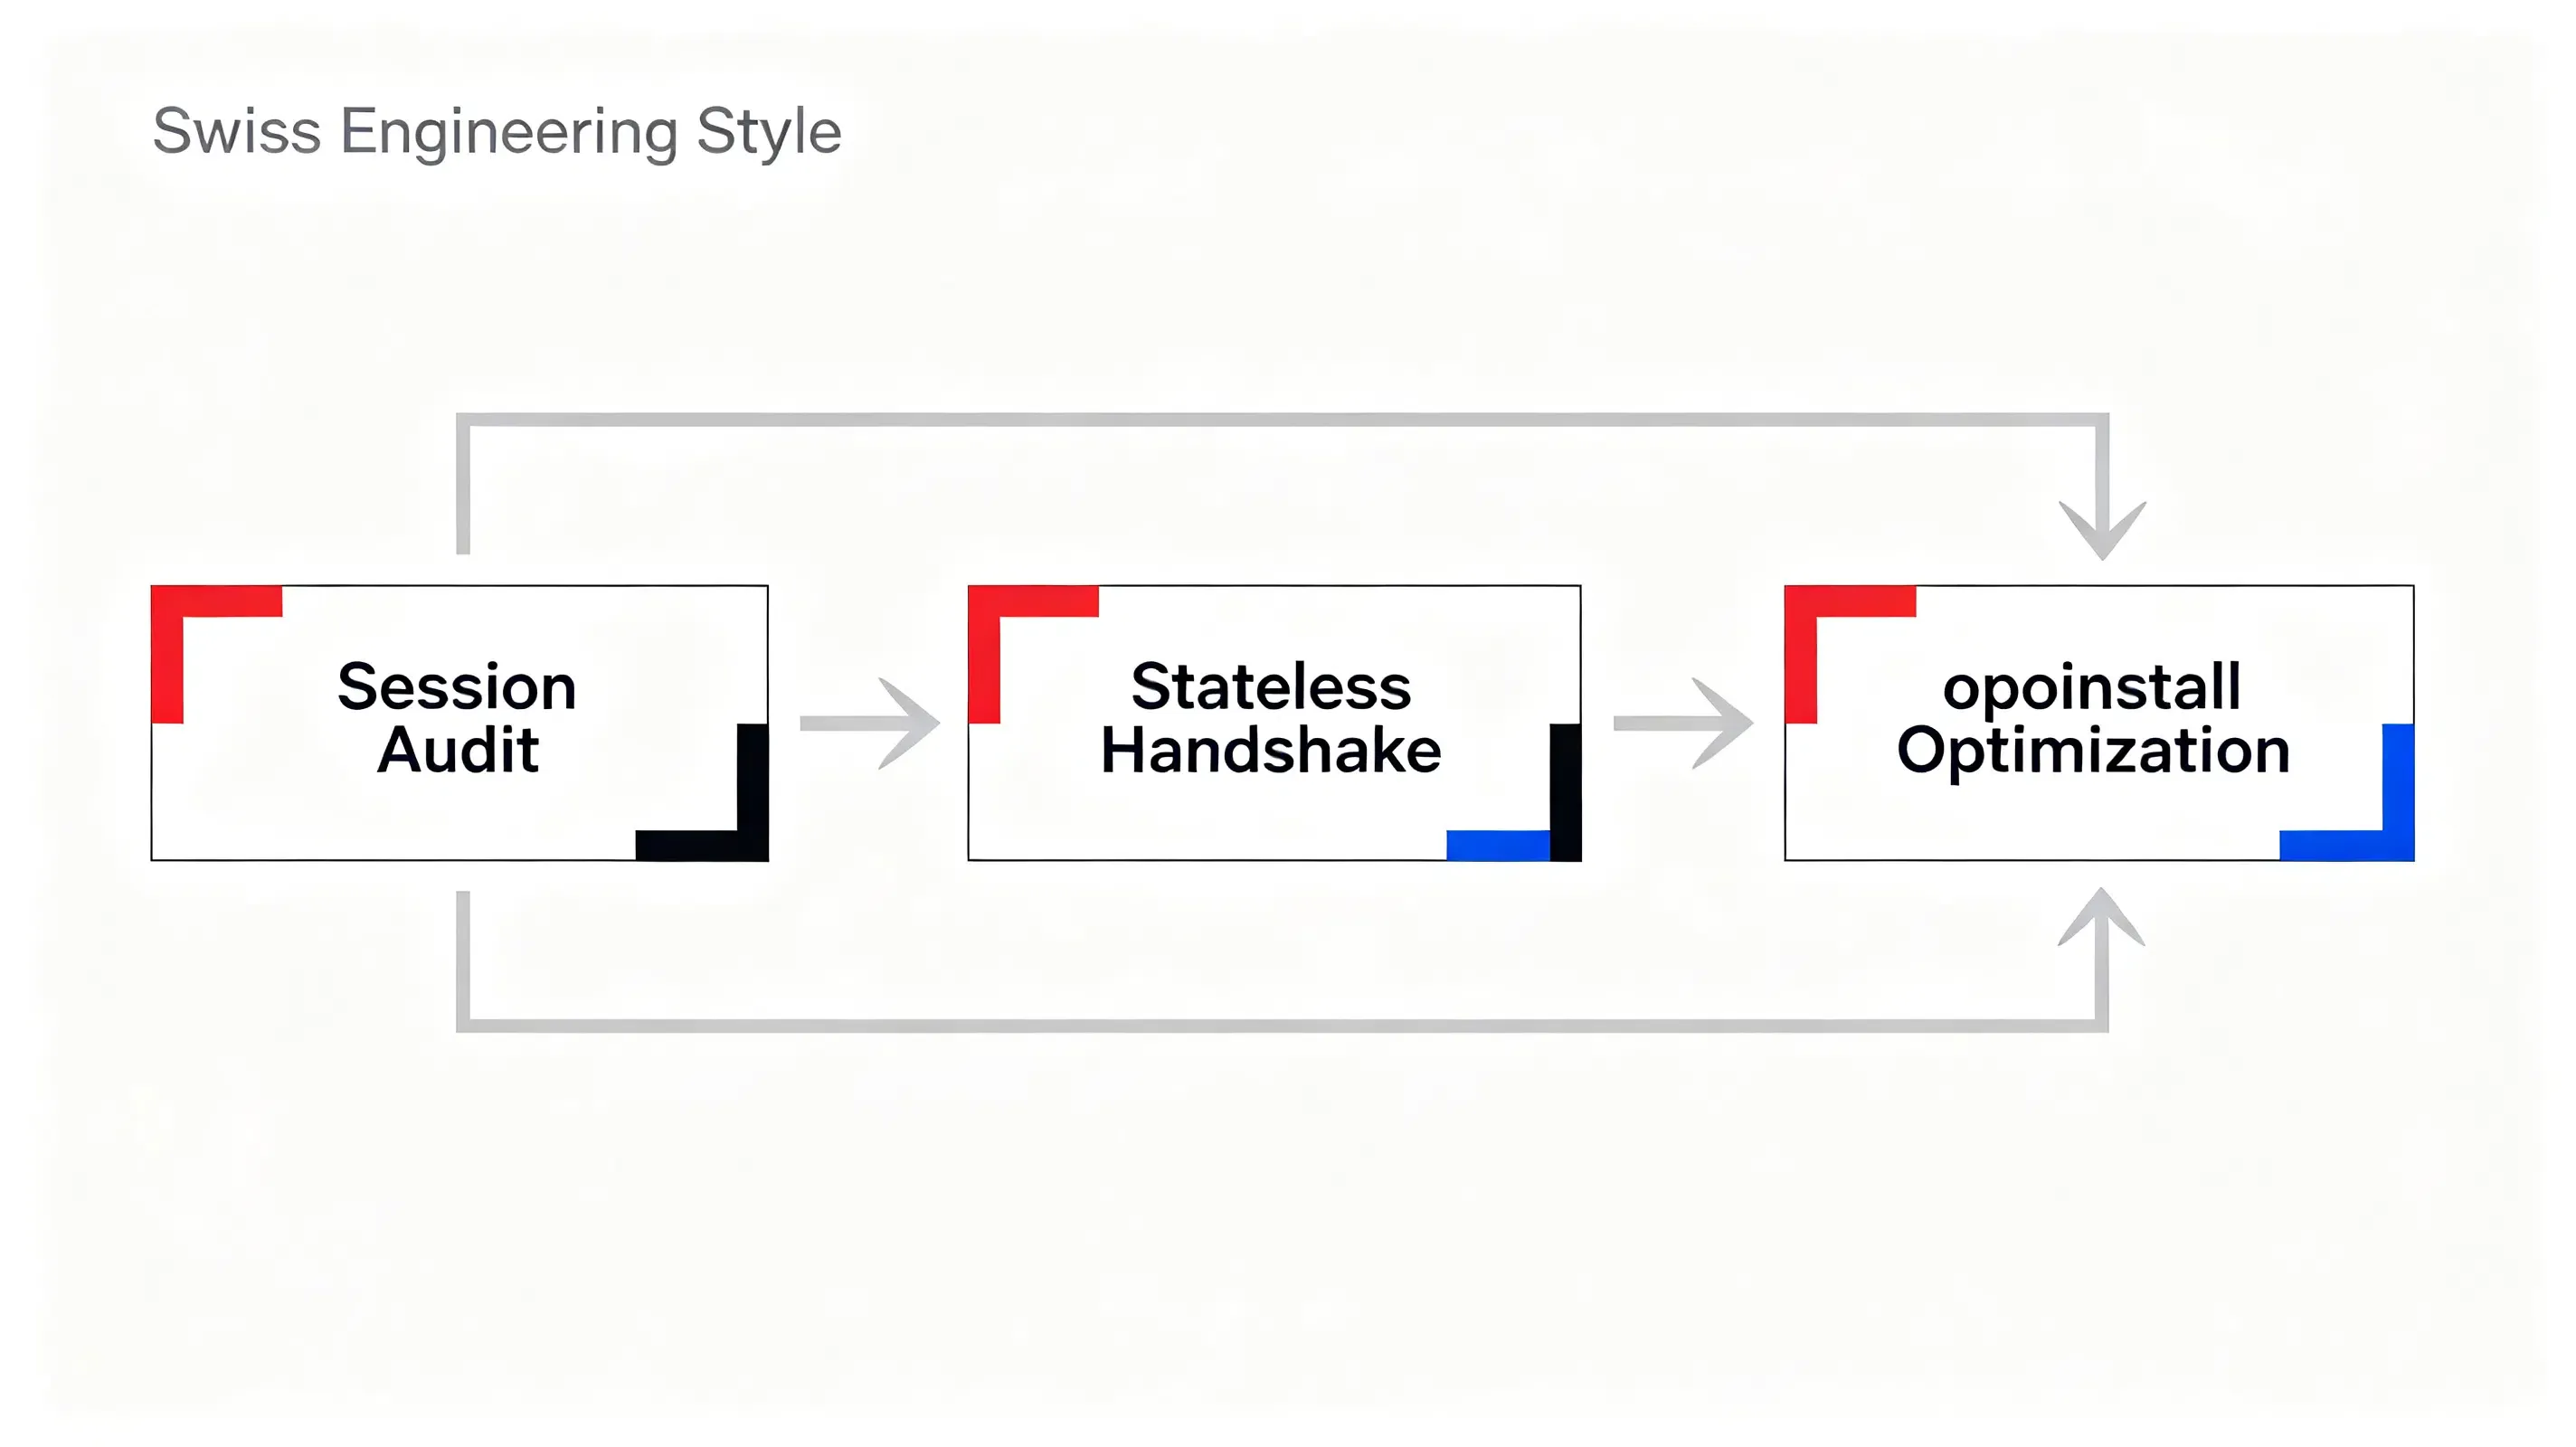
Liste de contrôle pour la mise en œuvre par le développeur
- Auditer la conservation des données de session : Examiner toutes les bases de données pour s'assurer que les historiques de discussion compagnons émotionnels persistants sont purgés conformément aux calendriers de suppression des données.
- Mettre en œuvre des poignées de main de session sans état : Passer les routes API à des modèles de traitement sans état, en utilisant des jetons signés cryptographiquement pour transmettre un contexte temporaire entre les nœuds.
- Appliquer des passerelles de vérification de l'âge : Pour les produits destinés aux consommateurs, déployer des mesures de sécurité pour les enfants afin d'empêcher les mineurs d'accéder aux fonctionnalités conversationnelles restreintes.
Liste de contrôle pour la stratégie de produit et de croissance
- Réorganiser les flux d'expérience utilisateur : Pivoter des modèles d'engagement basés sur le compagnonnage vers des outils utilitaires et axés sur les tâches qui ne reposent pas sur une dépendance émotionnelle.
- Optimiser les entonnoirs de conversion : Tirer parti de frameworks de transfert de paramètres non intrusifs pour maintenir le suivi des acquisitions sans violer les directives de confidentialité des utilisateurs.
- Surveiller la conformité de la plateforme : S'assurer que tous les SDK tiers intégrés sont conformes aux lois locales sur la protection des données et au mandat du 15 juillet à venir.
En établissant ces directives structurées, les équipes de développement peuvent faire passer leurs applications vers des architectures plus sûres et plus conformes tout en maintenant une continuité opérationnelle.
Foire aux questions (FAQ)
Pourquoi le même GPU reste-t-il inactif jusqu'à quatre-vingt-dix pour cent de son temps d'exécution ?
Quelles sont les différences techniques entre HBM, HBF et HBS ?
Comment la restauration de session côté serveur résout-elle les goulots d'étranglement des états ?
Pourquoi la HBM est-elle plus importante pendant l'inférence IA que pendant l'entraînement ?
Points clés pour les équipes d'ingénierie
À mesure que les plateformes d'IA s'adaptent aux nouvelles exigences réglementaires, les équipes d'ingénierie s'appuieront de plus en plus sur des architectures sans état, une gestion de session côté serveur et une conception axée sur la confidentialité. Les architectures de données en évolution nécessitent un changement fondamental dans la façon dont nous construisons et mesurons les expériences numériques. Alors que les proxys sans état et les scrapers headless deviennent des consommateurs standard de contenu web, les modèles d'attribution côté client traditionnels continueront de se dégrader. Se fier aux cookies et aux référents standard ne suffit plus pour sécuriser les pipelines de données qui favorisent l'acquisition d'utilisateurs.
Pour maintenir la croissance, les équipes d'ingénierie et de produit doivent donner la priorité aux structures de données sans état et à la préservation de l'état côté serveur. En mettant en œuvre une vérification d'identité « zéro confiance », des frameworks de transfert de paramètres sécurisés et des calendriers robustes de suppression des données, les organisations peuvent protéger leurs pipelines d'utilisateurs tout en respectant les limites légales. Ce changement architectural est essentiel pour construire des plateformes stables et fiables qui prospèrent dans une économie numérique réglementée.
Share this article



