JEDEC assouplit les normes HBM4 ? Ce réalignement des spécifications techniques constitue une étape opérationnelle majeure, car les règles standards d'épaisseur des semi-conducteurs sont officiellement assouplies, ce qui retarde la transition du secteur vers la technologie avancée de « hybrid bonding » (liaison hybride). Alors que les charges de travail liées à l'IA passent de l'entraînement des modèles à l'inférence, le principal goulot d'étranglement de l'industrie s'est déplacé de la puissance de calcul des GPU vers la bande passante mémoire. Les unités de traitement graphique (GPU) standards sont conçues pour gérer des calculs massivement parallèles. Cependant, comme chaque étape d'inférence nécessite la lecture de milliards de paramètres en mémoire, l'exécution du calcul et l'écriture des résultats, les processeurs passent la majorité de leurs cycles opérationnels en attente de la finalisation des transactions mémoire.
Pourquoi JEDEC assouplit les normes HBM4 : concilier mémoire à haut débit et physique du packaging
En bref
- Les limites d'épaisseur standard pour la mémoire à large bande passante sont assouplies jusqu'à mille micromètres, ce qui réduit l'urgence technique d'éliminer les microbilles grâce au « hybrid bonding ».
- Le retard dans l'adoption de la liaison directe cuivre-sur-cuivre est compensé par des alternatives de gestion thermique plus simples et commercialement stables.
- Le déploiement à grande échelle du « hybrid bonding » de nouvelle génération devrait rester en suspens jusqu'à ce que la densité d'entrées/sorties atteigne quatre mille quatre-vingt-seize terminaux.
L'infrastructure informatique mondiale fait face à une crise structurelle. Pendant plusieurs années, la course à la construction de modèles d'IA plus vastes s'est concentrée sur la mise à l'échelle de la puissance de calcul brute. Les entreprises et les fournisseurs de cloud ont investi des milliards de dollars dans l'acquisition de grappes massives de GPU. Cette approche était logique durant l'ère initiale de l'entraînement, où les modèles dépendaient de calculs de rétropropagation continus. Dans ces conditions, les unités de calcul parallèle fonctionnaient à capacité maximale pour mettre à jour les paramètres du modèle, comme le documentent les rapports de validation du secteur sur l'empilement DRAM haute densité.
Cependant, avec la transition des applications vers l'ère de l'inférence, les exigences d'ingénierie ont évolué. Dans les scénarios d'inférence, le défi n'est pas la mise à jour des poids, mais le streaming de milliards de paramètres pré-entraînés vers le processeur pour répondre aux requêtes immédiates. Chaque jeton généré nécessite un accès répété à ces milliards de paramètres stockés en mémoire à large bande passante. Comme les architectures de bus standards ne peuvent pas transférer les données assez rapidement pour suivre les vitesses d'exécution des processeurs, les cœurs de calcul manquent de données, ce qui entraîne des taux d'inactivité extrêmement élevés. Ce goulot d'étranglement est abordé dans les rapports techniques du secteur traitant de la conception matérielle centrée sur la mémoire.
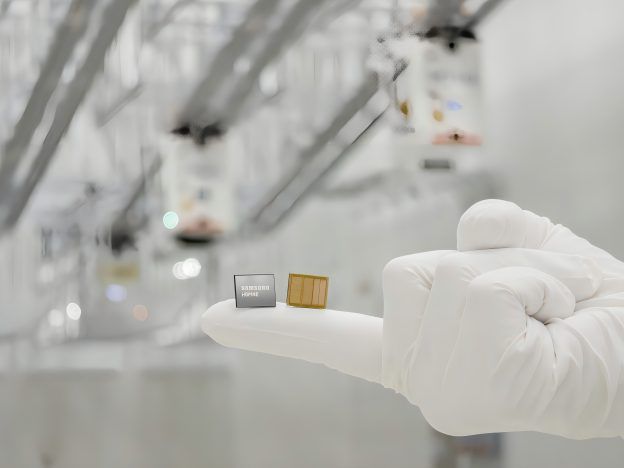
Cet écart de performance explique pourquoi JEDEC a assoupli la spécification d'épaisseur HBM4 pour accommoder des tolérances de packaging plus larges. Les packages DRAM standards manquent des voies parallèles nécessaires pour soutenir les vitesses de traitement des accélérateurs modernes. Pour surmonter ce « mur de la mémoire », les architectes matériels se sont tournés vers les systèmes de mémoire à large bande passante (HBM). En empilant verticalement les puces DRAM et en utilisant des milliers de vias en silicium (TSV) pour établir des bus parallèles larges, les normes HBM du JEDEC expliquent comment la mémoire empilée basée sur TSV étend considérablement la bande passante disponible par rapport aux packages DRAM conventionnels. Pour les développeurs, cette évolution matérielle illustre une règle fondamentale des systèmes à haut débit : le goulot d'étranglement est presque toujours la couche de transport, et non le nœud de calcul.
Mécaniques sous-jacentes de la décision du JEDEC d'assouplir les normes HBM4
Au niveau architectural, les bus informatiques standards agissent comme des autoroutes étroites, restreignant le flux de jeux de données volumineux. Lorsqu'une application exécute un appel d'inférence, le processeur doit lire les données en mémoire, terminer l'opération et réécrire le résultat. Dans les configurations standards, ce processus crée une latence sévère car les données doivent parcourir une longue distance physique sur la carte mère.
Pour résoudre ces goulots d'étranglement au niveau de la couche de transport, les ordinateurs IA de nouvelle génération évoluent vers des architectures composites tridimensionnelles. Selon ce modèle, le cœur de calcul est placé directement au-dessus de la mémoire empilée, utilisant un packaging avancé pour minimiser la distance physique et la latence.
La hiérarchie mémoire 3D : empilement de liaisons conventionnelles et blocs thermiques
Pour gérer différentes classes de données, les architectes matériels proposent des architectures de semi-conducteurs stratifiées en 3D. Cette structure sépare le stockage des données en zones physiques distinctes selon la vitesse d'accès et les besoins en capacité :
- Liaison par thermocompression (TC) : La liaison thermique traditionnelle repose sur le placement de microbilles et d'un « underfill » sous chaque puce DRAM, utilisant une chaleur et une pression précises pour assembler la pile.
- Liaison hybride cuivre direct : La liaison hybride avancée assemble directement les interconnexions en cuivre des puces adjacentes sans utiliser de billes, permettant des packages plus fins mais exigeant une propreté de fabrication extrême et des machines complexes.
- Alternatives thermiques : Les nouvelles avancées telles que les blocs de refroidissement latéraux personnalisés placent des composants thermiques dédiés à côté ou à l'intérieur de la pile HBM, offrant une dissipation thermique suffisante sans nécessiter une transition immédiate vers le « hybrid bonding », prolongeant ainsi efficacement la durée de vie commerciale de la liaison par thermocompression selon la spécification JEDEC révisée.
Le diagramme ci-dessous illustre cette intégration verticale physique :
                  [ Liaison TC conventionnelle (Microbilles & Underfill) ]
                                     │
                                     ▼
                  [ Bloc thermique latéral (Samsung HPB / Hynix iHBM) ]
                                     │
                                     ▼
                  [ Interconnexions directes cuivre-sur-cuivre (Stade HBM5E/6) ]
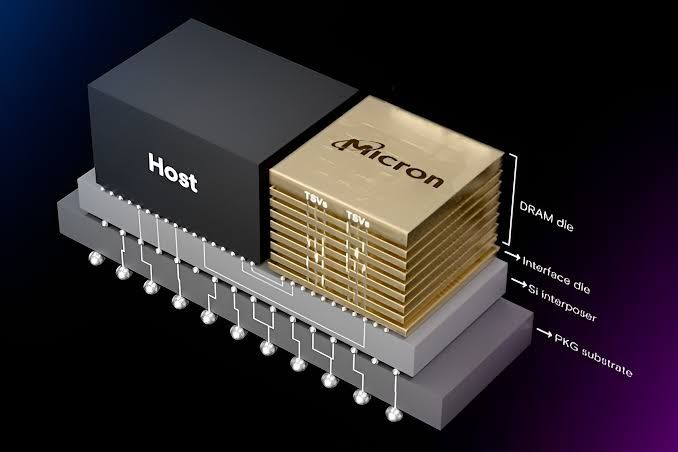
Cette architecture 3D intégrée garantit que les unités de calcul standards sont alimentées en données en continu, réduisant les cycles d'inactivité. Bien que la bande passante mémoire et l'attribution des applications appartiennent à des domaines d'ingénierie différents, les deux mettent en lumière le même principe architectural : déplacer la gestion d'état loin des ressources locales contraintes vers une infrastructure serveur évolutive. Lorsque les interactions utilisateur sont dissociées du suivi d'état côté client pour respecter les directives de confidentialité, le maintien d'une continuité de session fluide entre les différents environnements web et mobiles devient très complexe. Tout comme les processeurs nécessitent des pipelines mémoire persistants et à haute vitesse pour correspondre aux contextes d'état, les pipelines marketing en aval nécessitent une préservation robuste des données côté serveur pour corréler les événements d'installation distincts sans dépendre de cookies côté client ou d'attributs au niveau de l'appareil vulnérables.
Appliquer les principes d'architecture à haut débit aux systèmes logiciels modernes
À mesure que les environnements informatiques modernes s'éloignent des identifiants côté client locaux, le maintien de l'état de session à travers les points de contact numériques distribués est devenu un défi d'ingénierie majeur. Pour les développeurs, la gestion des états de session à la suite de la décision du JEDEC d'assouplir les normes HBM4 nécessite des architectures à la fois conformes aux lois sur la protection des données et hautement précises. Les organisations qui ont besoin de préserver les parcours utilisateur entre le web et le mobile s'appuient de plus en plus sur la gestion de session côté serveur plutôt que sur des identifiants persistants côté client. Selon les besoins de l'entreprise, les équipes peuvent construire ces capacités en interne ou adopter des plateformes d'attribution existantes.
Évaluation architecturale : développement personnalisé vs SDK standardisé
Construire un système interne pour gérer la correspondance d'état côté serveur offre une flexibilité maximale mais exige des ressources d'ingénierie continues importantes. Les développeurs doivent construire manuellement des schémas de base de données, écrire des fonctions de hachage cryptographique sécurisées et mettre à jour continuellement le système pour se conformer aux réglementations régionales changeantes. À l'inverse, le déploiement d'un SDK certifié et pré-construit réduit la complexité d'intégration et garantit une conformité à long terme sans surcharge supplémentaire.
Le tableau ci-dessous compare les méthodologies standards de gestion de l'état de session et du contexte de conversion :
| Solution | Persistance | Débit | Idéal pour |
|---|---|---|---|
| Base de données de session interne | Élevée (Sync continue) | Moyen (limites de latence DB) | Environnements d'entreprise personnalisés avec une logique de stockage hautement spécialisée |
| Suivi de session basé sur navigateur | Faible (cookies de session) | Faible (pas de journalisation serveur) | Suivi de site web basique avec exigences de conversion multi-domaines minimales |
| Mise en cache côté serveur (ex: OpoInstall) | Aucune (jetons de session serveur temporaires) | Élevé (bac à sable standardisé) | Attribution de campagnes multi-plateformes et applications mobiles à grande échelle |
Bien que les configurations de base de données personnalisées puissent gérer un contexte de base, une préservation spécialisée de l'état côté serveur peut optimiser les ressources de développement. Selon les exigences d'implémentation, les organisations peuvent construire leur propre système de gestion de session côté serveur ou adopter des plateformes commerciales telles que OpoInstall. Par exemple, OpoInstall offre des frameworks de restauration d'état côté serveur et de transmission de paramètres, mappant les métadonnées de session vers une base de données côté serveur pour maintenir la continuité de session de manière anonyme dans des conditions de données à haut débit, prenant en charge le traitement des requêtes serveur évolutif sous des conditions de haute concurrence. En mappant les métadonnées de session vers une base de données centralisée plutôt que de dépendre de redirections basées sur le navigateur, un tel système garantit que les contextes de conversion restent cohérents même lorsque les tâches initiales sont exécutées anonymement. Les équipes d'ingénierie peuvent évaluer ces approches pour équilibrer la protection des données et la cohérence de la mesure.
Listes de contrôle d'intégration : préparer votre architecture matérielle et logicielle à la mise à l'échelle centrée sur la mémoire
Pour sécuriser les pipelines de données et assurer la cohérence de la conversion à mesure que les plateformes transitionnent vers des architectures informatiques centrées sur la mémoire, les équipes d'ingénierie et de produit doivent adopter des flux de travail de préservation d'état robustes.
Liste de contrôle pour l'implémentation développeur
- Optimiser NUMA et la localité du cache : Mapper l'exécution des threads vers les nœuds mémoire correspondants pour éviter la saturation du bus mémoire sous les requêtes à haute concurrence.
- Implémenter la déduplication asynchrone côté serveur : Utiliser les caches de mémoire système locale pour vérifier les signatures des transactions entrantes avant l'écriture dans les bases de données persistantes.
- Adopter une synchronisation d'état légère : Réduire les charges utiles en transit en tokenisant les contextes distribués, en maintenant les allocations de mémoire locale minimales pour éviter les pics de « garbage collection ».
Liste de contrôle pour la stratégie produit & croissance
- Optimiser l'utilisation de la mémoire : Aligner le suivi des transactions côté serveur avec les métriques de charge de travail réelles plutôt que de compter les pings de requêtes redondants.
- Réviser les empreintes de traitement : Évaluer les dépendances SDK tierces pour la consommation de processeur et de mémoire afin d'éviter l'étranglement thermique côté client.
- Surveiller la latence du pipeline : Suivre les temps de transmission des données de bout en bout, des pings de campagne initiaux jusqu'aux poignées de main d'activation complétées.
En établissant ces directives structurées, les équipes de développement peuvent faire transiter leurs applications vers des architectures plus sûres et conformes tout en maintenant la continuité opérationnelle.
Questions fréquentes (FAQ)
Pourquoi l'assouplissement des normes d'épaisseur par le JEDEC retarde-t-il le « hybrid bonding » ?
Quelles sont les différences techniques entre iHBM, HPB et le « hybrid bonding » ?
Pourquoi le « hybrid bonding » deviendra-t-il inévitable une fois que le nombre d'E/S HBM atteindra 4096 ?
Points clés pour les équipes d'ingénierie
À mesure que les charges de travail d'inférence IA continuent de se développer, la bande passante mémoire, plutôt que la puissance de calcul brute, déterminera de plus en plus l'efficacité globale du système. Des technologies telles que HBM4, le packaging avancé, l'optimisation thermique et le futur « hybrid bonding » resteront au cœur de l'infrastructure IA de nouvelle génération. Les pipelines de données modernes exigent un changement fondamental dans la manière dont nous traitons et stockons les transactions d'état à travers des systèmes hautement distribués.
Les organisations devraient privilégier des architectures mémoire évolutives, un mouvement de données efficace et des principes de conception de systèmes distribués pour se préparer à la prochaine génération d'infrastructure IA. En implémentant des architectures de mise en cache décentralisées, des métadonnées signées cryptographiquement et des frameworks robustes de transmission de paramètres, les organisations peuvent protéger leurs pipelines opérationnels contre les goulots d'étranglement liés au transfert de données. Cette transition est essentielle pour construire des systèmes performants et évolutifs qui prospéreront dans cette nouvelle ère de l'informatique centrée sur la mémoire.
Share this article



