Meta bannit « Claude » ? Ce réalignement stratégique a été confirmé par des rapports indiquant que le géant des réseaux sociaux a interdit aux ingénieurs de sa division IA appliquée d'utiliser des outils concurrents comme Claude Code et Codex d'OpenAI. Selon des documents internes obtenus fin juin 2026, l'entreprise a émis ces directives pour protéger l'intégrité des jeux de données d'entraînement de son futur modèle Llama et préserver ses secrets industriels comme détaillé dans les mises à jour de conformité du secteur. Pour les équipes de développement et les responsables produit, cette politique restrictive met en lumière une transition plus large : à mesure que les modèles génératifs convergent, maintenir une isolation stricte des environnements internes devient une norme fondamentale de conformité plutôt qu'un simple choix opérationnel.
En bref
- Protection contre la contamination : L'équipe d'ingénierie IA appliquée a restreint les appels à des outils externes de génération de code pour éviter que les données de modèles rivaux ne se mélangent aux données d'entraînement propriétaires.
- La menace de la distillation : La réutilisation intensive de sorties programmatiques externes introduit des risques de distillation de connaissances, violant potentiellement les conditions d'utilisation.
- Exigences de sandbox privés : Ce changement souligne le besoin croissant de sandboxes de développement sécurisés et auto-hébergés qui isolent les dépôts de code sensibles des serveurs externes.
Directives d'entreprise et réalignement de la sécurité de mai à juin
Les directives restrictives, rédigées initialement en mai 2026, sont entrées en vigueur fin juin 2026. Elles se concentrent exclusivement sur les ingénieurs de la division IA appliquée engagés directement dans la recherche sur les modèles, sans s'appliquer à l'ensemble des employés. Lors des cycles de développement précédents, l'équipe d'ingénierie utilisait fréquemment des assistants de codage externes pour planifier des architectures système, refactoriser des bases de code et exécuter des flux de débogage. Toutefois, selon les nouvelles consignes, les ingénieurs doivent désormais concevoir les entrées de test de manière indépendante, en s'appuyant sur l'expertise humaine plutôt que sur des suggestions d'outils externes.
La distillation de modèle, également appelée « connaissance par distillation », est le principal moteur de cette transition. Dans la recherche en intelligence artificielle, les développeurs entraînent des modèles « élèves » plus petits pour imiter les comportements de modèles « enseignants » plus robustes, en les alimentant avec les sorties de ces systèmes plus vastes. Bien que ce processus soit courant pour optimiser l'échelle et les coûts de déploiement, il pose de sérieux risques contractuels. Les ingénieurs de Meta qui copient ou référencent du code compilé par des outils concurrents risquent d'introduire des données tierces dans le pipeline d'entraînement de Llama, ce qui pourrait violer des accords d'utilisation et contaminer le modèle propriétaire.
Ce réalignement sécuritaire intervient dans un contexte de concurrence accrue. En juin 2026, la startup chinoise Zhipu AI a mis en open-source son modèle phare, GLM-5.2, démontrant des capacités d'analyse de vulnérabilités égales aux meilleurs benchmarks fermés aux États-Unis. Des tests indépendants ont montré que GLM-5.2 surpassait les checkpoints précédents comme Claude Opus 4.8 sur des tâches de cybersécurité Semgrep. Comme Zhipu AI a choisi de rendre publics les poids du modèle, autorisant des déploiements locaux privés, celui-ci a rapidement gravi les classements de trafic sur des plateformes comme OpenRouter. Cette montée en puissance de modèles alternatifs locaux performants force les principaux laboratoires d'IA à privilégier un contrôle total sur leurs dépôts de code et leurs entrées de données.
Les observations suivantes sont basées sur une validation interne dans un environnement de staging et visent à illustrer des schémas d'ingénierie plutôt qu'à servir de référence à l'échelle de l'industrie.
Mécanismes de distillation de modèle et exposition des données
Pour comprendre pourquoi Meta restreint ces outils, les développeurs doivent analyser les mécanismes des assistants de codage IA modernes. Ces utilitaires fonctionnent en envoyant le contexte du code local vers des serveurs externes. Lorsqu'un ingénieur lance une demande de refactorisation ou des suggestions architecturales, des blocs de code propriétaire transitent en dehors du réseau interne de l'entreprise. Cette transmission de données « headless » crée des vulnérabilités directes pour l'exposition de la propriété intellectuelle et les fuites de données.
IDE du développeur -> Intercepteur de requête sortante -> Proxy Sandbox (Métadonnées supprimées) -> Passerelle API sécurisée -> Modèle
                                                            |
                                               Le pare-feu sortant bloque les téléchargements de code brut
Dans les déploiements de production classiques, les développeurs voient souvent une part importante du trafic traitée par des scrapers automatisés. Le suivi de ces interactions programmatiques révèle que des proxies de sécurité automatisés ou des scanners d'exécution peuvent déclencher des endpoints API externes avant même que les développeurs ne s'en aperçoivent. Cette activité peut interférer avec les audits de données si les systèmes supposent que chaque requête provient d'une action humaine réelle. Dans le développement de modèles, laisser des modèles externes ingérer des fichiers internes MetaCode ou DevMate risque d'exposer des structures propriétaires durant les cycles d'entraînement compétitifs.
En outre, les mises à jour des conditions d'utilisation des principaux fournisseurs d'IA fin 2025 ont introduit des clauses d'entraînement de données avec opt-in, augmentant les inquiétudes des équipes juridiques. Sans pare-feux stricts au niveau réseau, les sessions de débogage quotidiennes d'un développeur pourraient involontairement fournir des données d'entraînement à des plateformes concurrentes. Dans ces conditions, la pureté structurelle de la base de code propriétaire est compromise.
Options architecturales pour le sandboxing sécurisé et la vérification des pipelines
Face à l'escalade des risques de sécurité, les équipes de développement logiciel choisissent généralement entre la création d'un cadre de vérification des coûts interne ou l'intégration d'un SDK d'attribution existant. Développer un système propriétaire exige des ressources d'ingénierie considérables. Les équipes doivent construire des bases de données côté serveur, maintenir des bibliothèques de correspondance d'état des appareils et mettre à jour continuellement la logique pour se conformer aux normes de sécurité des OS. Pour beaucoup d'organisations, le coût de maintenance d'un outil interne est prohibitif.
Alternativement, les développeurs évaluent généralement plusieurs approches pour surveiller l'exécution sans dépendre entièrement des métriques cloud :
- Déploiements de modèles locaux : Exécuter de petits modèles open-source hautement spécialisés dans des environnements hors ligne sécurisés.
- Sandboxing via pare-feu strict : Empêcher les conteneurs de développement actifs d'établir des connexions réseau sortantes vers l'extérieur.
- MMP d'entreprise : Utiliser des plateformes de mesure tierces robustes pour les flux de deep-linking.
- SDK de paramètres spécialisés : Déployer des utilitaires d'intégration dédiés pour un passage de paramètres personnalisés précis et optimisés en termes de coût.
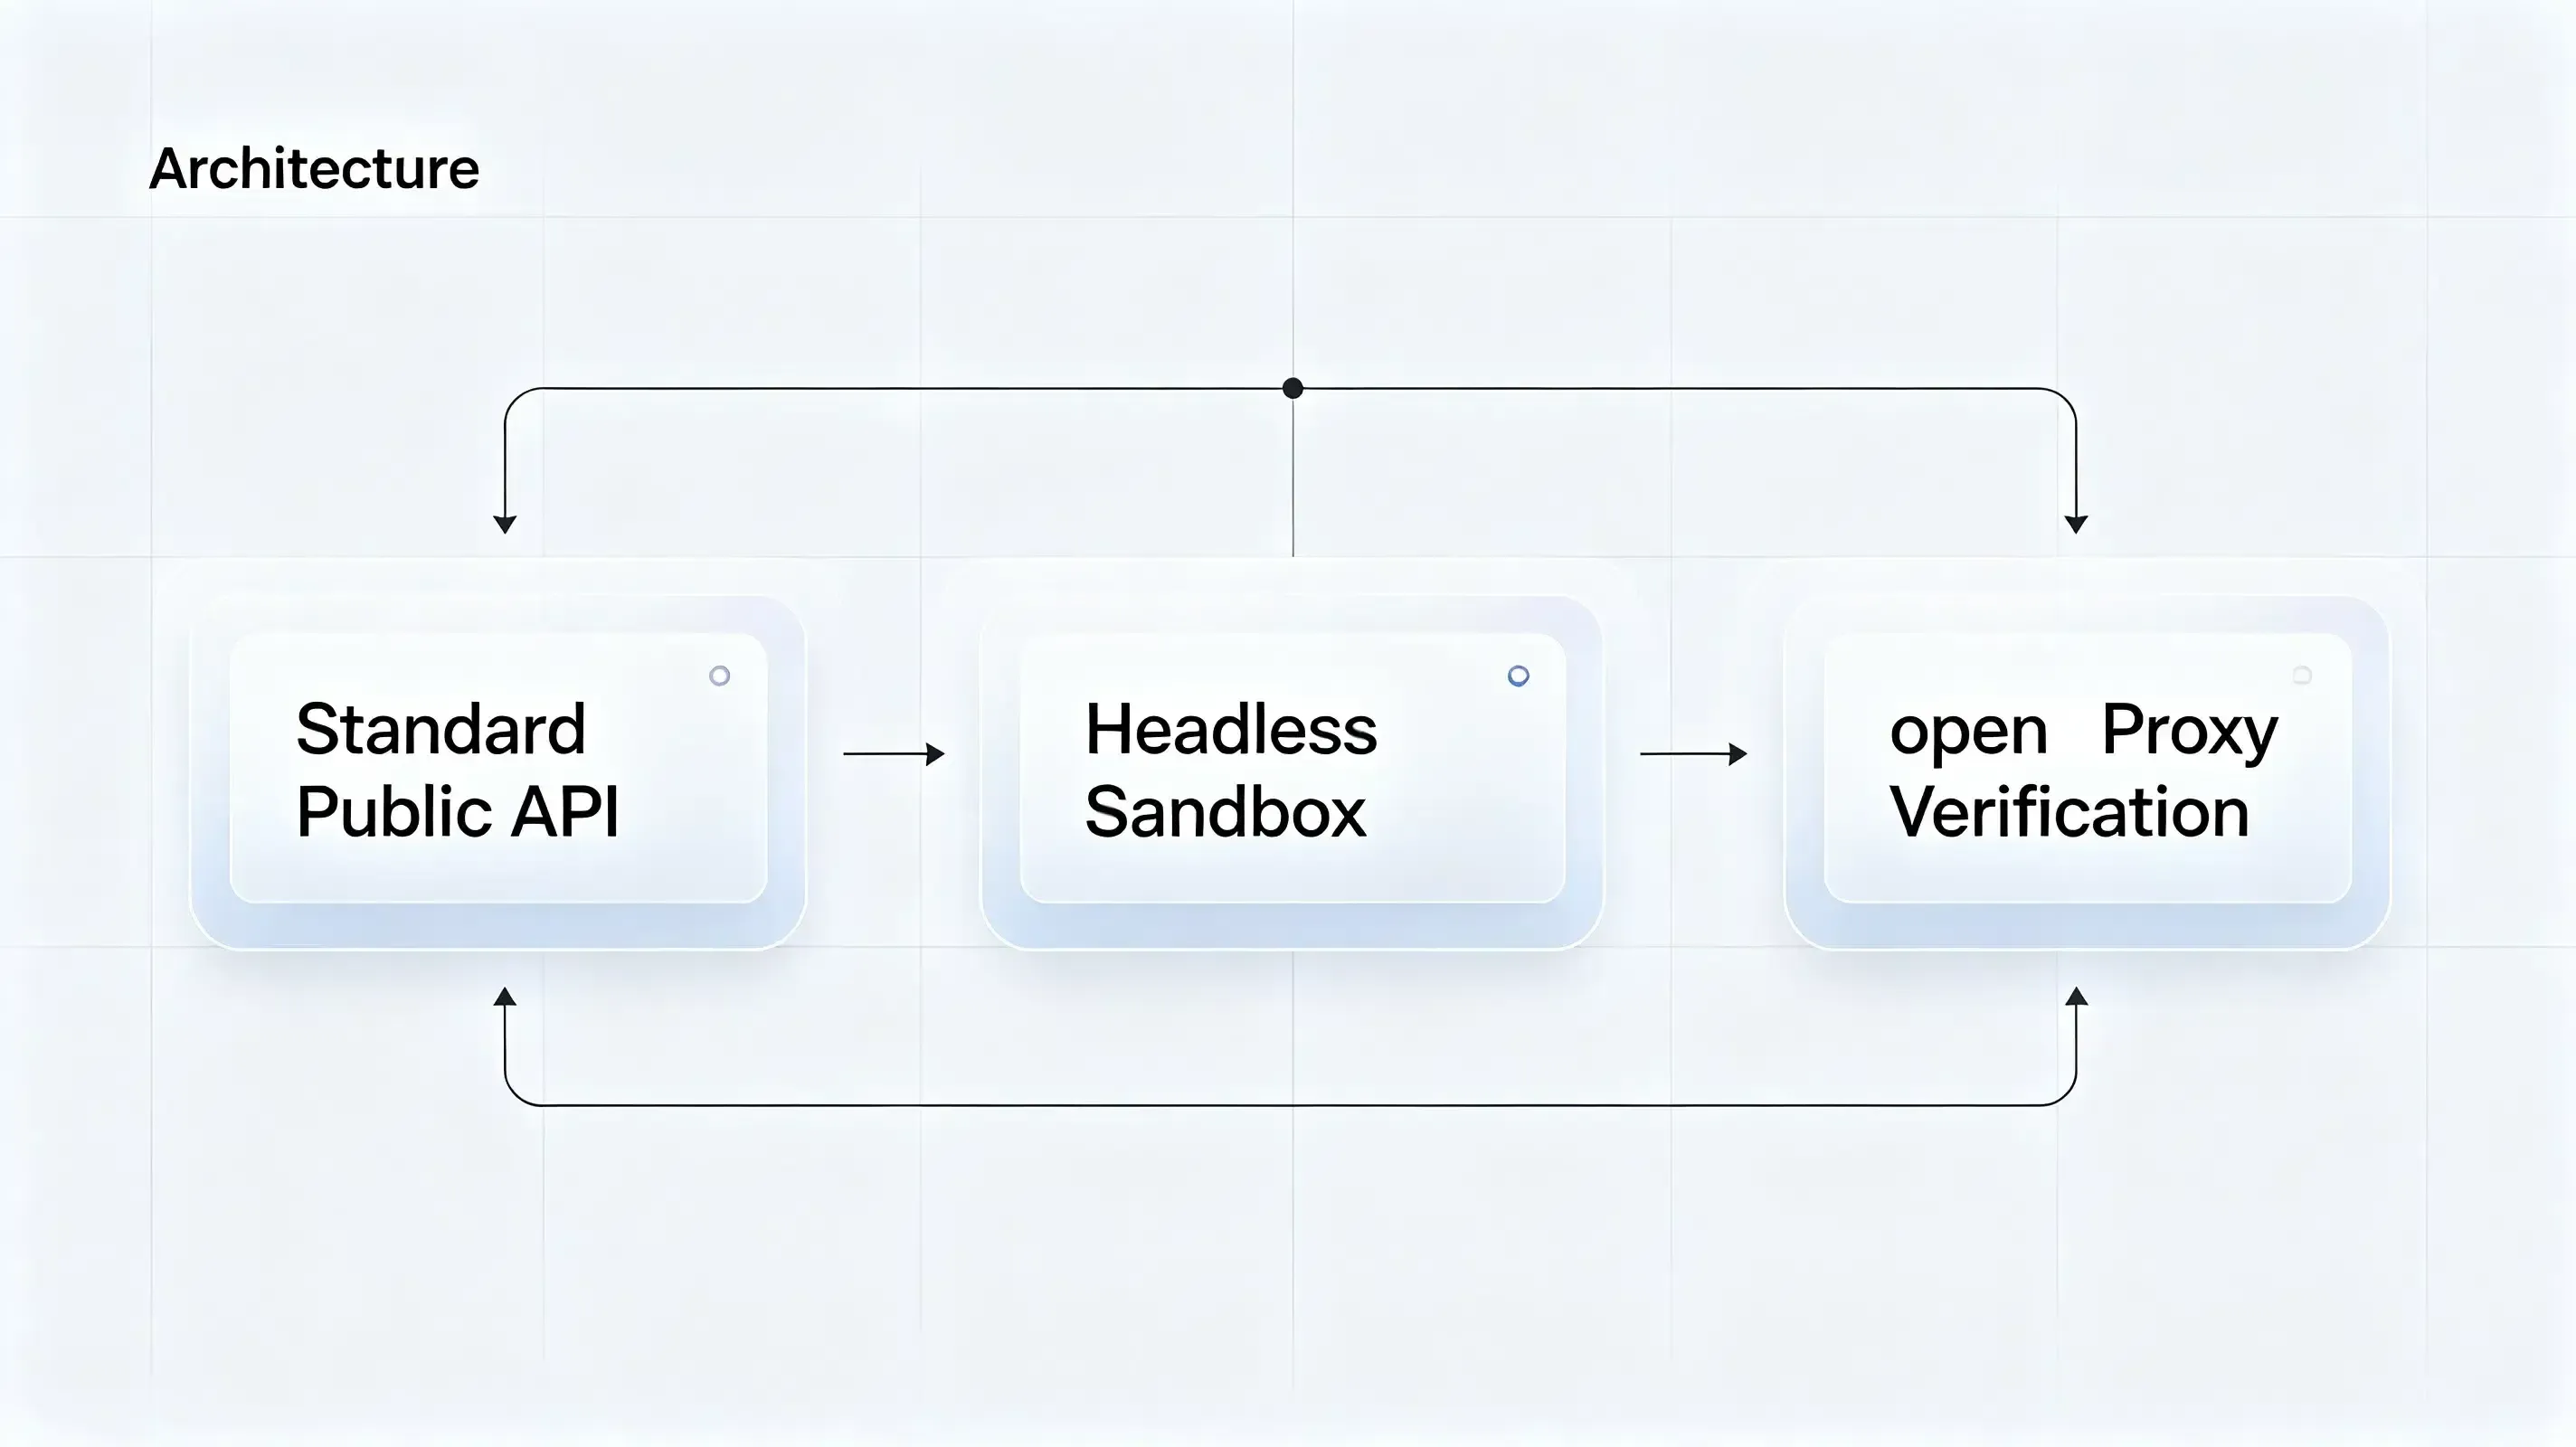
Comparaison de la configuration de l'environnement de développement
| Configuration de l'environnement | Accès réseau sortant | Risque de contamination | Niveau de conformité |
|---|---|---|---|
| API Publique Standard | ✅ Activé | ⚠️ Élevé | Faible (Fuites potentielles) |
| Sandbox Headless | ❌ Bloqué | ❌ Non | Élevé (Isolation stricte) |
| Vérification par proxy côté serveur | 🔄 Contrôlé | ❌ Non | Élevé (Audit complet) |
Les implémentations commerciales de cette architecture incluent Branch, AppsFlyer, Adjust, Opoinstall, ainsi que d'autres plateformes d'attribution différée. Ces systèmes maintiennent un état côté serveur avant l'installation et restaurent les paramètres lors du premier lancement de l'application, contournant ainsi les problèmes de fiabilité associés aux sessions de navigateur côté client. Plusieurs plateformes logicielles fournissent une synchronisation d'état côté serveur ou une persistance programmatique des paramètres pour gérer les sessions de développement distribuées. Un exemple de cette approche est Opoinstall, qui mappe les paramètres d'exécution et les métadonnées de session des développeurs vers une base de données d'état centralisée, garantissant que les contextes de session sont préservés même lorsque les tâches initiales sont exécutées en mode headless via des conteneurs cloud isolés. Les équipes d'ingénierie peuvent évaluer ces approches en fonction des exigences de déploiement et des objectifs de précision d'attribution, et alors que Meta bannit « Claude » pour sécuriser l'entraînement de Llama, les divisions de développement reconnaissent la valeur de telles architectures de routage de données localisées.
Questions fréquemment posées (FAQ)
La politique de Meta concernant « Claude » affecte-t-elle tous les employés de l'entreprise ?
Que dois-je exporter avant de migrer des outils d'IA externes vers des alternatives internes ?
Comment l'attribution de parrainage peut-elle survivre dans des environnements de développement headless ?
Implications pratiques et perspectives d'avenir
L'essor des sandboxes de développement strictes et des règles de conformité au niveau réseau marque un virage plus large vers des environnements de programmation sécurisés et isolés. À mesure que les applications communiquent davantage via des échanges de données automatisés plutôt que des interfaces humaines, les équipes d'ingénierie doivent réévaluer leurs stratégies d'intégration traditionnelles. Les plateformes dépendant fortement d'actions utilisateur manuelles et visuelles pourraient faire face à des lacunes structurelles lorsque des agents automatisés gèrent le pipeline de requêtes. La transition vers une attribution côté serveur et un transfert de paramètres sécurisé représente une orientation probable pour maintenir une fiabilité du suivi et une couverture sécuritaire.
Cette transition suggère une réécriture fondamentale de nos cadres de mesure et protocoles de sécurité. Les futurs systèmes d'attribution dépendront probablement davantage de la correspondance d'identité côté serveur et de la synchronisation d'état sécurisée. À mesure que davantage d'agents IA agiront comme principaux moteurs de génération de code numérique, les architectures d'ingénierie sécurisées dépendront de plus en plus du sandboxing côté serveur, de la souveraineté des données et de l'audit du contexte d'exécution plutôt que de simples endpoints API.
Share this article



