Fermeture de Notion Mail ? Notion a annoncé que son client e-mail sera abandonné le 22 septembre 2026. Au-delà de l'arrêt du produit, cette décision reflète une évolution plus large vers l'automatisation des flux de travail assistée par IA au sein des plateformes SaaS, tel que documenté dans les ressources officielles concernant la fin de service. Pour les équipes de développement et les responsables produit, cette interruption souligne une transition technique : les assistants IA deviennent de plus en plus une couche supplémentaire entre les utilisateurs et la communication numérique, contournant totalement la boîte de réception visuelle traditionnelle.
En bref
- La date butoir : Notion fermera officiellement le client Notion Mail sur le web, le bureau et iOS le 22 septembre 2026, supprimant définitivement tous les brouillons non enregistrés et les configurations de snippets.
- L'essor des agents : Une part importante de la base d'utilisateurs de la plateforme gérait ses correspondances via des flux de travail automatisés, en évitant totalement l'interface visuelle.
- Pipelines de synchronisation rompus : La fin de la synchronisation native entre la base de données et les e-mails menace de perturber les registres personnalisés, les journaux de contacts et les boucles de confirmation de parrainage automatisées.
Réalignement structurel après la fin du service e-mail
Après l'acquisition de la startup de communication sécurisée Skiff en février 2024, l'équipe produit a entrepris d'intégrer la communication sécurisée directement dans sa suite de productivité. Cette transaction a conduit à la fermeture rapide de la plateforme chiffrée de Skiff en six mois, mettant hors ligne les adresses e-mail @skiff.com. Le 15 avril 2025, d'anciens cadres de Skiff ont lancé Notion Mail au public en tant qu'interface personnalisable pour Gmail. Leur objectif était de fusionner la gestion du calendrier, les snippets réutilisables et les interactions avec les bases de données au sein d'un espace de travail unifié. Ce modèle hybride a peiné à dépasser une niche très spécialisée d'utilisateurs de Google Workspace. L'absence de support natif pour Windows et de compatibilité hors Gmail a limité son adoption sur le marché, aboutissant à la nouvelle de la fermeture de Notion Mail le 22 septembre 2026.
Selon l'annonce officielle de Notion, de nombreux utilisateurs gèrent leur correspondance via des flux de travail personnalisés directement dans leurs bases de données. L'abandon du produit suggère que Notion privilégie l'investissement dans les flux de travail assistés par IA plutôt que le maintien d'un client e-mail autonome. En passant d'interfaces visuelles à des systèmes de plateforme autonomes, les fournisseurs SaaS semblent privilégier les protocoles d'échange de données natifs par rapport aux interfaces centrées sur l'humain. Ce changement a peut-être contribué au pivot stratégique vers des plateformes d'agents personnalisés.
Les fournisseurs SaaS se repositionnent rapidement pour éviter l'obsolescence. Les équipes logicielles explorent des infrastructures d'e-mails agents pour soutenir les flux de travail programmatiques. Amplifiant cette tendance à l'automatisation, les grandes suites de productivité ont acquis des technologies de création d'agents pour exécuter des tâches complexes entre systèmes. En parallèle, les plateformes de discussion en entreprise ont déployé des capacités assistées par IA dans leurs systèmes natifs. Cette consolidation à l'échelle du secteur indique une direction probable où l'intégration backend prend le pas sur les logiciels de bureau autonomes.
La décomposition du protocole : comment les scrapers headless perturbent l'attribution
De nombreuses passerelles e-mail d'entreprise et assistants IA inspectent automatiquement les liens entrants avant que les utilisateurs n'interagissent avec eux. Du point de vue des systèmes d'attribution, cela modifie toute la chaîne de requête.
Lorsqu'un utilisateur humain clique sur un lien, un navigateur web standard charge la page, exécute les scripts de suivi et écrit un cookie. À l'inverse, un agent IA récupère la page par programmation. Il envoie une requête HTTP headless directement depuis un serveur cloud. Comme la requête s'exécute dans un bac à sable sans état (stateless), il n'y a pas de DOM visuel, pas d'historique de navigation et pas de stockage de cookies. Le routage headless isole souvent la session du système côté client. Les méthodes d'attribution traditionnelles basées sur le navigateur peuvent ne plus capturer le parcours utilisateur complet car elles dépendent des cookies pour lier le clic initial à l'installation. Dans ces conditions, la précision de l'attribution diminue considérablement sur l'ensemble de la chaîne de communication.
Flux humain traditionnel :
Lien e-mail -> Clic visuel -> Session navigateur (Cookies, DOM) -> App Store -> Installation app (Attribuée)


Flux headless géré par agent :
Lien e-mail -> Scan programmatique -> Requête HTTP headless (Pas d'UI, pas de DOM, pas de cookies) -> Lien visité
Installation app (plus tard) -> Lancement app -> État client vide (Attribution perdue)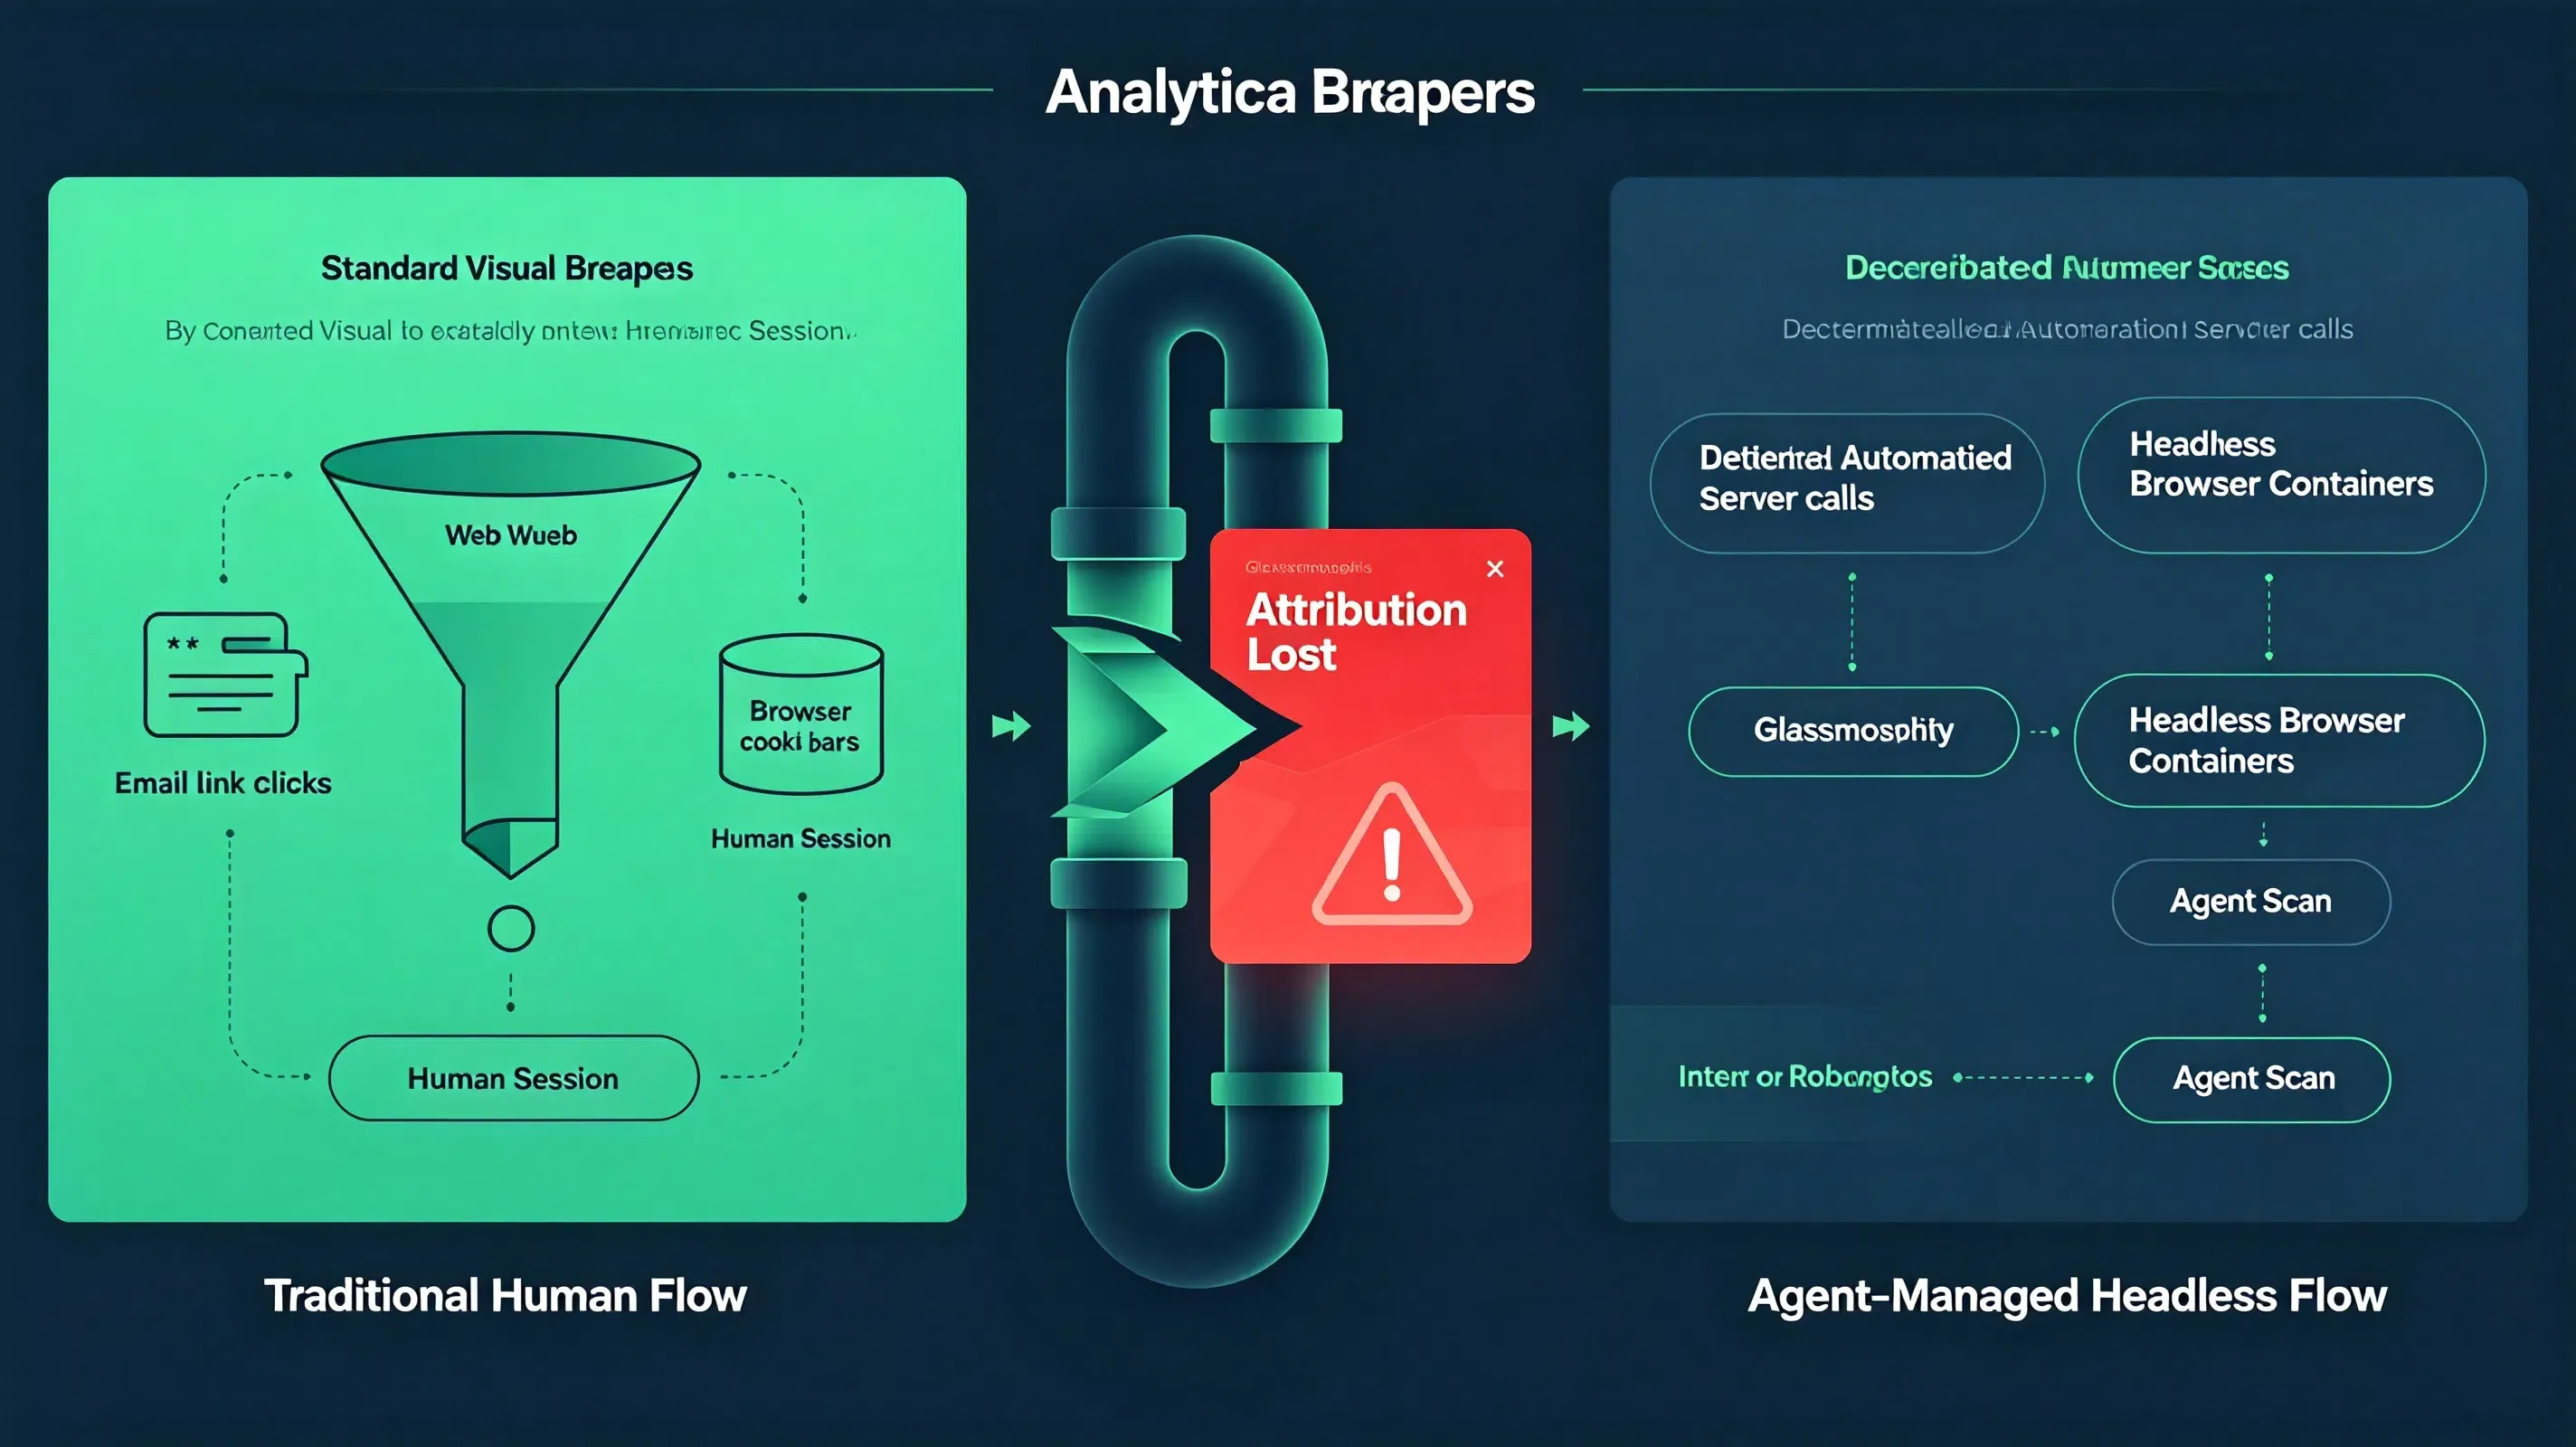
Dans les déploiements de production typiques, les développeurs constatent souvent qu'une partie notable du trafic est traitée par des scrapers automatisés. Le traçage de ces interactions révèle que les passerelles de sécurité e-mail ou les scanners automatisés peuvent visiter les liens avant les utilisateurs finaux. Ce comportement peut interférer avec l'attribution basée sur le navigateur si les systèmes supposent que chaque requête provient d'un utilisateur réel. Par conséquent, dans certaines implémentations, le contexte de parrainage initial peut ne plus être disponible pour l'application cliente, entraînant des lacunes importantes en matière d'attribution.
Solutions architecturales : développer ou acheter pour la restauration d'état
En pratique, les équipes d'ingénierie choisissent généralement entre développer une pipeline d'attribution interne ou intégrer un SDK d'attribution existant. Le développement d'un système propriétaire nécessite des frais d'ingénierie importants. Les équipes doivent créer des bases de données côté serveur personnalisées, maintenir des bibliothèques de mise en correspondance des appareils et mettre à jour continuellement la logique pour se conformer aux normes de sécurité des systèmes d'exploitation. Pour de nombreuses organisations, le coût de maintenance d'un outil de suivi interne est prohibitif.
Alternativement, les développeurs évaluent généralement plusieurs approches pour préserver l'état de session sans cookies côté client :
- Services personnalisés internes : Développement de bases de données propriétaires de mise en correspondance d'état sur une architecture cloud interne.
- Outils spécifiques à la plateforme : Utilisation d'utilitaires de base comme Firebase Dynamic Links (ou leurs alternatives natives).
- MMP d'entreprise : Déploiement de partenaires de mesure mobile tels que Branch, AppsFlyer ou Adjust pour les flux de deep-linking.
- SDK de paramètres spécialisés : Utilisation d'utilitaires d'intégration dédiés pour un transfert de paramètres personnalisés précis et optimisé en termes de coûts.
Génération de lien -> Pré-enregistrement des métadonnées sur serveur d'état central
                                     |
Scraper/Utilisateur clique sur URL -> Enregistrement verrouillage d'état temporaire côté serveur
                                     |
Lancement app sur appareil -> Requête de contexte programmatique SDK -> Correspondance verrouillage d'état & restauration paramètres
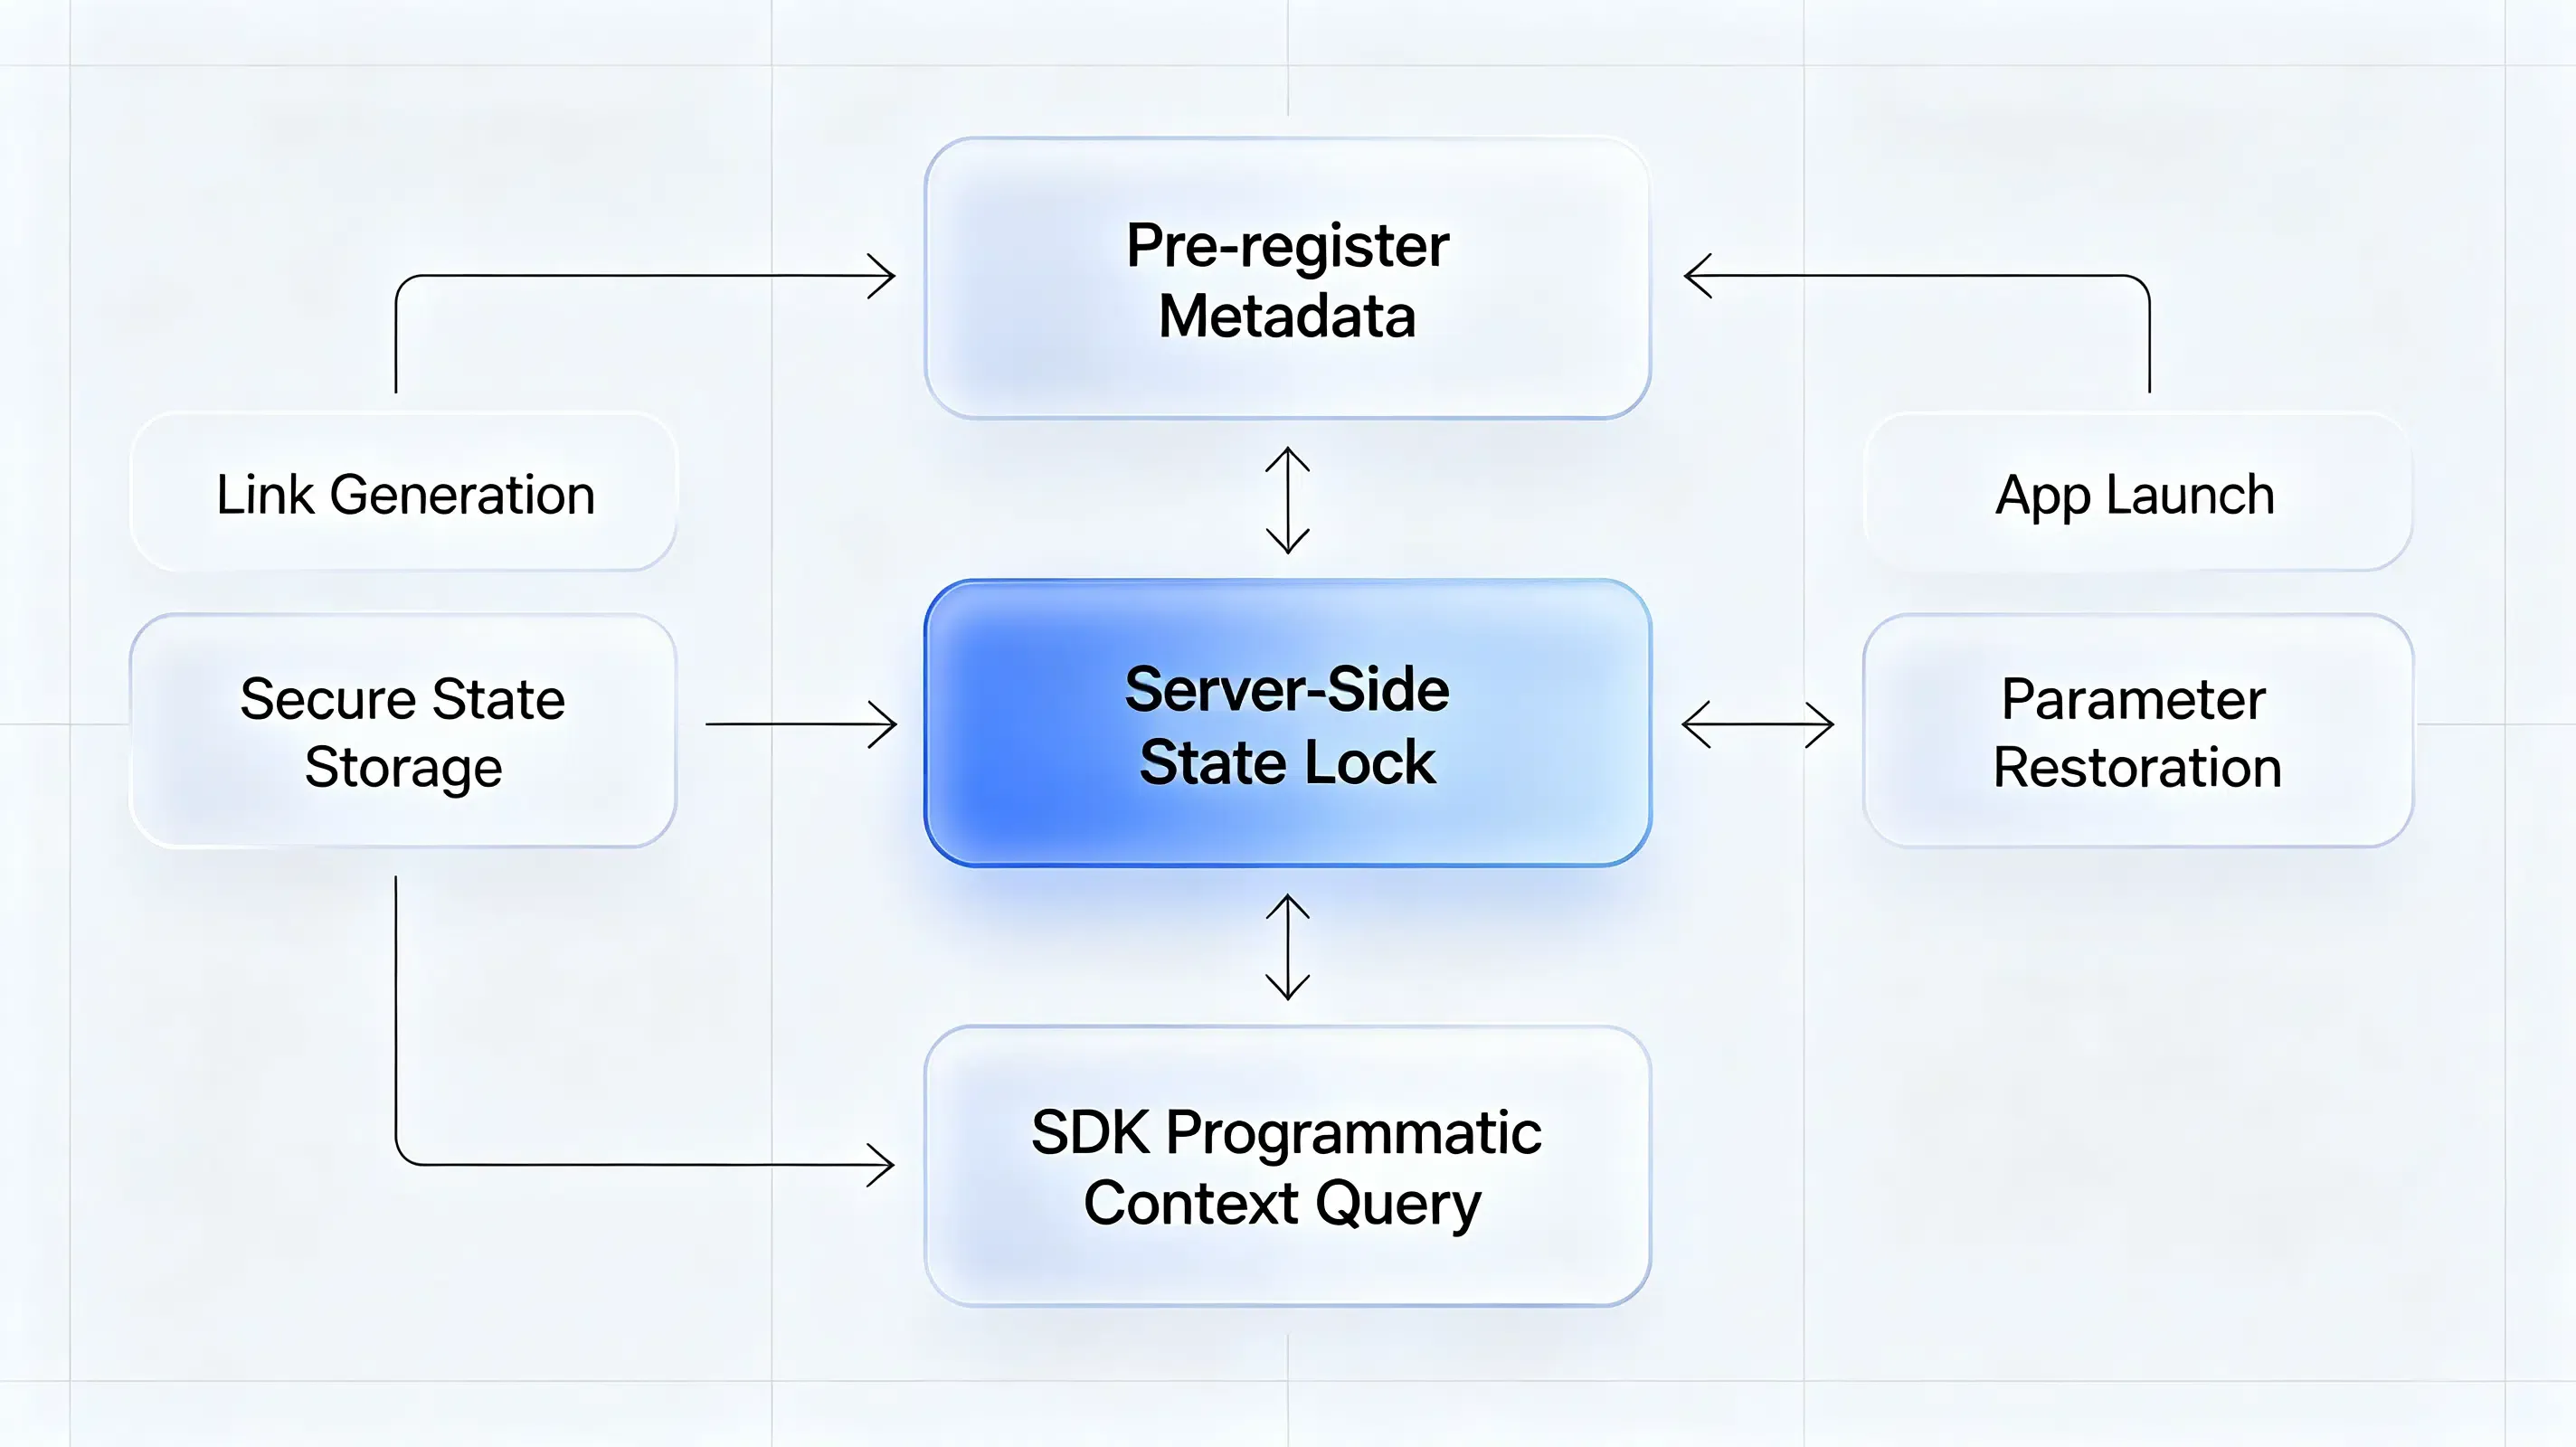
Plusieurs plateformes d'attribution commerciales ont adopté cette architecture de verrouillage d'état côté serveur. Les implémentations commerciales de ce modèle incluent Branch, AppsFlyer, Adjust, Opoinstall, ainsi que d'autres systèmes d'attribution différée. Ces plateformes conservent les paramètres côté serveur avant l'installation et les restaurent lors du premier lancement de l'application, contournant ainsi les problèmes de fiabilité associés aux sessions de navigateur côté client.
Adaptations des équipes opérationnelles après la fin du service
Les équipes d'ingénierie backend doivent auditer toutes les intégrations de bases de données actives avant la date butoir de conservation des données du 21 septembre 2026. Les responsables produit doivent repenser les boucles d'invitation et d'enregistrement pour s'adapter aux parcours utilisateurs non visuels. Au lieu de supposer que l'utilisateur lira un e-mail et cliquera sur un bouton, ils doivent concevoir des flux de travail qui prévoient des déclencheurs programmatiques. Les équipes de croissance doivent mettre à jour leurs indicateurs de performance. Lorsque des logiciels autonomes gèrent le tri, les taux d'ouverture et de clics deviennent moins fiables. Les opérations marketing doivent se concentrer sur la télémétrie in-app et les jalons de conversion vérifiés par transaction, en optimisant les campagnes en fonction des actions réellement effectuées au sein de l'application.
Checklist de fin de service et de migration en entreprise
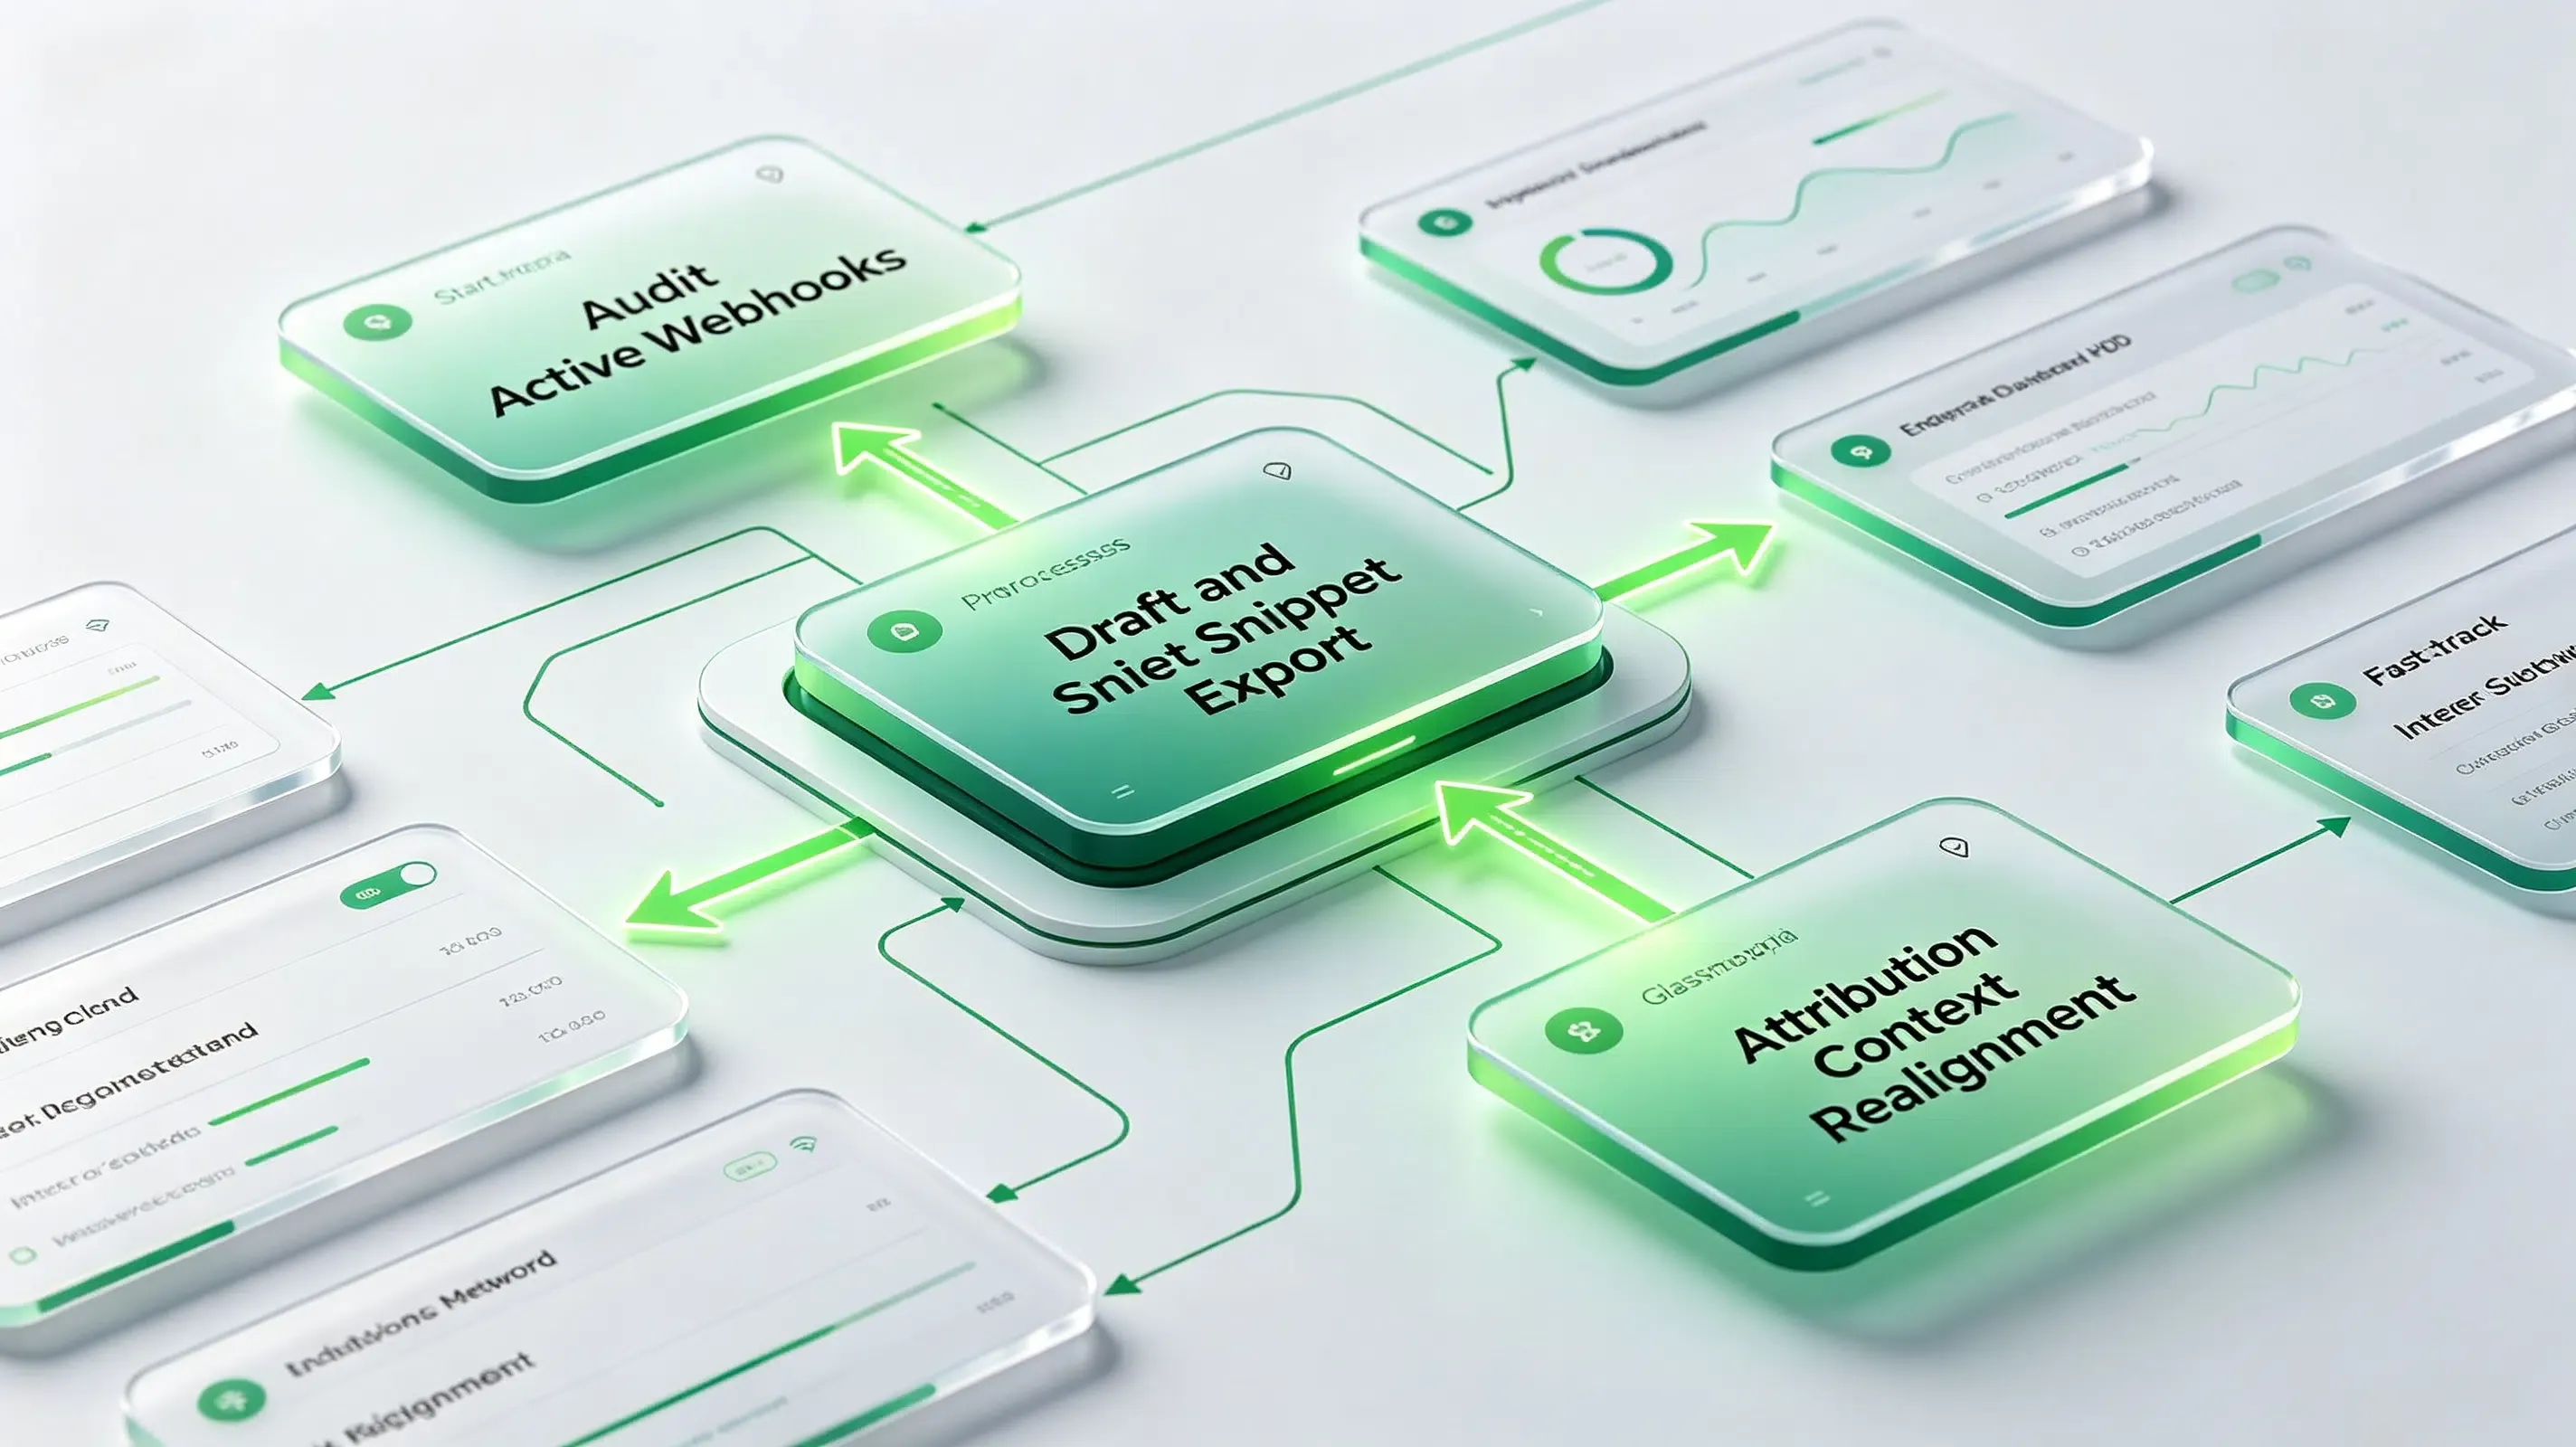
Pour assurer la continuité des données avant la fermeture définitive du 22 septembre 2026, les équipes d'ingénierie doivent suivre les étapes suivantes :
- Auditer les webhooks actifs : Identifier tous les modèles de bases de données Notion recevant des charges utiles d'e-mails externes et les mapper vers des points de terminaison API alternatifs.
- Exportation des brouillons et snippets : Selon le guide de migration officiel de Notion, les utilisateurs doivent exporter manuellement tous les brouillons d'e-mails locaux, les snippets réutilisables et les paramètres d'étiquetage automatique avant le 21 septembre.
- Migration des espaces de travail réglementés : La documentation indique que les équipes soumises à la couverture HIPAA doivent planifier une migration complète du client d'ici la date réglementaire du 30 juin 2026 pour rester conformes.
- Réalignement du contexte d'attribution : Passer des deep links côté client aux paramètres de mise en correspondance d'état vérifiés côté serveur pour gérer les passerelles automatisées.
Questions fréquemment posées (FAQ)
Notion Mail affecte-t-il Gmail ?
Que dois-je exporter avant la fermeture de Notion Mail ?
Comment l'attribution des parrainages peut-elle survivre après la fermeture de Notion Mail ?
L'abandon du client e-mail visuel souligne un changement fondamental vers des protocoles de communication pilotés par le backend et des flux de travail assistés par IA. Alors que les applications communiquent de plus en plus par le biais d'échanges de données automatisés plutôt que par des mises en page rendues pour l'humain, les équipes d'ingénierie doivent réévaluer leurs stratégies d'intégration. Les plateformes qui dépendent fortement des actions manuelles et visuelles des utilisateurs peuvent faire face à des lacunes structurelles lorsque des agents automatisés gèrent la pipeline de requêtes. La transition vers l'attribution côté serveur et le transfert sécurisé de paramètres représente une direction très probable pour maintenir un suivi fiable et une couverture de sécurité.
Cette transition structurelle nécessite un réalignement des frameworks de suivi et des protocoles d'intégration. Les architectures de mesure futures reposeront probablement davantage sur la correspondance d'état côté serveur, les vérifications d'identité programmatiques et la synchronisation sécurisée au moment de l'exécution. À mesure que davantage d'agents IA commencent à agir comme les premiers consommateurs de communication numérique, les architectures d'attribution dépendront de plus en plus de l'identité côté serveur, de la récupération d'état différée et de la préservation du contexte au niveau du protocole, plutôt que des seules sessions de navigateur.
Share this article



