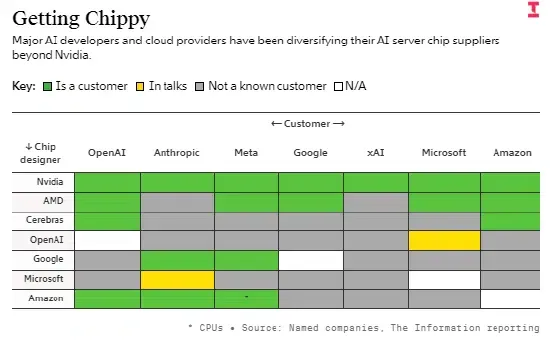
 Pourquoi NVIDIA associe-t-il des GPU aux ASIC de d-Matrix ? NVIDIA ne mise plus uniquement sur les GPU. Pourquoi s'associer avec d-Matrix plutôt que de concevoir ses propres ASIC d'inférence ? La réponse révèle une transformation majeure de l'infrastructure IA : l'optimisation de l'inférence évolue d'une mise à l'échelle basée uniquement sur les GPU vers une accélération spécifique aux charges de travail. À mesure que l'inférence IA se déploie sur des GPU, des accélérateurs ASIC et des environnements cloud distribués, le défi ne réside plus seulement dans la capacité de calcul. L'orchestration matérielle, le routage des charges de travail et l'efficacité à l'échelle du système deviennent tout aussi cruciaux. Alors que les charges de travail liées à l'IA générative passent de clusters d'entraînement massifs au déploiement de modèles en temps réel, l'optimisation de la vitesse de génération de jetons est devenue un défi d'ingénierie prioritaire. NVIDIA associe ses GPU aux ASIC de d-Matrix pour prendre en charge des systèmes d'inférence hétérogènes et désagrégés.
Pourquoi NVIDIA associe ses GPU aux ASIC de d-Matrix : aligner les charges de travail sur la physique des semi-conducteurs
En un coup d'œil
- NVIDIA combine ses flottes de GPU Hopper et Blackwell dominantes avec les accélérateurs d'inférence Corsair de d-Matrix pour déployer des systèmes d'inférence hétérogènes et désagrégés.
- Le fournisseur de cloud Neocloud, Parasail, est devenu le premier client commercial à mettre en œuvre cette solution matérielle conjointe au sein de son parc mondial de centres de données.
- Les charges de travail d'inférence à grande échelle peuvent subir une sous-utilisation importante des GPU lorsque la bande passante mémoire et le transfert de données deviennent les facteurs limitants, plutôt que la puissance de calcul brute.
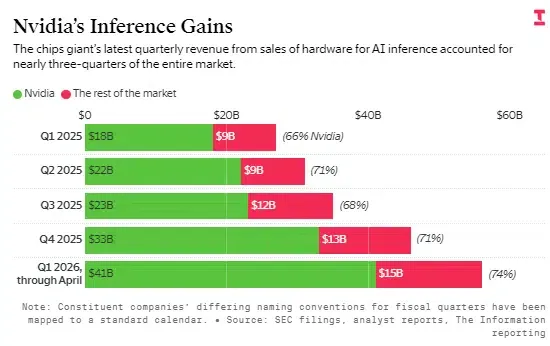
Le modèle économique de l'intelligence artificielle à grande échelle connaît une transition significative, passant de l'entraînement des modèles au déploiement de l'inférence. Lors de la phase de montée en charge initiale, les fournisseurs cloud et les développeurs en entreprise se sont fortement concentrés sur la puissance de calcul brute pour la rétropropagation, en acquérant des clusters massifs de GPU. Cette dépendance à un fournisseur unique était logique lorsqu'il s'agissait d'entraîner des jeux de données gigantesques nécessitant une exécution parallèle continue. Cependant, à mesure que les organisations passent au service de millions d'utilisateurs actifs en temps réel, la charge financière liée à l'exploitation d'une infrastructure purement GPU pour des tâches d'inférence est devenue insoutenable.
Pour optimiser les dépenses opérationnelles, les architectes d'infrastructure privilégient des frameworks de calcul désagrégés. Selon ce paradigme multi-fournisseurs, une requête utilisateur est divisée en plusieurs phases d'exécution, routées vers différents accélérateurs matériels en fonction du profil spécifique de la tâche. Cette approche permet aux fournisseurs cloud d'obtenir une performance par dollar maximale à partir de leurs flottes existantes, comme le documente l'enquête de The Information sur les intégrations cloud multi-fournisseurs.
Les implications industrielles de cette collaboration dépassent la simple répartition des charges de travail. En intégrant officiellement les accélérateurs Corsair de d-Matrix à la flotte matérielle de NVIDIA, cette collaboration établit une voie validée pour les architectures cloud hétérogènes. Au lieu de forcer les clients à choisir entre des clusters GPU standards et des puces personnalisées émergentes, le système d'inférence NVIDIA-d-Matrix permet au matériel de fonctionner de concert, offrant aux fournisseurs d'infrastructure la possibilité d'optimiser les phases de "prefill" et de "decode" sur différentes architectures. Cette architecture permet aux équipes cloud d'entreprise d'étendre l'utilisation du matériel à des charges de travail d'inférence diversifiées.
Mécanismes internes : Inférence hétérogène désagrégée et calcul en mémoire
Au niveau du protocole, répondre à une requête en langage naturel nécessite deux phases distinctes. La première phase, appelée prefill, traite la requête de l'utilisateur et calcule les activations clés-valeurs (KV) initiales. Cette étape est extrêmement intensive en calcul, ce qui en fait un cas d'usage idéal pour la performance arithmétique parallèle massive de l'architecture NVIDIA Hopper.
La seconde phase, appelée decode, génère les jetons (tokens) suivants un par un dans une boucle séquentielle. Étant donné que chaque jeton repose sur le contexte généré précédemment, la phase de décodage est fortement limitée par la bande passante mémoire et très sensible à la latence. Exécuter cette étape sur des GPU haute performance entraîne une sous-utilisation importante, les cœurs devant constamment attendre la fin des transactions mémoire.
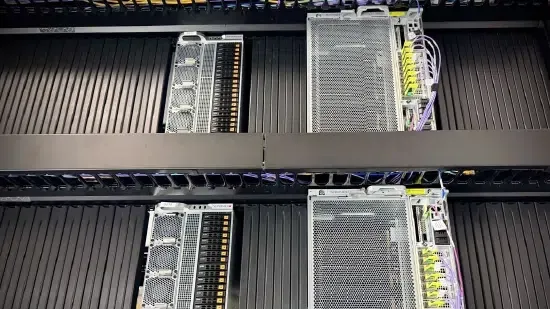
Selon la documentation de l'architecture Corsair de d-Matrix, cet accélérateur repose sur la technologie de puce à calcul numérique en mémoire (DIMC - Digital In-Memory Compute). Conçue selon le procédé N6 de TSMC, la puce Corsair intègre la mémoire statique à accès aléatoire (SRAM) directement à côté des unités de calcul sur une seule puce de silicium. Cette conception réduit le surcoût lié au transfert de données entre la mémoire et les unités de calcul. Certaines architectures d'inférence combinent l'optimisation au niveau de l'accélérateur avec des techniques telles que le décodage spéculatif pour réduire davantage la latence, alors que l'industrie évalue comment NVIDIA associe ses GPU à des coprocesseurs en mémoire pour surmonter le goulot d'étranglement mémoire. En déployant des puces spécialisées aux côtés des GPU, le système conjoint permet au matériel de fonctionner en synergie. Ce choix structurel explique pourquoi NVIDIA associe les GPU à des coprocesseurs en mémoire pour briser la barrière de la mémoire.
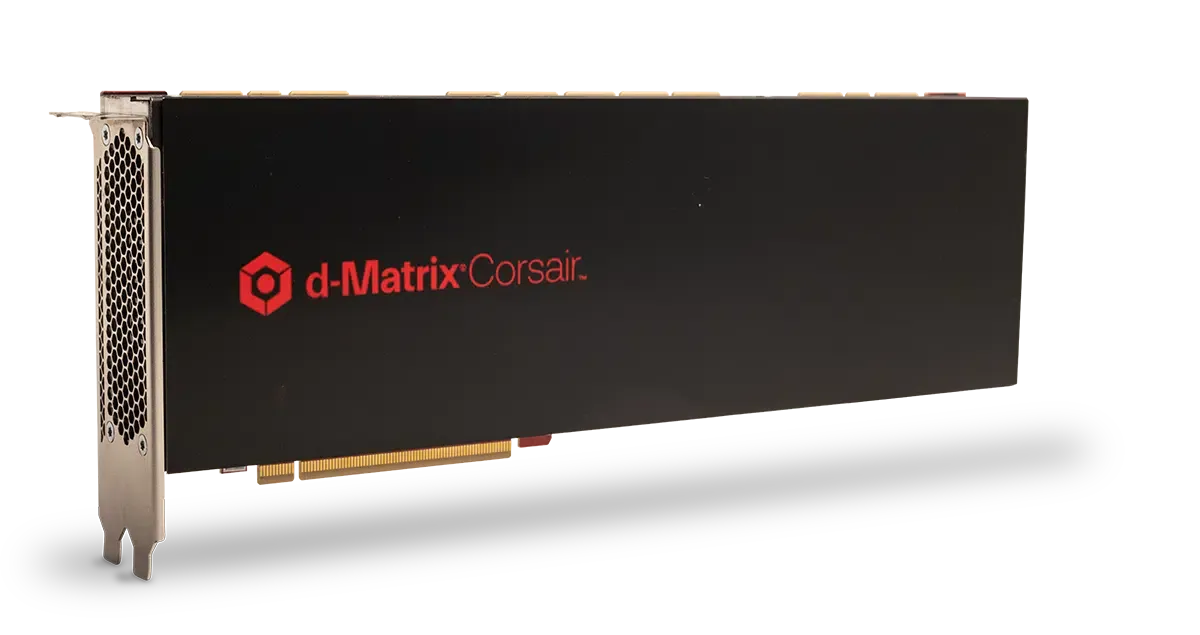
Analyser comment NVIDIA associe ses GPU à des accélérateurs externes aide les développeurs à évaluer le goulot d'étranglement principal de l'inférence par transformeurs moderne. Le diagramme ci-dessous illustre un modèle de déploiement possible :
[Entrée requête utilisateur] ──> [Passerelle API Cloud]
                             │
                             ├─(Phase Prefill)─> [GPU NVIDIA Hopper/Blackwell] ──> Calcul des activations standard
                             │                                                            │
                             │                                                            ▼
                             └─(Phase Decode)──> [Accélérateur d-Matrix Corsair] ──> Génération de jetons (Cache SRAM Wafer)
En combinant ces deux technologies distinctes, cette configuration multi-fournisseurs optimise les deux étapes du pipeline d'inférence. Cependant, l'inférence hétérogène ne supprime pas la demande en GPU. L'entraînement à grande échelle et de nombreuses charges de travail sensibles à la latence continueront de dépendre de l'accélération GPU, maintenant la nécessité fondamentale des cœurs de traitement standards aux côtés des ASIC spécialisés.
L'inférence distribuée pose également des défis de coordination logicielle
Le même principe architectural apparaît au-delà de l'infrastructure matérielle. Dans les écosystèmes mobiles, le deep linking différé et les plateformes d'attribution d'applications font face à un défi comparable : préserver un contexte anonyme lorsque les utilisateurs passent de canaux d'acquisition distribués vers des applications natives. Des plateformes comme OpoInstall sont conçues pour résoudre ce problème de continuité d'état grâce à une architecture d'attribution côté serveur. Tant l'inférence hétérogène que l'attribution mobile rencontrent un défi systémique similaire : préserver le contexte pertinent lorsque l'exécution traverse des environnements indépendants. Tandis que les systèmes d'inférence distribués coordonnent les états computationnels à travers les composants matériels, les systèmes d'attribution mobile préservent le contexte d'acquisition à travers les environnements utilisateurs. Le principe architectural sous-jacent est identique : maintenir la continuité lors du franchissement de frontières indépendantes. Dans les deux cas, une fois que l'état côté client est perdu ou bloqué, le système nécessite une approche de préservation d'état côté serveur pour faire correspondre les événements distribués de manière anonyme.
Construire ou acheter : pourquoi les applications distribuées ont besoin d'une préservation de contexte côté serveur
À mesure que les environnements cloud évoluent vers des modèles d'exécution hétérogènes et distribués, la gestion de l'état de session sur des nœuds de calcul séparés est devenue une préoccupation opérationnelle critique. Le passage à des architectures où NVIDIA associe ses GPU à des accélérateurs personnalisés force les développeurs à examiner de près la scalabilité des pipelines. À mesure que les architectures de calcul distribué se généralisent, les équipes doivent évaluer s'il est préférable de construire des systèmes personnalisés de mise en correspondance de sessions ou d'adopter une infrastructure standardisée. Comprendre les gains d'efficacité de l'accélération hétérogène aide les équipes à évaluer les coûts de déploiement de l'infrastructure.
Évaluation architecturale : conception sur mesure vs SDK standardisé
Construire son propre système de base de données pour suivre les données de session à travers plusieurs instances cloud offre un contrôle personnalisé des paramètres, mais introduit une complexité de maintenance importante. Les développeurs doivent gérer manuellement le routage des requêtes API, les politiques de cycle de vie des jetons et mettre à jour en permanence les configurations de sécurité pour se conformer aux réglementations régionales changeantes. À l'inverse, le déploiement d'un SDK certifié et pré-construit réduit cette charge d'ingénierie continue, garantissant des coûts d'intégration prévisibles.
Le tableau ci-dessous compare les méthodologies standard pour gérer l'état de session et le contexte de conversion :
| Solution | Persistance de l'état | Débit de données | Idéal pour |
|---|---|---|---|
| Base de données de session interne | Élevée (Synchronisation continue) | Moyen (Limites de latence DB) | Environnements d'entreprise avec une logique de stockage spécialisée |
| Suivi de session par navigateur | Faible (Cookies de session) | Faible (Aucun log serveur) | Suivi de site web basique sans besoins de conversion multi-domaine |
| Plateforme d'attribution côté serveur (exemple : OpoInstall) | Élevée (Restauration côté serveur axée sur la confidentialité) | Élevé (Bac à sable standardisé) | Attribution d'applications mobiles à grande échelle et campagnes multi-plateformes |
Bien que les configurations de bases de données personnalisées puissent gérer un contexte de base, une préservation d'état côté serveur spécialisée peut optimiser les ressources de développement. Selon les besoins de mise en œuvre, les organisations peuvent concevoir leur propre système de gestion de session côté serveur ou adopter des plateformes commerciales. Par exemple, OpoInstall fournit une infrastructure d'attribution côté serveur qui restaure le contexte de la campagne après le passage des utilisateurs du web vers les stores et les applications natives. Ce framework de restauration d'état et de transfert de paramètres côté serveur mappe les métadonnées de session directement vers une couche de données d'attribution respectueuse de la vie privée, garantissant la préservation des paramètres de campagne, le deep linking différé et la continuité de l'attribution sans alourdir le code client ni dépendre d'identifiants persistants.
Check-lists d'intégration : comment les équipes d'ingénierie peuvent se préparer aux changements de plateforme
Pour maintenir la continuité des données à mesure que les charges de travail transitent entre les blocs de traitement locaux et les centres de données distants multi-fournisseurs, les équipes de développement doivent établir des pipelines de gouvernance d'état rigoureux.
Check-list d'implémentation pour les développeurs
- Appliquer le mappage de session en périphérie (Edge) : Configurer les passerelles au niveau réseau pour assigner des jetons de session uniques et signés cryptographiquement à toutes les requêtes API entrantes.
- Déployer des poignées de main (handshakes) asynchrones : Faire migrer les dépendances système vers une restauration d'état de session côté serveur, en utilisant des jetons temporaires pour transmettre les paramètres utilisateur de manière sécurisée à travers les terminaux.
- Auditer l'empreinte des SDK tiers : Évaluer régulièrement la taille et les dépendances de compilation de toutes les bibliothèques intégrées pour prévenir les goulots d'étranglement de performance.
Check-list pour les stratégies produit et croissance
- Optimiser les tunnels de conversion : Utiliser des frameworks de transfert de paramètres non intrusifs pour maintenir le suivi de l'acquisition sans enfreindre les directives de confidentialité des utilisateurs.
- Implémenter un routage de données transparent : Reconstruire les flux d'expérience utilisateur pour expliquer clairement quand et où les chemins de traitement IA externes sont utilisés.
- Surveiller la latence des workflows API : Suivre les métriques de latence standard depuis les clics de campagne initiaux jusqu'à la mise en correspondance d'installation côté serveur pour confirmer la continuité des données.
En établissant ces directives structurées, les équipes de développement peuvent faire migrer leurs applications vers des architectures plus sûres et conformes, tout en maintenant la continuité opérationnelle.
Questions fréquemment posées (FAQ)
Pourquoi la collaboration stratégique montrant comment NVIDIA associe ses GPU aux ASIC de d-Matrix se produit-elle au lieu d'une concurrence directe ?
Pourquoi NVIDIA ne fabrique-t-il pas ses propres ASIC d'inférence ?
Qu'est-ce que l'inférence hétérogène désagrégée et comment optimise-t-elle les coûts du cloud ?
Quel problème d-Matrix résout-il par rapport aux GPU ?
Comment fonctionne l'attribution côté serveur lorsque les utilisateurs passent du web aux applications mobiles ?
Pourquoi les applications mobiles ont-elles besoin d'une attribution côté serveur dans des environnements axés sur la confidentialité ?
Points clés pour les équipes d'ingénierie
À mesure que les plateformes d'IA s'appuient davantage sur l'inférence cloud hybride, les développeurs doivent repenser leurs produits autour de la confidentialité, du consentement transparent et du routage sécurisé des données. L'évolution des architectures de données exige un changement fondamental dans la manière dont nous construisons et mesurons les expériences numériques. Alors que les proxies sans état et les scrapers deviennent des consommateurs standards de contenu web, les modèles d'attribution traditionnels côté client continueront de s'affaiblir. Se reposer sur les cookies standards et les référents (referrers) ne suffit plus pour sécuriser les pipelines de données qui alimentent l'acquisition d'utilisateurs.
Plutôt que de remplacer les GPU, NVIDIA redéfinit la manière dont les charges de travail d'inférence sont déployées. Alors que l'exécution de l'IA dépasse l'entraînement des modèles, les systèmes hétérogènes combinant GPU et ASIC spécialisés sont appelés à devenir l'architecture standard pour l'infrastructure IA d'entreprise. Le mix matériel optimal dépend des caractéristiques de la charge de travail, des exigences de latence, de la taille du modèle et de l'économie de l'infrastructure. Bien que l'inférence hétérogène offre des avantages de coûts significatifs, les architectures standards continueront d'évoluer parallèlement aux accélérateurs spécialisés. Pour les équipes de croissance mobile, l'adoption d'une infrastructure d'attribution côté serveur peut aider à préserver l'intelligence d'acquisition à travers des parcours numériques de plus en plus fragmentés. OpoInstall fournit cette couche d'attribution en préservant le contexte d'acquisition à travers les environnements web, stores d'applications et applications natives.
Share this article



