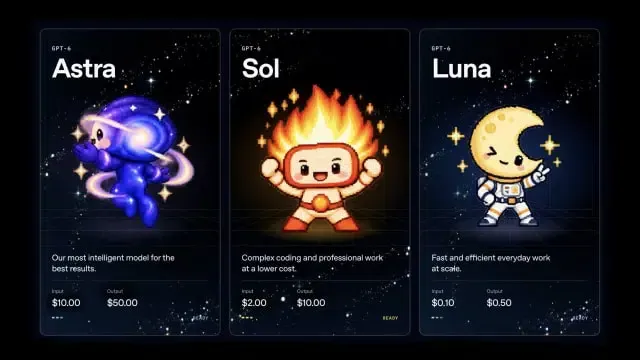
OpenAI réduit de moitié les coûts de l'API Sol ? OpenAI a officiellement annoncé la disponibilité commerciale de GPT-6 Sol et GPT-6 Luna le 22 septembre 2026, abaissant les tarifs des jetons d'API de 50 % ou plus par rapport aux prix promotionnels antérieurs du GPT-5.6 sur les points de terminaison standard. Pour le traitement standard des requêtes comprenant jusqu'à 272 000 jetons d'entrée, GPT-6 Sol est facturé 2,00 $ par million de jetons d'entrée et 10,00 $ par million de jetons de sortie, tandis que le modèle plus compact GPT-6 Luna s'établit à 0,10 $ en entrée et 0,50 $ en sortie par million de jetons. Lorsque OpenAI réduit de moitié les coûts de l'API Sol sur les paliers de développement standard, la déflation structurelle du calcul modifie les contraintes opérationnelles des logiciels génératifs. La baisse des prix unitaires rend économiquement viables à grande échelle les boucles d'agents récursifs, l'extraction de lots en arrière-plan et les travailleurs autonomes multi-étapes. Pour les architectes système, les ingénieurs de fiabilité et les développeurs back-end, la diminution de la friction financière expose toutefois des défis de scalabilité en aval, déplaçant l'attention de l'ingénierie des budgets de jetons vers les limites de débit, les restrictions de concurrence, les pipelines de télémétrie et les goulots d'étranglement de la régulation.
Le problème opérationnel et les goulets d'étranglement financiers
Au cours des premières phases d'adoption des LLM en entreprise, les frais nominaux par jeton ont servi de régulateur architectural informel. Les coûts d'inférence élevés ont contraint les équipes de développement à traiter les invocations de modèles comme des transactions distinctes initiées par l'utilisateur. Les applications reposaient largement sur des approbations humaines, un historique conversationnel borné et des tâches planifiées strictement limitées pour garantir la prévisibilité des factures mensuelles des fournisseurs. L'introduction de réductions permanentes sur les modèles de milieu de gamme remet en question ces compromis historiques, déplaçant les préoccupations d'ingénierie des systèmes vers la résilience de l'infrastructure back-end.
En un coup d'œil
- Réduction de prix de base : Le 22 septembre 2026, OpenAI a introduit GPT-6 Sol à 2,00 $ en entrée / 10,00 $ en sortie et GPT-6 Luna à 0,10 $ en entrée / 0,50 $ en sortie par million de jetons pour le traitement standard sur des requêtes allant jusqu'à 272K jetons, ce qui représente une réduction nominale de 50 % ou plus par rapport aux tarifs d'API promotionnels du GPT-5.6.
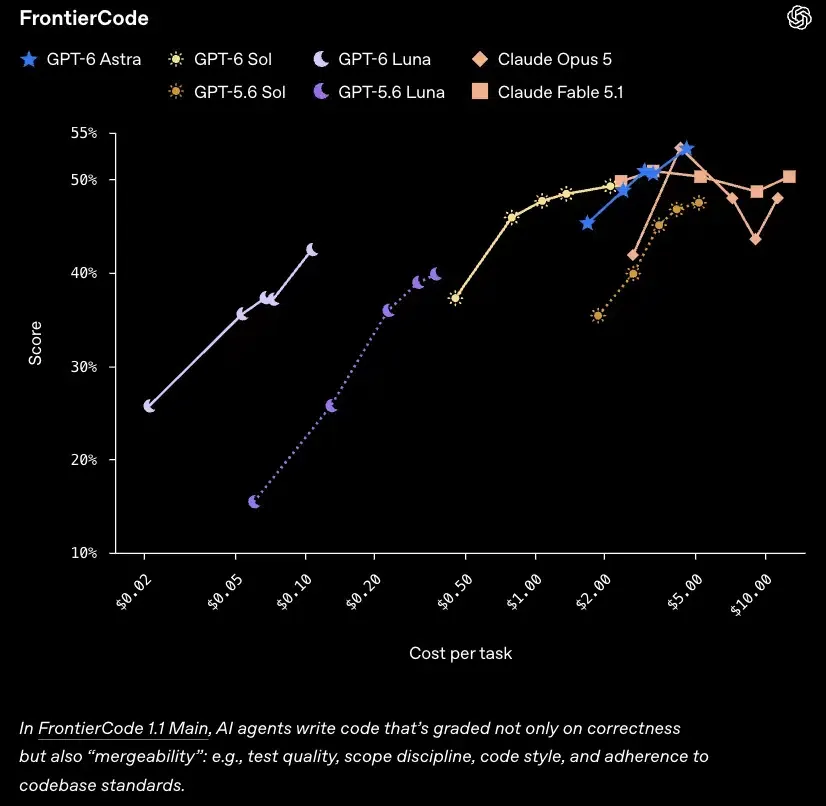
- Économie des benchmarks au niveau des tâches : Sur AutomationBench 1.0.6, OpenAI indique que GPT-6 Sol configuré avec un effort de raisonnement très élevé (xhigh) a atteint un score de flux de travail de 33,2 % pour un coût moyen déclaré de 0,27 $ par tâche tentée, faisant basculer l'évaluation des développeurs du prix brut des jetons vers le coût par unité de travail tentée.
- Dynamique du cache de requêtes : La plateforme offre une réduction automatisée de 90 % sur les lectures de jetons d'entrée mis en cache (facturées à 0,1× le tarif de base du jeton d'entrée), tandis que les écritures initiales dans le cache sont facturées à 1,25× le tarif du jeton d'entrée non mis en cache, ce qui nécessite une normalisation minutieuse des préfixes pour maintenir des taux de réussite de cache élevés lors d'exécutions dynamiques en plusieurs étapes.
Comme détaillé dans la Référence des prix de l'API développeur OpenAI et l'Annonce de la communauté OpenAI, ces structures de prix découlent d'améliorations continues des pipelines d'inférence de bas niveau et des systèmes de mise en cache KV. Cependant, lorsque le coût d'exécution de séquences de tâches automatisées diminue de manière significative, les équipes d'ingénierie élargissent la portée de leurs tâches en arrière-plan. Le seuil économique qui décourageait auparavant les travailleurs en arrière-plan d'exécuter des scrutations continues (polling), des passes automatisées de révision de code ou des pipelines d'extraction de documents en plusieurs étapes a été abaissé.
Sur le marché, plusieurs fournisseurs de modèles de fondation ont abaissé ou restructuré leurs prix d'API sur l'ensemble des paliers de développement. Anthropic a publié Claude Opus 5.5 parallèlement à des spécifications mises à jour sur la Spécification de la plateforme Anthropic Claude Opus 5.5, affichant 4 $ par million de jetons d'entrée, 0,20 $ par million de lectures d'entrées en cache et 20 $ par million de jetons de sortie, soulignant une réduction de la consommation de jetons sur les benchmarks de refactorisation de code. Parallèlement, Google maintient ses prix d'introduction promotionnels pour Gemini 3.8 Flash documentés sur Google AI for Developers, et les versions à poids ouverts telles que MiMo-V2.6-Pro de Xiaomi offrent aux équipes d'auto-hébergement des options agressives en matière de coût des jetons sous des licences logicielles permissives.
Lorsque les coûts des modèles baissent, les comportements de développement changent. Les équipes d'ingénierie déploient des boucles récursives plus profondes, intègrent une documentation d'entreprise complète dans les requêtes système et configurent une logique de nouvelle tentative automatisée sur des graphes de tâches complexes. Ce qui commence comme un allègement des coûts au niveau de l'API peut déplacer la latence et les pics de trafic vers les services internes. Si un travailleur d'orchestration émet des dizaines d'appels de modèles séquentiels ou parallèles pour une seule transaction utilisateur, les pools de bases de données internes, les clusters de stockage auxiliaires, les pipelines de télémétrie et les limiteurs de débit doivent absorber la charge résultante.
Causes profondes systémiques et chaînes de requêtes non visuelles
Lorsque les applications clientes passent d'interfaces de chat interactives à une automatisation en arrière-plan non visuelle, les profils de requêtes en amont changent radicalement. Un seul événement commercial peut déclencher un pipeline autonome qui inspecte des schémas, évalue des variables d'environnement, appelle des outils externes et vérifie les résultats au cours de plusieurs passes continues.
+-----------------------------------------------------------------------------------------+
|                  EXÉCUTION D'AGENT RÉCURSIF ET GOULOT D'ÉTRANGLEMENT DE RÉGULATION         |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ Déclencheur Web / App de l'utilisateur ]                                               |
|         |                                                                               |
|         v                                                                               |
|  [ Passerelle API d'ingestion ]                                                          |
|         |                                                                               |
|         +---> Crée une instance de travailleur autonome                                 |
|         |                                                                               |
|         v                                                                               |
|  [ Boucle d'orchestration autonome (GPT-6 Sol / Luna) ]                                   |
|         |                                                                               |
|         +--- Étape 1 : Interrogation du contexte (Lecture du cache) ---+                |
|         |                                                            |                  |
|         +--- Étape 2 : Exécution d'outil (Appel non mis en cache)    |                  |
|         |                                                            |                  |
|         +--- Étape 3 : Validation d'auto-correction                  |                  |
|         |                                                            v                  |
|         +--- Étape 4 : Bifurcation de l'exécution récursive -> [ Appels RPC internes en rafale ] |
|                                                                      |                  |
|  [ Goulots d'étranglement du système en aval ]                       |                  |
|         |                                                            |                  |
|         +--- Microservices internes <-- (Famine de connexions) ------+                  |
|         +--- PostgreSQL / Magasins de cache <-- (Saturation du pool de connexions)      |
|         +--- Flux de télémétrie distribué <-- (Tampon de rejet avec perte appliqué)     |
|         +--- Magasin de conformité d'audit <-- (Retard de file d'attente durable / rejouable) |
|         +--- Seuils du fournisseur en amont <-- (Épuisement de la limite de débit HTTP 429) |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
Exécution d'agents récursifs et multiplication de la concurrence
Dans les systèmes web interactifs traditionnels, le volume des requêtes reflète les rythmes d'interaction humaine. Chaque thread HTTP correspond généralement à une interaction utilisateur explicite, avec une diffusion (fan-out) globale plus faible et un rythme limité par le temps de réflexion humain. Le runtime client envoie une charge utile, attend une réponse et fait une pause avant d'initier les interactions suivantes.
Comparaison conceptuelle des profils de requêtes : interactif vs. agentique
| Métrique architecturale | Flux utilisateur interactif | Boucle d'agent autonome |
|---|---|---|
| Modèle de concurrence | La diffusion des requêtes rythmée par l'humain est généralement plus faible | 1 événement d'ingestion = N appels enfants enchaînés |
| Calendrier d'exécution | Rythmé par la réponse de l'utilisateur et son temps de réflexion | Progresse automatiquement jusqu'à l'intervention des limites de politique |
| Invalidation du contexte | Charges utiles fraîches par session | Repose fortement sur le contexte mis en cache |
| Gestion des erreurs | Nouvelle tentative de l'utilisateur en cas d'erreur | Nouvelles tentatives programmatiques automatisées |
| Goulots d'étranglement du système | Bande passante de la passerelle front-end | Limites du pool de bases de données internes |
| Cascades de pannes | Isolé à une seule session | Peut déclencher la saturation de la file d'attente |
Lorsque les systèmes intègrent des agents autonomes, ce rythme se dissocie. Un seul événement déclenché peut générer une séquence ininterrompue d'appels automatisés. Si un agent rencontre une erreur transitoire ou une sortie d'outil malformée, une logique de nouvelle tentative naïve peut générer des rafales rapides de requêtes sur les services back-end. Étant donné que la réduction des coûts en jetons rend les exécutions plus longues abordables, les flux de travail automatisés peuvent augmenter considérablement le volume des requêtes en arrière-plan, même avec une base d'utilisateurs actifs stable.
Mécanismes du cache de requêtes : réutilisation KV, frais généraux d'écriture et stabilité des préfixes
OpenAI a associé les sorties de Sol et Luna à des optimisations de son sous-système de mise en cache des requêtes. Comme le documente la Spécification de mise en cache des requêtes OpenAI, les jetons d'entrée correspondant à un préfixe mis en cache bénéficient d'une réduction de 90 % sur le prix de lecture. La mise en cache des requêtes réduit principalement le recalcul du côté du modèle plutôt que de fonctionner comme un mécanisme de compression de charge utile réseau à usage général. Dans les interactions sans état standard, l'application cliente transmet le contexte de la requête et le fournisseur ignore le recalcul des tenseurs KV pour le préfixe correspondant, réduisant considérablement la latence du temps jusqu'au premier jeton et la facturation des entrées.
De manière cruciale, l'écriture d'un préfixe initial dans le cache côté serveur est facturée à 1,25× le tarif des jetons d'entrée non mis en cache. Maximiser l'efficacité des coûts nécessite de maintenir la stabilité des préfixes sur plusieurs requêtes.
Prix de liste publics d'API sélectionnés — Non directement comparables entre les fournisseurs
| Identifiant du modèle | Entrée ($/1M Tok) | Sortie ($/1M Tok) | Politique de lecture du cache |
|---|---|---|---|
| OpenAI GPT-6 Luna (Std) | 0,10 $ | 0,50 $ | Remise de 90 % (0,10×) |
| OpenAI GPT-6 Sol (Std) | 2,00 $ | 10,00 $ | Remise de 90 % (0,10×) |
| OpenAI GPT-6 Astra (Std) | 10,00 $ | 50,00 $ | Tarification dynamique par paliers |
| Anthropic Opus 5.5 | 4,00 $ | 20,00 $ | 0,20 $/1M de lecture (0,05×) |
| Anthropic Sonnet 5 | 2,00 $ | 10,00 $ | Jusqu'à 90 % sur le cache |
| Google Gemini 3.8 Flash | 0,75 $ (Intro) | 3,75 $ (Intro) | 0,075 $/1M de lecture en cache |
| Xiaomi MiMo-V2.6-Pro | 0,435 $ | 0,87 $ | 0,0036 $/1M de lecture en cache |
Remarque : Les tarifs standard s'appliquent aux paliers à contexte court (requêtes jusqu'à 272K jetons d'entrée pour OpenAI). Les fournisseurs appliquent des frais généraux d'écriture de cache, des limites de contexte et des conditions promotionnelles limitées dans le temps variables.
La préservation des préfixes nécessite une gestion minutieuse des options de configuration de l'API. Dans l'architecture d'API d'OpenAI, la modification directe des paramètres d'effort de raisonnement ou l'altération des tableaux de définition d'outils modifiera le préfixe de la requête rendue et invalidera les états mis en cache précédemment.
Pour préserver le contexte mis en cache lors de sessions à plusieurs tours, les développeurs doivent maintenir les schémas d'outils et les instructions de base dans un ordre cohérent. Si des ajustements d'exécution sont nécessaires, les développeurs doivent mettre à jour les paramètres via des contrôles de session structurés (tels que configuration_update) ou basculer l'exécution des outils à l'aide de tool_choice ou allowed_tools plutôt que de modifier directement le tableau des définitions d'outils.
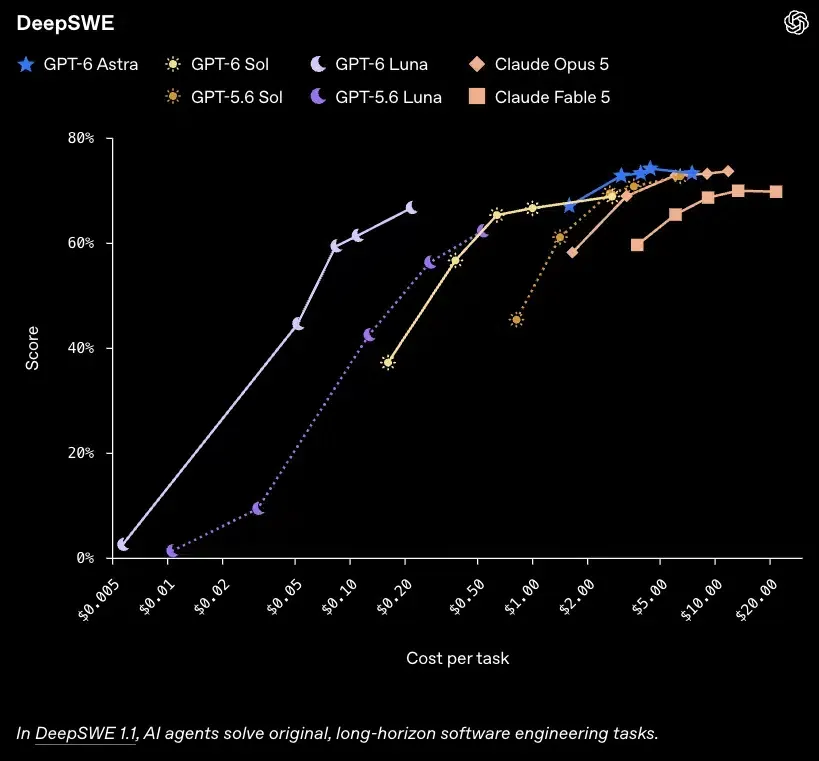
En cas de non-correspondance du cache (cache miss), le fournisseur en amont retrousse le traitement de la séquence d'entrée sans la réduction de lecture de 90 %. À grande échelle, cela peut augmenter la latence d'inférence et la pression sur les délais d'attente (timeouts). Pour l'exécution de tâches en plusieurs étapes, l'évaluation des coûts passe de simples multiplicateurs de jetons aux dépenses par tâche achevée, comme le montre le Rapport de VentureBeat sur les benchmarks de GPT-6 Sol et Luna, où GPT-6 Sol a atteint un score de 33,2 % sur AutomationBench 1.0.6 pour une moyenne de 0,27 $ par tâche tentée.
Architecture de télémétrie : dissocier les métriques opérationnelles des audits de conformité
Une augmentation des requêtes LLM automatisées exerce une pression significative sur l'observabilité du back-end et les pipelines de conformité. Les flux de travail d'agents à haute concurrence nécessitent une séparation architecturale claire entre la télémétrie opérationnelle et les pistes d'audit juridiques.
Les politiques de conformité des entreprises exigent souvent l'enregistrement des métadonnées de session, des preuves d'exécution d'outils et des enregistrements de transactions. Traiter la télémétrie opérationnelle et les données de conformité de manière identique crée de sérieux compromis en matière d'ingénierie :
- Canaux d'audit de conformité et de sécurité : Doivent fournir une livraison durable et rejouable avec une logique explicite de nouvelle tentative, de persistance et de gestion des erreurs dans des magasins d'audit en écriture unique et à accès contrôlé. Les charges utiles doivent capturer les métadonnées structurées, l'identité de l'appelant et l'état cryptographique tout en aseptisant systématiquement les informations personnelles identifiables (PII) et les clés secrètes. Sous forte charge, ces pipelines doivent appliquer une régulation (backpressure) ou mettre en file d'attente les tâches de manière durable plutôt que de rejeter les enregistrements.
- Canaux de télémétrie opérationnelle : Suivent les métriques de performance telles que les comptes de jetons, les ratios de réussite du cache de requêtes et les latences de réponse en amont. Étant donné que ces traces sont utilisées pour la surveillance en temps réel et le débogage, elles peuvent être traitées par des tampons de rejet limités avec perte. Si les collecteurs en aval ralentissent, l'application peut éliminer en toute sécurité l'excès de télémétrie opérationnelle pour préserver la disponibilité du service de base.
Lorsque les fournisseurs externes renvoient des erreurs de limitation de débit HTTP 429, des politiques de nouvelle tentative mal configurées peuvent provoquer de graves problèmes opérationnels. Des nouvelles tentatives immédiates ou des routines de recul exponentiel (backspace) synchronisées sans gigue aléatoire (jitter) créent des vagues de nouvelles tentatives qui peuvent se propager à travers les microservices intermédiaires, consommant des pools de threads et des connexions de bases de données.
Comparaison des solutions : compromis entre fabrication interne et achat
La gestion de la charge opérationnelle résultant de la baisse des coûts d'inférence oblige les organisations à évaluer leur passerelle IA et leurs architectures de proxy. Les équipes doivent décider s'il convient de développer en interne des proxys personnalisés de routage, de limitation de débit et de télémétrie, ou de déployer une infrastructure tierce spécialisée.
+-----------------------------------------------------------------------------------------+
|                  PIPELINE DE RÉSILIENCE SYSTÈME AVEC TÉLÉMÉTRIE DISSOCIÉE                 |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ Requêtes d'application entrantes ]                                                   |
|         |                                                                               |
|         v                                                                               |
|  [ Limiteur de débit à fenêtre glissante ] <--- Cache local en mémoire ou distribué       |
|         |                                                                               |
|         +---> Rejette / Retarde la concurrence excessive (Protection HTTP 429)          |
|         |                                                                               |
|         v                                                                               |
|  [ Moteur de normalisation des requêtes et d'alignement du cache ]                        |
|         |                                                                               |
|         +---> Épingle les requêtes système statiques et définitions d'outils au préfixe de base |
|         +---> Utilise des contrôles structurés pour modifier les paramètres de session  |
|         |                                                                               |
|         v                                                                               |
|  [ Répartition du fournisseur en amont (OpenAI / Anthropic / API locale) ]              |
|         |                                                                               |
|         +---------------------------------------+---------------------------------------+
|         |                                       |                                       |
|         v (Chemin rapide synchrone)             |                                       |
|  [ Assemblage de la réponse client ]            |                                       |
|         |                                       v (Chemin double asynchrone)            |
|         v                               +-----------------------------------------------+
|  [ Renvoyer la charge utile à l'application ]   |                                               |
|                                         v (Tampon circulaire avec perte) v (Boîte d'envoi durable) |
|                                    [ Métriques opérationnelles ] [ Magasin d'audit de conformité ] |
|                                    (Suppression en cas de congestion) (Durable / Rejouable)    |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
Pipelines de résilience personnalisés internes
Le développement d'une infrastructure personnalisée donne aux équipes d'ingénierie un contrôle total sur les politiques de réseau, l'aseptisation des données et les stratégies de routage. Les organisations peuvent créer des proxys de périphérie (edge proxies) adaptés à leurs topologies de microservices internes exactes.
// Implémentation de référence : Seau de jetons synchronisé avec reste fractionnaire et saturation bornée
package com.example.ai.resilience;

import java.math.BigInteger;
import java.time.Duration;

public final class TokenBucketLimiter {
    private final long maxTokenCapacity;
    private final long refillPeriodNanos;
    private long availableTokens;
    private long lastRefillNanos;
    // Numérateur du reste mis à l'échelle dans la plage [0, refillPeriodNanos)
    private long scaledRemainder;

    public TokenBucketLimiter(long maxTokens, Duration refillPeriod) {
        if (maxTokens <= 0 || refillPeriod.isZero() || refillPeriod.isNegative()) {
            throw new IllegalArgumentException("Configuration de limite invalide pour TokenBucketLimiter.");
        }
        this.maxTokenCapacity = maxTokens;
        this.refillPeriodNanos = refillPeriod.toNanos();
        this.availableTokens = maxTokens;
        this.lastRefillNanos = System.nanoTime();
        this.scaledRemainder = 0L;
    }

    public synchronized boolean tryAcquire(long requestedUnits) {
        if (requestedUnits <= 0) {
            return false;
        }
        refillTokens();
        if (requestedUnits > availableTokens) {
            return false;
        }
        availableTokens -= requestedUnits;
        return true;
    }

    private void refillTokens() {
        long nowNanos = System.nanoTime();
        long elapsedNanos = nowNanos - lastRefillNanos;

        if (elapsedNanos <= 0) {
            return;
        }

        // Avancer l'horodatage de référence de manière monotone
        this.lastRefillNanos = nowNanos;

        // Si le seau est déjà plein, rejeter les crédits fractionnaires non consommés pour éviter la dérive temporelle
        if (this.availableTokens >= this.maxTokenCapacity) {
            this.scaledRemainder = 0L;
            return;
        }

        long wholePeriods = elapsedNanos / refillPeriodNanos;
        long remElapsedNanos = elapsedNanos % refillPeriodNanos;

        // Chemin rapide : si au moins une période complète s'est écoulée, le seau se recharge complètement à pleine capacité.
        // Cela élimine la surface de dépassement de multiplication (wholePeriods * maxTokenCapacity).
        if (wholePeriods > 0) {
            this.availableTokens = maxTokenCapacity;
            this.scaledRemainder = 0L;
            return;
        }

        // Sous des micro-intervalles de sous-période, calculer les jetons fractionnaires exacts à l'aide de l'arithmétique BigInteger
        BigInteger bigRemNanos = BigInteger.valueOf(remElapsedNanos);
        BigInteger bigCapacity = BigInteger.valueOf(maxTokenCapacity);
        BigInteger bigRemainder = BigInteger.valueOf(scaledRemainder);
        BigInteger bigPeriod = BigInteger.valueOf(refillPeriodNanos);

        // totalWork = (remElapsedNanos * maxTokenCapacity) + scaledRemainder
        BigInteger totalWork = bigRemNanos.multiply(bigCapacity).add(bigRemainder);
        BigInteger[] divAndRem = totalWork.divideAndRemainder(bigPeriod);

        long tokensGenerated = divAndRem[0].longValue();
        this.scaledRemainder = divAndRem[1].longValue();

        if (tokensGenerated > 0) {
            long spaceLeft = maxTokenCapacity - availableTokens;
            if (tokensGenerated >= spaceLeft) {
                this.availableTokens = maxTokenCapacity;
                this.scaledRemainder = 0L;
            } else {
                this.availableTokens += tokensGenerated;
            }
        }
    }
}
Cependant, le développement interne nécessite une maintenance d'ingénierie continue. Les équipes doivent s'adapter manuellement aux mises à jour de l'API des fournisseurs, gérer l'évolution des limites de débit auprès de plusieurs vendeurs et administrer les files d'attente de télémétrie distribuées. Cette surcharge de maintenance peut détourner les ressources des développeurs internes des fonctionnalités principales du produit.
Passerelles commerciales et outils d'infrastructure
Pour éviter d'avoir à développer ces capacités à partir de zéro, de nombreuses entreprises optent pour des proxys d'API gérés, des passerelles LLM et des plans de contrôle de périphérie. Certaines passerelles gérées fournissent une coordination des limites de débit consciente des fournisseurs, de l'observabilité, des contrôles de politique et un routage conscient du cache ; les capacités exactes varient selon le fournisseur, et l'optimisation des préfixes nécessite souvent encore une discipline de requête au niveau de l'application.
Les plateformes commerciales permettent aux équipes d'ingénierie d'appliquer des quotas de coûts par environnement, de configurer un routage de repli (fallback) automatisé entre les familles de modèles et de supprimer les informations sensibles des clients avant d'enregistrer les métadonnées des requêtes. Des passerelles conçues spécifiquement gèrent les pics de concurrence, auditent les tendances de consommation des API et protègent les microservices en aval dans des environnements d'application complexes.
Matrice de décision : Pipeline interne vs. Plateformes gérées
| Critères d'évaluation | Outils de résilience internes | Infrastructure de routage gérée |
|---|---|---|
| Effort de développement initial | Élevé (3 à 6 semaines d'ingénierie) | Faible (S'intègre via l'API standard) |
| Maintenance du protocole | Responsabilité continue de l'équipe | Géré par les mises à jour du fournisseur |
| Contrôle opérationnel | Visibilité complète de la pile | Limité par l'interface du fournisseur |
| Réglage du cache de requêtes | Nécessite des proxys personnalisés | Dépendant du fournisseur ; nécessite généralement la coopération de l'application |
| Isolation de la télémétrie | Gestion de file d'attente personnalisée | Dépendant du fournisseur |
| Profil de coût financier | Frais généraux de paie d'ingénierie | SaaS récurrent / frais d'utilisation |
Listes de contrôle d'intégration et calendriers de gouvernance
Les organisations qui augmentent l'utilisation de leurs modèles suite aux baisses de prix de GPT-6 Sol et Luna peuvent utiliser ce cadre opérationnel pour éviter les surcharges systémiques :
+-----------------------------------------------------------------------------------------+
|          LISTE DE CONTRÔLE DE L'INFRASTRUCTURE LLM D'ENTREPRISE                         |
+-----------------------------------------------------------------------------------------+
| [ ] Auditer les applications clientes pour identifier les boucles d'appels de modèles récursifs non bornées |
| [ ] Définir des limites de délai strictes et des reculs de nouvelles tentatives non linéaires avec gigue aléatoire |
| [ ] Implémenter des limiteurs de débit à seau de jetons locaux et en périphérie avant les appels en amont |
| [ ] Organiser les structures de requêtes pour maximiser la réutilisation des préfixes de mise en cache des requêtes |
| [ ] Séparer la télémétrie opérationnelle avec perte des pistes d'audit durables et rejouables |
| [ ] Ajouter un échantillonnage d'exécution pour supprimer les corps de requêtes bruts des traces à haute fréquence |
| [ ] Surveiller les tendances des codes d'état HTTP 429 et définir des déclencheurs de régulation automatisés |
| [ ] Configurer des alertes de coûts et des disjoncteurs pour intercepter les tâches automatisées hors de contrôle |
+-----------------------------------------------------------------------------------------+
Configuration du pipeline de télémétrie
Les systèmes d'observabilité doivent dissocier l'enregistrement des requêtes (logging) des chemins de requêtes en temps réel. Lors du traitement de charges de travail d'agents à haute fréquence, les applications doivent écrire les métadonnées de télémétrie dans des files d'attente asynchrones limitées en mémoire, évitant ainsi les blocages d'E/S si les collecteurs de télémétrie en aval ralentissent.
// Implémentation de référence : Journaliseur de télémétrie limité en mémoire avec délestage de charge avec perte
package com.example.ai.resilience;

import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.BlockingQueue;
import java.util.concurrent.atomic.AtomicLong;

public final class BoundedTelemetryQueue {
    public static final class LogPayload {
        public final String traceId;
        public final String modelId;
        public final long promptTokens;
        public final long completionTokens;
        public final boolean cacheHit;

        public LogPayload(String traceId, String modelId, long pTokens, long cTokens, boolean hit) {
            this.traceId = traceId;
            this.modelId = modelId;
            this.promptTokens = pTokens;
            this.completionTokens = cTokens;
            this.cacheHit = hit;
        }
    }

    private final BlockingQueue<LogPayload> internalQueue;
    private final AtomicLong droppedEvents = new AtomicLong(0);

    public BoundedTelemetryQueue(int maxQueueCapacity) {
        if (maxQueueCapacity <= 0) {
            throw new IllegalArgumentException("La capacité de la file d'attente doit être positive.");
        }
        this.internalQueue = new ArrayBlockingQueue<>(maxQueueCapacity);
    }

    public boolean recordEvent(LogPayload payload) {
        if (payload == null) {
            return false;
        }
        // Soumission non bloquante : supprime la télémétrie sous charge pour préserver la stabilité de l'application
        boolean accepted = internalQueue.offer(payload);
        if (!accepted) {
            droppedEvents.incrementAndGet();
        }
        return accepted;
    }

    public LogPayload pollEvent() {
        return internalQueue.poll();
    }

    public long getDroppedEventCount() {
        return droppedEvents.get();
    }
}
Foire aux questions (FAQ)
Quels sont les tarifs officiels de l'API pour GPT-6 Sol et Luna ?
Comment la mise en cache des requêtes réduit-elle les coûts sur les longues conversations ?
Pourquoi des jetons moins chers augmentent-ils le risque opérationnel du back-end ?
Points clés pour les équipes d'ingénierie
Le lancement de GPT-6 Sol et Luna accélère une tendance plus large : l'intelligence frontalière devient moins chère et plus accessible. À mesure que les coûts unitaires des jetons chutent fortement, les contraintes financières cessent d'être un mécanisme de contrôle efficace pour les architectures logicielles.
Alors que les organisations adoptent des agents à haute fréquence et des topologies de modèles à plusieurs niveaux, l'ingénierie opérationnelle devient critique pour le succès de l'entreprise. Les équipes doivent aller au-delà de l'évaluation des modèles uniquement par les prix nominaux des jetons ou les scores de benchmark. La fiabilité à long terme dépendra de la manière dont les systèmes gèrent efficacement la concurrence, alignent les contextes de requêtes pour la réutilisation du cache, gèrent les limites de débit en amont avec élégance et dissocient la télémétrie des chemins d'application critiques. Les organisations qui bâtiront une infrastructure résiliente réussiront à mettre à l'échelle leurs flux de travail d'agents automatisés sans sacrifier la disponibilité des applications ni la stabilité du système.
Sources primaires et documentation de référence
-
Référence des prix de l'API développeur OpenAI : Tableaux de tarifs officiels pour les développeurs, contraintes de la fenêtre de contexte (seuil standard ≤272K) et calendriers de tarification des lectures/écritures en cache pour GPT-6 Sol, Luna et Astra.
-
Annonce de la communauté OpenAI : Divulgation publique confirmant la réduction de prix de base de 50 % par rapport aux paliers promotionnels du GPT-5.6 et détails du déploiement par étapes.
-
Spécification de mise en cache des requêtes OpenAI : Documentation architecturale sur la réutilisation des préfixes de clés-valeurs (KV) côté serveur, les frais généraux d'écriture du cache et les règles d'invalidation de configuration.
-
Spécification de la plateforme Anthropic Claude Opus 5.5 : Spécification de sortie officielle confirmant les tarifs des jetons à 4 $ en entrée / 20 $ en sortie / 0,20 $ pour la lecture du cache, ainsi que les performances de benchmark.
-
Aperçu d'Anthropic Claude Sonnet 5 : Grille tarifaire officielle pour les développeurs et métriques d'efficacité de la mise en cache des requêtes (2 $ en entrée / 10 $ en sortie / jusqu'à 90 % de réduction sur le cache).
-
Grille tarifaire Google AI for Developers : Aperçu des grilles tarifaires pour les développeurs et des politiques de prix d'introduction pour Gemini 3.8 Flash.
-
Tarification officielle de l'API et calendrier des tarifs de Xiaomi MiMo : Tarifs canoniques des jetons à l'usage (pay-as-you-go) à l'étranger pour l'inférence de MiMo-V2.6-Pro (0,435 $ en entrée / 0,87 $ en sortie / 0,0036 $ en cas de succès du cache).
-
Rapport de VentureBeat sur les benchmarks de GPT-6 Sol et Luna : Couverture de l'économie de lancement, des garanties de prix permanentes et des chiffres de coût par tâche d'AutomationBench 1.0.6 (0,27 $ par tâche tentée).
Share this article



