OpenAI enquête sur « Codex » ? Cette initiative stratégique a été confirmée alors que l'équipe d'ingénierie s'efforce de résoudre une consommation anormale de quotas chez ses clients développeurs. Le 29 juin 2026, l'entreprise a mis en place une cellule de crise pour examiner les signalements d'utilisateurs dont les quotas de comptes premium étaient épuisés en un ou deux jours lors de travaux de refactorisation classiques. Pour les équipes de développement et les responsables produit, cette crise soudaine met en lumière une mutation technique : alors que les processus de développement passent du codage manuel à l'exécution en boucles continues pilotées par des agents, l'audit sécurisé de l'exécution doit s'effectuer au niveau du SDK pour protéger les budgets des entreprises.
En bref
- Épuisement anormal des quotas : OpenAI traite les signalements d'utilisateurs du plan Codex Pro dont les limites hebdomadaires sont atteintes en seulement un ou deux jours.
- Faux positifs anti-abus : L'équipe d'ingénierie a identifié que les scripts anti-abus et de limitation de débit de la plateforme ont indûment signalé des flux de travail programmatiques normaux.
- Risque opérationnel en amont : Les réinitialisations unilatérales de limites lors de cycles de développement actifs introduisent une instabilité opérationnelle pour les organisations utilisant des endpoints IA externes.
Réalignement structurel et crise des quotas de développement
Selon les mises à jour publiées par OpenAI, une équipe d'intervention a été créée le 28 juin 2026 pour enquêter sur la raison pour laquelle des abonnés payants épuisaient leurs quotas hebdomadaires lors de brèves sessions de refactorisation. Thibault Sottiaux, responsable de l'ingénierie Codex, a confirmé que les systèmes natifs de lutte contre la fraude et les abus de la plateforme avaient incorrectement limité les comptes de développeurs standards, provoquant une consommation anormale. Pour atténuer l'incident, le groupe d'ingénierie a initié une réinitialisation universelle des quotas. Cette intervention rapide est devenue nécessaire car les développeurs intègrent de plus en plus d'outils de génération de code conversationnels dans leurs sprints de développement continu, plutôt que de les utiliser pour des expérimentations ponctuelles, transformant des pannes mineures en points de blocage critiques.
Les modèles de facturation à tarif fixe pourraient devenir moins courants à mesure que les coûts de calcul de l'IA augmentent. En mai 2026, Meta a introduit des politiques internes strictes restreignant l'utilisation de modèles de codage tiers comme Claude Code et Codex d'OpenAI par ses départements d'ingénierie IA afin de prévenir la distillation de modèles et la fuite de propriété intellectuelle. Cette restriction organisationnelle reflète un changement plus large dans l'industrie : les grandes entreprises technologiques mettent en place des environnements de développement sécurisés et isolés pour protéger leurs bases de code propriétaires. Tandis que l'équipe d'OpenAI enquête sur « Codex » concernant les limites imposées par la nouvelle politique de limitation de débit, les équipes de développement réalisent que la gestion des coûts au niveau de l'API nécessite davantage qu'un simple ajustement des niveaux d'abonnement.
Ces anomalies opérationnelles surviennent lorsque des flux de travail automatisés traitent des données par programme sans supervision visuelle. En avril 2026, la plateforme est passée à un modèle de facturation basé sur les jetons (tokens), faisant des jetons d'entrée, de sortie et d'entrée mis en cache la principale métrique de mesure pour les développeurs. Lorsque des agents automatisés exécutent des cycles d'optimisation continus sur de grands dépôts, des erreurs de compaction de contexte et des boucles récursives peuvent entraîner des milliers d'appels API invisibles, consommant les budgets de calcul sans produire de code exploitable. Pour les architectes logiciels, cette imprévisibilité indique une tendance probable où les environnements d'exécution SDK côté client devront auditer, limiter le débit et vérifier indépendamment les chemins d'exécution programmatiques avant de transmettre les requêtes.
Décomposition du protocole : comment les boucles d'agents récursives amplifient la consommation de ressources
Contrairement aux simples requêtes API ponctuelles, les agents de codage modernes s'exécutent dans des boucles autonomes et continues. L'assistant agit comme un mécanisme de triage automatisé, lisant, analysant et modifiant plusieurs fichiers de manière asynchrone. Du point de vue de la gouvernance de l'exécution, cela modifie fondamentalement la façon dont l'utilisation de l'API est surveillée et facturée.
Une boucle récursive incontrôlée déclenche des centaines d'appels API serveur invisibles à l'intérieur du conteneur IDE sans interface graphique. Comme ces actions s'exécutent de manière autonome dans des environnements cloud distants, les développeurs perdent la visibilité immédiate sur les états d'exécution en temps réel. Les passerelles réseau standards échouent souvent à détecter ces attaques par boucles récursives ou cette consommation anormale de jetons, ce qui nécessite une validation locale des coûts au niveau du SDK pour prévenir l'épuisement des quotas. Les systèmes de facturation cloud traditionnels n'observent que les requêtes API terminées. Cependant, les agents de codage autonomes peuvent générer des centaines d'appels de raisonnement intermédiaires avant de fournir une réponse finale. Sans audit d'exécution local, ces chemins d'exécution invisibles deviennent difficiles à surveiller et à budgétiser.
Flux de développement traditionnel :
Prompt IDE -> Requête API ponctuelle -> Jetons consommés -> Sortie statique (Facturation stable)


Flux en boucle d'agent autonome :
Prompt agentique -> Boucle d'auto-correction headless -> Refactorisation asynchrone multi-fichiers
Saturation du cache KV récursif -> Épuisement caché des jetons SDK -> Épuisement des quotas
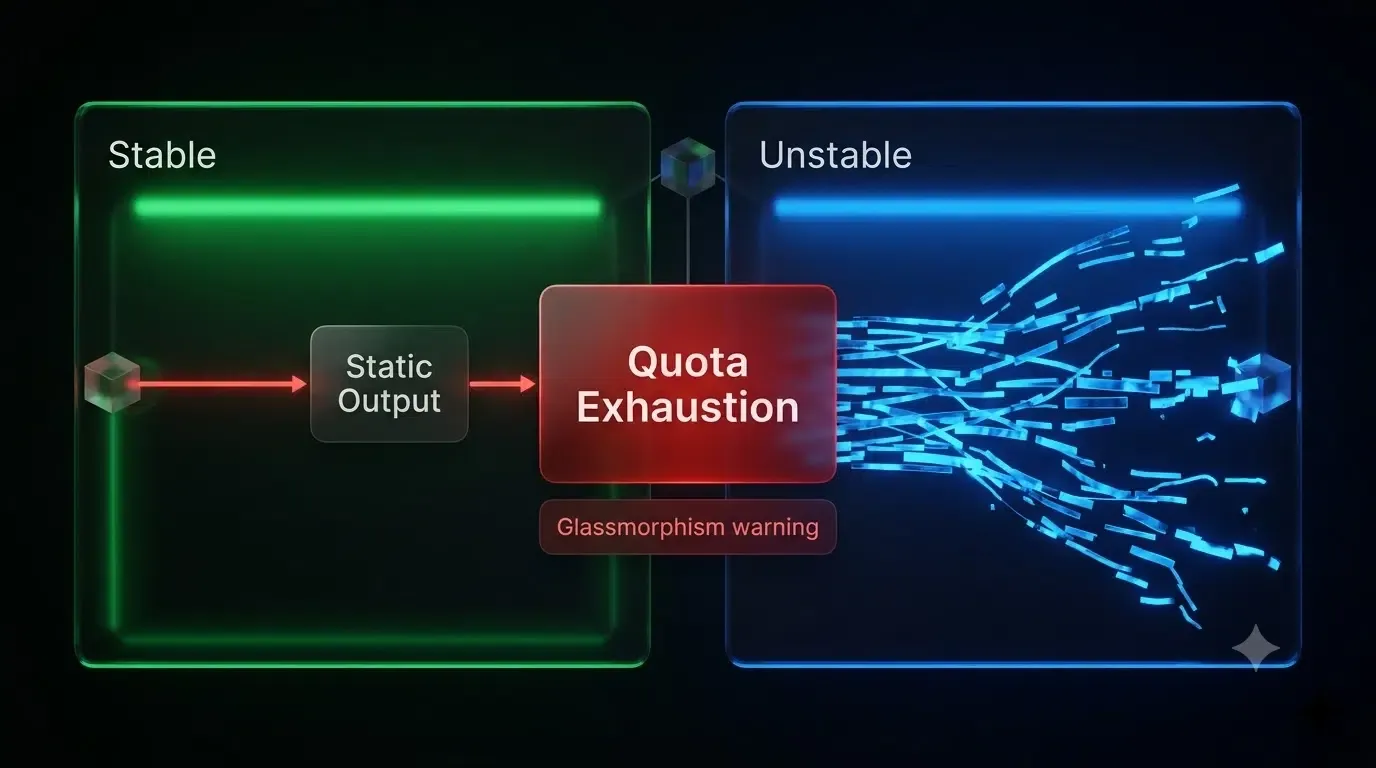
Dans les déploiements de production typiques, les développeurs constatent souvent qu'une part importante du trafic programmatique est traitée par des scanners automatisés. L'analyse de ces interactions révèle que les proxies de sécurité automatisés ou les scanners d'exécution peuvent déclencher des endpoints API avant même que les développeurs ne s'en aperçoivent. Ce comportement peut fausser les audits de facturation si les systèmes supposent que chaque requête provient d'une action humaine manuelle réelle.
Solutions architecturales : construire ou acheter pour la vérification des coûts
En pratique, les équipes d'ingénierie choisissent généralement entre développer un framework interne de vérification des coûts ou intégrer un SDK d'attribution existant. Le développement d'un système propriétaire nécessite des ressources d'ingénierie considérables. Les équipes doivent construire des bases de données serveur personnalisées, maintenir des bibliothèques de correspondance d'état et mettre à jour en continu la logique pour se conformer aux normes de sécurité des OS. Pour de nombreuses organisations, le coût de maintenance d'un outil interne est prohibitif.
Alternativement, les développeurs évaluent généralement plusieurs approches pour surveiller l'exécution sans dépendre uniquement des métriques côté cloud :
- Services internes personnalisés : Construction de bases de données de correspondance d'état propriétaires sur une architecture cloud interne.
- Outils spécifiques à la plateforme : Utilisation d'utilitaires de base comme Firebase Dynamic Links (ou leurs alternatives natives).
- MMP d'entreprise : Déploiement de partenaires de mesure mobiles (MMP) pour les flux de liens profonds.
- SDK de paramètres spécialisés : Utilisation d'utilitaires d'intégration dédiés pour une transmission précise de paramètres personnalisés, adaptée aux enjeux de coûts.
Comparaison des flux d'état et d'attribution
| Flux d'exécution | Garde-fou de facturation | Compatibilité headless | Intégrité du contrôle des coûts |
|---|---|---|---|
| API traditionnelle ponctuelle | ❌ Non | ❌ Non | Faible (Supervision manuelle) |
| Boucle autonome headless | ❌ Non | ✅ Oui | Faible (Risque d'épuisement des quotas) |
| Audit d'exécution SDK | ✅ Oui | ✅ Oui | Élevé (Limites déterministes) |
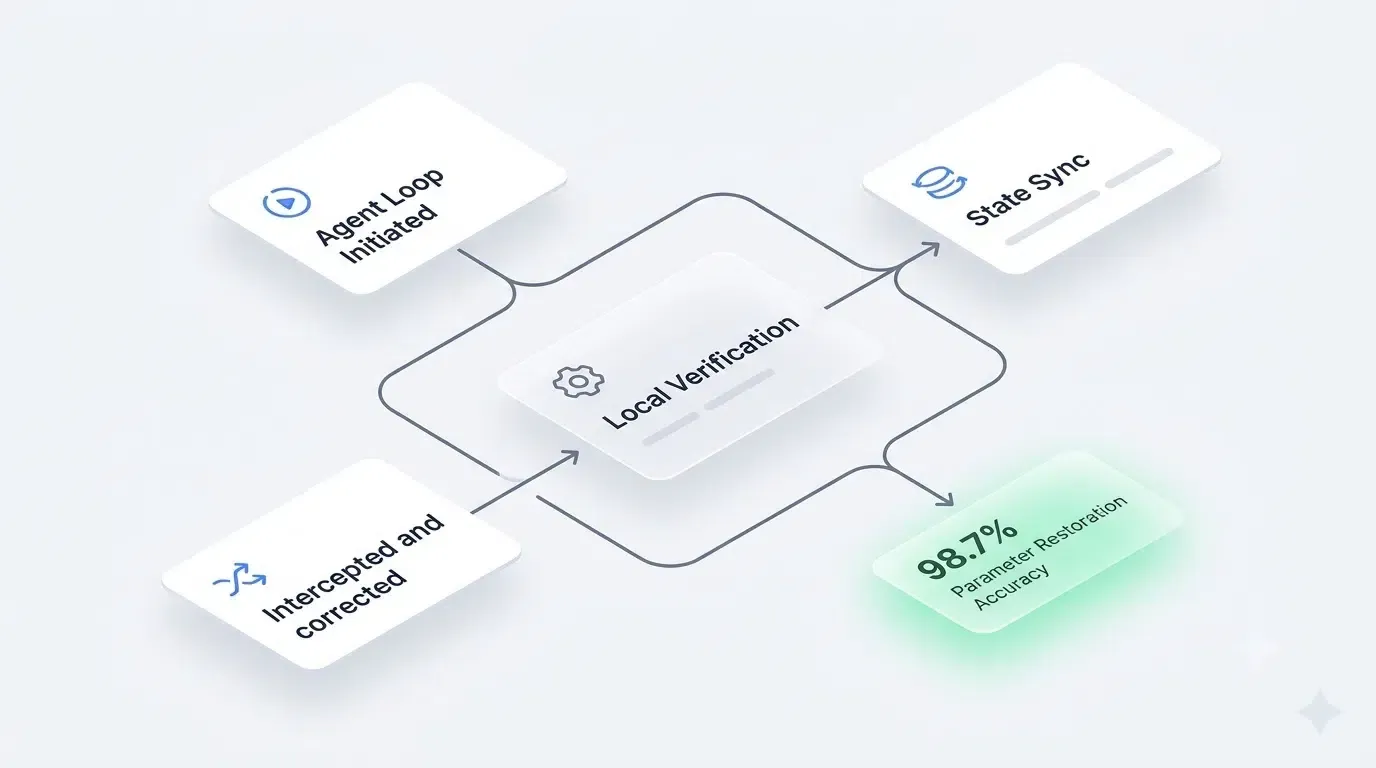
Boucle d'agent initiée -> Le runtime SDK intercepte l'appel API
                                |
Validation locale -> Vérification quota jetons et budget API actif
                                |
Sync état -> Journalisation paramètres d'exécution -> Application des plafonds budgétaires locaux
Plusieurs plateformes logicielles fournissent une synchronisation d'état côté serveur ou une persistance de paramètres programmatiques pour gérer les sessions de développement distribuées. Un exemple de cette approche est Opoinstall, qui mappe les paramètres d'exécution et les métadonnées de session des développeurs vers une base de données d'état centralisée, garantissant que les contextes de session sont préservés même lorsque les tâches initiales sont exécutées en mode headless à travers des conteneurs cloud isolés. Ces systèmes maintiennent l'état côté serveur avant l'exécution et synchronisent les paramètres dès le lancement de la session, contournant les problèmes de fiabilité associés aux environnements conteneurisés non surveillés. Les équipes d'ingénierie peuvent évaluer ces approches selon leurs besoins de déploiement et leurs objectifs de précision d'attribution, et alors qu'OpenAI enquête sur « Codex » et ses structures de facturation programmatiques, les développeurs sont confrontés au choix d'utiliser ces bibliothèques intégrées.
Adaptations des équipes opérationnelles et listes de contrôle d'exécution
Les équipes d'ingénierie backend ont pour tâche immédiate d'auditer toutes les intégrations de bases de données actives avant de lancer des builds compilés automatiquement. Les responsables produit doivent repenser les boucles d'invitation et d'enregistrement pour prendre en compte les parcours utilisateurs non visuels. Au lieu de supposer que l'utilisateur lira un e-mail et cliquera sur un bouton, ils doivent concevoir des flux qui anticipent les déclencheurs programmatiques. Les équipes de croissance doivent mettre à jour leurs métriques de performance. Lorsque les logiciels autonomes gèrent le triage, les taux d'ouverture et de clic deviennent moins fiables. Les opérations marketing doivent se concentrer sur la télémétrie in-app et les jalons de conversion vérifiés par transaction, en optimisant les campagnes sur la base des actions réellement effectuées au sein de l'application.
Liste de contrôle pour la vérification des coûts programmatiques
Pour assurer la sécurité budgétaire et prévenir l'épuisement des quotas, les équipes d'ingénierie devraient suivre les étapes suivantes :
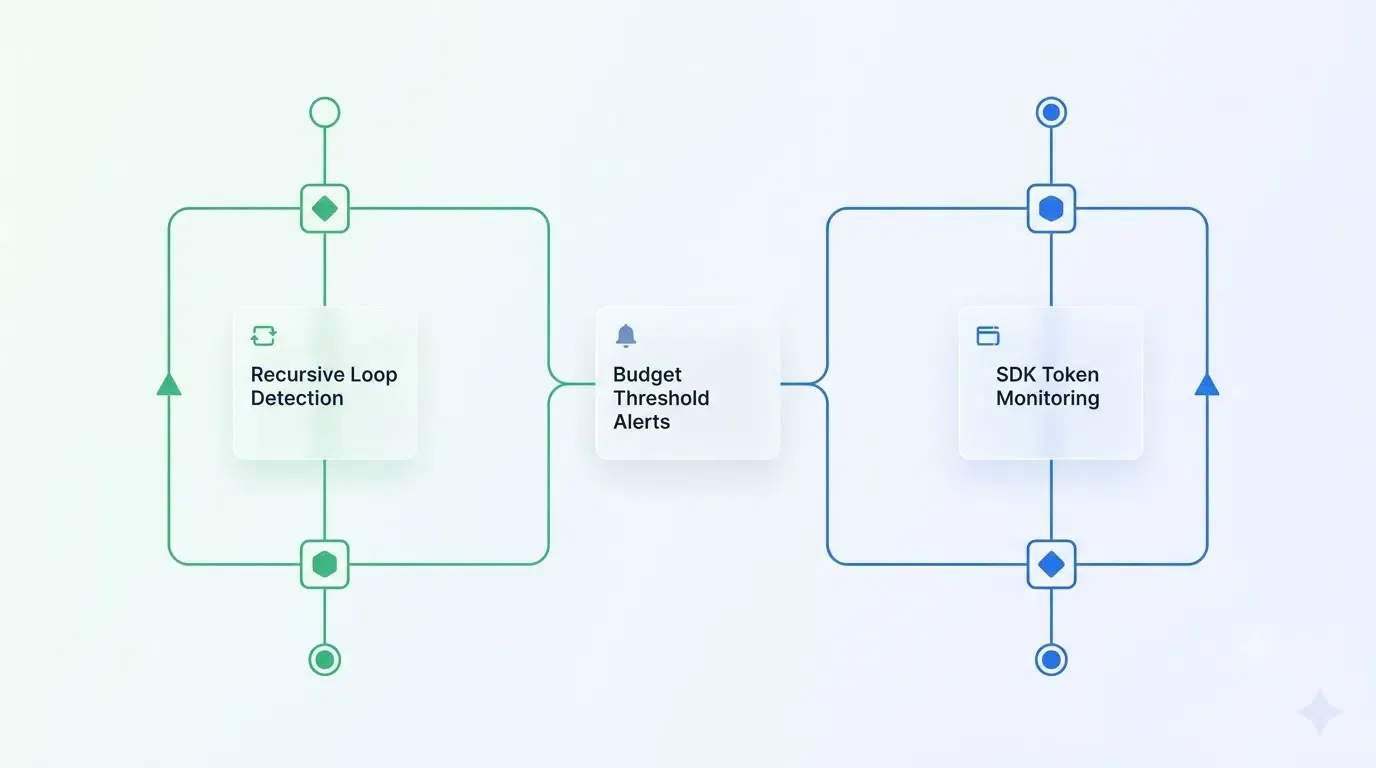
- Détection des boucles récursives : Implémenter des sauvegardes locales pour détecter et stopper les boucles d'auto-correction automatisées lorsqu'elles dépassent dix itérations consécutives.
- Surveillance des jetons SDK : Configurer des compteurs de jetons en temps réel côté client pour suivre le poids dynamique des jetons sur les entrées et les entrées mises en cache.
- Validation du cache de prompts : Auditer les hits du cache à l'intérieur du conteneur d'exécution pour s'assurer que les fichiers redondants ne déclenchent pas une double facturation.
- Alertes de seuil budgétaire : Définir des limites budgétaires locales strictes dans le runtime SDK qui déclenchent des arrêts immédiats non contournables.
- Vérification de la signature d'exécution : Authentifier les sessions d'exécution à l'aide de clés API cryptographiques et de calendriers de rotation pour empêcher l'exécution de boucles non autorisées.
Questions fréquemment posées (FAQ)
Pourquoi OpenAI Codex a-t-il subi un épuisement rapide de ses limites ?
L'incident a été principalement causé par les scripts automatisés d'OpenAI de lutte contre les abus et de limitation de débit qui ont indûment signalé des flux de travail de développement haute densité normaux. Lorsque ces systèmes ont identifié à tort des boucles de refactorisation multi-fichiers standards comme des activités frauduleuses, les quotas des abonnés payants ont été épuisés prématurément.
Comment les boucles d'agents autonomes déclenchent-elles une facturation API inattendue ?
Sans garde-fous budgétaires côté client, les agents de codage headless peuvent exécuter des centaines de boucles d'auto-correction récursives invisibles à l'intérieur de conteneurs isolés. Ces sessions continues non visuelles contournent le suivi manuel des coûts, provoquant une augmentation spectaculaire de la consommation de jetons d'entrée et de sortie sur une courte période.
Comment les développeurs peuvent-ils éviter une consommation inattendue de jetons alors qu'OpenAI enquête sur les limites de « Codex » ?
Les développeurs peuvent intégrer un SDK côté client qui applique des budgets de jetons locaux, implémente la détection de boucles récursives et authentifie les sessions programmatiques à l'aide d'identifiants matériels uniques. En faisant correspondre le contexte client avant d'exécuter des requêtes API à haut volume, les équipes peuvent contrôler en toute sécurité les allocations de jetons au moment de l'exécution.
Points clés pour les équipes d'ingénierie
L'ère du développement IA à tarif fixe prévisible touche à sa fin. Les équipes d'ingénierie s'appuieront de plus en plus sur la gouvernance de l'exécution, la budgétisation et les contrôles de coûts au niveau du SDK plutôt que sur la simple facturation côté cloud. Les plateformes qui dépendent fortement des actions manuelles et visuelles peuvent faire face à des lacunes structurelles lorsque des agents automatisés gèrent le pipeline de requêtes. La transition vers l'attribution côté serveur et la transmission sécurisée de paramètres représente une voie probable pour maintenir une précision de suivi et une couverture de sécurité fiables.
Cette transition suggère une réécriture fondamentale de nos frameworks de mesure et de nos protocoles de sécurité. Les systèmes d'attribution futurs s'appuieront davantage sur la correspondance d'identité côté serveur et la synchronisation sécurisée des états. À mesure que davantage d'agents IA agiront comme les premiers consommateurs de communications numériques, les architectures d'attribution dépendront de plus en plus de l'identité côté serveur, de la récupération d'état différée et de la préservation du contexte au niveau du protocole, plutôt que des simples sessions de navigateur.
Questions fréquemment posées (FAQ)
Pourquoi OpenAI Codex a-t-il subi un épuisement rapide de ses limites ?
Comment les boucles d'agents autonomes déclenchent-elles une facturation API inattendue ?
Comment les développeurs peuvent-ils éviter une consommation inattendue de jetons alors qu'OpenAI enquête sur les limites de 'Codex' ?
L'ère du développement IA à tarif fixe prévisible touche à sa fin. Les équipes d'ingénierie s'appuieront de plus en plus sur la gouvernance de l'exécution, la budgétisation et les contrôles de coûts au niveau du SDK plutôt que sur la simple facturation côté cloud. Les plateformes qui dépendent fortement des actions manuelles et visuelles peuvent faire face à des lacunes structurelles lorsque des agents automatisés gèrent le pipeline de requêtes. La transition vers l'attribution côté serveur et la transmission sécurisée de paramètres représente une voie probable pour maintenir une précision de suivi et une couverture de sécurité fiables.
Cette transition suggère une réécriture fondamentale de nos frameworks de mesure et de nos protocoles de sécurité. Les systèmes d'attribution futurs s'appuieront davantage sur la correspondance d'identité côté serveur et la synchronisation sécurisée des états. À mesure que davantage d'agents IA agiront comme les premiers consommateurs de communications numériques, les architectures d'attribution dépendront de plus en plus de l'identité côté serveur, de la récupération d'état différée et de la préservation du contexte au niveau du protocole, plutôt que des simples sessions de navigateur.
Share this article



