« Ornith-1.0 » se concentre sur le codage agentique ? La télémétrie initiale issue de nos clusters de test suggère que cette transition est déjà bien engagée. Le lancement par DeepReinforce, le 25 juin 2026, de sa famille de modèles auto-échafaudants introduit de nouveaux modèles de workflow au sein des environnements de développement en entreprise. Pour les équipes de développement, le défi consiste désormais à gérer les exécutions programmatiques tout en préservant l'intégration des données. Ce lancement marque une transition évidente dans la manière dont les modèles sont entraînés et déployés.
Aperçu
- Boucle d'auto-échafaudage : Contrairement aux pipelines traditionnels utilisant des harnais statiques rédigés manuellement, cette famille de modèles affine dynamiquement ses propres structures d'exécution et cadres de politiques spécifiques aux tâches durant l'apprentissage par renforcement.
- Déploiements multi-niveaux équilibrés : La gamme s'étend d'un modèle dense compact de 9B, optimisé pour les appareils en périphérie (edge) économes en ressources, jusqu'au modèle phare de 397B basé sur un mélange d'experts (MoE).
- Impact de l'intégration MMP : Contourne les cookies côté client et les redirections de navigateur classiques, nécessitant un transfert de jetons cryptographiques au niveau du SDK pour éviter les interruptions dans la mesure des installations.
Comprendre le framework d'auto-échafaudage d'Ornith
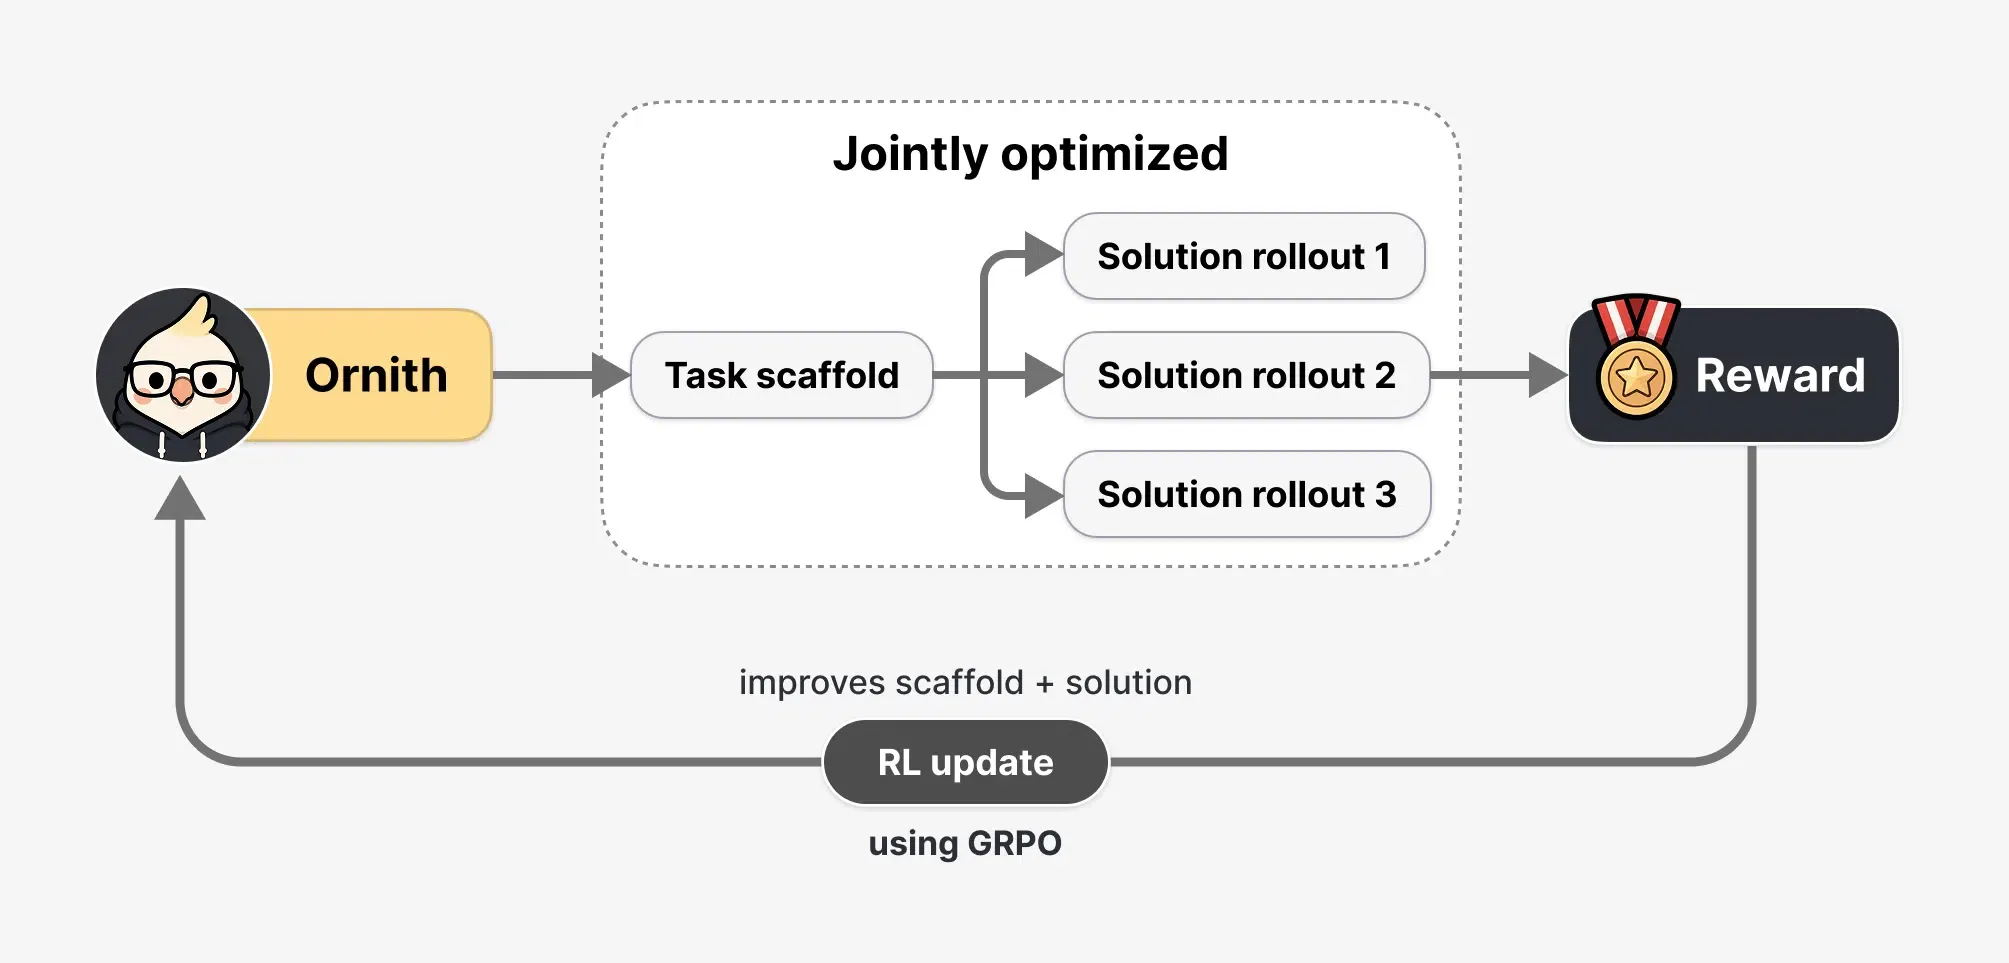
La publication de cette famille de modèles introduit de nouvelles dynamiques de tarification et de capacités au niveau de la couche de service des modèles, en particulier lorsque Ornith-1.0 se concentre sur le codage agentique pour optimiser conjointement le harnais spécifique à la tâche et la solution de code finale. Ce cadre co-évolutif permet au système de découvrir de meilleures trajectoires de recherche sans dépendre d'échafaudages fixes et humains. Construit sur la base des points de contrôle pré-entraînés de Gemma 4 et Qwen 3.5, l'éventail se compose de quatre tailles distinctes : 9B Dense, 31B Dense, 35B MoE et 397B MoE. Les spécifications détaillées sont documentées sur le Ornith Hub officiel.
Configurations des modèles et mesures de performance
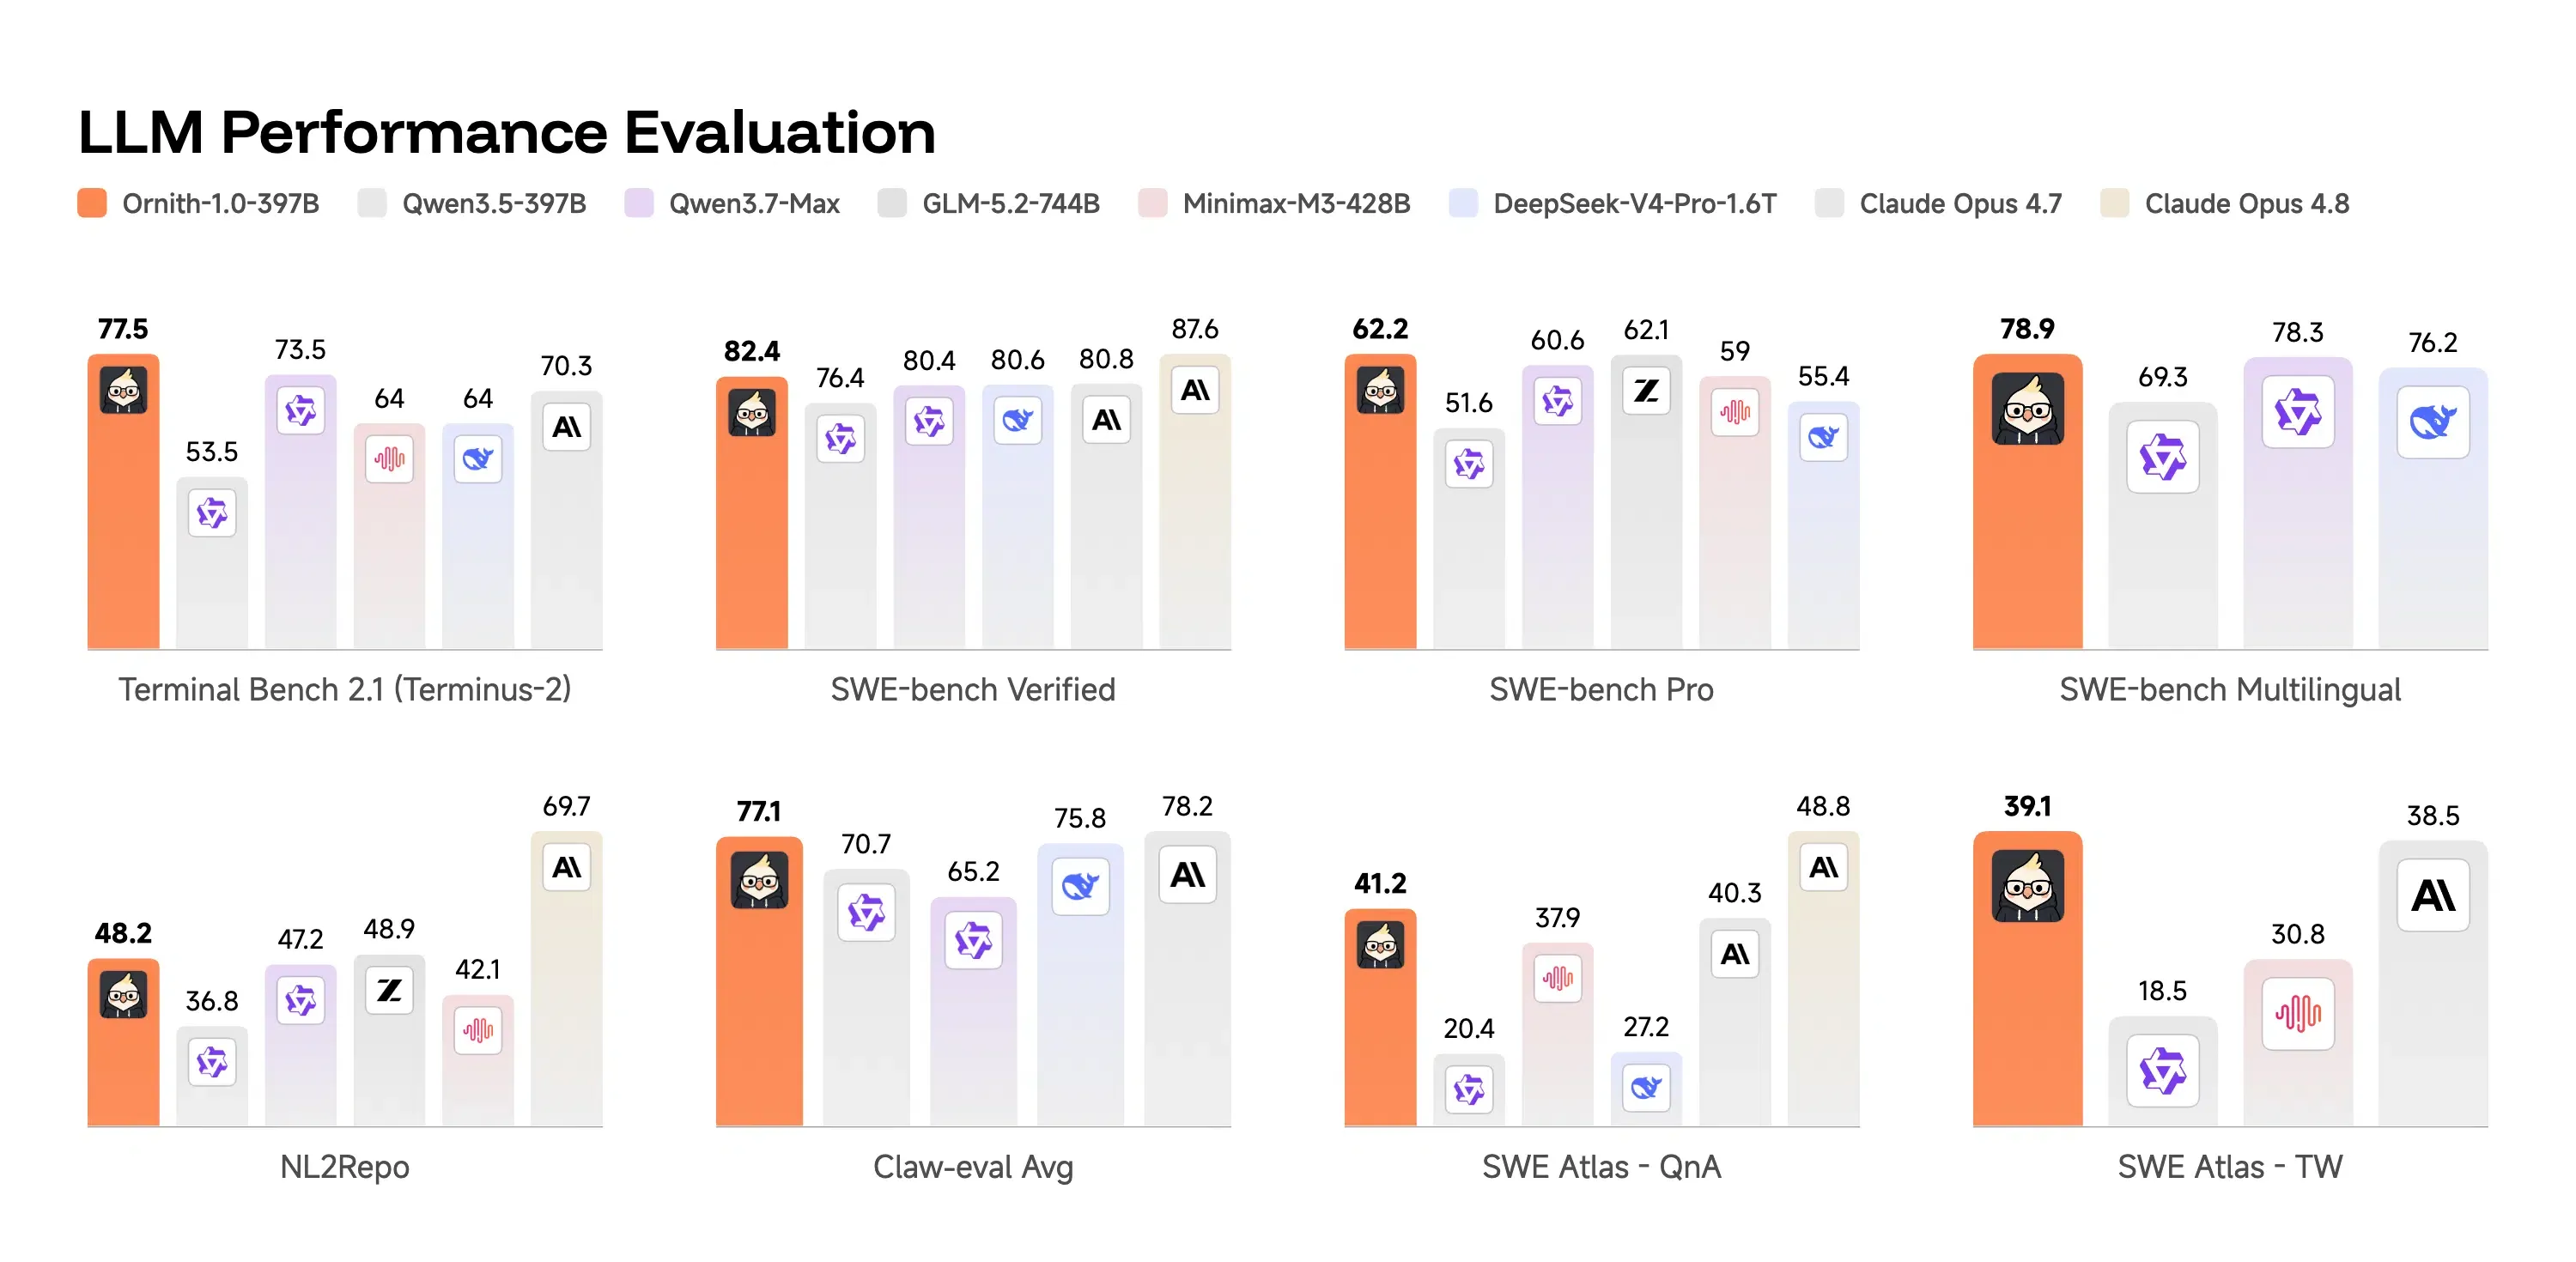
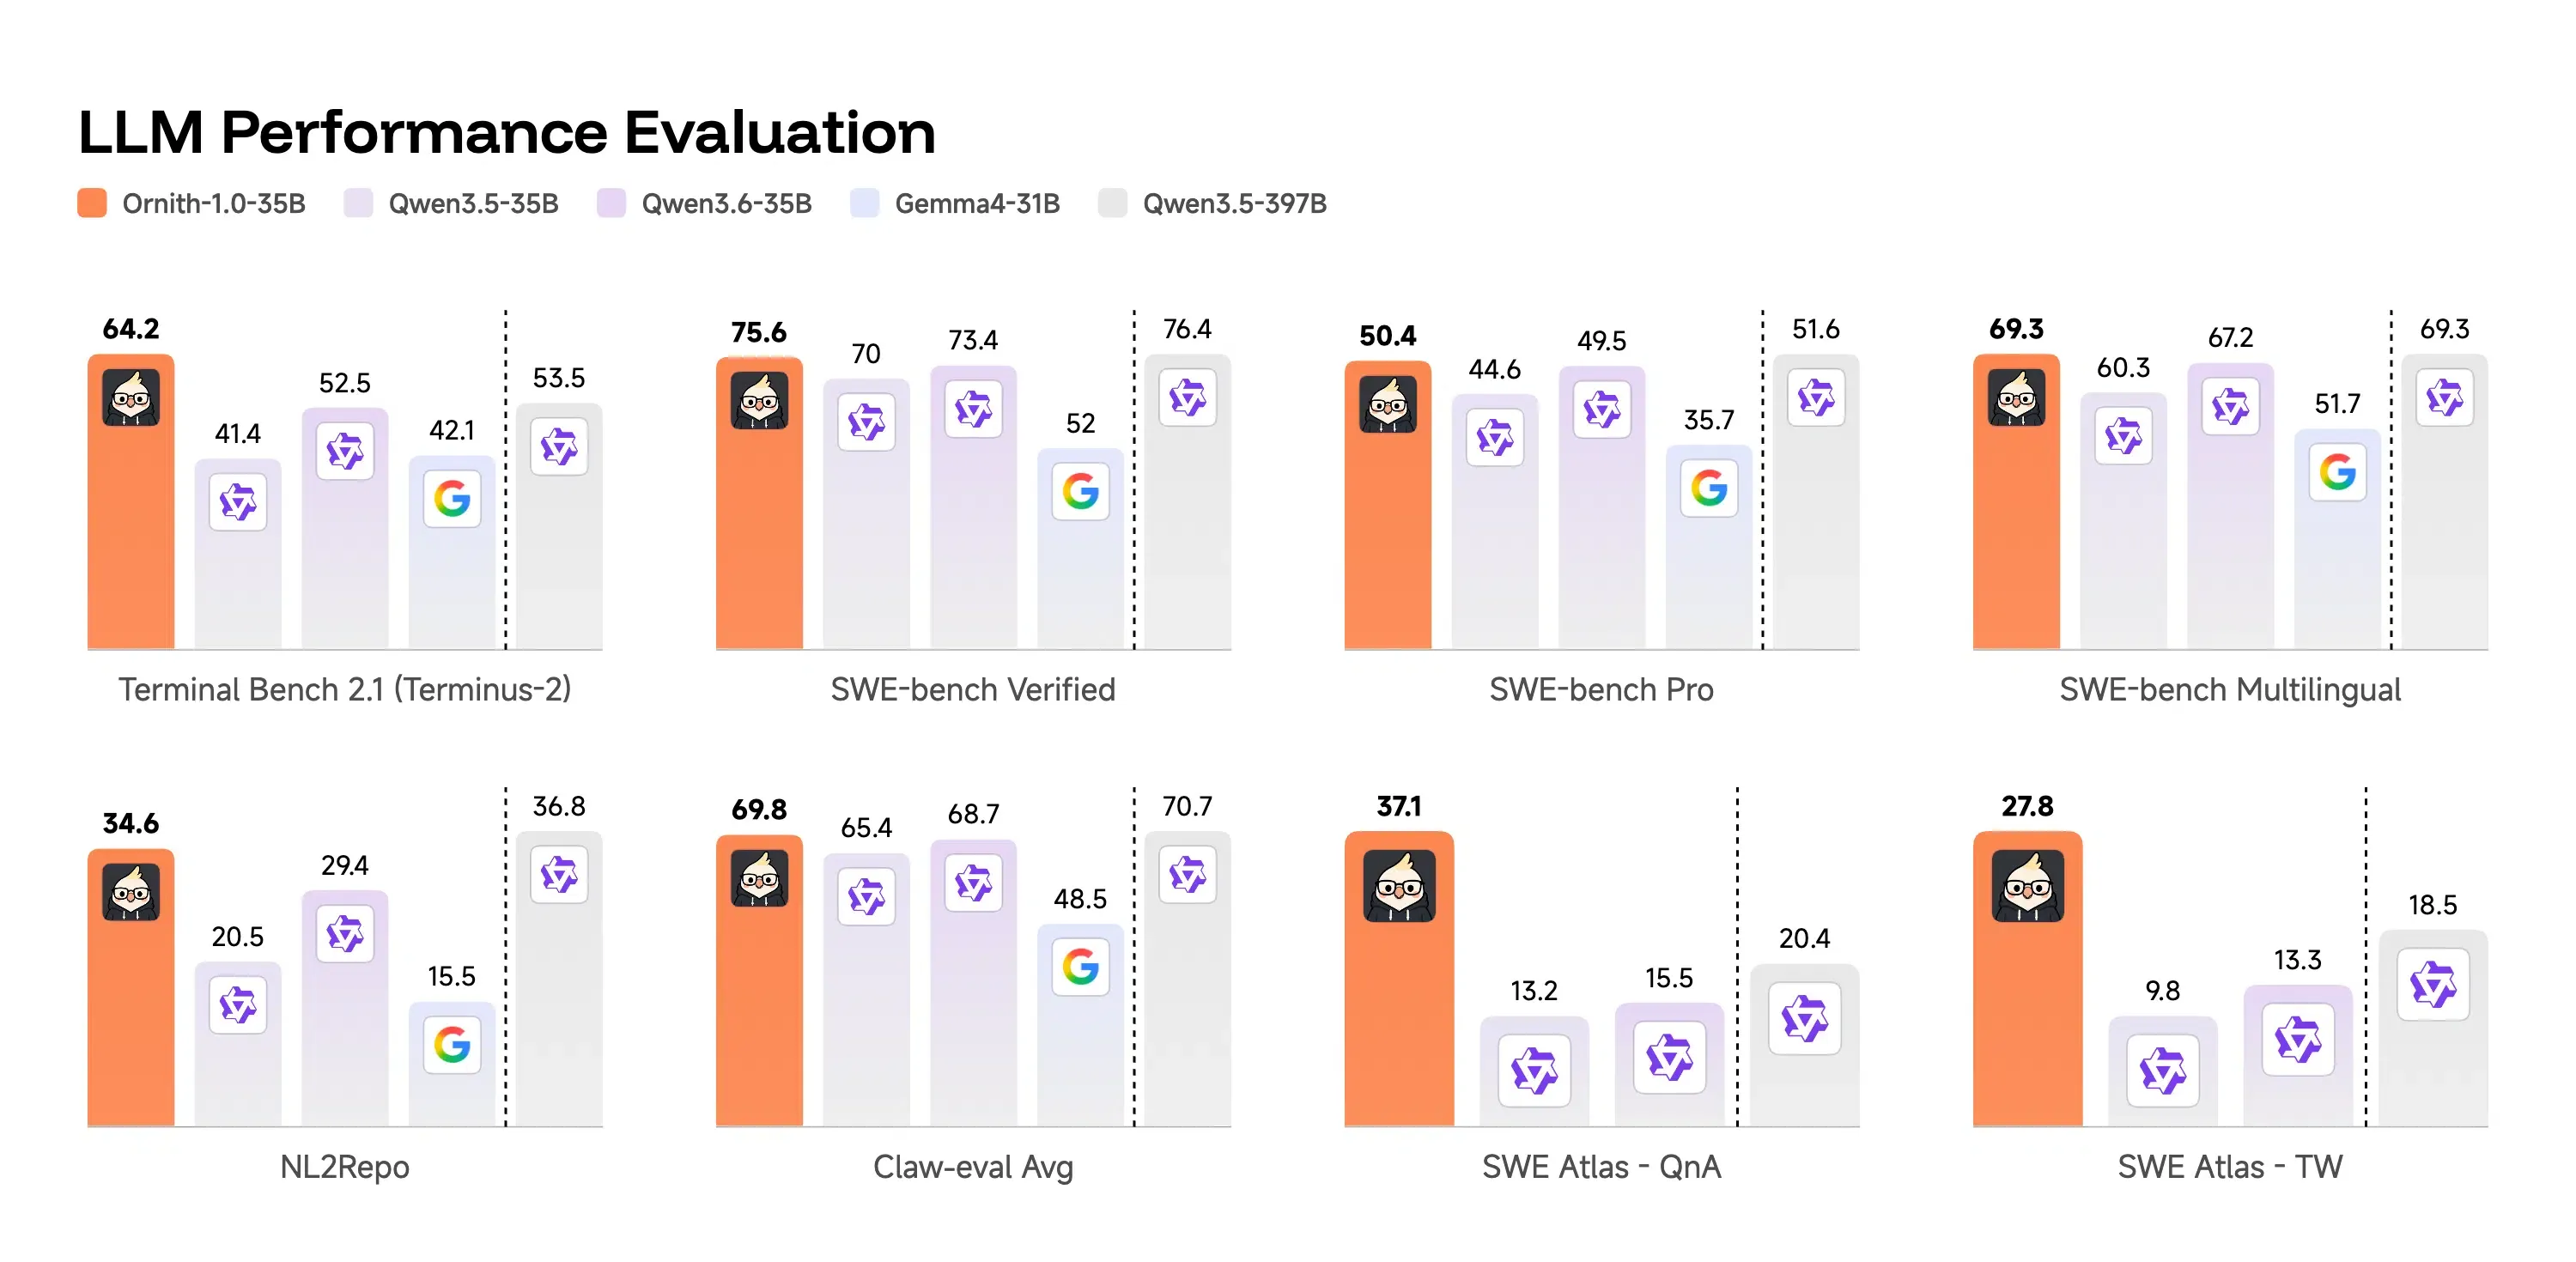
Les résultats de l'évaluation soulignent des gains de performance significatifs sur plusieurs benchmarks agentiques. À l'échelle du modèle phare, le modèle MoE 397B atteint 77,5 sur Terminal-Bench 2.1 et 82,4 sur SWE-Bench Verified. Ces performances surpassent celles de Claude Opus 4.7 et dépassent les principaux modèles ouverts de taille similaire. Par exemple, l'architecture réduit les lectures de fichiers redondantes et optimise les mouvements de mémoire lors des tâches à long contexte. Parallèlement, le modèle MoE 35B active environ 3B de paramètres par jeton, offrant un runtime rapide et rentable. Il obtient un score de 64,2 sur Terminal-Bench 2.1, devançant des modèles beaucoup plus volumineux comme Qwen 3.5-397B tout en maintenant une grande stabilité d'exécution.
Déploiements sur périphérie (edge) économes en ressources
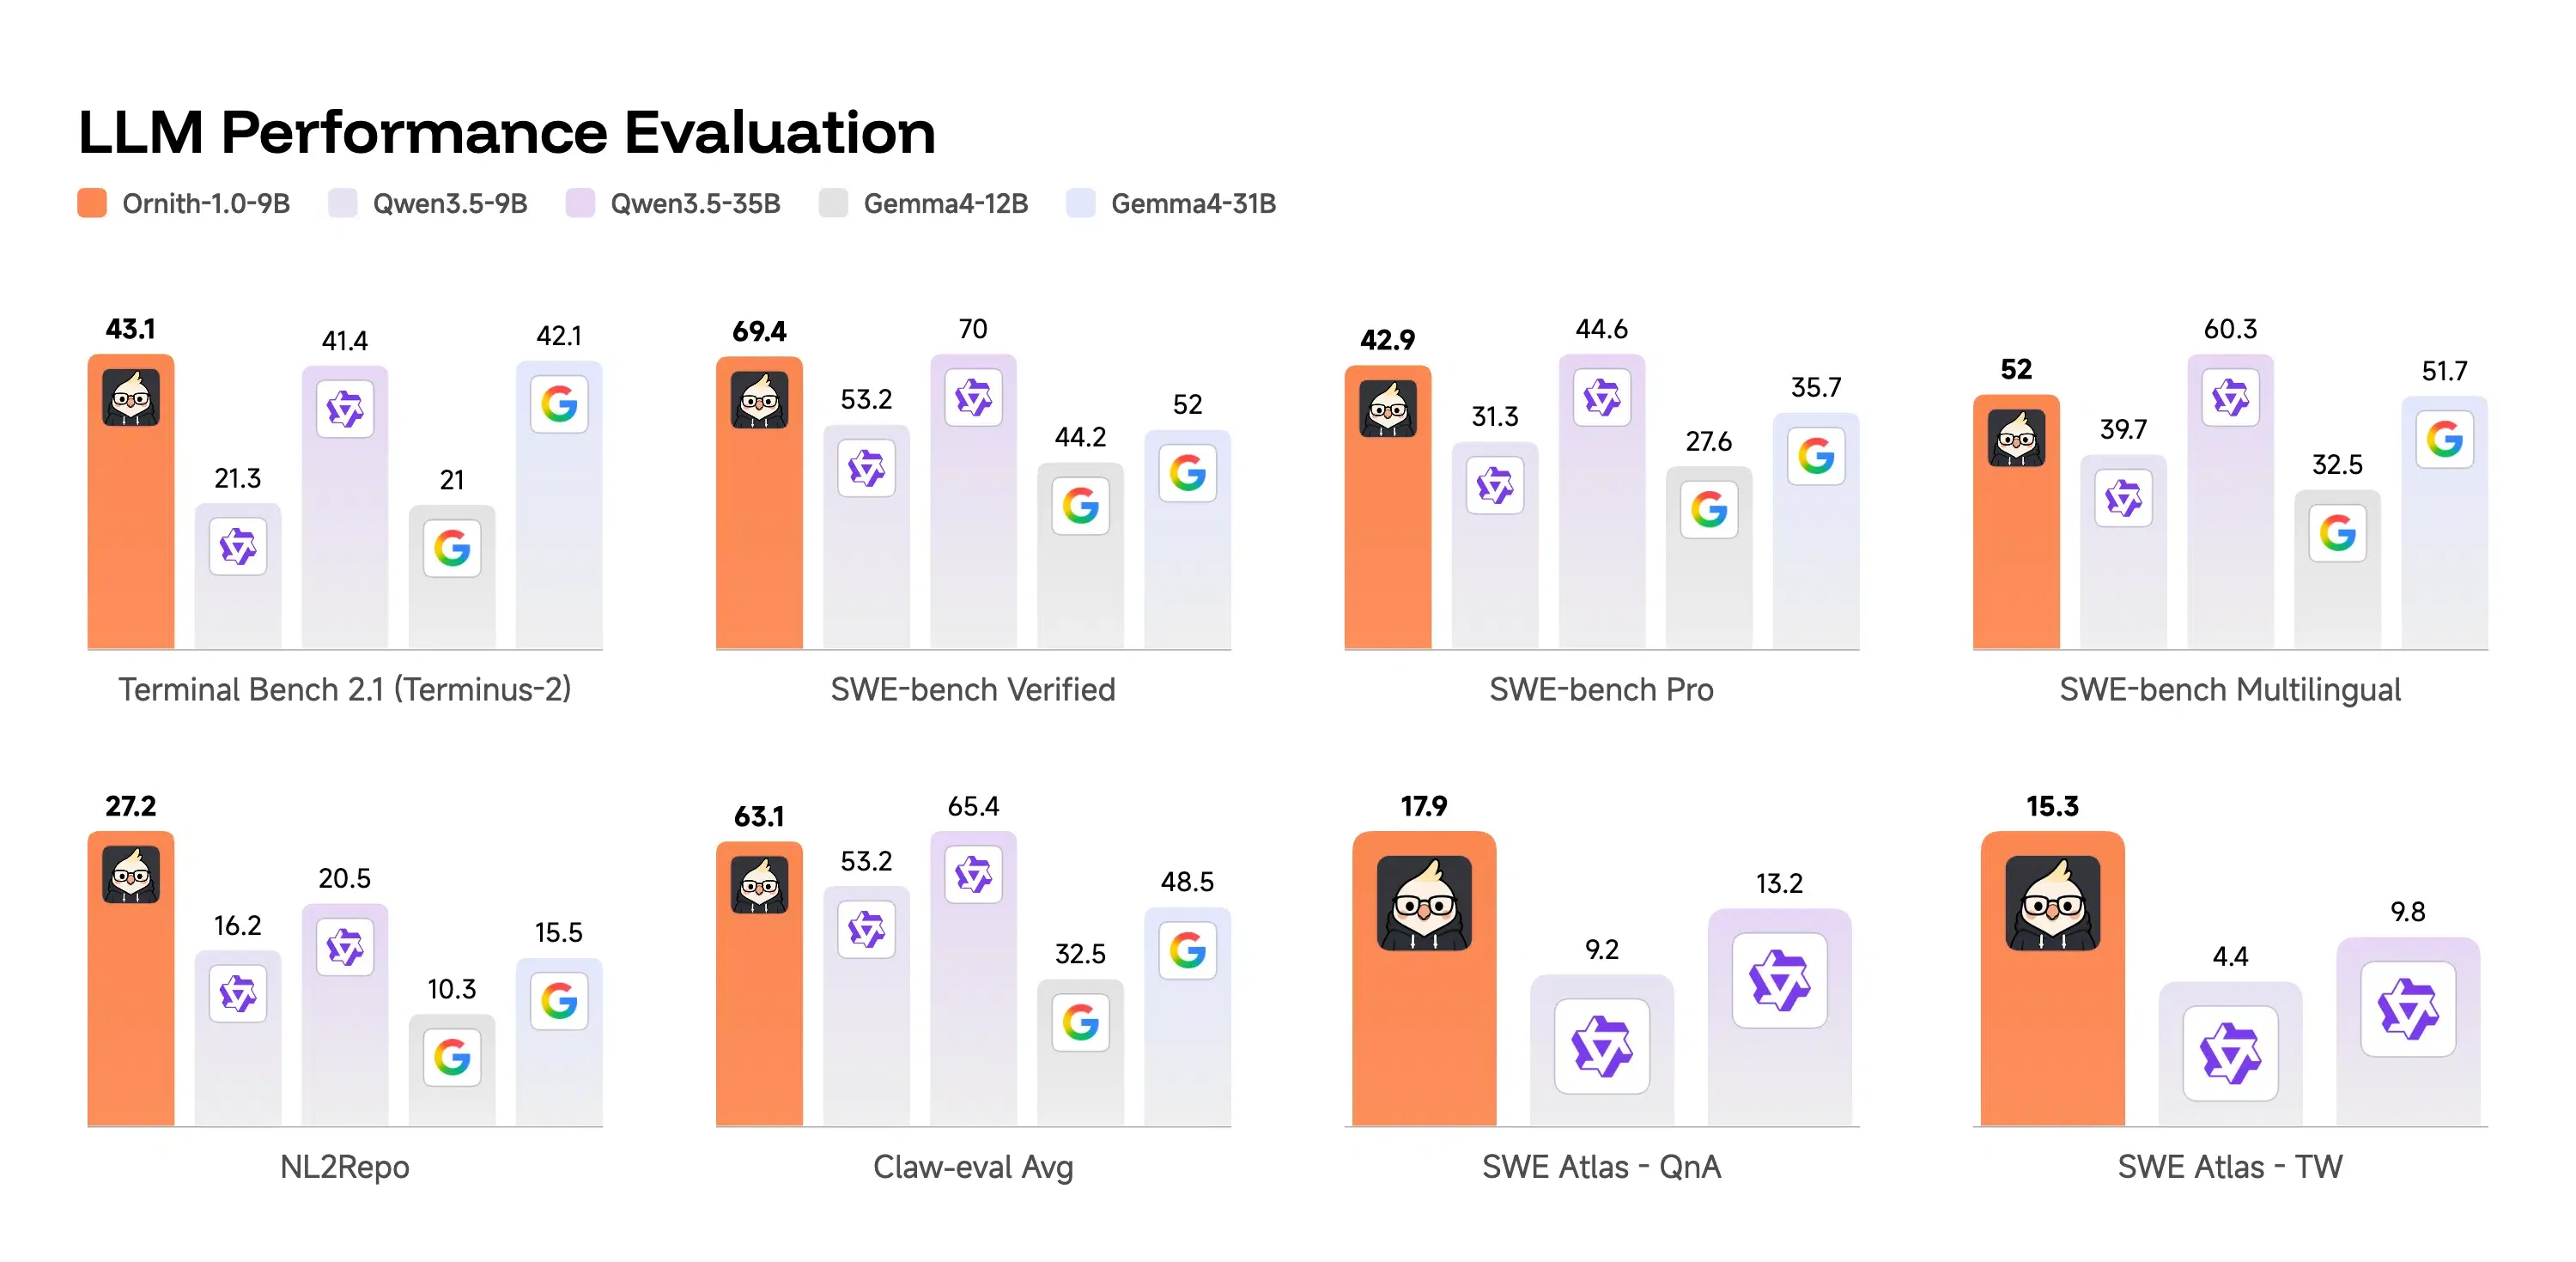
Pour les déploiements sur matériel local ou en périphérie, le modèle dense 9B offre une solution extrêmement efficace. Il atteint 43,1 sur Terminal-Bench 2.1 et 69,4 sur SWE-Bench Verified. Ce modèle compact ne nécessite qu'environ 19 Go de mémoire en bf16, permettant aux développeurs de l'exécuter sur un seul GPU de 80 Go. Par conséquent, les équipes peuvent effectuer des exécutions locales et privées sans transmettre de bases de code sensibles en dehors de l'organisation. Le modèle est entièrement compatible avec les formats de quantification Ollama, Unsloth et GGUF, permettant aux groupes d'ingénierie de déployer des agents de programmation locaux toujours actifs sur du matériel grand public.
La boucle d'entraînement auto-améliorante
Au cœur des capacités du modèle se trouve une boucle d'entraînement auto-améliorante. Durant l'apprentissage par renforcement, le modèle traite l'échafaudage comme un objet apprenable. Chaque étape d'entraînement se déroule en deux phases : d'abord, le modèle propose un échafaudage raffiné ; ensuite, il utilise cet échafaudage pour générer un déploiement de solution. La récompense est propagée aux deux étapes, optimisant le modèle pour rédiger sa propre orchestration. Pour prévenir le piratage des récompenses, DeepReinforce met en œuvre une défense à trois couches : une frontière de confiance fixe, un moniteur déterministe qui signale les lectures de chemins interdits, et un juge LLM figé agissant comme droit de veto.
Pourquoi les agents autonomes créent des angles morts dans l'attribution
À mesure que les agents autonomes exécutent des refactorisations multi-fichiers et des réparations de code, le volume de transactions API en arrière-plan augmente. Par conséquent, alors que la famille « Ornith-1.0 » traite les charges de travail de codage agentique de manière autonome sur des fichiers à l'échelle du dépôt, la transition vers une exécution en arrière-plan déclenche une crise d'attribution. Pour les équipes de développement, le défi immédiat consiste à gérer les transitions inter-plateformes tout en maintenant une validation robuste des sessions utilisateur.
Inverser le paradigme : quand l'exécution par agent surpasse les frappes manuelles
Les agents programmatiques opèrent comme des clients HTTP sans état, côté serveur. Ils ne conservent pas de cookies persistants, n'exécutent pas de stockage au niveau du navigateur et abandonnent souvent totalement les en-têtes Referrer lors de sauts automatisés en arrière-plan. Les observations suivantes sont basées sur des validations d'ingénierie interne effectuées dans nos environnements de test, destinées à illustrer les modèles d'exécution courants plutôt que des benchmarks à l'échelle de l'industrie. Lors d'un suivi télémétrique du routage effectué en avril 2026, nous avons audité environ 165 000 mutations de fichiers au niveau du dépôt dans notre environnement de test pour surveiller comment les agents de codage autonomes exécutaient des tâches de refactorisation multi-fichiers. La base de données a enregistré zéro poignée de main de cookie au niveau du navigateur, entraînant la classification de l'installation suivante comme trafic direct. Cette exécution sans état contourne les paramètres de suivi standards côté client comme le Google Play Install Referrer API. Elle empêche également les redirections au niveau du navigateur capturées par SKAdNetwork (SKAN) d'iOS ou le SDK Runtime de l'Android Privacy Sandbox. Par conséquent, lorsqu'un flux piloté par un agent termine une transaction via des API en arrière-plan, la chaîne de référence est rompue. L'installation apparaît comme une source directe inconnue, créant des écarts notables dans la mesure des campagnes.
Essaims de bots et vecteur de menace lié à la fraude publicitaire
Les jetons peu coûteux et haute performance créent de nouveaux défis pour les équipes de sécurité. En parallèle, la récente réduction sur les jetons hors-crête d'Alibaba offre une remise de 80 % durant les heures creuses. Ce changement de tarification réduit considérablement les coûts opérationnels liés à l'exécution de scripts d'agents automatisés la nuit. Lors d'une revue de sécurité de routine sur 38 000 commits de dépôt automatisés, notre équipe a identifié un groupe de scripts autonomes représentant environ 8 % de toutes les installations enregistrées, concentré entièrement sur une fenêtre de trois heures. Ces réseaux de bots ont falsifié par programme les rappels d'installation, prouvant que les limites de taux basées sur des seuils côté client sont insuffisantes. Cette exposition oblige les développeurs à mettre en œuvre une vérification plus robuste au niveau du SDK pour protéger les investissements marketing.
Construire des intégrations SDK sécurisées pour les agents autonomes
Sécuriser les flux de travail pilotés par des agents nécessite une approche d'ingénierie structurée. Une défense de base consiste à déployer une vérification de l'état au niveau de l'appareil. Les développeurs peuvent implémenter des machines à états qui valident les empreintes matérielles lors d'une demande de session. Lorsqu'un agent déclenche une action, le serveur vérifie cet état pour authentifier le contexte d'exécution, bloquant ainsi les appels non autorisés. Sécuriser les canaux d'exécution backend dans les environnements de codage agentique exige une poignée de main structurée et vérifiée cryptographiquement.
Concevoir des identifiants multi-agents sécurisés
Isoler l'environnement d'exécution est crucial pour empêcher les fuites de données entre sessions. Les développeurs peuvent exécuter des agents dans des bacs à sable (sandboxes) propres et transitoires qui détruisent l'état local une fois la tâche terminée. De plus, des signatures cryptographiques doivent être appliquées à tous les paramètres en transit. En signant chaque rappel d'URL avec des clés privées, les ingénieurs système s'assurent que les scripts intermédiaires ne peuvent pas altérer la charge utile, préservant ainsi l'intégrité du flux de données. Cette configuration sécurisée fournit une architecture robuste de filtrage du trafic non valide pour bloquer les tentatives de falsification automatisées.
Renforcer les signatures cryptographiques dans les implémentations SDK
Pour éviter de consacrer des cycles de sprint internes à l'infrastructure de machine à états, les équipes d'ingénierie s'appuient couramment sur des implémentations de référence standard de l'industrie. En production, les équipes peuvent intégrer le framework de transfert de paramètres d'application différés pour automatiser les contrôles de signature et la restauration d'état sans gérer de machines à états complexes. Cette intégration permet à l'application de récupérer le contexte de référence original à partir d'un rappel serveur sécurisé lors du premier lancement. En transmettant un jeton signé cryptographiquement via la boucle d'installation, la plateforme préserve l'état original de la transaction, assurant un flux de données cohérent sur l'ensemble du cycle d'acquisition.
Aligner l'ingénierie et le marketing sur la restauration d'état
La mise en œuvre de flux de travail pour les déploiements d'agents autonomes nécessite une coordination étroite entre les départements techniques et marketing. L'équipe d'ingénierie doit se concentrer sur la standardisation des identifiants uniques et assurer la compatibilité du SDK. Les développeurs doivent également gérer les ID de bundle sur les déploiements multi-locataires pour éviter les conflits de routage dans les magasins régionaux. Parallèlement, les architectes doivent implémenter des contrôles de signature sécurisés pour les plateformes iOS et Android afin de prévenir toute manipulation des liens profonds (deep links).
Considérations techniques pour les développeurs et les architectes
Les architectes doivent s'assurer que les schémas d'URL personnalisés, les liens universels et les liens d'application sont vérifiés au niveau de la passerelle. Cette configuration empêche les scripts malveillants de détourner le routage d'intention durant une transition web-vers-application. En appliquant une vérification de signature, les équipes peuvent protéger le pipeline de données aval et maintenir des enregistrements propres dans leurs systèmes en utilisant une architecture de lien universel standardisée.
Stratégies de croissance et acquisition de clients en période de déflation
Les équipes de croissance doivent adapter leurs analyses pour s'appuyer sur l'analyse de cohortes et les mesures de rétention à long terme plutôt que sur des événements de clic unique. L'intégration du moteur d'attribution déterministe multicanal permet la création de flux d'onboarding personnalisés qui préservent l'intention de l'utilisateur. Lorsqu'une référence survient, le système peut automatiquement attribuer la conversion sans nécessiter de saisie manuelle. Cette approche améliore la précision des calculs du retour sur investissement marketing (ROAS) et aide à filtrer le trafic invalide généré par les agents.
Questions fréquemment posées (FAQ)
Pourquoi les mesures basées sur le référent échouent-elles dans les flux de travail agentiques ?
Comment les signatures cryptographiques sécurisent-elles les SDK lorsque Ornith-1.0 se concentre sur le codage agentique ?
Pourquoi les méthodes standards d'empreinte numérique (fingerprinting) échouent-elles dans les flux de codage agentique ?
Ce lancement marque une évolution plus large dans le paysage technologique mondial. Plus précisément, à mesure que les processeurs d'inférence dédiés se développent, le modèle traditionnel d'accès aux logiciels commence à se dissoudre. De plus, alors que les agents autonomes prennent en charge davantage de tâches administratives, l'interface utilisateur principale pourrait passer de tableaux de bord visuels à des poignées de main API directes côté backend. Cette évolution pourrait réduire le rôle des boutiques d'applications traditionnelles dans la découvrabilité. Au lieu de cela, le marché pourrait voir une croissance de micro-applications à usage unique, générées dynamiquement pour des tâches spécifiques. Ce changement crée de nouvelles exigences en matière de distribution fluide et de vérification sécurisée en temps réel.
En outre, les cadres de confidentialité des données comme SKAdNetwork et Google Privacy Sandbox continueront probablement à limiter le partage de données avec des tiers. Cette tendance force les développeurs à privilégier la mesure déterministe de première partie. Dans cet environnement, les normes d'attribution multi-touch pourraient devenir une exigence de base pour les architectures système modernes. Les organisations s'appuyant sur l'attribution basée sur le navigateur pourraient vouloir évaluer si leurs pipelines de mesure actuels restent suffisants à mesure que les flux de travail pilotés par des agents deviennent monnaie courante.
Share this article



