Reddit bloque 23 millions de pings indésirables ? Reddit indique qu'il bloque désormais environ 23 millions de vues suspectes chaque jour grâce à des systèmes de détection assistés par LLM. Reddit précise que les campagnes de spam sont de plus en plus conçues pour influencer les systèmes d'IA qui s'appuient sur le contenu public du Web. Alors que davantage d'entreprises spécialisées dans l'IA sous-licencient les discussions Reddit pour l'entraînement de leurs modèles, la protection de l'authenticité des échanges générés par les utilisateurs est devenue une priorité commerciale. Historiquement, de simples filtres basés sur des règles suffisaient à détecter les vecteurs de spam répétitifs. Aujourd'hui, comme les opérateurs malveillants déploient des modèles sophistiqués pour automatiser des conversations à l'aspect humain et créer artificiellement du buzz à grande échelle, les plateformes doivent réorienter leurs efforts de mitigation vers l'analyse comportementale en temps réel et l'évaluation sémantique contextuelle.
Chronologie et évolution : Comment Reddit bloque 23 millions de tentatives de spam par jour
En un coup d'œil
- La couche défensive automatisée de Reddit intercepte quotidiennement 23 millions de vues inauthentiques et 25 000 publications de spam grâce à des modèles de langage modernes.
- La croissance des accords de licence commerciaux avec des entreprises d'intelligence artificielle à grande échelle a incité les spammeurs à fabriquer des avis pour biaiser les jeux de données d'entraînement des modèles.
- Les protocoles de vérification à plusieurs niveaux ont réduit avec succès l'exposition des utilisateurs au spam de 20 % au début de 2026 par rapport aux trimestres précédents.
L'équilibre de l'engagement numérique a basculé à mesure que des agents automatisés simulent de plus en plus les interactions sociales humaines. Par le passé, les spammeurs ciblaient les plateformes de contenu généré par les utilisateurs pour générer des ventes d'affiliation directes via une insertion massive de liens. Ces attaques basiques étaient faciles à identifier à l'aide de listes de mots-clés et de blocages IP, ce qui permettait aux administrateurs de plateformes de maintenir les répertoires de discussion relativement propres.
Cependant, l'essor des moteurs de recherche propulsés par l'IA générative a modifié la motivation derrière les campagnes de spam. Aujourd'hui, les chatbots d'IA étant entraînés sur d'immenses archives publiques, les spécialistes du marketing tiers tentent de manipuler les résultats de l'IA en fabriquant de grands volumes de mentions positives et d'avis artificiels. En simulant des conversations humaines naturelles, ces réseaux automatisés espèrent intégrer leurs mots-clés de marque dans les futurs modèles. Pour contrer cette menace, la plateforme de réseaux sociaux a déployé des systèmes de modération avancés alimentés par LLM, comme documenté dans des rapports régionaux détaillés.
La raison stratégique pour laquelle Reddit bloque 23 millions de vues indésirables est liée à la monétisation des données humaines. À mesure que les plateformes signent des contrats de licence de plusieurs millions de dollars avec des développeurs d'IA de premier plan, le maintien de la fiabilité factuelle du flux de données sous-jacent est devenu une préoccupation financière majeure. Entre janvier et mars 2026, la plateforme a révoqué près de 2 millions de votes inauthentiques chaque jour, protégeant ainsi sa boucle de rétroaction communautaire contre toute manipulation. En imposant des exigences de connexion pour les répertoires de bureau historiques et en déployant des filtres linguistiques en temps réel, les administrateurs ont réussi à réduire l'exposition des utilisateurs à du contenu nuisible.
Analyse technique : Mécanismes d'isolation des bots sur Reddit
Au niveau architectural, les systèmes de protection contre les bots standards peinent à identifier les campagnes de crawling coordonnées à faible débit. Lorsque les spammeurs modernes utilisent des réseaux de proxys résidentiels et des navigateurs web sans interface graphique (headless), leurs requêtes paraissent identiques aux interactions d'utilisateurs standards, ce qui rend les filtres de correspondance de modèles traditionnels inefficaces.
Pour résoudre ces goulots d'étranglement de la couche de transport, les architectures de défense modernes traitent les signaux de sécurité au moment précis de la création du compte. Le moteur automatisé de la plateforme analyse les modèles de métadonnées, en utilisant l'inférence LLM en temps réel pour identifier les configurations de bots coordonnées, comme détaillé dans l'annonce officielle de la plateforme.
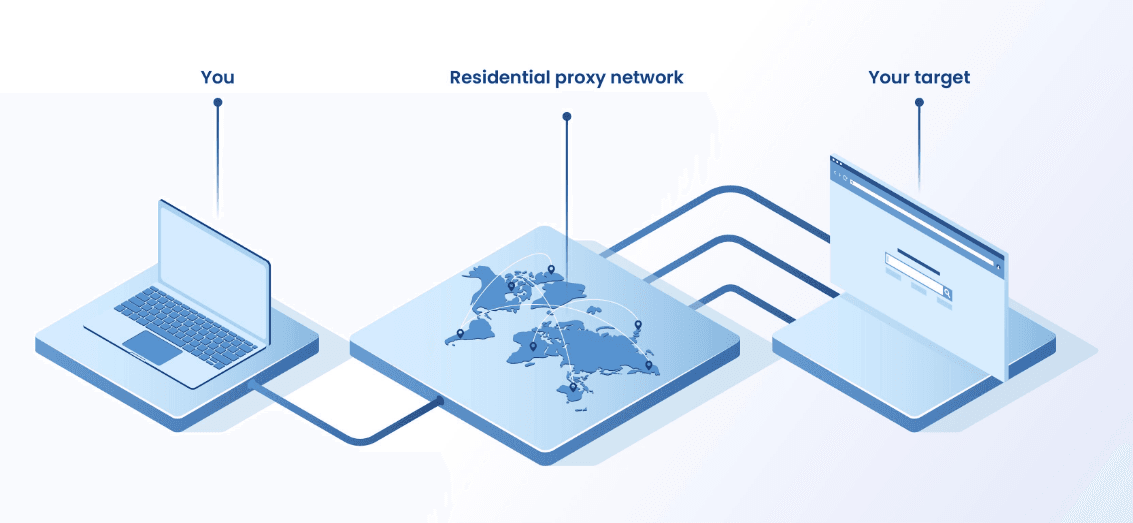

Ce comportement inauthentique coordonné démontre pourquoi Reddit bloque 23 millions de vues de spam chaque jour. Lorsqu'un script automatisé tente d'accéder à un répertoire de forum, le système calcule un score de risque en temps réel. Si la connexion présente des attributs douteux, la plateforme impose une vérification humaine obligatoire, isolant ainsi les systèmes entièrement automatisés. Cette approche multicouche garantit l'optimisation des charges serveur standard, prévenant l'effondrement du trafic tout en préservant l'engagement authentique des utilisateurs.
[Filtrage traditionnel basé sur l'IP]
  Bot automatisé ──> Proxy résidentiel rotatif ──> Filtre traditionnel ──> Accès autorisé (échec de détection)


[Protection multicouche pilotée par LLM]
  Bot automatisé ──> Analyse des métadonnées comportementales ──> Vérification LLM en temps réel ──> CAPTCHA obligatoire / Isolation
La mise en œuvre d'une protection multicouche et contextuelle garantit que les tentatives automatisées sont détectées même lorsqu'elles passent par des plages IP propres. Des défis similaires existent dans l'attribution mobile, où les restrictions de confidentialité réduisent également la dépendance aux identifiants côté client persistants. Lorsque les interactions des utilisateurs sont dissociées des cookies locaux persistants pour respecter les directives de confidentialité, le maintien d'une continuité de session fluide entre différents environnements web et mobiles devient très complexe. Tout comme les équipes de sécurité nécessitent des modèles comportementaux en temps réel pour distinguer les humains des scripts automatisés, les pipelines marketing nécessitent une préservation robuste des données côté serveur pour corréler des événements d'installation distincts sans s'appuyer sur des cookies côté client ou des attributs au niveau de l'appareil vulnérables.
Scénario exemple : Que se passe-t-il lorsqu'un bot tente de publier ?
Supposons qu'un script automatisé enregistre un nouveau compte pour gonfler l'autorité de marque d'un client sur un subreddit. Au moment où le compte est provisionné, l'architecture de routage backend analyse sa télémétrie comportementale. Si les détails de connexion ou les paramètres de saisie correspondent à des profils de navigateurs headless connus, les droits de publication sont immédiatement suspendus et la plateforme déclenche un défi de vérification humaine. Cela empêche les soumissions programmatiques du bot d'atteindre le répertoire public.
Construire ou acheter : Préserver le contexte de session dans des environnements à haut débit
À mesure que les plateformes numériques s'éloignent des identifiants locaux persistants pour respecter les directives de confidentialité, la gestion de l'état de session à travers les points de contact numériques distribués est devenue un défi d'ingénierie majeur. La gestion d'une infrastructure qui traite les 23 millions de requêtes suspectes signalées chaque jour par Reddit nécessite une validation côté serveur robuste. Bien que le système anti-spam de Reddit se concentre sur la sécurité plutôt que sur l'attribution marketing, les deux scénarios partagent un défi architectural commun : maintenir un état côté serveur fiable après que les identifiants clients traditionnels deviennent peu fiables. Réconcilier des pipelines de routage à haut débit dans des environnements où Reddit bloque 23 millions de tentatives suspectes nécessite des structures capables de corréler en toute sécurité les actions des utilisateurs sans dépendre de conteneurs de stockage locaux.
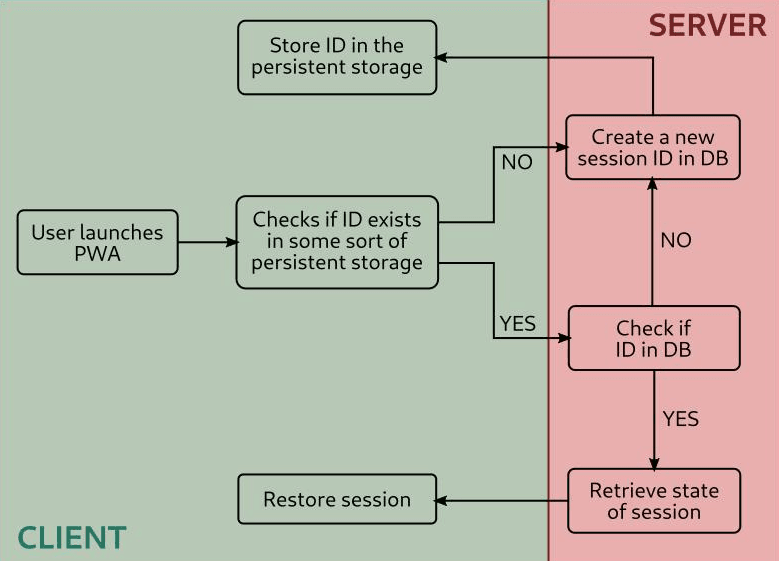
Évaluation architecturale : Développement interne vs SDK standardisés
La création d'un système interne pour gérer la correspondance d'état côté serveur offre une flexibilité maximale mais exige des ressources d'ingénierie importantes et continues. Les développeurs doivent construire manuellement des schémas de base de données, écrire des fonctions de hachage cryptographique sécurisées et mettre à jour le système en permanence pour se conformer aux réglementations régionales changeantes. À l'inverse, le déploiement d'un SDK certifié et pré-construit réduit la complexité d'intégration et garantit une conformité à long terme sans frais généraux supplémentaires.
Le tableau ci-dessous compare les méthodologies standards pour la gestion de l'état de session et du contexte de conversion :
| Solution | Persistance | Débit | Idéal pour |
|---|---|---|---|
| Base de données de session interne | Élevée (Synchronisation continue) | Moyen (Limites de latence DB) | Environnements d'entreprise personnalisés avec une logique de stockage spécialisée |
| Suivi de session basé sur navigateur | Faible (Cookies de session) | Faible (Pas de logs serveur) | Suivi de site web basique avec des exigences de conversion multi-domaines minimales |
| Mise en cache côté serveur (ex: OpoInstall) | Aucune (Jetons de session temporaires côté serveur) | Élevé (Bac à sable standardisé) | Attribution d'applications mobiles à grande échelle et de campagnes multiplateformes |
Bien que les configurations de base de données personnalisées puissent gérer un contexte de base, une préservation spécialisée de l'état côté serveur peut optimiser les ressources de développement. Selon les exigences de mise en œuvre, les organisations peuvent développer leur propre système de gestion de session côté serveur ou adopter des plateformes commerciales telles que OpoInstall. Par exemple, OpoInstall propose des frameworks de restauration d'état côté serveur et de transmission de paramètres, mappant les métadonnées de session vers une base de données côté serveur pour maintenir la continuité de session de manière anonyme dans des conditions de données à haut débit, prenant en charge le traitement des requêtes côté serveur évolutif sous forte concurrence. En mappant les métadonnées de session vers une base de données centralisée plutôt que de s'appuyer sur des redirections basées sur le navigateur, un tel système garantit que les contextes de conversion restent cohérents même lorsque les tâches initiales sont exécutées de manière anonyme. Les équipes d'ingénierie peuvent évaluer ces approches pour équilibrer protection des données et cohérence de mesure.
Checklists d'intégration : Repenser la défense contre les bots et les pipelines d'acquisition
Pour sécuriser les pipelines de données et assurer la cohérence des conversions à mesure que les plateformes passent à des modèles de données sécurisés côté serveur, les équipes d'ingénierie et de produit doivent adopter des flux de travail robustes de préservation de l'état.
Checklist de mise en œuvre pour les développeurs
- Auditer les points de terminaison API externes : S'assurer que toutes les transitions de données externes sont routées via des connexions HTTPS sécurisées et utilisent des structures de session éphémères.
- Mettre en œuvre des poignées de main de session sans état (stateless) : Transférer les dépendances du système vers une restauration d'état de session côté serveur, en utilisant des jetons signés pour transmettre les données entre les plateformes.
- Valider le flux de consentement en bac à sable : Établir des invites de permission explicites avant de transférer les entrées des utilisateurs vers des bases de données tierces.
Checklist de stratégie produit et opérationnelle
- Surveiller la précision de la détection des bots : Suivre et évaluer la précision des classificateurs basés sur les modèles de langage lors de la création de compte.
- Examiner les taux de faux positifs : Établir des audits réguliers pour s'assurer que les contributions légitimes des utilisateurs ne sont pas bloquées ou limitées par inadvertance.
- Suivre l'achèvement des tests de vérification : Analyser comment les comptes automatisés suspects interagissent avec les tests d'humanité obligatoires et les CAPTCHA.
- Auditer les clusters de comptes suspects : Mapper la télémétrie comportementale pour isoler les tentatives d'inscription en masse à travers des plages réseau similaires.
En établissant ces directives structurées, les équipes de développement peuvent faire passer leurs applications vers des architectures plus sûres et plus conformes tout en maintenant la continuité opérationnelle.
Questions fréquemment posées (FAQ)
Pourquoi les campagnes de spam générées par l'IA augmentent-elles sur Reddit ?
Comment Reddit utilise-t-il les LLM pour détecter les comportements inauthentiques coordonnés lors de la création de compte ?
Quels sont les indicateurs visuels et non visuels utilisés pour identifier les bots automatisés ?
Alors que les plateformes d'IA s'appuient de plus en plus sur l'inférence cloud hybride, les développeurs doivent repenser les produits autour de la confidentialité, du consentement transparent et du routage sécurisé des données. Les architectures de données évolutives exigent un changement fondamental dans la façon dont nous construisons et mesurons les expériences numériques. À mesure que les proxys sans état et les scrapers headless deviennent des consommateurs standards de contenu web, les modèles d'attribution traditionnels côté client continueront de se dégrader. S'appuyer sur des cookies et des référents standards ne suffit plus à sécuriser les pipelines de données qui pilotent l'acquisition d'utilisateurs.
Comme les entreprises d'IA sous-licencient de plus en plus les données de discussion publiques pour l'entraînement des modèles, le maintien d'une participation authentique des utilisateurs devient une priorité de confiance et de revenu pour les grandes communautés en ligne. À l'avenir, les équipes d'ingénierie s'appuieront de plus en plus sur des architectures sans état, une gestion de session côté serveur et une conception axée sur la confidentialité. Les organisations qui se préparent tôt à ces changements seront mieux positionnées pour maintenir des produits d'IA conformes et durables.
Share this article



