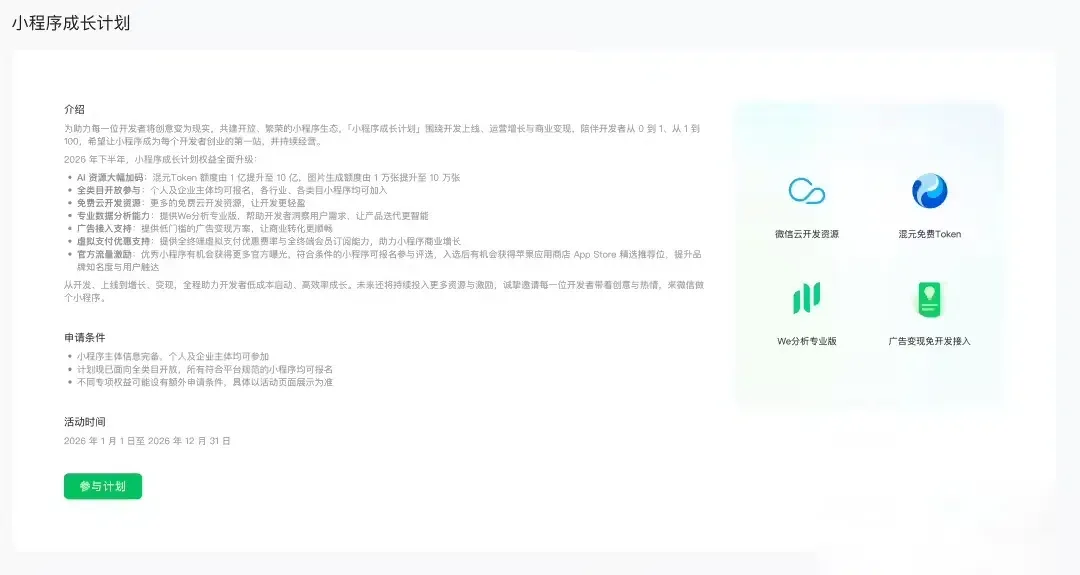
 Extension des mini-programmes IA WeChat ? Tencent a annoncé un nouveau programme pour les développeurs offrant un milliard de jetons textuels Hunyuan gratuits ainsi que cent mille crédits de génération d'images, afin de réduire les barrières à l'entrée pour les applications clientes intelligentes. En abaissant les coûts des API et en simplifiant l'accès aux modèles de base, Tencent ambitionne d'accélérer l'adoption de fonctionnalités IA au sein des mini-programmes WeChat tout en réduisant la charge infrastructurelle pesant sur les développeurs. Aujourd'hui, les plateformes d'IA distribuent de plus en plus leurs charges de travail intensives sur des environnements cloud tiers de confiance, rendant le consentement explicite des utilisateurs et le routage transparent essentiels. À mesure que ces plateformes gèrent des requêtes génératives plus complexes sur des infrastructures externes, des protocoles de vérification multi-cloud sécurisés deviennent indispensables pour préserver la confiance des utilisateurs.
Pourquoi les mini-programmes IA WeChat entrent dans une phase d'adoption massive
En un coup d'œil
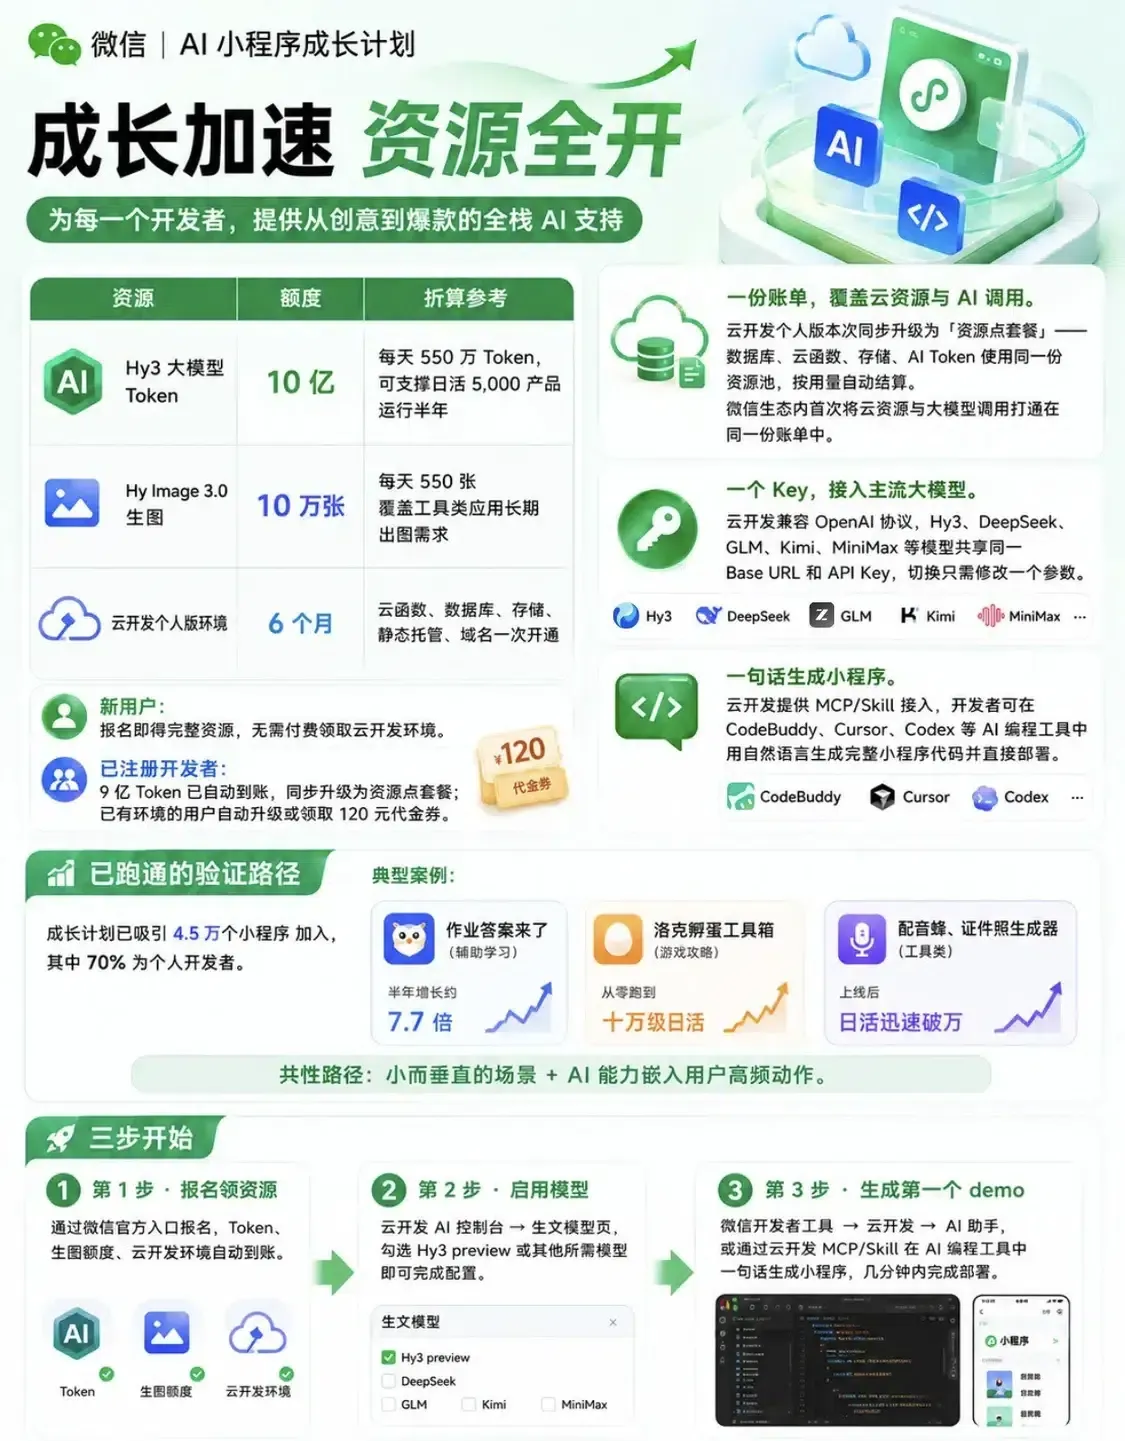
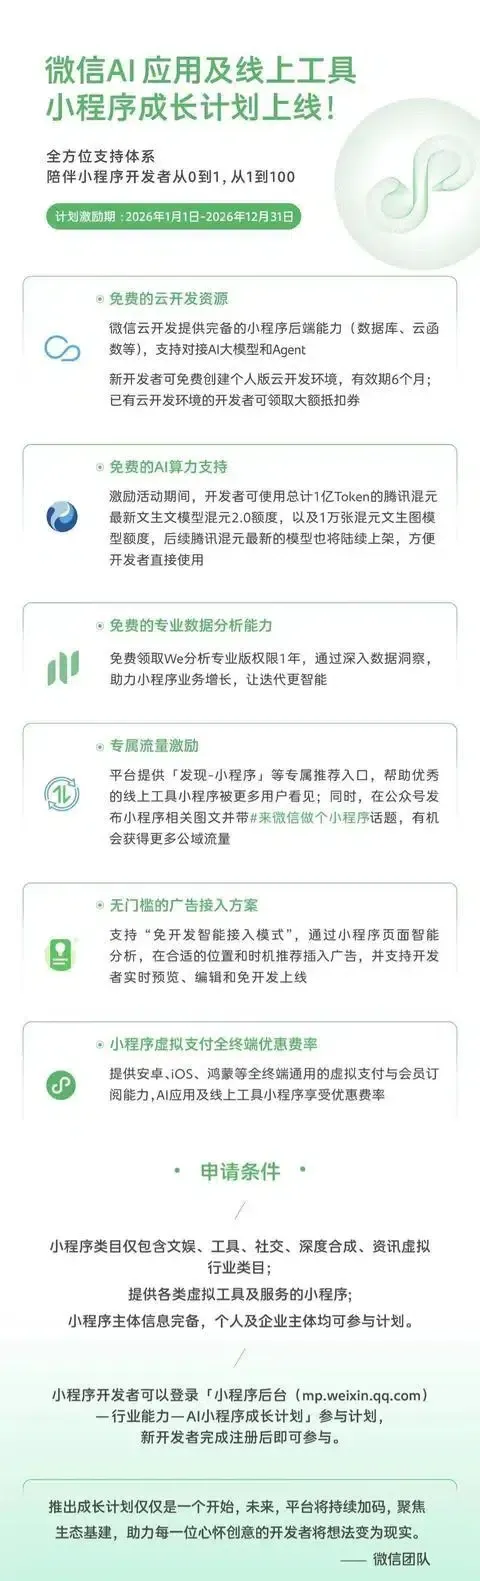
- Le programme pour les développeurs de Tencent multiplie par dix son allotment de base, offrant un milliard de jetons textuels et cent mille créations d'images sur une période de six mois.
- Tous les secteurs sont éligibles sans restriction de catégorie, permettant aux comptes de développeurs individuels de réclamer des ressources au même titre que les entités d'entreprise vérifiées.
- Les points de terminaison mis à jour permettent une transition automatique des projets existants vers des modèles de raisonnement modernes, simplifiant ainsi la maintenance du code sur les nœuds serverless.
Le paysage des micro-applications décentralisées connaît une transition opérationnelle majeure. Historiquement, intégrer des capacités de réseaux neuronaux à grande échelle dans des applications légères côté client exigeait un capital initial et une infrastructure technique considérables. Les petites équipes et les développeurs indépendants devaient négocier des passerelles API complexes, gérer des pipelines de facturation lourds et configurer des clés ardues. Ces obstacles techniques décourageaient souvent les créateurs d'intégrer des fonctionnalités génératives avancées, au profit de produits basés sur des règles simples.
Les développeurs concevant des mini-programmes IA WeChat peuvent désormais enregistrer des comptes personnels sans nécessiter d'authentification d'entreprise formelle. En introduisant des ressources importantes sous forme de jetons gratuits, l'opérateur de la plateforme lève ces goulots d'étranglement financiers. Les développeurs qui établissent un environnement serverless selon les guides officiels de la plateforme peuvent immédiatement configurer des modèles en utilisant le SDK cloud standard. Le pack de ressources inclut une mise à niveau automatique vers le nouveau modèle génératif Tencent Hunyuan, permettant aux applications de produire des images personnalisées et d'effectuer des interactions textuelles approfondies sans middleware externe.
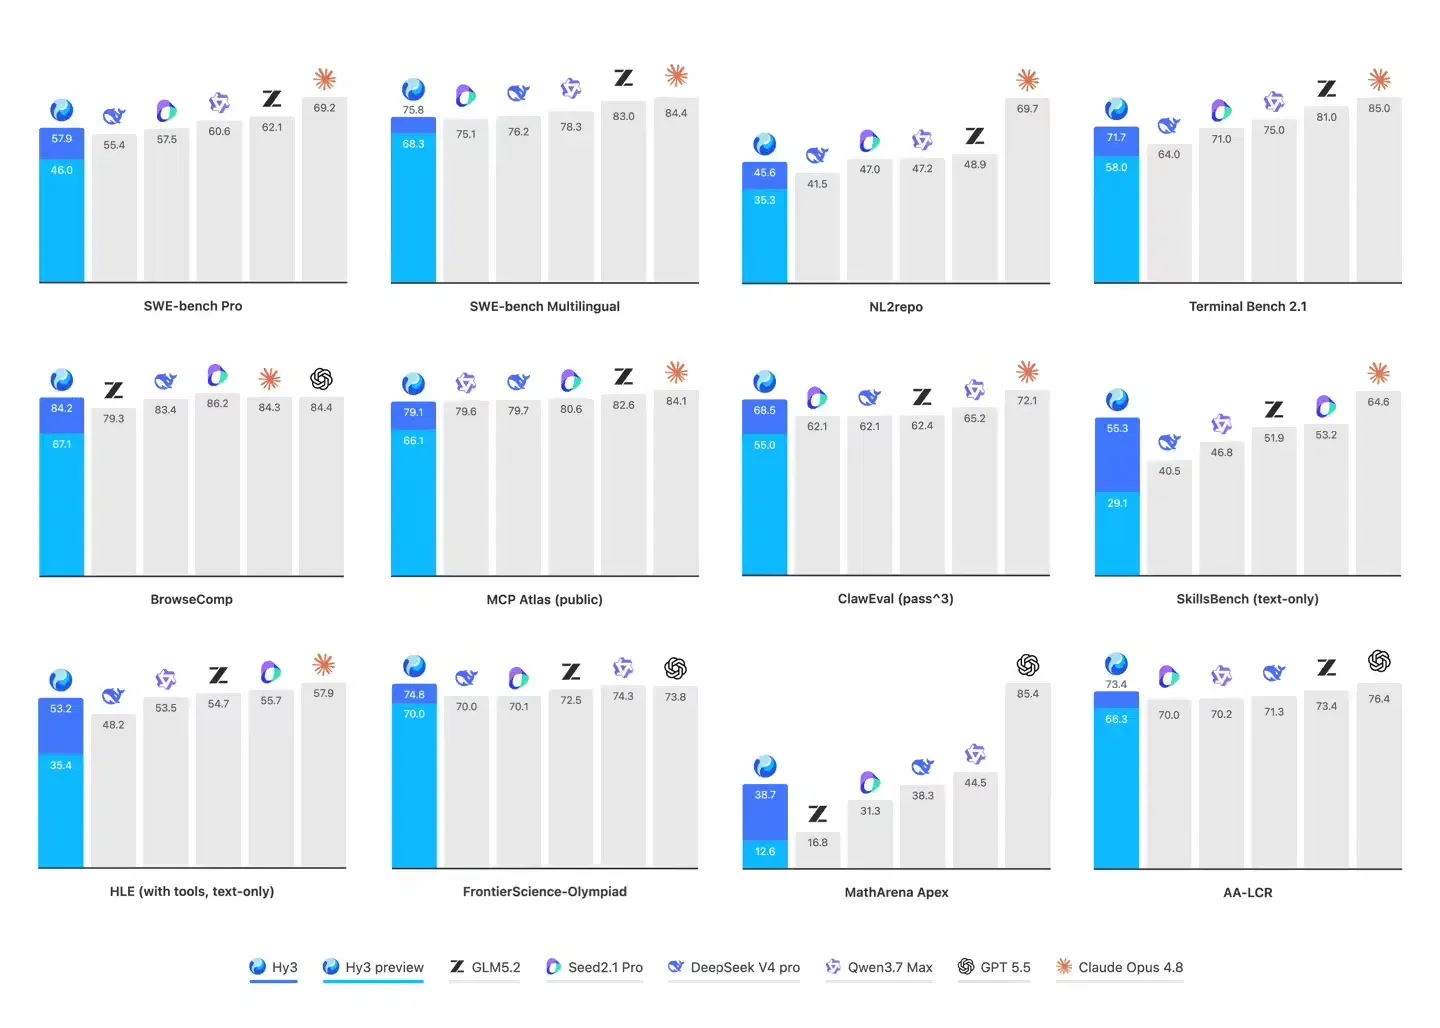
L'initiative des mini-programmes IA WeChat établit une voie fiable pour intégrer des ressources cloud aux applications clientes. Dans ce cadre mis à jour, la plateforme assure une compatibilité ascendante automatique pour les applications existantes, basculant les connexions actives vers les points de terminaison mis à jour. Aucune configuration manuelle de l'environnement n'est nécessaire pour accéder aux ressources modernes. En offrant ces allocations généreuses, le programme garantit que les développeurs peuvent se concentrer sur l'expérience utilisateur et les parcours de conversion plutôt que sur la surveillance des compteurs d'utilisation en temps réel.
Analyse technique : Déconstruction de CloudBase MCP et des flux de travail IA serverless
Au niveau du système, la mise en œuvre du traitement de modèle côté serveur dans des environnements de messagerie isolés nécessite des connexions hautement sécurisées et conformes aux standards. Le déploiement de mini-programmes IA WeChat via le protocole MCP (Model Context Protocol) permet aux développeurs de communiquer en toute sécurité avec des backends serverless. Grâce au déploiement du MCP, les développeurs peuvent connecter en toute sécurité leurs environnements de développement intégrés (IDE) standard à la plateforme cloud, permettant un déploiement automatique du code et une configuration des ressources directement via des commandes en langage naturel.
Ces intégrations sont configurées via des wrappers d'API standard, permettant des transitions de données sécurisées entre les environnements locaux et les réseaux cloud, comme indiqué dans la documentation officielle d'accès aux API. Avec ce modèle, le système exécute les appels côté serveur dans des environnements isolés (sandboxes) afin de protéger les identifiants utilisateur contre toute interception externe, établissant ainsi un protocole sécurisé pour les déploiements de mini-programmes IA WeChat.
Distinction technique : Points de terminaison serverless vs traitement de contexte local
D'un point de vue architectural, l'exécution d'API serverless diffère considérablement du traitement local standard. Lorsqu'une application utilise des fonctions cloud pour exécuter des requêtes de modèle, elle délègue les calculs neuronaux intensifs du processeur du terminal vers des conteneurs élastiques distants. Cependant, cette approche hybride nécessite une gestion minutieuse des requêtes pour éviter l'encombrement des prompts et les pics de latence.
Le schéma ci-dessous illustre le flux typique d'une boucle d'exécution cloud intégrée :
[IDE Développeur] ──(Prompt en langage naturel)──> [Serveur CloudBase MCP]
                                                     │
                                                     ▼
[Mini-programme WeChat] ──(Appel API : SDK Serveur) ──> [Fonction Cloud Serverless] ──> [Moteur Hunyuan Hy3]
Lorsqu'une fonction cloud déclenche une requête d'inférence, elle transmet le prompt de l'utilisateur accompagné des instructions système au cluster de modèles Tencent Hunyuan. Pour éviter une consommation inutile de ressources, la couche serverless doit traiter les données de manière éphémère, assurant une optimisation de la mémoire pour les requêtes à haute concurrence. Des défis similaires en matière d'optimisation de jetons et de gestion des ressources d'exécution existent dans l'analytique mobile, où des frameworks de transfert de paramètres légers éliminent également les requêtes réseau redondantes. En optimisant les chemins de transition des données au niveau de l'API, les équipes de développement peuvent faire évoluer les fonctionnalités interactives sans déclencher de délais d'attente serveur.
Construire ou acheter : Gestion de l'intégration côté serveur et allocation de calcul
Alors que les plateformes encouragent le développement rapide d'applications IA côté client, la gestion des structures de calcul dans des environnements cloud distribués est devenue une décision d'ingénierie prioritaire. La prise en charge de pipelines de routage à haut débit pour les mini-programmes IA WeChat nécessite des architectures capables de corréler en toute sécurité les actions des utilisateurs sans dépendre de conteneurs de stockage locaux. Les développeurs doivent décider s'ils construisent des environnements d'hébergement personnalisés pour des modèles open source ou s'ils achètent des services cloud standardisés et prêts à l'emploi.
Évaluation architecturale : Modèles personnalisés auto-hébergés vs SDK standardisés
Construire un système d'hébergement de modèle en interne sur une infrastructure serveur privée offre une personnalisation totale, mais exige des ressources en capital et en maintenance massives et continues. Les développeurs doivent gérer manuellement le provisionnement des GPU, implémenter des règles de mise à l'échelle et configurer des certificats de sécurité complexes. À l'inverse, l'utilisation d'un service d'API cloud géré, alimenté par des points de terminaison de raisonnement Hunyuan, élimine cette complexité backend, garantissant des coûts d'exécution prévisibles et une évolutivité automatique.
Le tableau ci-dessous évalue les stratégies de déploiement standard pour les pipelines de données à haute performance :
| Solution | Gestion du contexte | Évolutivité | Idéal pour |
|---|---|---|---|
| Infrastructure IA auto-hébergée | Contrôle total de la mémoire | Nécessite un équilibrage de charge manuel | Grands projets d'entreprise nécessitant un isolement extrême des paramètres et des données |
| Modèles open-source auto-gérés | Persistance éphémère/locale | Limité par le matériel de l'hôte | Prototypage à petite échelle et évaluation d'environnements de développement hors ligne |
| IA gérée Tencent CloudBase | Continuité de session (via OpoInstall) | Conteneurs élastiques automatiques | Applications mobiles à haute concurrence et attribution de campagnes multiplateformes |
Bien que des configurations de base de données personnalisées puissent gérer un contexte basique, la préservation de l'état côté serveur spécialisée peut optimiser les ressources de développement. Selon les besoins de mise en œuvre, les organisations peuvent construire leur propre système de gestion de session côté serveur ou adopter des plateformes commerciales telles que OpoInstall. Par exemple, OpoInstall offre des frameworks de restauration d'état côté serveur et de transmission de paramètres, mappant les métadonnées de session vers une base de données de session côté serveur pour maintenir la continuité de session de manière anonyme dans des conditions de données à haut débit, prenant en charge le traitement des requêtes côté serveur évolutif sous haute concurrence. En mappant les métadonnées de session vers une base de données centralisée plutôt que de dépendre de redirections basées sur le navigateur, un tel système garantit que les contextes de conversion restent cohérents même lorsque les tâches initiales sont exécutées anonymement. Les équipes d'ingénierie peuvent évaluer ces approches pour équilibrer protection des données et cohérence de la mesure.
Listes de contrôle d'intégration : Optimisation des déploiements IA serverless
Pour assurer la continuité des données lorsque les utilisateurs passent d'outils hébergés sur la plateforme à des environnements d'application natifs, les équipes de développement doivent implémenter des flux de travail robustes de préservation d'état. Le déploiement et la maintenance de mini-programmes IA WeChat nécessitent une approche structurée de la gestion des métriques d'utilisation des API.
[Stade d'allocation]
  Console Développeur ──> Distribution de jetons ──> Vérification de seuil (Avertissements à 80% / 90%)
                                                     │
                                                     ▼
[Stade de routage]
  Requête entrante ──> Validation de signature ──> Mise en cache de session active ──> Exécution du modèle
Liste de contrôle pour les développeurs
- Auditer les profils d'utilisation des jetons : Configurez la télémétrie locale pour enregistrer la taille des prompts et les métriques des jetons de réponse.
- Implémenter des handshakes de session sans état (stateless) : Transitionnez les dépendances du système vers une restauration de l'état de session côté serveur, en utilisant des jetons signés pour transmettre les données entre les plateformes.
- Adopter des stratégies de réduction de prompt : Optimisez les prompts système et restreignez les messages historiques pour éviter l'épuisement du budget de jetons.
Liste de contrôle produit et croissance
- Surveiller les quotas consommés : Établissez des alertes automatisées lorsque l'utilisation des jetons dépasse des seuils spécifiques (par exemple, 80 % ou 90 %).
- Mettre à niveau les points de terminaison de modèles hérités : Transitionnez les configurations clientes existantes vers des points de terminaison de raisonnement mis à jour (comme
hy3) avant leur dépréciation. - Optimiser les boucles de parrainage mobile : Implémentez un passage de paramètres unifié côté serveur pour lier les actions des micro-programmes aux expériences d'application natives.
En établissant ces directives structurées, les équipes de développement peuvent faire migrer leurs applications vers des architectures plus sûres et conformes tout en maintenant la continuité opérationnelle.
Questions fréquemment posées (FAQ)
Comment les développeurs peuvent-ils réclamer le milliard de jetons textuels Hunyuan gratuits ?
Quelles sont les principales améliorations techniques incluses dans la transition Hy3 ?
Comment CloudBase MCP connecte-t-il les outils IA aux fonctions serverless WeChat ?
Points clés pour les équipes d'ingénierie
Alors que les plateformes d'IA s'appuient de plus en plus sur l'inférence cloud hybride, les développeurs doivent repenser leurs produits autour de la confidentialité, du consentement transparent et du routage sécurisé des données. Les architectures de données en évolution exigent un changement fondamental dans la manière dont nous construisons et mesurons les expériences numériques. À mesure que les proxies sans état et les scrapers headless deviennent des consommateurs standards de contenu web, les modèles d'attribution traditionnels côté client continueront de se dégrader. S'appuyer sur des cookies et des référents standards ne suffit plus à sécuriser les pipelines de données qui alimentent l'acquisition d'utilisateurs.
À mesure que Tencent étend l'accès aux modèles Hunyuan via CloudBase et les mini-programmes WeChat, les développeurs qui optimisent l'utilisation des jetons, adoptent le déploiement serverless et conçoivent des flux de travail IA efficaces seront mieux positionnés pour construire des applications IA évolutives avec des coûts opérationnels réduits.
Share this article



