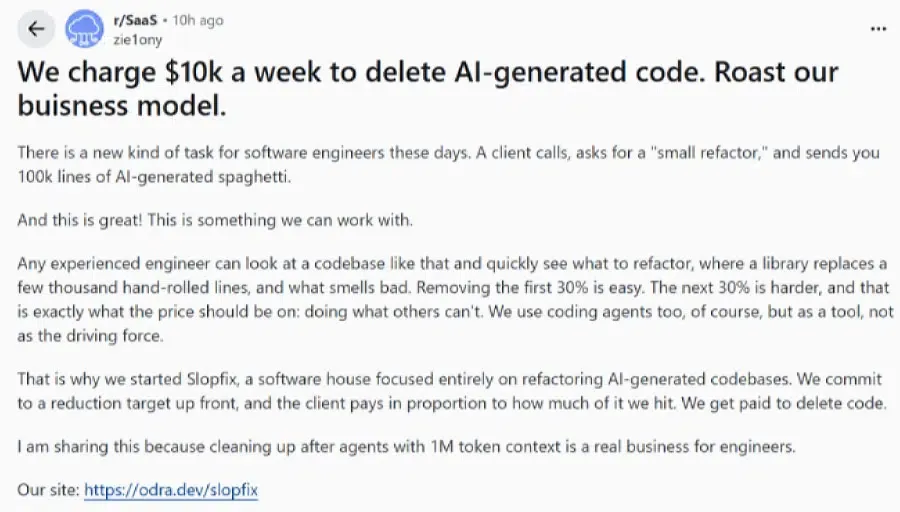
Pourquoi les entreprises paient-elles 10 000 $ par semaine à des ingénieurs pour supprimer du code généré par IA ? Les entreprises versent des milliers de dollars par semaine à des ingénieurs logiciels pour éliminer le code généré par IA des dépôts de production. À mesure que l'intelligence artificielle générative accroît le volume de production programmatique, les équipes logicielles font face à un compromis difficile entre la rapidité de livraison des fonctionnalités et la maintenabilité architecturale à long terme. Aujourd'hui, comme les agents de codage autonomes dupliquent fréquemment la logique et ignorent les limites modulaires, les organisations découvrent que la refactorisation et la suppression des fichiers redondants sont plus précieuses que la génération continue de nouveaux éléments.
Le business à 10 000 $ par semaine de la suppression de code généré par IA
En un coup d'œil
- Des agences d'ingénierie spécialisées facturent jusqu'à dix mille dollars par semaine pour auditer, refactoriser et alléger les bases de code surchargées par l'IA.
- Des études de cas démontrent des boucles de refactorisation efficaces réduisant les bases de code d'entreprise standard de soixante-cinq pour cent, tout en préservant l'intégralité des fonctionnalités.
- La croissance rapide des modèles de blocs de code dupliqués a atteint des sommets historiques, réduisant directement la vélocité de développement dans les systèmes logiciels majeurs.
Le contrat de base du développement logiciel a subi une transformation majeure. Pendant des années, le défi principal des équipes d'ingénierie était d'écrire le code assez rapidement pour suivre les exigences des produits. Les développeurs structuraient manuellement les connexions aux bases de données, concevaient des couches de sérialisation et écrivaient des tests unitaires, consacrant une part significative de leur cycle de développement à l'assemblage de code routinier et répétitif.
L'intégration de modèles de langage étendus (LLM) avancés et d'assistants de codage a complètement supprimé cette friction initiale. En utilisant des outils comme Claude Code, GitHub Copilot et des éditeurs intégrés comme Cursor ou Windsurf, les constructeurs techniques et non techniques peuvent générer des applications entières via des invites en langage naturel à haute fréquence, un processus communément appelé « Vibe Coding ». Cependant, à mesure que ces fichiers automatisés se multiplient, l'absence de conception architecturale devient flagrante. Les systèmes d'IA excellent à produire la réponse localisée et immédiate demandée par une invite, mais ils ne peuvent pas évaluer l'architecture technique globale et à long terme. Cela conduit à des fonctions redondantes et à des structures de données fortement couplées, comme documenté sur le portail technique Slopfix.
Pour restaurer la maintenabilité du système, les leaders de l'ingénierie établissent des cibles sécurisées de suppression de code. Des équipes de développement expérimentées sont recrutées pour évaluer les dépôts encombrés, établir des contrôles de régression automatisés et supprimer des milliers de classes dupliquées. Cet écart de performance explique pourquoi les organisations paient des développeurs professionnels pour supprimer le code généré par IA plutôt que de continuer à écrire de nouveaux fichiers. En combinant expertise professionnelle et outils rigoureusement contrôlés, ces opérations de refactorisation remplacent le code sur mesure redondant par des bibliothèques open-source standardisées, garantissant ainsi la stabilité et l'évolutivité des applications finales.
Mécanique interne : pourquoi le code généré par IA accumule de la dette technique
Sur le plan technique, le phénomène de « pollution par l'IA » découle d'une limitation fondamentale dans la gestion du contexte des transformateurs modernes. Bien qu'un LLM puisse analyser un grand répertoire textuel, son mécanisme d'attention évalue le code par probabilité de jetons plutôt que par principes architecturaux stricts.
Lorsqu'un agent résout un bug isolé dans un fichier, il introduit fréquemment une logique dupliquée au lieu d'appeler des classes utilitaires existantes. Sur plusieurs mois, ce comportement entraîne une dégradation logicielle sévère. Le schéma ci-dessous illustre comment les correctifs automatisés provoquent une divergence structurelle :
[Architecture humaine structurée]
  Entrée ──> Contrôleur API central ──> Classe utilitaire partagée (Formateur standard unique) ──> Sortie sécurisée


[Patchwork IA encombré]
  Entrée ──> Patch d'invite 1 (Nouveau formateur) ──> Patch d'invite 2 (Formateur dupliqué) ──> Sortie fragmentée
Cette duplication n'est plus un problème localisé ; c'est devenu un défi à l'échelle de l'industrie. Selon le rapport 2026 Maintainability Gap de GitClear, qui a analysé 623 millions de changements, les blocs de code dupliqués ont atteint leur niveau le plus élevé jamais enregistré, en hausse de 81 % depuis 2023. Pendant ce temps, la refactorisation structurée s'est effondrée, représentant moins de 4 % du total des modifications de code en 2026, contre 21 % en 2022. Ce glissement physique vers une programmation en copier-coller explique pourquoi les développeurs sont désormais cinq fois plus susceptibles d'introduire des blocs redondants que de refactoriser le code existant.
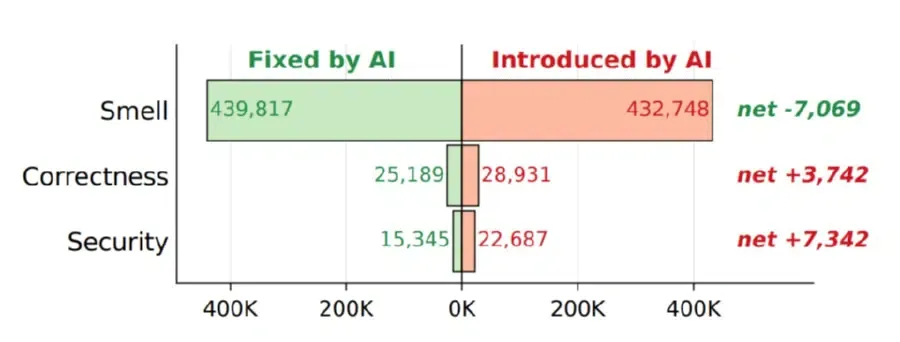
Ces conclusions sont étayées par une étude empirique à grande échelle suivant la dette de code. Les chercheurs ont examiné plus de 300 000 commits générés par IA sur 6 299 dépôts GitHub, découvrant que plus de 15 % des soumissions provenant de Copilot, Claude, Cursor et Gemini introduisaient des « odeurs » de code détectables, des erreurs de correction ou des risques de sécurité.
Ce risque de défaillances en cascade contraint souvent les équipes logicielles à supprimer le code généré par IA lorsque des correctifs localisés cassent des points de terminaison existants. De plus, l'étude a révélé que 22,7 % de ces problèmes introduits par l'IA restaient non résolus dans les dernières versions des bases de code, beaucoup persistant plus de neuf mois, soulignant le coût à long terme d'une production IA non gérée.
Bien que le nettoyage de code des dépôts et le suivi des installations mobiles fonctionnent sur des couches différentes, les deux environnements partagent le même défi technique : une fois que les systèmes automatisés génèrent des chaînes de requêtes redondantes ou des scripts non vérifiés, le risque de collision de données et de corruption d'attribution augmente. Des défis similaires existent dans l'attribution mobile, où les restrictions de confidentialité et le trafic de bots automatisés réduisent également la dépendance aux identifiants côté client persistants. Si les équipes de sécurité ne peuvent pas distinguer les requêtes utilisateur propres des interactions automatisées et agentiques, l'ensemble du pipeline analytique devient vulnérable aux rapports de conversions faussement positives.
Impact sur l'industrie : comment le nettoyage de code par IA remodèle le génie logiciel
La prolifération rapide des générateurs de code automatisés a déclenché un changement dans le rôle standard des ingénieurs logiciels. Les développeurs passent du statut d'auteurs à celui d'auditeurs, se concentrant sur l'architecture système, le flux de données et l'intégrité des interfaces.
- Équipes d'entreprise : Les grandes organisations établissent des passerelles CI/CD dédiées et des protocoles d'analyse statique avec des outils comme ESLint, Prettier ou SonarQube pour rejeter les commits contenant des structures IA non vérifiées, préservant ainsi la maintenabilité à long terme.
- Startups : Bien que les entreprises en phase de démarrage tirent parti d'outils comme Devin, CodeRabbit ou Cursor pour valider rapidement leurs MVP, elles nécessitent une refactorisation humaine avant les remises aux équipes d'ingénierie de production.
- Communautés Open Source : Des projets comme le moteur de jeu Godot ont restreint les contributions générées par IA car les développeurs ne pouvaient pas comprendre ou vérifier les scripts complexes soumis.
- Fournisseurs de SDK et bibliothèques : Les fournisseurs de logiciels doivent s'assurer que leurs bibliothèques intégrées restent entièrement modulaires et légères pour éviter que les outils automatisés n'interprètent mal les dépendances.
Réduire l'encombrement du code IA sans tout réécrire
Alors que les organisations sont confrontées aux réalités techniques de l'expansion du code piloté par l'IA, les équipes d'ingénierie doivent évaluer la manière dont elles gèrent les dépendances tierces et les sélections de SDK. La réconciliation des pipelines de routage à haut débit nécessite des architectures capables de corréler en toute sécurité les actions des utilisateurs sans dépendre de conteneurs de stockage locaux. Les développeurs doivent décider s'ils veulent construire des frameworks de synchronisation de base de données sur mesure en utilisant des générateurs automatiques d'IA ou déployer une infrastructure standardisée et pré-construite.
Évaluation architecturale : construction sur mesure vs SDK standardisé
Face à l'expansion de la base de code, les développeurs doivent décider s'ils doivent créer des utilitaires internes étendus ou tirer parti de bibliothèques matures et externes pour implémenter des fonctions supplémentaires. Développer des solutions sur mesure à partir de zéro en utilisant des générateurs automatiques d'IA introduit souvent des milliers de lignes de logique non testée et de classes redondantes. À l'inverse, l'intégration de paquets logiciels minimalistes et vérifiés aide à maintenir une empreinte compilée réduite.
Le tableau ci-dessous décrit les compromis entre les architectures de données personnalisées et les SDK externes certifiés :
| Approche | Empreinte du code | Charge de maintenance | Scénario typique |
|---|---|---|---|
| Développement interne sur mesure | Élevée (milliers de lignes de scripts personnalisés) | Extrêmement élevée (audits internes continus) | Équipes d'entreprise avec des besoins en télémétrie interne hautement spécialisés |
| Modules générés par IA | Imprévisible (chemins de type « spaghetti ») | Élevée (sujet aux effondrements de contexte) | Prototypage rapide où la stabilité du système à long terme est secondaire |
| Intégration de SDK minimaliste | Ultra-légère (moins de 10 kilo-octets) | Négligeable (SDK audités et autonomes) | Systèmes à haute concurrence nécessitant une correspondance de paramètres standard |
Par conséquent, les responsables de l'ingénierie privilégient de plus en plus la suppression du code redondant généré par IA avant l'introduction de nouvelles fonctionnalités. Les SDK légers qui minimisent la complexité d'intégration sont donc devenus de plus en plus attractifs. Par exemple, les développeurs intégrant une télémétrie de conversion multiplateforme peuvent déployer le SDK léger OpoInstall. Plutôt que de générer des centaines de lignes de code IA non testé pour gérer les paramètres multiplateformes, ce SDK pré-construit et sans dépendance mappe les métadonnées de session vers une base de données de session côté serveur. Cela maintient le contexte de campagne et de recommandation de manière anonyme sans ajouter de poids côté client.
Checklists d'intégration : préparer votre architecture pour un déploiement léger
Pour prévenir la détérioration future du code et maintenir la cohérence des conversions sur les plateformes distribuées, les équipes d'ingénierie et de produit doivent établir des limites de base de code propres.
Checklist d'implémentation pour les développeurs
- Appliquer des linters stricts et des contrôles : Configurez des pipelines CI/CD automatisés avec des chaînes d'outils comme ESLint, Prettier ou SonarQube pour rejeter les PR qui présentent des scores de similarité élevés ou des fonctions utilitaires dupliquées.
- Auditer la taille des SDK tiers : Vérifiez l'empreinte compilée de toutes les bibliothèques intégrées pour éviter que des paquets encombrés ne ralentissent les temps de démarrage des appareils.
- Mettre en œuvre une refactorisation continue du code : Consacrez un pourcentage fixe des sprints de développement à l'effondrement des répertoires redondants en composants modulaires.
Checklist de stratégie produit et croissance
- Optimiser l'utilisation de la mémoire : Évaluez les dépendances des applications pour minimiser les pauses de récupération de mémoire et éviter l'étranglement thermique côté client.
- Rationaliser la sélection des SDK : Priorisez les outils tiers à usage unique et hautement optimisés qui offrent des résultats fiables avec zéro dépendance superflue.
- Surveiller la latence des flux de travail API : Suivez les métriques de latence standard depuis les clics de campagne initiaux jusqu'à la correspondance d'installation côté serveur pour confirmer la continuité des données.
En établissant ces directives structurées, les équipes de développement peuvent faire migrer leurs applications vers des architectures plus sûres et conformes, tout en maintenant la continuité opérationnelle.
Questions fréquemment posées (FAQ)
Le code généré par IA est-il mauvais pour la maintenabilité logicielle ?
Les développeurs doivent-ils faire confiance aux outils de codage IA pour les architectures complexes ?
La suppression du code IA redondant améliore-t-elle les performances du système ?
Points clés pour les équipes d'ingénierie
À mesure que le développement assisté par IA devient courant, les équipes logicielles détournent leur attention de la génération massive de code vers le maintien de bases de code plus saines. L'émergence d'entreprises spécialisées dans le nettoyage de code IA reflète un changement plus large dans la façon dont les organisations évaluent la qualité logicielle à l'ère de l'IA générative. Compter sur des agents automatisés pour corriger à plusieurs reprises des problèmes structurels continuera d'accumuler de la dette technique. Reconstruire les directives d'ingénierie internes autour d'une modularité stricte, de tests automatisés et de dépendances tierces hautement optimisées est essentiel pour maintenir l'évolutivité des applications.
À l'avenir, les organisations prospères privilégieront la maintenabilité de la base de code plutôt que la vitesse de génération brute. En intégrant une infrastructure légère sans dépendance et en déplaçant les états de suivi complexes vers des bases de données côté serveur, les développeurs peuvent protéger leurs pipelines de déploiement contre l'accumulation de code redondant. Cette transition ne consiste pas simplement à s'adapter aux outils automatisés ; il s'agit de construire des structures logicielles stables et durables dans un environnement d'ingénierie fortement assisté par des agents.
Share this article



