GitHubがCopilot Fusionを発表?GitHubは2026年10月28日、ソフトウェアエンジニアリングタスクに向けて複数の人工知能モデルを協調させるランタイムモデルルーターおよびオーケストレータ「Copilot Fusion」の一般提供(GA)を正式に発表しました。サンフランシスコで開催された年次カンファレンス「GitHub Universe」で披露されたこのシステムは、個々の開発者によるモデル選択の負担を軽減し、プラットフォーム側がタスク要件を分析して、さまざまな基盤モデルに動的に作業を割り振る仕組みを実現しています。ソフトウェアエンジニアリングチームが、絶えず増加するAPIコストや、最先端モデルを頻繁に切り替えることによる認知疲労に直面する中、自動化されたモデルオーケストレータは標準的な運用アーキテクチャパターンとして浮上しつつあります。
業界の核心的な再編成:GitHub Universeで発表されたCopilot Fusion
概要
- GitHubは2026年10月28日、Visual Studio Code、Copilot CLI、JetBrains IDE、およびGitHub Copilotデスクトップアプリケーションを対象に、Copilot Fusionの一般提供を開始しました。
- このシステムは、「Project HydraFusion」から派生したランタイムのマルチモデル協調機能と、微調整された自動モデル選択アルゴリズムを統合しています。
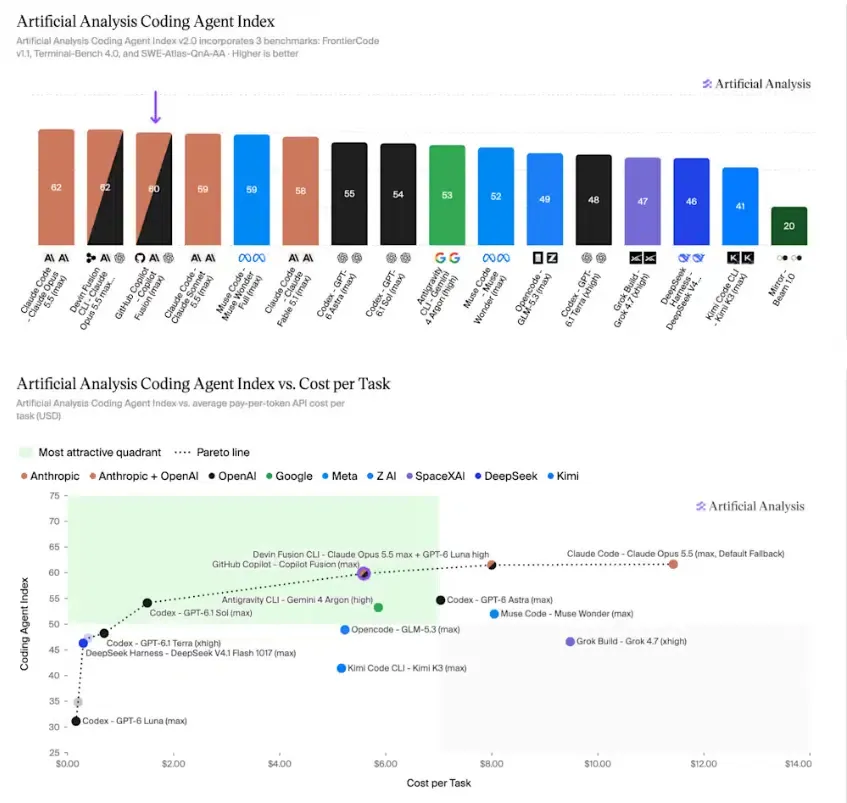
- Artificial Analysisによる独立した評価において、Fusion MaxはCoding Agent Index v2.0で60の総合スコアを記録し、Claude Code with Opus 5.5 Maxに2ポイント差まで迫りながら、タスクコストを約51%削減しました。
AIコーディングアシスタントを利用するソフトウェア開発チームはこれまで、手動による選択パラダイムのもとで運用を行ってきました。プログラマーは、GPT-4o、Claude Sonnet、o1シリーズの推論モデルなどの単一のモデルをIDEのドロップダウンメニューから選択し、コーディングセッション全体を通じてその選択を維持していました。個別のプロンプトに対しては有効であるものの、このパターンには運用のトレードオフが生じます。開発者は、複雑なアーキテクチャ設計には高価で高レイテンシな最先端モデルを選択する傾向がある一方で、単体テストの生成や定型ドキュメントの作成といった日常的なタスクを行う際にも軽量モデルに切り替えるのを忘れがちになります。
このような手動でのアプローチは、企業のAPI支出を膨らませ、コンテキストトークンを非効率に消費する原因となります。こうしたワークフロー上のトレードオフに対処するため、公式のGitHubの発表で概説されている通り、GitHubはCopilot Fusionを開発しました。AIコーディングを単一の静的なモデルとのインタラクションとして扱うのではなく、Fusionはランタイムコーディネーターとして機能します。開発者は全体的な推論の労力レベル(effort level)を指定し、システムはタスクの各ステップに応じて最も適切な下位モデル、またはモデルの組み合わせを自律的に選択します。

GitHub Launches Copilot Fusionのリリースが示す戦略的なピボットは、単なるパラメータの規模拡大ではなく、タスク単位の経済性に焦点を当てています。Artificial Analysisが公開したベンチマーク評価によると、Coding Agent Index v2.0上でCopilot CLIを介してテストされたCopilot Fusion Maxは、平均して1タスクあたり5.59ドルのコストでベンチマークのコーディング課題を完了しました。これに対し、AnthropicのClaude Opus 5.5を最大設定で実行したClaude Codeでは1タスクあたり11.42ドルかかりました。評価された構成では1タスクあたり約720万トークンを消費し(これは単体のOpus構成のトークンボリュームの約半分)、タスクを約40%短い時間で完了させました。
個別のベンチマークコンポーネントによってパフォーマンスは異なります。Fusion MaxはTerminal-Bench 4.0で71点のスコアを記録して首位に立ったものの、FrontierCodeでは51点(Claude Codeの56点に劣る)、SWE-Atlas-QnA-AAでは57点となりました。さらに、マイクロソフトのリーダーシップが引用した内部のDeepSWE評価では最大77%のコスト削減の可能性が示されているものの、この数値は独立したベンチマークの平均値ではなく、企業が独自に報告した最大限のシナリオを表しています。これらの結果は、動的なマルチモデルオーケストレーションがサポート対象のワークフローにおいて開発コストを大幅に引き下げられることを裏付けていますが、実際の削減効果は特定のタスクの組み合わせ、レビューの要件、およびエンタープライズでの利用パターンによって変動します。
アーキテクチャパターン:単一、カスケード、および批評の実行トポロジ
Copilot Fusionは、独立した基盤モデルとして動作するわけではありません。その代わり、開発者クライアント内に組み込まれたインテリジェントなコントロールプレーンとして機能します。ユーザーが推論、コード生成、デバッグ、またはツールの使用を伴う指示を送信すると、Fusionはリアルタイムのシステムの健全性、可用性、およびセマンティックな複雑さに対して、入力された意図シグナルを評価します。
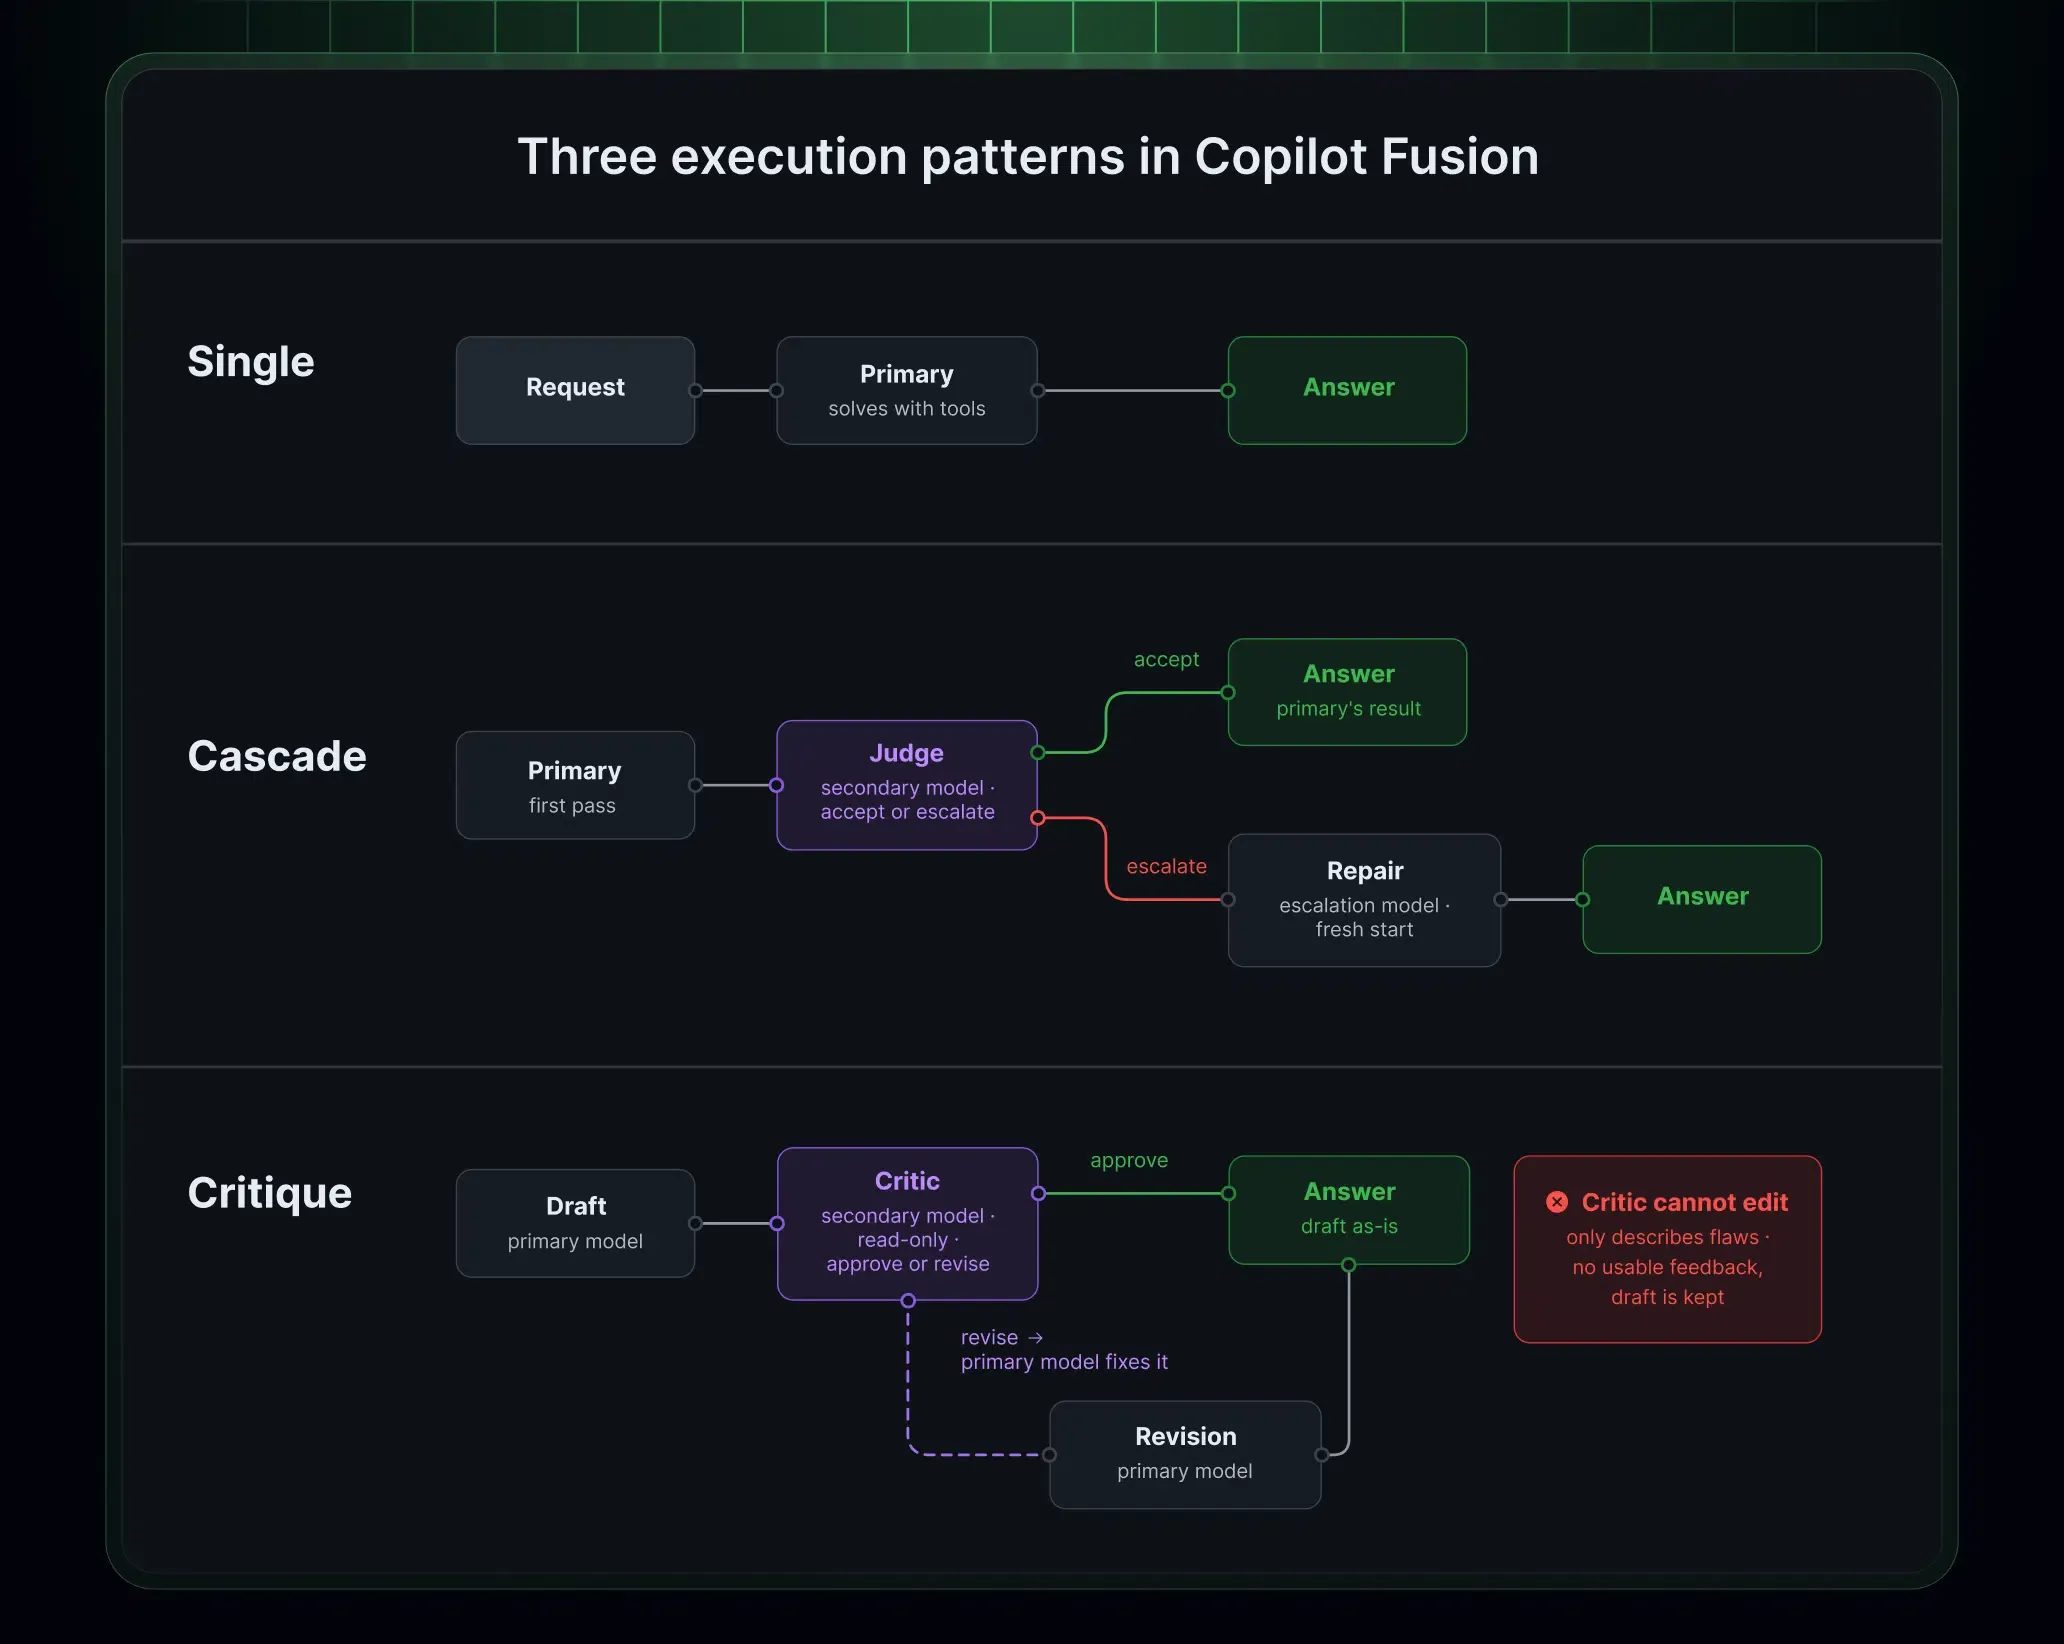
タスクの特性や選択された労力ティアに応じて、システムは以下の3つの実行パターンから動的に選択します。
- 単一パターン(Single Pattern):単一のモデルがプロンプトを受け取り、レビューのオーバーヘッドを一切追加することなく直接タスクを完了します。このパターンは、分かりやすいコード生成、構文に関するクエリ、および基本的なリファクタリングに適しています。
- カスケードパターン(Cascade Pattern):軽量モデルが初期のドラフトを作成します。二次的なジャッジモデルが提案されたコードを検査し、出力を受け入れるか、あるいは洗練されたパスを実行するためにより能力の高いモデルにタスクをエスカレーションするかを決定します。
- 批評パターン(Critique Pattern):プライマリモデルが初期の応答を作成する一方で、1つまたは複数のレビューアーモデルが並行して独立したコード評価を行います。オーケストレータがそれらのフィードバックを集約し、最終的な出力をユーザーに返す前にプライマリモデルがそれに応じてコードを修正します。
[Single Pattern]
  Prompt ──> Primary Model ──> Single Execution ──> Final Code Output

[Cascade Pattern]
  Prompt ──> Lightweight Model ──> Initial Draft ──> Judge Model ──[Accept]──> Final Code Output
                                                         └──[Escalate]──> Stronger Model ──> Final Output

[Critique Pattern]
  Prompt ──> Drafting Model ──> Initial Draft ──┬─> Reviewer Model A ──┐
                                                └─> Reviewer Model B ──┴─> Feedback Aggregator ──> Final Revision
これらの実行トポロジは、実行速度、検証の厳格さ、および計算コストの間に明確なトレードオフをもたらします。プロンプトを特定のパターンにハードコードする代わりに、GitHubは選択可能な労力レベル全体にわたってこれらのワークフローをマッピングしています。
- Fusion Standard:日常的なコーディングにおいて、コスト、品質、レイテンシのバランスを取ります。現在の実装では、通常タスクごとに1つのモデルが選択されます。
- Fusion High:トークンの効率性を考慮しつつ、大規模なコーディングタスクに向けてより強力な能力と深い推論を優先します。必要に応じてマルチモデルオーケストレーションが使用されます。
- Fusion Max:最も要求の厳しいタスクに対して最先端レベルの能力を優先し、有用な場合には追加のレビューやエスカレーションのステップが動的に選択されます。
- Fusion Fast:レイテンシに敏感なVisual Studio Codeのインラインチャットシナリオでサポートされている、ユーザーが選択できない特殊な労力レベルです。
動的なワークフロー全体にわたるコンテキスト境界の管理には、特化したメモリ処理が必要です。Copilot Fusion自体は、単一の統一されたコンテキストウィンドウを持っているわけではありません。その代わり、各実行ステップは、そのサブタスクを実行する特定のモデルのコンテキスト制限の範囲内で厳密に動作します。IDEに表示されるコンテキスト容量は、参加しているモデルの中で最も保守的な制限を反映したものとなります。さらに、プロンプトのキャッシュ効率を最大化するため、Fusionは可能な限り単一のプライマリモデル上でメインの会話スレッドを維持し、支援するレビューアーモデルには必要な孤立したコンテキストウィンドウのみを渡します。
企業ガバナンスと開発者フリート全体でのローカルモデル統合
大規模な企業のエンジニアリング組織全体に自律的なモデルオーケストレーションを導入する際には、ガバナンス、コンプライアンス、および予算に関する考慮事項が生じます。AIシステムがAnthropicやOpenAIなどのプロバイダーのモデル間を動的に選択する場合、管理者は組織のデータレジデンシーやセキュリティルールが確実に維持されるようにする必要があります。
Copilot Fusion管理マニュアルに記載されているように、エンタープライズ管理者は、サポートされているGitHub Copilotモデルポリシーおよびエンタープライズ管理設定を通じて、Copilot Fusionの対象となるモデルを管理できます。管理者は、Fusionで使用可能なモデルのロースターの確認、開発者のシート全体でのデフォルトの労力レベルの設定、および企業全体で無効化することなくFusion用の特定のモデルを無効化することが可能です。Fusionは、該当するサブスクリプション、組織、データレジデンシー、FedRAMP関連、および評価モデルの制限を尊重します。これらのコントロールはシステム内のモデル適格性を管理するものであり、組織独自のコンプライアンスレビュー、データガバナンス、またはセキュリティ検証プロセスに代わるものではありません。
以下の表は、さまざまな実行アーキテクチャが実行サーフェス、レビューメカニズム、およびトークン支出プロファイルの間でどのようにバランスを取っているかを示しています。
| 実行パターン | プライマリ呼び出し | レビューメカニズム | トークンコストプロファイル | 最適な用途 |
|---|---|---|---|---|
| シングルモード | 専用モデル1つ | なし | ベースラインの標準モデル価格 | わかりやすいコード編集と構文に関する質問 |
| カスケードモード | 効率的なドラフト作成モデル | ジャッジモデルによる検査とエスカレーション | 低~中程度(条件付きエスカレーション) | 範囲が明確なバグ修正と構造化された変更 |
| 批評モード | プライマリジェネレータ | 並行して動作する独立したレビューアーモデル | 高(複数の同時モデル呼び出し) | 複雑なアーキテクチャロジックとセキュリティ機密性の高いコード |
| ローカルモデルハイブリッド | サポートされているローカルデバイス上モデル | クラウド協調型モデル選択 | ローカルステップにおけるクラウドトークン消費の削減 | クラウド協調型ルーティングによる適切なオンデバイス推論 |
ローカルモデル選択に関するGitHub Changelogで発表されているように、GitHubはオプトインの実験的プレビューとしてローカルモデル認識型ルーティングを導入しました。サポートされているローカルモデルが構成されている場合、Copilot Fusion Standardは適格なタスクに対してオンデバイス推論を選択し、それらのステップにおけるクラウドモデルの使用量を削減できます。互換性のあるハードウェアを搭載したWindowsシステムでは、開発者はCopilotアプリ、Copilot CLI、またはVisual Studio Code内のWindows ML管理を通じてMAI Code 1.1 Flashをインストールして実行できます。Windows、macOS、Linuxのクロスプラットフォームユーザーは、Ollamaなどのローカルモデルプロバイダーを使用してCopilot CLIでQwen3.8 Flash Nextなどのローカルモデルを構成し、--experimentalフラグを指定してCLIを起動できます。
ただし、Copilot Fusionは引き続きクラウドベースのルーティング判断に依存しており、必要に応じてタスクでクラウドモデルが使用される場合があります。したがって、ローカルモデルのサポートによってCopilot Fusionが完全にオフラインのコーディング環境になるわけではありません。エアギャップされたセキュリティを必要とする開発者は、代わりに専用のオフラインツールを評価する必要があります。
エンジニアリングチェックリスト:本番環境へのマルチモデルオーケストレーションの導入
マルチモデルランタイムオーケストレーションをソフトウェア開発ワークフローに統合するには、開発者の習慣、IDEの構成、および企業の財務運営全体にわたる調整が必要です。エンジニアリングリーダーは、ワークフローの落とし穴を回避しながらトークンの効率性を最大限に高めるために、明確な運用プロトコルを確立しなければなりません。
開発者向け実装チェックリスト
- コミット前にワークスペースの差分を検査する:AIのドラフトを破棄しても、ワークスペースファイルの変更が自動的に元に戻るわけではありません。開発者は、コードを送信する前に、すべての未コミットのファイル編集内容をレビューする必要があります。
- タスクの複雑さに労力レベルを合わせる:Fusion Maxは複雑なアルゴリズムロジックやセキュリティ監査のために温存し、不必要なAIクレジットの消費を防ぐために日常的なコーディングにはFusion Standardを利用します。
- マルチモデルの進捗ストリームを監査する:IDEの進捗インジケーターを観察して、生成されたコードブロックにどの特定のモデルが貢献しているかを検査し、実行ステップ全体にわたる透明性を確保します。
- サポートされているローカルモデルを構成する:Fusion Standardでの適格なタスクに向けて、Windows上のMAI Code 1.1 FlashやOllama経由のQwen3.8 Flash Nextなどのサポートされているローカルモデルを設定し、必要に応じて実験的設定を有効にします。
エンタープライズガバナンスとFinOpsチェックリスト
- エンタープライズモデルポリシーを構成する:エンタープライズダッシュボードでFusionルーティングの対象となるモデルを指定し、モデルのロースターを企業のコンプライアンスおよびデータレジデンシーの要件に合わせます。
- 使用量ベースのAIクレジットを監査する:労力ティア全体にわたるチームレベルのクレジット消費を追跡します。Fusion HighおよびMaxでのマルチモデル実行は、単一モデルの実行よりもタスクあたりのクレジットを多く消費する可能性があることを考慮に入れます。
- プロモーション課金ウィンドウを考慮する:運用経費のベンチマークを行う際、2026年11月30日までの有料Copilotサブスクライバーに対するモデルコストのGitHubの30%プロモーション割引を織り込みます。
- 人間のコードレビューゲートを確立する:エージェントによって生成されたすべてのプルリクエストに対して必須のピアコードレビューを維持し、自動化された批評ループが人間のエンジニアリングの監視に取って代わるのではなく、それを補完するようにします。
よくある質問(FAQ)
Copilot Fusionが複数のモデルを呼び出す場合、GitHubはどのように請求を計算しますか?
Copilot Fusionが中間コードのドラフトを破棄した場合、どうなりますか?
エンタープライズ管理者は、Copilot Fusionが選択するモデルを制限できますか?
エンジニアリングチーム向けの主要なポイント
GitHub Copilot Fusionの登場により、複雑なソフトウェアエンジニアリングタスクのために単一のモノリシックなAIモデルに依存することが、不必要な運用のトレードオフを招くことが裏付けられました。現代の開発ワークフローには、瞬時の構文補完から複雑なリポジトリ間推論に至るまで、多様な認知的要求が含まれています。単一のモデルアーキテクチャにこのスペクトル全体を強制的に処理させると、モデルの支出の増大や実行品質の低下につながる可能性があります。
独立したベンチマーク結果は、マルチモデルオーケストレーションが特定のワークロードに対して、より低いモデルコストで競争力のあるコーディングパフォーマンスを提供できることを示唆しています。実際の成果は、タスクの複雑さ、オーケストレーションの挙動、選択されたモデル、および組織の利用パターンによって異なります。タスクの委任を開発者の手動選択から切り離すことにより、ランタイムモデルオーケストレーションは実用的な運用への道筋を確立します。ソフトウェアエンジニアリング組織が自動化されたコーディングエージェントを拡張するにつれて、主要な競争力の差別化要因は、個別の基盤モデルへのアクセスではなく、それらを接続するオーケストレーション層のガバナンス、信頼性、およびアーキテクチャの厳格さとなります。
参考文献
-
GitHub: Route and Orchestrate Models with GitHub Copilot Fusion — GitHub Universe 2026からの公式リリースノートと機能概要。
-
GitHub: Copilot Fusion Now Supports Selection of Local Models — ローカルモデルルーティングによる適格タスクのオンデバイス推論を詳述する公式発表。
-
GitHub Docs: About GitHub Copilot Fusion Concepts and Configuration — 実行パターン、労力レベル、請求ルールを詳述する公式技術ドキュメント。
-
GitHub Docs: Configuring Models Available for Copilot Fusion — エンタープライズモデルポリシーとデフォルト設定を管理するための管理者向けガイダンス。
-
Artificial Analysis: GitHub Copilot Fusion Benchmark Evaluation — タスクコスト、トークン効率、Coding Agent Indexスコアを測定した独立分析。
-
The New Stack: GitHub Debuts Copilot Fusion Multi-Model System — Project HydraFusionの統合とエンタープライズ顧客の実装に関する技術報道。
-
VentureBeat: GitHub Copilot Fusion Mixes Models for Cost Efficiency — コスト効率のためにモデルを混合するランタイムルーティングアーキテクチャについて取り上げたGitHubプロダクトリーダーシップへの技術インタビュー。
Share this article



