GoogleがGemini 4 Hydrogenを発表?Google DeepMindは2026年11月12日、日常的なソフトウェアエンジニアリングやマルチステップのエージェントワークフローに向けた、コスト効率とスループットに優れたシステムとして「Gemini 4 Hydrogen」を正式に発表しました。詳細については、公式のGoogle DeepMindの発表をご覧ください。ソフトウェア開発チームがリポジトリの探索やテストの実行に自律型エージェントを導入するケースが増える中、最先端の高度な推論モデルだけに依存し続けると、顕著なレイテンシや累積的なAPIコストが発生します。複雑なシステム設計には深いアーキテクチャ上の推論が不可欠である一方、小規模なコード修正の記述、テストハーネスの実行、ビルドログの解析といった日常的なエンジニアリングタスクには、迅速な実行が求められます。Hydrogenは、大規模開発向けの単体ツールとしても、マルチモデルルーティングパイプラインにおいて最先端モデルと組み合わせる実行エンジンとしても機能するように設計されています。
業界の主要な再編成:高スループットワークフローに向けたGemini 4 Hydrogenの発表
概要
- Google DeepMindは、日常的なコーディング、リポジトリのQ&A、エージェントワークフローを最先端モデルよりも低レイテンシで処理するために設計された高スループットモデルとして、Gemini 4 Hydrogenを導入しました。
- このモデルは、入力と出力の間で共有される1,048,576トークンの統合コンテキストウィンドウ内で動作し、価格設定は入力100万トークンあたり1.50ドル、出力100万トークンあたり7.50ドルとなっています。
- 提供範囲は、Google AI Studio、Gemini API、Android Studio、Google検索、エンタープライズプラットフォームに及び、アクセス階層は無料の一般向けプランから有料の開発者ワークスペースまで多岐にわたります。
ソフトウェアエンジニアリングワークフローの運用の要件は、単一プロンプトによるコード補完の域を超えて進化しています。現代のエージェント型セットアップでは、ディレクトリ構造の読み込み、依存関係ツリーの検査、パッチの提案、回帰テストの実行など、数十の自律的なステップがトリガーされることがよくあります。開発者がすべてのルーチンアクションを最先端の推論モデル経由でルーティングすると、タスクの実行速度が大幅に低下します。反復的な環境においては、個々のツール呼び出しにおける中程度のレイテンシであっても、自動化された開発サイクル全体にわたって長い遅延へと蓄積される可能性があります。
このローンチを巡る業界の議論は、本番環境のスケーラビリティにとってモデルの特化が不可欠であるという認識の高まりを反映しています。すべての開発タスクのデフォルトの選択肢として単一の汎用モデルを扱うのではなく、チームは階層型アーキテクチャを評価しています。これらの構成では、高容量の推論モデルがシステム設計や曖昧な問題のフレーミングを管理し、専用の実行モデルが反復的なコードベースの操作を担当します。GoogleはHydrogenをこの運用階層に対応させるべく設計し、標準的なAPIエンドポイントやプログラミング環境を通じて即座に開発者が利用できるようにしました。
Gemini 4 Hydrogenのベンチマーク分析と技術的な境界
Googleは、HydrogenがGemini 4 Carbonを適応させたものであると説明しています。しかし、公開されている技術文書には、重み転送メカニズム、トークナイザーアーキテクチャ、または蒸留パイプラインに関する具体的な内部詳細は開示されていません。したがって、技術的な評価は、推測される内部の仕組みではなく、観測可能なベンチマークデータ、文書化されたコンテキストの境界、および報告されている運用上の制約に焦点を当てる必要があります。
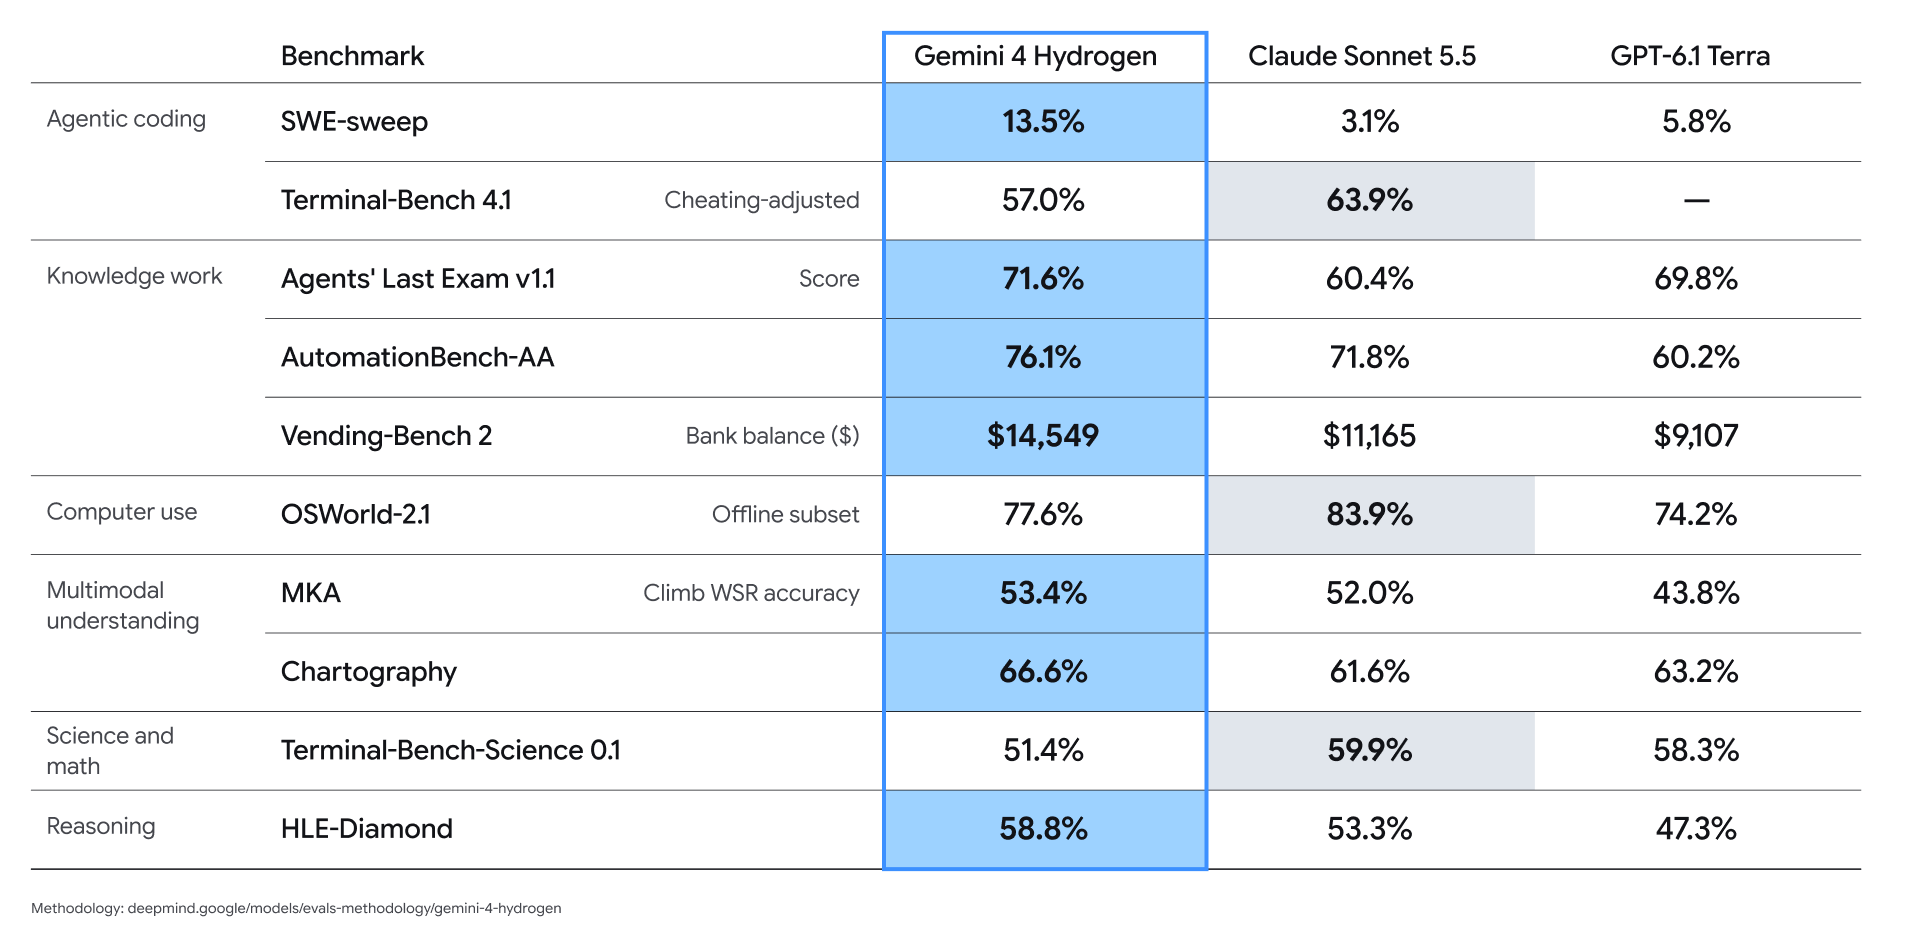
Gemini 4 Hydrogenモデルカードで報告されている標準的な評価において、Hydrogenはタスクカテゴリ全体で明確なパフォーマンスの違いを示しています。課題解決に関するSWE-sweepベンチマークでは、指定された評価条件の下で、GoogleはHydrogenの解決率を13.5%と報告しており、Claude Sonnet 5.5の3.1%、GPT-6.1 Terraの5.8%と比較して高い数値となっています。一方、不正調整パラメータに基づくTerminal-Bench 4.1では、Hydrogenは57.0%を達成し、Gemini 3.8 Flash(18.2%)から大幅に改善したものの、63.9%を記録したClaude Sonnet 5.5には一歩譲る結果となりました。独立したArtificial Analysisインテリジェンスインデックスでは、デフォルトの「high thinking」設定で51、「xhigh」設定で54のスコアを記録し、フラッグシップモデルであるGemini 4 Argonの50と比較して優れた結果を示しています。
Google Cloudモデルドキュメントに記載されているように、モデルのコンテキスト容量は重要なアーキテクチャ上の検討事項です。Hydrogenは、すべての入力と出力の間で共有される1,048,576トークンの統合コンテキスト上限を提供します。これは、広範な入力ファイルによって、モデルの出力に使用できる残りのトークン容量が減少することを意味します。単一のフォアグラウンドセグメントは最大65,536個の出力トークンをサポートします。より長い生成には、SDK管理による継続、カスタムの継続トークンループ、または利用可能な場合はサーバー管理によるバックグラウンド実行など、サポートされている継続メカニズムを使用します。すべてのセグメントは共有コンテキスト制限の対象となります。出力トークンには、内部推論トークン、生成されたツールリクエスト、および表示されるテキストが含まれます。
[Google Antigravityにおけるマルチモデルオーケストレータのアーキテクチャ]
                         ┌────────────────────────┐
                         │  Gemini 4 Carbon/Argon │ (アーキテクチャ設計と複雑な推論)
                         └───────────┬────────────┘
                                     │ タスクの委任と計画のレビュー
                                     ▼
                         ┌────────────────────────┐
                         │   Gemini 4 Hydrogen    │ (並列コード生成とツール呼び出し)
                         └───────────┬────────────┘
                                     │ 構造化されたツールの呼び出し
                                     ▼
                [ ローカルランタイム / テストスイート / ファイルシステム ]
レイテンシと分析の深さのバランスを取るため、Hydrogenには4つの構成可能な推論レベル(low、medium、high(デフォルト)、xhigh)が組み込まれています。低い設定では単純な構文調整に対する応答レイテンシが短縮され、高い設定ではより多くの内部推論トークンが割り当てられてエッジケースが評価されます。開発者は、文書化された制限事項が残っていることに注意する必要があります。モデルの知識カットオフは2026年3月であり、重いバックグラウンド処理中に一時的なタイムアウトが発生する場合があり、曖昧なプロンプトに対してはハルシネーションや過剰な拒否が発生する可能性があります。
分離されたシステムとマルチモデルオーケストレーションのトレードオフ
マルチモデルオーケストレーションにより、開発プラットフォームはエンジニアリングワークフローを異なるモデル階層に分割できます。このパターンでは、複雑なシステムモデリングとセキュリティ評価が最先端の推論モデルに委任され、具体的なコード編集とテストの表明が高速な実行モデルに割り当てられます。
Googleは、Google Antigravityの実験的オーケストレータを使用してこのアプローチを評価しました。Terminal-Bench 4.0でのテストにおいて、CarbonとHydrogenの間で動的な切り替えを行うことで、Carbon単体の実行と比較して、クォータ消費量を24%削減し、タスクを19%高速に完了させながら、Carbonに近いタスク成功率を達成したとGoogleは報告しています。また、Googleは、一部のワークフローにおいて、Gemini 3.8 Flashよりも2倍〜2.8倍高速な実行と12%〜23%少ないトークン使用量を示す初期のパートナーテスト結果も報告しています。たとえば、Box社は約2倍高速な実行と、複雑な文書および表のタスクにおける12%少ないトークン数を報告しました。これらのベンダーが報告した例は特定の統合設定を反映したものであり、すべての本番環境のデプロイメントにおける節約の制御された見積もりを表すものではありません。
| システムコンポーネント | 代表的なツール | 定義された責任 | 運用範囲と制限 |
|---|---|---|---|
| システムコーディネーター | Gemini 4 Carbon / Argon | 高レベルのアーキテクチャ設計、クロスリポジトリ計画、複雑なロジック評価 | 高い推論能力。トークンあたりのコストが高く、生成レイテンシが長くなる |
| 実行エンジン | Gemini 4 Hydrogen | ローカライズされたコード生成、自動ファイル編集、迅速なツール呼び出しループ | 高い生成スループット。単体でもコーディネーターの下でも動作可能 |
| 検証ゲート | ユニットテストハーネス / 静的リンター | 決定的ルールチェック、構文検証、回帰テスト | 定義されたアサーションと静的ルールをチェック。保証はテストの品質、カバレッジ、および独立したレビューに依存する |
マルチモデルアーキテクチャを評価する際、エンジニアリングチームはシステムの複雑さと実行効率のバランスを取る必要があります。動的なモデルルーティングにより、反復的なタスクでのトークン支出を削減できる一方で、オーケストレーションのオーバーヘッド、サブエージェント間の状態同期の課題、ルーティング分類器への依存性が生じます。エンジニアリングチームは、これらのトレードオフを、自身のタスク分布、リポジトリ構造、およびAPIレイテンシの要件に照らし合わせて測定する必要があります。
エンジニアリングの実装とワークフローガバナンスのチェックリスト
Gemini 4 Hydrogenを自動化された開発者ツールチェーンに統合するには、明確な実行境界、トークン監視、および防御的なエージェントガバナンスが必要です。
開発者の実装チェックリスト
- 思考レベルを運用タスクに合わせる:ワークロードの複雑さに応じて推論エフォートパラメータを設定します。複雑なアルゴリズムのエッジケースには
xhighを予約し、リポジトリ探索の標準的なベースラインとしてhighを維持し、コードの再フォーマットや単純なドキュメント検索などのレイテンシに敏感なタスクにはmediumまたはlowを使用します。 - 並列ツールインターフェースを構造化する:ランタイムでサポートされている場合は、バッチ化された引数を受け入れるようにツール定義を設計し、ワーカーエージェントが順次ラウンドトリップを行うのではなく、統合されたリクエストで複数のファイルの検査や構文チェックを要求できるようにします。
- モデルの生成を実行から分離する:モデルがツール呼び出しやコード修正を構造化データとして提案する一方、隔離されたクライアントランタイムまたはコンテナ化されたテストランナーがコマンドを実行し、可能な限り実行結果と再現可能な証拠を返すようにします。
エンタープライズガバナンスチェックリスト
- セッションロギングを確立する:ツールリクエスト、実行結果、権限の決定、コード変更、テスト結果、および利用可能なモデルサマリーをログに記録します。推論サマリーを完全または信頼性の高い実行トレースとして扱わないでください。
- 階層型セキュリティコントロールを適用する:外部ドキュメント、課題トラッカー、プルリクエストのコメントを信頼できない入力として扱います。HydrogenはGray Swanの間接的プロンプトインジェクションベンチマークで2.3倍の耐性向上を示しましたが、自動化された入力サニタイゼーションと実行権限ゲートは依然として必要です。
- 累積トークン消費量を監視する:選択したAPIの使用状況フィールドを使用して、思考トークンを含む入力トークンと課金対象の出力トークンを追跡します。請求される出力合計にすでに含まれている思考トークンを再度追加しないでください。
よくある質問 (FAQ)
本番ワークロードにおいて、Gemini 4 HydrogenはCarbonおよびArgonとどのように比較されますか?
4つの思考レベルとは何ですか?また、開発者はどのような場合に xhigh を使用すべきですか?
100万トークンのコンテキストウィンドウ全体で、フラットな価格モデルはどのように機能しますか?
エンジニアリングチーム向けの重要なポイント
本番環境に自律型コーディングツールを導入するには、開発チームが最先端のベンチマークスコアの先を見据え、反復的なツール実行の経済性に焦点を当てる必要があります。すべてのルーチンコード変更を高レイテンシの推論モデル経由でルーティングすると、不必要な運用の遅延と予算の膨張を招きます。同時に、実行レイテンシとタスク成功率を管理するには、ベンチマークスコアやエラー回復の動作について現実的な期待を持つことが求められます。
高容量の推論モデルと、高速で予測可能な実行エンジンを組み合わせた階層型アーキテクチャを確立することで、エンジニアリング組織は自動化された開発ワークフローを持続的にスケールさせることができます。disciplined なマルチモデルルーティング、構造化されたテスト境界、および厳格な入力検証を実装するチームは、堅牢で保守性の高いAI支援ソフトウェアパイプラインを構築する上で最も有利な立場に立つことになります。
参考文献
-
Google DeepMind. Introducing Gemini 4 Hydrogen. 公式発表.
-
Google DeepMind. Gemini 4 Hydrogen Model Card. 技術仕様および安全性レポート.
-
Google Cloud. Gemini 4 Hydrogen Model Documentation. 技術リファレンス.
-
Google Antigravity. Gemini 4 Hydrogen in Google Antigravity. マルチモデルオーケストレーションの概要.
-
Artificial Analysis. Gemini 4 Hydrogen Intelligence and Latency Benchmark. 独立したAI評価.
-
Ars Technica. Google Rolls Out Gemini 4 Hydrogen, Finally Replacing 3.8 Flash. 技術分析.
Share this article