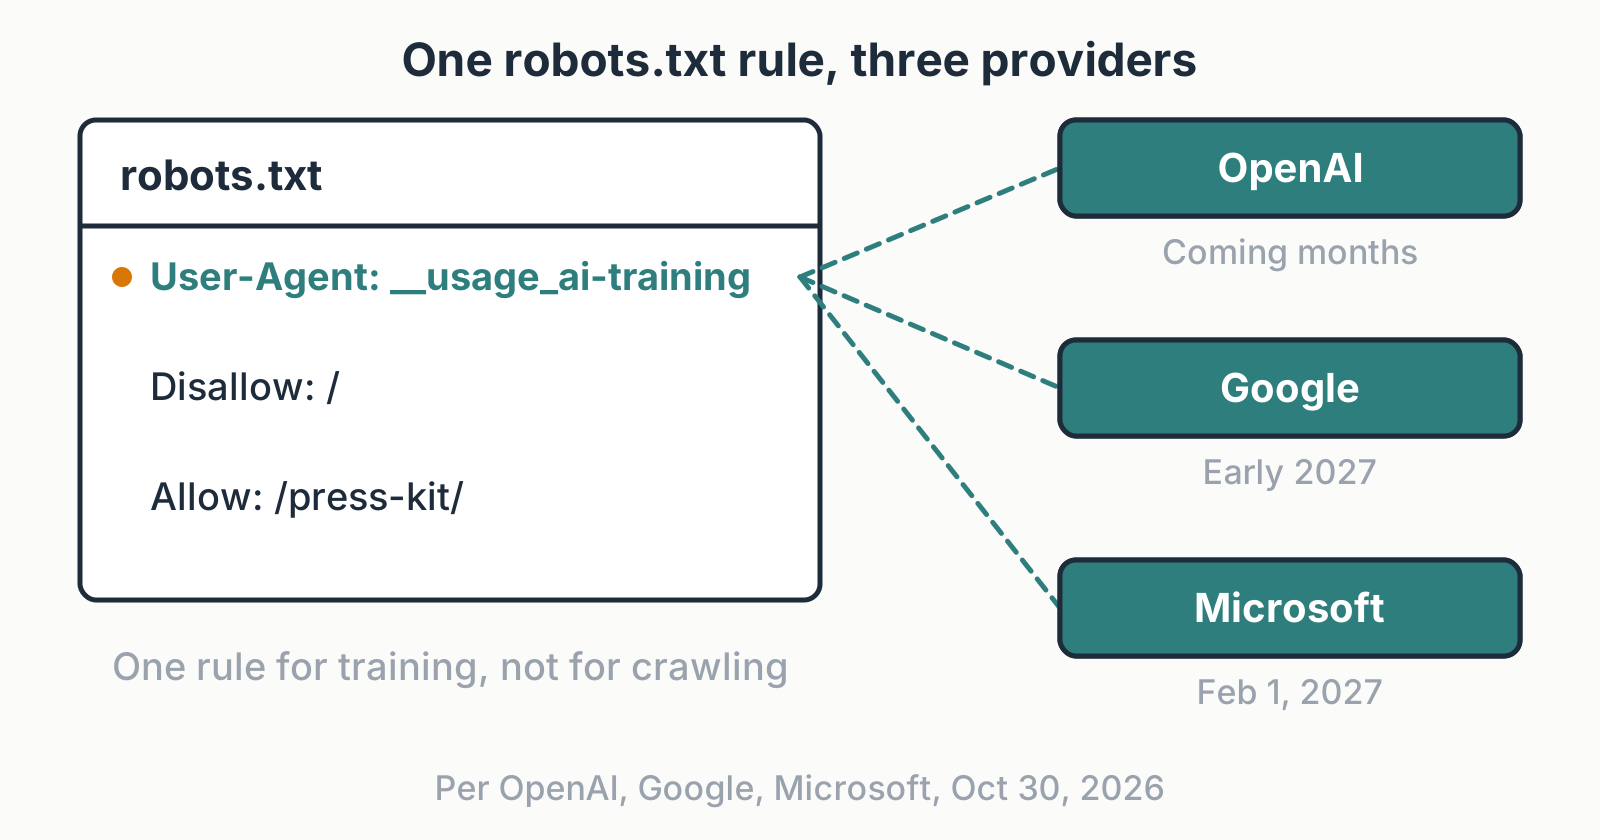
OpenAIとGoogleがAI学習の共同オプトアウトを支持?OpenAI、Google、Microsoftの3社は2026年10月30日、複数のプロバイダーにわたる生成AIモデルの学習設定をウェブサイト運営者が同時に表明できるようにする、robots.txt内の共通ポリシーシグナルを尊重する計画を発表しました。この提案されたメカニズムは、Anthropicのエンジニアであるケビン・ケリー(Kevin Kelley)氏がIETFのAI Preferencesワーキンググループに提出した個人のインターネットドラフト(Internet-Draft)に端を発しています。このイニシアチブにより、パブリッシャーは標準的なAllowおよびDisallow構文を使用して学習オプトアウトを宣言する効率的な手段を得られる一方、実装のタイムラインは2027年に向けて段階的となっており、各主要プラットフォームはモデルの学習とリアルタイムの会話型グラウンディングにわたって、このシグナルの解釈および適用を個別に進める予定です。
業界の主要な再編:主要AIラボがrobots.txt標準で協調
概要
- OpenAI、Google、Microsoftは2026年10月30日、生成モデルの学習設定を管理するための共通robots.txtポリシーシグナルである
__usage_ai-trainingを認識する協調計画を発表しました。 - このシグナルは、Anthropicのエンジニアであるケビン・ケリー氏が作成した個人のIETFインターネットドラフトで定義されており、公式または最終的なIETF RFC標準を表すものではないものの、標準化された構文を確立しています。
- プラットフォームの導入スケジュールは大きく異なり、Anthropicはすでに内部のエンジニアリング作業を開始しており、OpenAIは数ヶ月以内の展開を予定、Microsoftは2027年2月1日に開始し、Googleは2027年のサポートを予定しています。
約30年にわたり、ロボット排除プロトコル(Robots Exclusion Protocol)は、自動化されたウェブクローラーが公開オンラインコンテンツとどのように相互作用するかを規定してきました。ウェブサイト管理者は、ルートディレクトリにシンプルなrobots.txtプレーンテキストファイルを配置し、どの検索エンジンユーザーエージェントが特定のURLパスの取得を許可されているかを定義していました。このプロトコルは、ウェブサイトパブリッシャーが検索結果ページでの発見性、外部へのリファラートラフィック、ブランド露出の対価として、クローラーによるコンテンツのインデックス作成を許可するという、基本的な商業上の取引に基づいて機能していました。
生成AIの急激な台頭により、その経済モデルは崩れました。最先端のAIラボが展開する自動スクレイパーは、基礎モデルを学習するためにウェブドメインの取り込みを開始し、多くの場合、パブリッシャーへのリファラークリックを提供することなく、元のコンテンツを回答インターフェース内で直接要約するようになりました。自身の知的財産が取り込まれることを防ぎたいコンテンツ所有者は、GPTBot、ClaudeBot、Google-Extendedなど、独自ユーザーエージェントの断片的で複雑なリストを管理せざるを得ませんでした。この管理上の負担により、複数のクローラーディレクティブを同時に管理する際の設定ミスや、誤って検索インデックスから除外されてしまう運用リスクが増大していました。

共通のAI学習オプトアウトの登場は、断片的なベンダーごとのブロックから、協調的なプロトコルガバナンスへの大きな転換を示しています。共通のポリシーシグナルを中心にサポートを調整することで、主要なAIプロバイダーは、生成モデルの学習に関して明確な境界線を設定したいと考えているコンテンツクリエイターの技術的ハードルを下げることを目指しています。Google検索セントラルの公式発表によると、この単一のルールにより、ウェブサイト管理者は、市場に参入する個別の商業用AIクローラーごとに異なるディレクティブを追跡・設定するのではなく、一度の手順で生成AIの学習スタンスを宣言できるようになります。
内部のアーキテクチャメカニズム:__usage_ai-trainingシグナルの仕組み
共有設定シグナルの背後にある技術的アーキテクチャは、機械可読な学習設定シグナルに関するIETFインターネットドラフトで仕様が定められています。重要な点として、このドラフトは新たなディレクティブを導入したり、RFC 9309で定義されているロボット排除プロトコルの基盤となる文法を変更したりするものではありません。その代わり、予約済みのポリシーシグナルである__usage_ai-trainingを割り当てることで、標準的なUser-Agentレコードを再利用しています。
オプトアウトを設定するために、ウェブマスターはこのポリシーシグナルをユーザーエージェントとして指定し、その後に標準的なDisallowおよびAllowルールを続ける通常のルールブロックを作成します。以下の例は、ウェブサイトの所有者が、一般向けのプロモーション資料例外を除き、すべてのサイトディレクトリにわたってどのようにオプトアウトを表明するかを示しています。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
「AI学習」を構成するものの意味論的定義は、IETFワーキンググループの基礎的な語彙仕様に裏付けられています。このフレームワークの下では、学習は、スクレイピングされたウェブコンテンツを利用して、生成人工知能モデルの学習済みウェイトやパラメータを修正または微調整することと厳密に定義されています。標準的な文書分類、検索インデックスのランキング、スペル修正、スパムフィルタリングなどの非生成的な計算処理は、この定義から明示的に除外されます。
プロトコル境界:クロール vs 学習 vs グラウンディング
この提案されたシグナルの運用上の限界を理解するには、自動データ取り込みの明確な段階を切り分ける必要があります。
[公開ウェブコンテンツ]
       │
       ▼
[1. HTTPクロール / フェッチ] ──> 特定のクローラーのUser-Agent(例: GPTBot, Bingbot)によって管理されます
       │                    *__usage_ai-trainingはHTTPフェッチの動作を管理しません*
       ├────────────────────────────────────────┐
       ▼                                        ▼
[2. モデル学習での利用]                  [3. ライブグラウンディング / RAG]
   *__usage_ai-training: Disallow*          *ページタグおよびベンダー設定によって管理されます*
   学習に対する設定の意向を表明します      AIモデルにリアルタイムのウェブコンテキストを提供します
       │                                        │
       ▼                                        ▼
   適用は参加AIプロバイダー                     適格基準は個別のプラットフォーム
   に依存します                                 ポリシーによって設定されます
技術チームは、このドラフト仕様に固有の4つの構造的境界を評価する必要があります。
- シグナルが管理するのは学習であり、クロールではない:このポリシーシグナルは、ネットワーククロールの動作に対するディレクティブではありません。
__usage_ai-trainingの下でDisallow: /に遭遇したAIクローラーであっても、HTTP経由でHTMLドキュメントを取得することは引き続き許可されます。単に、その取得したテキストをモデルの学習パイプラインに投入しないよう指示されているに過ぎません。ボットによるURLのリクエスト自体を完全に防ぐためには、管理者はクローラー固有の識別名をブロックし続ける必要があります。 - ワイルドカードルールは適用されない:
User-Agent: *の後にDisallow: /が続くような一般的なワイルドカードブロックは、このポリシーシグナルには一致しません。このドラフトでは、参加するAIプロバイダーが、普遍的なワイルドカードグループをAI学習設定の表明として解釈してはならないと義務付けています。ファイルから明示的な__usage_ai-trainingシグナルが省略されている場合、標準ではそのサイトが学習設定を表明していないものとして解釈します。 - 過去のモデルの学習解除(アンラーニング)は行われない:ウェブサイトの
robots.txtファイルの更新は、未来に向けて機能します。将来のクロールおよび学習サイクルのためのシグナルを提供しますが、過去の学習データセットにすでに統合されたデータをAIラボに強制的に削除させたり、既存の基礎モデルからウェイトを削除させたりすることはできません。 - 技術的な強制力よりも自主的な協調:このシグナルはパブリッシャーの意向を表明するものであり、非参加または非準拠のデータ消費者に対する技術的な強制力を提供するものではありません。RFC 9309の原則に基づき、robots.txtはアクセスコントロールファイアウォールではなく、あくまで協調的なアドバイザリーメカニズムであり続けます。
プロバイダーごとの実装の違いと移行スケジュール
Google、Microsoft、OpenAIは共有シグナルのサポート計画を発表していますが、その技術的実装とロールアウトスケジュールは大きく異なります。各プロバイダーは、検索エンジンのインデックス作成、生成モデルの学習、会話型の検索拡張生成(RAG)のバランスへのアプローチを、自社の製品インフラストラクチャを通じて進めています。
以下のマトリックスは、確認されているプラットフォームのコミットメント、解釈ルール、移行スケジュールを対比させたものです。
| プラットフォーム | 確認されているステータスとタイムライン | ポリシーシグナルの解釈 | グラウンディングおよび検索の処理 | レガシータグの移行と例外 |
|---|---|---|---|---|
| サポート発表済み。2027年予定(正確な日付は未定) | 明示的なGoogle-Extendedルールが存在しない場合、Google-Extended: Disallowとして解釈される |
デフォルトのマッピングはGemini Appsのグラウンディングに影響。明示的なルールが優先される | 既存のGoogle-Extendedディレクティブは完全に有効なまま。検索インデックス作成への影響なし |
|
| Microsoft | 対応を正式決定。2027年2月1日より遵守を開始 | ウェブクロール時の学習オプトアウトとして認識される | 学習から切り離され、ページレベルのタグを介して個別に管理される | 2027年3月1日にAI向けのNoArchive/NoCacheを廃止。一時的なBingウェブマスターツールの設定は12月15日に開始 |
| OpenAI | 数ヶ月以内の実装を表明 | データ取り込みパイプラインでの直接サポート | GPTBotディレクティブと並行して評価される |
既存のGPTBot設定はアクティブかつ有効な状態を維持 |
| Anthropic | 従業員がドラフトを作成。ワーキンググループのリストで開発が報告されている | サービス全体でのサポートを意図。公式のニュースルームのタイムラインは未定 | ClaudeBotディレクティブと並行して評価される |
既存のClaudeBotクローラー制御は継続して機能する |
Googleは、共有AI学習オプトアウトを、明示的なGoogle-Extendedルールが存在しない場合にGoogle-Extendedの拒否として解釈する予定です。Google-ExtendedはGemini Appsでのグラウンディングの適格性も管理しているため、このデフォルトのマッピングはパブリッシャーのコンテンツがそれらのエクスペリエンスで利用可能かどうかに影響を与える可能性があります。Googleの実装では、明示的なGoogle-Extendedルールが共有シグナルよりも優先されますが、Googleの現在のコントロールがモデル学習とGemini Appsのグラウンディングに対して個別のオプトアウトを提供しているとパブリッシャーが思い込むべきではありません。Google-Extendedの下で許可されたコンテンツは、掲載や引用の保証なしに、Geminiのグラウンディングの対象となる場合があります。
対照的に、公式のBingウェブマスターの更新情報で詳述されているように、Microsoft Bingはモデル学習とリアルタイムグラウンディングを別個のアーキテクチャ概念として扱っています。Microsoftでは、パブリッシャーが生成モデルの学習をオプトアウトしながら、Copilotの回答におけるライブグラウンディングを引き続き許可することが可能です。これらの設定を管理するサイトは、robots.txt内、または個別URLのrobots.txtを上書きするページレベルのHTMLメタタグやHTTPヘッダーを通じて、学習制限を宣言できます。グラウンディングは、Microsoft独自のツール(Copilotなど)でのグラウンディングを許可しつつMicrosoftのグラウンディングAPIを利用するサードパーティサービスを除外するDisallowExtendedオプションを含む、ページレベルの設定によって制御されます。さらに、MicrosoftはAI制御のための従来のNoArchiveおよびNoCacheタグへの依存を段階的に廃止しています。それらのタグに依存しているサイトは、2027年3月1日までに新しいオプションへ移行する必要があります。一時的なBingウェブマスターツールのグラウンディング設定は、2026年12月15日の時点でNoArchiveまたはNoCacheを使用しているサイトでのみ利用可能です。これは、Microsoftがページを再クロールして新しい設定を検出するまで、または2027年9月30日のいずれか早い方まで有効です。
エンジニアリングチェックリスト:エージェント型ウェブに向けたウェブ設定の監査
共有AI学習設定シグナルのデプロイには、システムアーキテクチャ、コンテンツ運用、および法的ガバナンスチーム間の連携が必要です。エンジニアリングリーダーは、検索エンジンの発見を意図せず妨げることなく、サーバー設定が組織のポリシーを正確に反映していることを確認する必要があります。
ウェブマスターおよびシステム実装チェックリスト
- 現在のロボットマニフェストの監査:既存の
robots.txtファイルをレビューしてベンダー固有のディレクティブをカタログ化し、GPTBot、ClaudeBot、またはGoogle-Extendedのルールが組織の学習ポリシーと競合していないか検証します。 - 予約済みポリシーシグナルのデプロイ:
User-Agent: __usage_ai-trainingブロックを実装し、統一されたフォーマットで参加AIプロバイダー全体にグローバルな学習境界を表明します。 - 細やかな例外パスの維持:プレスリリース、メディアキット、オープンな開発者ドキュメントなどのパブリックアセットがモデルによる消費を意図している場合は、ディスアドバンス(拒否)ディレクティブの下に明示的な
Allow:例外を宣言します。 - フェッチブロックと学習ガバナンスの分離:主な目的がオリジンサーバーの負荷軽減や不正なスクレイピングの防止である場合は、IPベースのレート制限、CDNボットチャレンジ、および明示的なクローラーユーザーエージェントブロックを設定します。
ガバナンスおよびコンプライアンスチェックリスト
- Microsoftのグラウンディング移行スケジュールの確認:Bing Copilotの出力を制御するために
NoArchiveまたはNoCacheを利用しているサイトでは、Microsoftの2027年3月1日の強制期限前に、新しいページレベルタグへの移行を準備します。 - 検索発見におけるトレードオフの評価:会話型アンサーエンジンでの露出を評価しているプラットフォームでは、ベンダー固有のデフォルトマッピング(Googleの
Google-Extendedへのフォールバックなど)がリアルタイム検索の適格性にどのように影響するかを認識します。 - IETFワーキンググループの更新情報の追跡:2027年5月の期限切れ予定の前に発生する可能性のある構文の更新に対応するため、IETF AIPREFワーキンググループ内での
draft-kelley-aipref-training-preference-signalの進捗を監視します。
Share this article