O Anthropic Sonnet 5.5 acelera 30%? A Anthropic lançou oficialmente o Claude Sonnet 5.5, com o laboratório reportando uma geração de saída 30% mais rápida e um custo até 30% menor por tarefa concluída. À medida que as plataformas de inteligência artificial generativa migram de protótipos experimentais para sistemas de produção de alto volume, as equipes de engenharia de software enfrentam uma pressão crescente para controlar o consumo de tokens e a latência de execução. Historicamente, arquitetos corporativos presumiam que alcançar um desempenho de ponta em codificação exigia a implantação dos maiores e mais caros modelos principais. Hoje, como arquiteturas de nível intermediário otimizadas conseguem resolver desafios complexos de engenharia de software com menos etapas operacionais e chamadas de ferramentas, a economia fundamental das ferramentas de desenvolvimento automatizado está mudando para a eficiência na execução.
Economia de Produção: Por que o Custo de Conclusão da Tarefa Importa Mais que o Preço do Token
Em Resumo
- A Anthropic lançou o Claude Sonnet 5.5 em 28 de setembro de 2026, entregando uma geração de saída 30% mais rápida e até 30% menos custo por tarefa concluída.
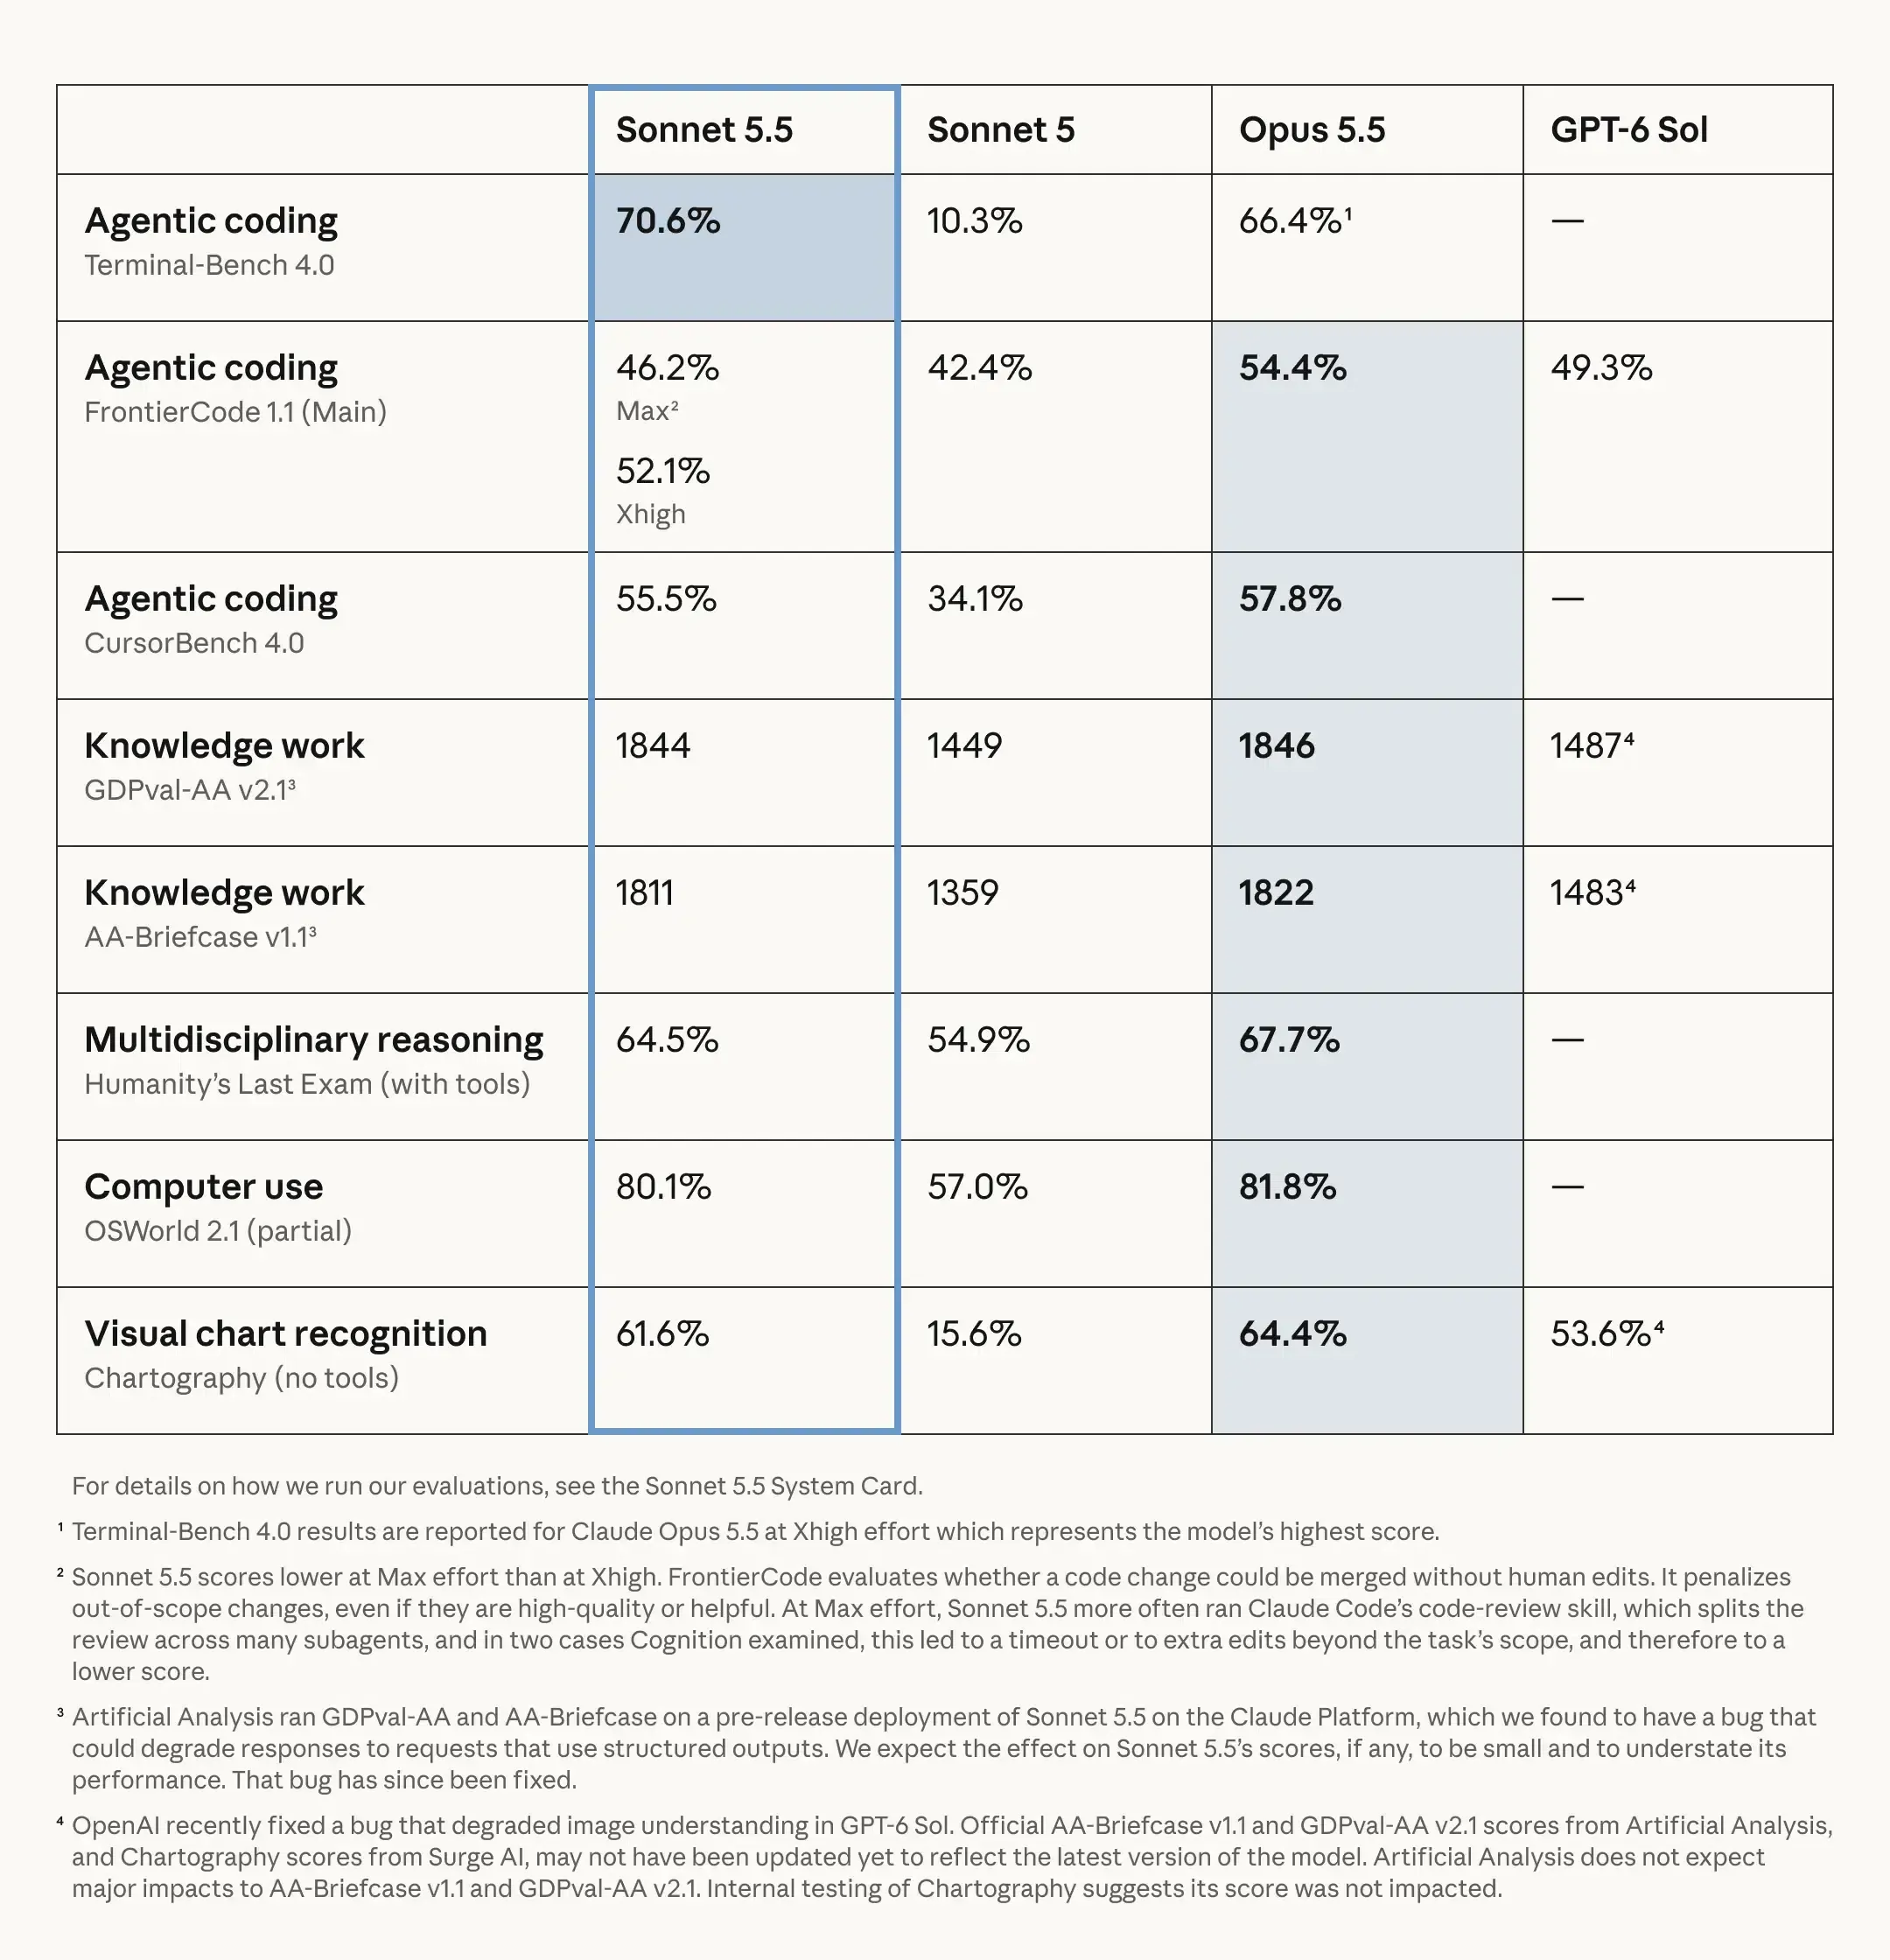
- Na avaliação de codificação por agentes Terminal-Bench 4.0, o Sonnet 5.5 atingiu 70,6%, superando o modelo principal Claude Opus 5.5 com 66,4% e o Sonnet 5 com 10,3%.
- O preço dos tokens da API permanece ancorado em $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída, alcançando reduções de custo por meio de menos etapas de execução e chamadas de ferramentas em lote.
A viabilidade comercial da implantação de agentes autônomos de engenharia de software enfrentou historicamente restrições econômicas severas. Executar ferramentas de desenvolvedor de várias etapas que inspecionam bases de código, executam comandos de shell e corrigem iterativamente testes unitários consome volumes massivos de tokens. Embora os modelos de fronteira de nível superior demonstrem uma profundidade de raciocínio notável, seus altos custos por token e latências de geração elevadas tornam a execução contínua e autônoma cara para empresas de software em escala.
Ao avaliar a infraestrutura do desenvolvedor, o preço de capa da API geralmente obscurece o custo real de completar um trabalho. Um modelo com preço baixo por token que percorre dezenas de chamadas de ferramentas repetitivas e novas tentativas acaba custando significativamente mais do que um modelo que resolve problemas em menos etapas de execução. Essa dinâmica é explorada em relatórios da indústria sobre o Sonnet 5.5, que destacam como os custos de conclusão de tarefas estão se desvinculando dos preços de tabela de tokens brutos.
A Anthropic estruturou o Claude Sonnet 5.5 para abordar esses gargalos operacionais diretamente. Mantendo as taxas básicas de API de $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída, o modelo alcança uma redução de até 30% nos custos líquidos por tarefa, ao exigir substancialmente menos etapas de raciocínio. Relatórios de testes de clientes publicados pela Anthropic destacam ganhos de eficiência notáveis em cargas de trabalho de produção:
- A Box relatou que o Sonnet 5.5 operou 2,4 vezes mais rápido, usando 12% menos tokens no total para verificar documentos de origem e identificar regressões de código.
- A Zendesk observou que os tíquetes de suporte foram processados 20% mais rápido, com menos erros de decisão automatizada do que nos modelos de produção existentes.
- O Slack demonstrou que o modelo superou o Sonnet 5 em avaliações de bots offline sem modificações nos prompts, consumindo cerca de 14% menos tokens de saída.
- A Lovable constatou que o Sonnet 5.5 exigiu aproximadamente um terço a menos de chamadas de ferramentas e metade das execuções de shell durante builds automatizados de aplicativos.
- A Base44 verificou que o modelo completou builds completos de aplicativos em uma média de 3,6 iterações, comparado a 7,7 iterações para o Opus 5.
Esses resultados ilustram como a eficiência na execução altera fundamentalmente a produtividade do desenvolvedor. Ao reduzir chamadas de ferramentas falhas e eliminar iterações redundantes, os modelos de nível intermediário fornecem uma base sustentável para a automação corporativa contínua.
Dissecação Técnica: Avaliando Benchmarks de Codificação e Escalonamento de Subagentes
O surgimento de modelos de nível intermediário superando os principais modelos em benchmarks técnicos específicos reflete uma mudança no pós-treinamento de modelos de base. Leis de escala iniciais sugeriam que a contagem bruta de parâmetros era o principal determinante da inteligência do modelo. No entanto, tarefas complexas de agentes—como navegar em ambientes de terminal e editar repositórios extensos—dependem fortemente da gestão de contexto, disciplina precisa no uso de ferramentas e controle de escopo.
Modelos principais, como o Opus 5.5, possuem uma imensa capacidade de raciocínio, destacando-se em decisões arquiteturais ambíguas e de final aberto. No entanto, uma profundidade de raciocínio extensiva pode, ocasionalmente, introduzir sobrecarga operacional em tarefas estritamente definidas. Nas avaliações do benchmark FrontierCode, por exemplo, a Anthropic observou que o Sonnet 5.5 com esforço Máximo pontuou menos do que com esforço Xhigh, pois invocou com mais frequência a habilidade de revisão de código do Claude Code. Essa habilidade dividia as revisões entre vários subagentes, o que, nos casos examinados, levava a timeouts ou edições fora do escopo penalizadas pelo mecanismo de benchmark. Em contraste, o Sonnet 5.5 operando com esforço padrão é particularmente adequado para execuções restritas e bem delimitadas: ele analisa rapidamente estruturas de repositório, avalia mudanças propostas e opera dentro de limites de arquivo definidos.
Paridade de Benchmark: Terminal-Bench, CursorBench e GDPval-AA
As avaliações publicadas pela Anthropic mostram o Sonnet 5.5 igualando ou superando os melhores benchmarks em domínios técnicos cotidianos. No Terminal-Bench 4.0, que avalia a resolução de problemas em linha de comando de várias etapas, o Sonnet 5.5 obteve 70,6%, superando o Opus 5.5 com 66,4% e o Sonnet 5 com 10,3%. No CursorBench 4.0, derivado de sessões reais de desenvolvedores Cursor, o Sonnet 5.5 atingiu 55,5%, ficando atrás do Opus 5.5 (57,8%) por pouco mais de dois pontos percentuais. Além disso, no GDPval-AA v2.1, que mede tarefas profissionais do mundo real em 44 ocupações, o Sonnet 5.5 alcançou uma classificação Elo de 1844, acompanhando de perto o Opus 5.5 com 1846.
Para examinar como modelos simplificados otimizam a execução autônoma, considere as diferenças de fluxo de trabalho:
[Loop de Agente Principal Monolítico]
  Prompt do Usuário ──> Cadeia de Raciocínio Pesada ──> Chamadas de Ferramentas Extensas (Alto Consumo de Tokens) ──> Risco de Edição Excessiva & Timeouts

[Loop de Agente de Nível Intermediário Simplificado]
  Prompt do Usuário ──> Mapeamento de Intenção Delimitado ──> Chamadas de Ferramentas em Lote ──> Menos Etapas de Execução ──> Patch Conciso Entregue
Esse loop de execução simplificado pode reduzir oportunidades para desvio de contexto e idas e vindas desnecessárias. A Anthropic relata uma geração de saída 30%+ mais rápida, juntamente com contagens de etapas reduzidas em relação ao Sonnet 5. O modelo agrupa chamadas de ferramentas, minimizando a latência de rede de ida e volta entre o tempo de execução do agente e os ambientes host.
O Sonnet 5.5 também introduz infraestrutura de segurança de nível um na categoria de nível intermediário. É a primeira variante Sonnet a ser lançada com salvaguardas de cibersegurança semelhantes ao Opus 5.5. Tarefas de descoberta de vulnerabilidades de alto risco retornam automaticamente para arquiteturas anteriores, enquanto defensores autorizados recebem permissões escalonadas por meio do Programa de Verificação Cibernética. Além disso, o sistema incorpora classificadores de segurança projetados para reduzir a extração de raciocínio em escala industrial e manter o raciocínio preservado vinculado à conta de origem.
Estratégia Arquitetural: Alocando Cargas de Trabalho entre Modelos de Fronteira e de Nível Intermediário
À medida que os modelos de base de IA se bifurcam em mecanismos de raciocínio ultra-profundos e modelos de execução ágil, os líderes de engenharia devem reavaliar como alocam os níveis de modelo ao longo do ciclo de vida de desenvolvimento de software. A implantação de um único modelo principal em todo o pipeline de engenharia introduz latência e custo desnecessários. Em vez disso, a infraestrutura moderna do desenvolvedor depende cada vez mais do roteamento dinâmico de modelos, atribuindo tarefas com base na complexidade estrutural.
Ao arquitetar fluxos de trabalho de produção, as equipes devem ponderar as compensações entre raciocínio conceitual profundo e resolução de tarefas de alta vazão. Embora os modelos principais continuem sendo indispensáveis para o planejamento arquitetural amplo, os modelos intermediários lidam com a grande maioria da execução de código do dia a dia com capacidade de resposta superior.
A seguinte matriz de decisão descreve o alinhamento técnico entre os níveis de modelo:
| Categoria de Carga de Trabalho | Escolha Primária de Modelo | Perfil de Custo | Perfil de Latência | Melhor Para |
|---|---|---|---|---|
| Correções de Bugs e Revisões de PR | Claude Sonnet 5.5 | Baixo ($2 / $10 por 1M tokens) | Rápido (Geração 30%+ mais rápida) | Tarefas diárias de software bem delimitadas e verificações de CI/CD de alto volume |
| Arquitetura e Migrações de Base de Código | Claude Opus 5.5 | Alto ($4 / $20 por 1M tokens) | Adaptativo, ciclos de pensamento profundo | Refatoração complexa e ambígua em repositórios extensos |
| Prototipagem Interativa e Design de UI | Claude Sonnet 5.5 | Baixo ($2 / $10 por 1M tokens) | Iteração rápida e responsiva | Design de fluxos de usuário, geração de diagramas e estrutura de frontend |
| Pesquisa Avançada de Cibersegurança | Modelos Claude com acesso verificado | Depende do modelo e nível de acesso | Verificação minuciosa de várias etapas | Pesquisa de segurança de alto risco autorizada sob programas de verificação Anthropic |
A Anthropic estrutura capacidades de cibersegurança por meio de salvaguardas escalonadas. Embora a remediação rotineira de vulnerabilidades prossiga normalmente no Sonnet 5.5, tarefas de segurança de maior risco retornam automaticamente para arquiteturas anteriores. Para defensores autorizados conduzindo pesquisas de segurança avançadas, o acesso a capacidades expandidas em todo o Sonnet 5.5, Opus 5.5 e modelos Mythos é gerenciado por meio do Programa de Verificação Cibernética de várias camadas.
Ao estabelecer regras de roteamento dinâmico, as organizações de engenharia podem direcionar revisões rotineiras de pull requests, geração de testes unitários e localização de bugs para o Sonnet 5.5. Isso preserva a capacidade do Opus de nível superior para refatorações arquiteturais de alta complexidade, mantendo os orçamentos de engenharia previsíveis sem comprometer a confiabilidade do software.
Listas de Verificação de Integração: Operacionalizando o Sonnet 5.5 no CI/CD Corporativo
À medida que as organizações de software incorporam modelos de alta velocidade e custo-benefício como o Sonnet 5.5 em seus pipelines de produção, as equipes de engenharia devem estabelecer cronogramas de governança robustos. Maximizar a economia de custos requer alinhar as configurações de parâmetros da API com a complexidade da tarefa, evitando o desvio do agente não monitorado.
Lista de Verificação para Implementação do Desenvolvedor
- Configurar Níveis de Esforço Dinâmicos: Utilize as configurações de esforço nativas do modelo—padrão para Médio em aplicativos Claude e Claude Code, e Alto na Plataforma Claude—para equilibrar a profundidade do raciocínio com o gasto de tokens.
- Aproveitar o Cache de Prompt: Implemente cache de prompt em prompts de sistema estáticos e mapas de repositório para garantir um desconto de 90% nos tokens de leitura de cache ($0,20 por milhão de tokens).
- Implantar Processamento em Lote Assíncrono: Encaminhe avaliações que não sejam em tempo real, auditorias de código automatizadas e migrações em lote por meio de APIs de lote para obter um desconto de 50% nos custos padrão de token.
- Integrar Fallbacks à Prova de Falhas: Estabeleça disjuntores programáticos que terminem ou redirecionem solicitações caso os loops de ferramentas automatizadas excedam os orçamentos de iteração predefinidos.
Lista de Verificação de Governança e Infraestrutura
- Reavaliar Unidades Econômicas de Assinatura: Calcule os custos marginais de computação por desenvolvedor ativo para determinar se os modelos de nível intermediário de alta velocidade permitem oferecer cotas de uso mais altas ou preços de nível mais baixo.
- Monitorar Taxas de Iteração: Meça o número médio de execuções de ferramentas necessárias para resolver as tarefas do usuário; reduções nas contagens de iteração melhoram diretamente a satisfação do desenvolvedor.
- Configurar Processamento Apenas nos EUA Onde Exigido: Para clientes corporativos regulados com requisitos de residência de dados domésticos, configure endpoints de inferência apenas nos EUA (disponíveis a 1,1x de preço sob termos corporativos qualificáveis).
- Verificar Elegibilidade de Retenção Zero de Dados: Confirme o status de retenção zero de dados com o provedor da API, garantindo a conformidade corporativa, observando que recursos especializados como caches de prompt persistentes podem operar sob termos distintos de retenção de dados.
Ao adotar essas práticas operacionais estruturadas, as organizações de software podem converter a velocidade algorítmica e a eficiência de token em ganhos de desenvolvimento previsíveis.
Perguntas Frequentes (FAQ)
Por que o Sonnet 5.5 custa menos por tarefa se o preço por token é igual ao do Sonnet 5?
O Claude Sonnet 5.5 pode substituir o Opus 5.5 na engenharia de software?
Como o cache de prompt impacta os custos operacionais em agentes de codificação?
Principais Conclusões para Equipes de Engenharia
O lançamento do Claude Sonnet 5.5 reflete uma evolução da indústria de um escalonamento de parâmetros sem restrições para uma eficiência de tarefas operacionais. Plataformas de engenharia de software de alta vazão não exigem necessariamente a sobrecarga de computação dos modelos principais para cada fase operacional. Quando um modelo intermediário resolve de forma confiável tarefas de base de código delimitadas em menos iterações, o desenvolvimento de software automatizado torna-se significativamente mais econômico de implantar em escala.
Capitalizar esses ganhos de eficiência requer estabelecer uma arquitetura disciplinada: rotear tarefas dinamicamente com base na complexidade, impor limites de uso de ferramentas e aplicar sistematicamente o cache de prompt. À medida que os provedores de modelos de base continuam a otimizar a eficiência de tokens juntamente com o raciocínio bruto, as equipes de engenharia que projetam pipelines modulares e monitorados por custos manterão os fluxos de trabalho de produção mais sustentáveis e escaláveis.
Referências
-
Anthropic. Apresentando o Claude Sonnet 5.5.
-
Anthropic. Cartão de Sistema do Claude Sonnet 5.5.
-
Anthropic. Preços da API do Claude e Residência de Dados.
-
Anthropic. Termos de Serviço Comercial e Política de Retenção de Dados.
-
VentureBeat. Anthropic Lança Claude Sonnet 5.5 com 30% de Redução de Custo por Tarefa.
-
TechCrunch. Anthropic Lança o Sonnet 5.5 como um Parceiro de Trabalho Significativamente Mais Barato e Rápido.
-
9to5Mac. Anthropic Atualiza o Claude com o Novo Modelo Sonnet 5.5.
Share this article



