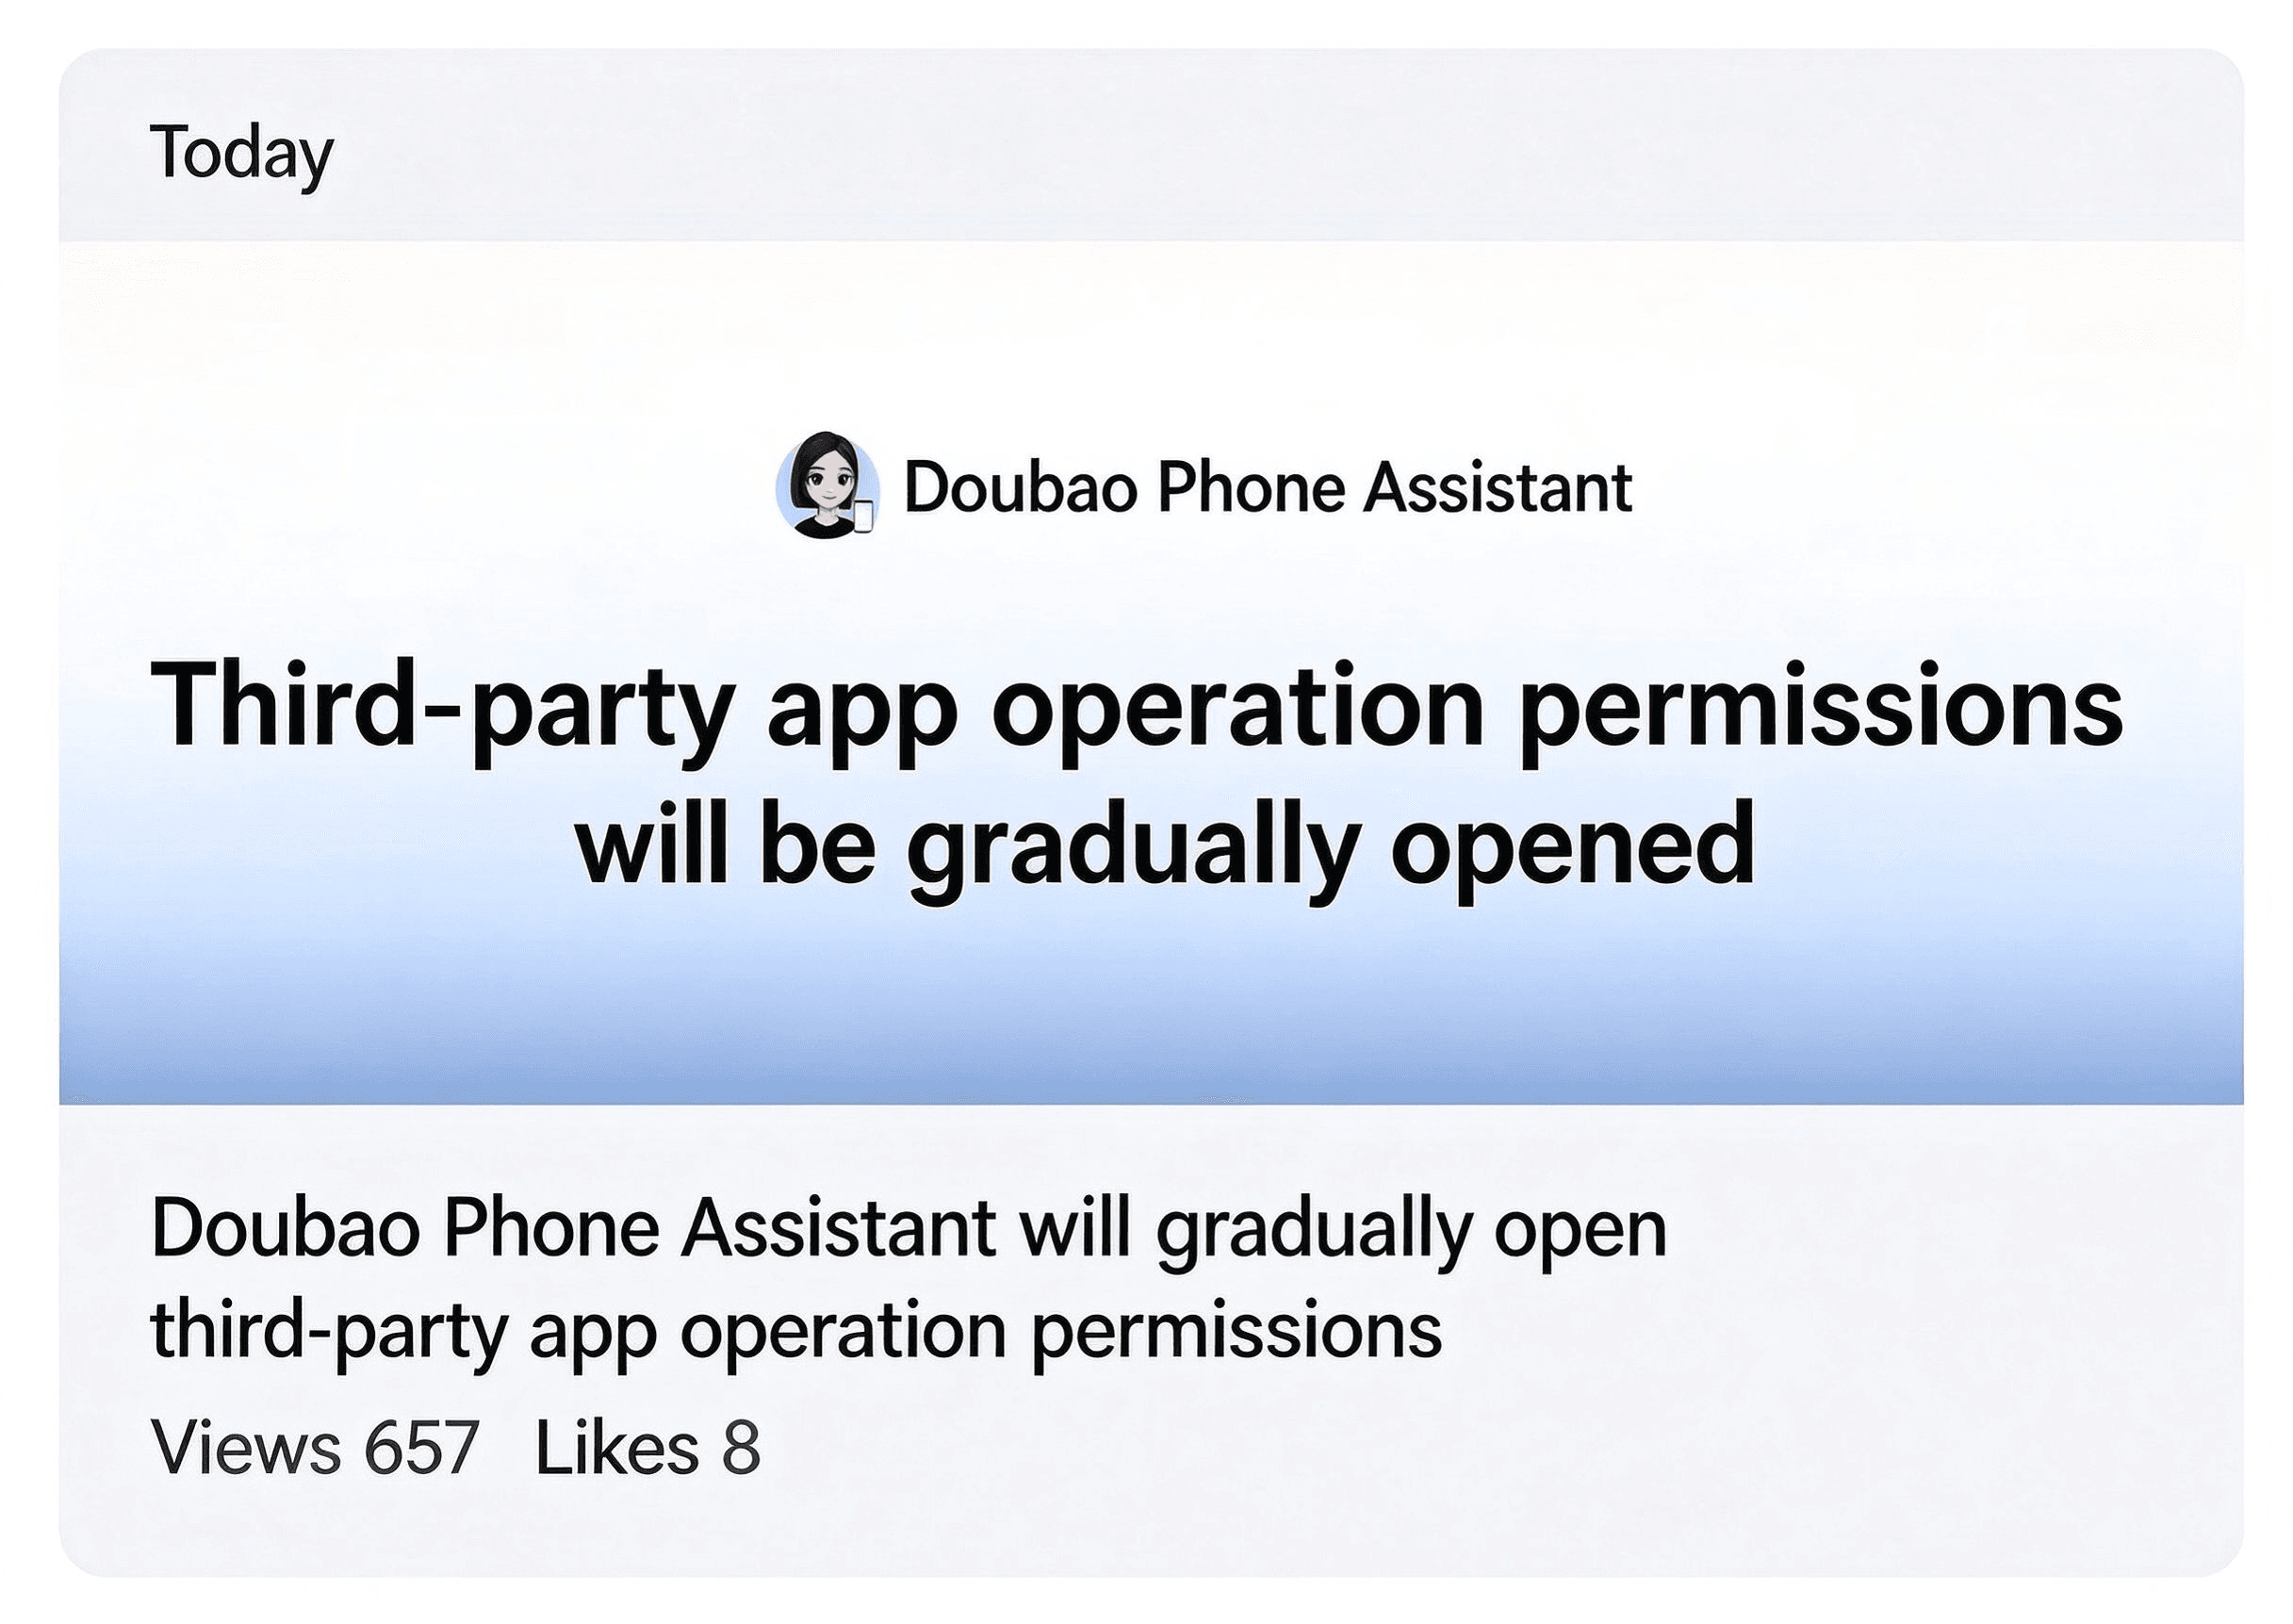
A DeepSeek compensa interrupção da API? A DeepSeek restaurou sua interface web de chat e seus serviços de API para desenvolvedores em 15 de outubro de 2026, após uma interrupção de serviço que durou quatro horas e cinquenta e três minutos, emitindo um aviso de compensação que concede créditos bônus equivalentes a sete dias de consumo histórico de API. Iniciando às 08:11 e sendo resolvida às 13:04 no Horário de Pequim (00:11 às 05:04 UTC), a interrupção afetou endpoints monitorados, incluindo o serviço de chat, a API DeepSeek V4 Pro e a API DeepSeek V4.1 Flash. Embora a alocação retroativa de créditos forneça alívio financeiro direto em faturas subsequentes, ela não reembolsa solicitações em tempo real não atendidas ou períodos de inatividade visíveis aos usuários. Para equipes de engenharia de software que mantêm cargas de trabalho em produção, essa falha operacional reforça a necessidade de ir além das dependências de um único provedor, caminhando em direção a arquiteturas estruturadas de failover no backend da aplicação.
O Problema Operacional e Gargalos Financeiros: DeepSeek compensa interrupção da API em endpoints monitorados
Resumo Rápido
- A DeepSeek sofreu uma interrupção de 4 horas e 53 minutos em 15 de outubro de 2026, afetando o chat web monitorado, o aplicativo móvel e os serviços de API para os modelos V4 Pro e V4.1 Flash.
- A plataforma anunciou créditos bônus iguais ao consumo faturado de cada conta de API elegível de 8 de outubro a 14 de outubro de 2026, aplicados automaticamente aos saldos das contas.
- Os créditos bônus são consumidos antes dos saldos em dinheiro em faturas de API subsequentes, fornecendo alívio retroativo de despesas em vez de reembolsos em dinheiro ou garantias para transações não atendidas.
A ampla integração de endpoints de modelos de terceiros introduziu novos limites operacionais para arquiteturas de software. Nos últimos dois anos, as equipes de desenvolvimento incorporaram APIs de modelos hospedados diretamente em serviços web, backends móveis, ferramentas de atendimento ao cliente e pipelines de processamento de dados. Quando um provedor de modelo upstream sofre instabilidade na infraestrutura, os aplicativos clientes que dependem de chamadas síncronas e diretas enfrentam modos de falha imediatos.
De acordo com reportagens de The Paper sobre a restauração de serviços da DeepSeek, os usuários começaram a observar avisos de "servidor temporariamente indisponível" em interfaces web e programáticas durante os horários comerciais de pico da manhã na Ásia. Os componentes monitorados começaram a relatar degradações de serviço logo após as 08:00 no Horário de Pequim, levando a interrupções completas do serviço nos endpoints principais da API antes que as equipes de engenharia resolvessem o incidente às 13:04 no Horário de Pequim.

Após a recuperação do sistema, a DeepSeek publicou um aviso oficial de restauração de serviço e compensação. Em vez de emitir vales uniformes, a empresa estruturou a compensação com base na atividade anterior da conta. As contas de desenvolvedores elegíveis receberam créditos bônus correspondentes ao seu consumo exato faturado de 8 de outubro a 14 de outubro de 2026. Os termos afirmam que esses créditos bônus são depositados diretamente nos saldos dos usuários e deduzidos antes das reservas em dinheiro durante ciclos de faturamento futuros.
Embora essa abordagem compense os custos subsequentes da plataforma, ela aborda o faturamento histórico em vez da interrupção em tempo real. As equipes de engenharia que mantêm ferramentas voltadas ao consumidor enfrentaram solicitações não atendidas e erros visíveis aos usuários durante a janela de quase cinco horas. O reembolso financeiro mitiga as despesas com servidores, mas as equipes de desenvolvedores continuam responsáveis por lidar com falhas de conexão upstream de forma adequada dentro de sua própria lógica de aplicativo.
Causas Raiz Sistêmicas e Cadeias de Solicitação Não Visuais: Avaliando Dependências de Ponto Único
Quando um aplicativo depende de um único endpoint de aprendizado de máquina upstream, sua disponibilidade de ponta a ponta é limitada inteiramente por esse provedor externo. A interrupção de 15 de outubro ilustra como dependências arquitetônicas compartilhadas podem impactar várias camadas de serviço simultaneamente.
Em seu aviso público, a DeepSeek afirmou ter iniciado uma revisão da estabilidade da plataforma, comprometendo-se a identificar e eliminar pontos únicos de dependência para reduzir o risco de falhas recorrentes. A interrupção simultânea do Serviço de Chat e de vários componentes da API levanta questões sobre possíveis dependências compartilhadas. Gateways de roteamento, serviços de autenticação e coordenação de infraestrutura são exemplos de áreas que os engenheiros podem investigar, mas a DeepSeek não identificou nenhuma delas como a causa confirmada deste incidente. Visões gerais técnicas publicadas por TechNode sobre a interrupção da DeepSeek observam de maneira semelhante o amplo impacto operacional sem afirmar um mecanismo de falha não verificado.
O diagrama abaixo descreve um cenário de falha ilustrativo que contrasta uma configuração de provedor único com uma arquitetura de referência de múltiplos provedores em nível de aplicativo:
[ Dependência Frágil de Provedor Único ]
  Solicitação do Cliente ──> Backend da Aplicação ──> API DeepSeek ──> (Incidente: 5xx / Timeout) ──> Solicitação Abortada

[ Roteamento Desacoplado de Múltiplos Provedores (Ilustrativo) ]
  Solicitação do Cliente ──> Backend da Aplicação ──> Camada de Roteamento Inteligente
                                          │
                                          ├─ (Rota Primária: Erro / Timeout)
                                          │         │
                                          │         ▼
                                          └─ (Tentativa de Failover) ──> Provedor Secundário ──> Resposta Condicional
Os registros da plataforma na Página de Status da DeepSeek documentam eventos operacionais históricos em diferentes períodos de monitoramento, mostrando degradações ocasionais de desempenho juntamente com interrupções principais de serviço. Embora os painéis de status público forneçam indicadores de integridade de componentes em tempo real, eles não servem como divulgações arquitetônicas detalhadas ou benchmarks históricos de tempo de atividade em janelas ilimitadas.
Para organizações de engenharia, gerenciar dependências de IA externas requer tratar os endpoints de API upstream como recursos de rede voláteis. Sistemas projetados com disjuntores (circuit breakers), limites de tentativas delimitados e caminhos secundários de failover podem isolar falhas upstream antes que elas se propaguem para os usuários finais.
Comparação de Soluções: Compensações de Implementação para Arquitetura de IA com Múltiplos Provedores
Mitigar interrupções de API de modelos requer redundância estrutural dentro do backend da aplicação. Como a DeepSeek fornece uma interface compatível com a OpenAI acessível em https://api.deepseek.com, os desenvolvedores podem estruturar mecanismos de fallback usando bibliotecas de clientes padronizadas.
No entanto, passar de um padrão conceitual para uma implementação confiável requer resolver compensações específicas de engenharia:
- Os aplicativos devem validar as configurações de ambiente na inicialização para garantir que as credenciais e os endpoints de fallback sejam totalmente resolvidos antes que ocorram falhas em tempo de execução.
- Os timeouts de solicitações primárias e secundárias devem operar dentro de um orçamento de execução delimitado, evitando atrasos em cascata em serviços dependentes.
- Os loops de tentativas em nível de cliente devem ser desativados nas instâncias do SDK para evitar o acúmulo de latência, tratando a detecção de falhas e a lógica de failover explicitamente.
- A classificação de erros deve separar erros de formatação no lado do cliente (como 400 Bad Request ou 401 Unauthorized) de falhas de infraestrutura transitórias (como timeouts de conexão, erros 5xx upstream ou limites de taxa temporários).
- Os aplicativos que executam chamadas de ferramentas externas ou operações não idempotentes devem se proteger contra efeitos colaterais indesejados durante tentativas de repetição e failover.
- Os desenvolvedores devem verificar se os modelos de fallback mantêm compatibilidade de esquema de saída, adesão ao prompt do sistema e limites adequados de janela de contexto para cargas de trabalho em produção.
Este exemplo de referência do backend da aplicação demonstra a validação da configuração na inicialização, a alocação de timeout por tentativa e o failover básico. Ele usa um orçamento de tempo restante, mas não implementa um prazo de ponta a ponta estritamente aplicado e cancelável:
import OpenAI from "openai";

type Msg = OpenAI.Chat.ChatCompletionMessageParam;

// Validação estrita da configuração de inicialização garantindo que os valores resultem em strings não vazias
function requireEnv(name: string): string {
  const value = process.env[name];
  if (!value || value.trim() === "") {
    throw new Error(`Configuração obrigatória ausente: ${name}`);
  }
  return value;
}

const primaryApiKey = requireEnv("DEEPSEEK_API_KEY");
const fallbackApiKey = requireEnv("FALLBACK_API_KEY");
const fallbackBaseUrl = requireEnv("FALLBACK_BASE_URL");
const fallbackModelName = requireEnv("FALLBACK_MODEL");

// Defina maxRetries como 0 para evitar que loops de novas tentativas no nível do SDK agravem a latência da solicitação
const primaryClient = new OpenAI({
  baseURL: "https://api.deepseek.com",
  apiKey: primaryApiKey,
  maxRetries: 0,
});

const fallbackClient = new OpenAI({
  baseURL: fallbackBaseUrl,
  apiKey: fallbackApiKey,
  maxRetries: 0,
});

function isTransientError(err: unknown): boolean {
  if (!(err instanceof OpenAI.APIError)) return false;
  const status = err.status;
  // Candidatos a falhas transitórias: timeouts de rede/conexão (status indefinido), limites de taxa (429) ou erros de servidor (5xx)
  return status === undefined || status === 429 || status >= 500;
}

export async function chat(messages: Msg[], totalTimeoutMs: number = 25_000) {
  if (!Number.isFinite(totalTimeoutMs) || totalTimeoutMs <= 1_000) {
    throw new RangeError("totalTimeoutMs deve ser um número finito maior que 1000");
  }

  const startTime = Date.now();

  // Aplicar orçamento delimitado para a tentativa primária (por exemplo, até 15 segundos)
  const primaryBudgetMs = Math.min(15_000, totalTimeoutMs);

  try {
    return await primaryClient.chat.completions.create(
      {
        model: "deepseek-flash",
        messages,
      },
      { timeout: primaryBudgetMs }
    );
  } catch (err) {
    if (!isTransientError(err)) throw err;

    const elapsedMs = Date.now() - startTime;
    const remainingBudgetMs = totalTimeoutMs - elapsedMs;

    // Abortar se o orçamento restante for insuficiente para uma viagem de ida e volta na rede
    if (remainingBudgetMs <= 1_000) {
      throw new Error("Orçamento de timeout de solicitação excedido antes de iniciar a tentativa do provedor de fallback.");
    }

    console.warn(`O endpoint primário falhou (${elapsedMs}ms decorridos). Iniciando provedor secundário com o orçamento restante (${remainingBudgetMs}ms).`);

    return await fallbackClient.chat.completions.create(
      {
        model: fallbackModelName,
        messages,
      },
      { timeout: remainingBudgetMs }
    );
  }
}
Os sistemas de produção devem propagar um sinal de cancelamento compartilhado e um prazo absoluto em chamadas de provedores e operações de downstream. O exemplo não implementa disjuntores completos, validação de capacidade ou execução de ferramentas idempotentes.
A matriz abaixo compara estratégias arquitetônicas comuns para gerenciar a disponibilidade de modelos upstream:
| Padrão de Arquitetura | Escopo Técnico Primário | Isolamento de Domínio de Falha | Considerações Operacionais |
|---|---|---|---|
| Integração Direta com Provedor Único | Código de cliente mínimo chamando uma única URL base | Nenhum (Dependência direta upstream) | Configuração simples; alta vulnerabilidade a inatividade do provedor |
| Wrapper de Fallback no Backend da Aplicação | Lógica de roteamento no aplicativo avaliando códigos de status | Parcial (Dependente da capacidade do provedor secundário) | Baixa sobrecarga de infraestrutura; requer verificações de compatibilidade de esquema |
| Gateway de IA Corporativo Centralizado | Frota de proxy interna dedicada gerenciando tráfego de várias nuvens | Alto (Rede isolada e camadas de roteamento) | Maior complexidade de implantação; política centralizada e gerenciamento de tokens |
Embora os wrappers no backend da aplicação forneçam um ponto de partida de baixa sobrecarga, a confiabilidade da produção depende de medir a latência de recuperação e validar se os provedores secundários mantêm cota e capacidade suficientes para absorver o tráfego redirecionado durante interrupções em grande escala.
Lista de Verificação de Engenharia e Cronogramas de Governança: Endurecendo Aplicativos Contra a Inatividade de Modelos
As equipes de engenharia e produto devem realizar revisões sistemáticas das dependências de API de terceiros para garantir a resiliência do sistema e a reconciliação precisa do faturamento após interrupções upstream.
Lista de Verificação de Implementação para Desenvolvedores
- Reconciliar Créditos de Conta: Acesse o console da plataforma DeepSeek para confirmar que os créditos bônus para a janela de faturamento de 8 a 14 de outubro foram aplicados ao saldo da sua conta.
- Recalibrar o Monitoramento Automatizado de Gastos: Como o uso subsequente consome os créditos bônus antes das reservas em dinheiro, calibre os alertas de faturamento para monitorar o uso total de tokens em vez de apenas os deltas do saldo em dinheiro.
- Auditar Logs de Erros de Incidentes: Consulte os logs de solicitações do backend da aplicação entre 00:11 e 05:04 UTC em 15 de outubro de 2026, compilando o total de solicitações descartadas, distribuições de códigos de status e fluxos de trabalho de clientes afetados.
- Implementar Prazos Rigorosos e Tentativas Delimitadas: Configure orçamentos explícitos de timeout de solicitações (como 15 a 20 segundos) e desative tentativas ilimitadas do SDK, consultando as diretrizes de configuração na documentação de configuração do SDK Node da OpenAI.
- Verificar a Compatibilidade de Esquema e Saída: Execute testes de integração automatizados em modelos de fallback para garantir que saídas estruturadas, validação de JSON e parâmetros de chamada de ferramentas tenham um desempenho confiável em provedores secundários.
Lista de Verificação de Produto e Governança
- Estabelecer Degradação Graciosa da UI: Projete interfaces voltadas ao cliente que exibam estados de fallback informativos ou respostas em cache durante interrupções de modelos upstream em vez de diálogos de erro não tratados.
- Avaliar Termos de SLA de Múltiplos Fornecedores: Revise os acordos de nível de serviço do fornecedor e os termos de compensação, garantindo que os acordos comerciais estejam alinhados com os requisitos internos de continuidade de negócios.
- Auditar a Idempotência de Efeitos Colaterais: Verifique se os fluxos de trabalho de agentes automatizados ou funções de chamada de ferramentas aplicam chaves de idempotência, evitando transações externas duplicadas quando as solicitações passam por failover.
Perguntas Frequentes (FAQ)
Como os créditos de tokens da DeepSeek se aplicam ao faturamento futuro?
Quais serviços foram confirmados offline durante o incidente de 15 de outubro?
A DeepSeek divulgou a causa raiz da interrupção de 15 de outubro?
Um fallback de modelo secundário garante a execução sem tempo de inatividade?
Implicações Práticas e Perspectivas Futuras
A interrupção de 15 de outubro destaca uma realidade operacional essencial para o desenvolvimento de software moderno: os endpoints de inteligência artificial hospedados são dependências de tempo de execução externas sujeitas às mesmas restrições de disponibilidade dos serviços de nuvem de terceiros. Os créditos de faturamento retroativos mitigam perdas financeiras diretas, mas não podem restaurar sessões de usuário perdidas ou erros de aplicativos não tratados.
Para organizações de engenharia, a confiabilidade técnica exige a construção de arquiteturas tolerantes a falhas que desacoplem a lógica do aplicativo de provedores de modelos únicos. Ao implantar um roteamento de failover disciplinado no backend da aplicação, definir prazos de solicitação delimitados e verificar a compatibilidade de saída entre modelos, as equipes de engenharia podem melhorar a resiliência e reduzir a exposição a interrupções de serviços upstream.
Referências
-
Status da Plataforma DeepSeek. Histórico de Incidentes da DeepSeek e Registros de Monitoramento de Componentes.
-
The Paper. DeepSeek Anuncia Alocação Completa de Crédito Bônus de Gastos de Sete Dias Após Interrupção do Serviço.
-
TechNode. DeepSeek implementa correção após interrupção parcial afetar os serviços de chat e API.
-
South China Morning Post. DeepSeek oferece reembolsos aos usuários após sofrer outra grande interrupção.
-
Plataforma Aberta DeepSeek. Documentação da API da DeepSeek e Diretrizes de Preços.
-
Repositório do SDK Node da OpenAI. Documentação de Configuração do Cliente, Novas Tentativas e Timeouts.
Share this article