O GitHub lançou o Copilot Fusion? O GitHub anunciou oficialmente a disponibilidade geral do Copilot Fusion em 28 de outubro de 2026, introduzindo um roteador e orquestrador de modelos em tempo de execução que coordena vários modelos de inteligência artificial para tarefas de engenharia de software. Revelado na conferência anual GitHub Universe em São Francisco, o sistema afasta a seleção de modelos dos desenvolvedores individuais, permitindo que a plataforma analise os requisitos das tarefas e delegue o trabalho dinamicamente entre diferentes modelos fundamentais. À medida que as equipes de engenharia de software enfrentam custos crescentes de API e fadiga cognitiva decorrente da alternância constante entre diferentes modelos de fronteira, a orquestração automatizada de modelos está surgindo como um padrão arquitetural operacional.
Realinhamento Central da Indústria: GitHub Lança o Copilot Fusion no Universe
Em Resumo
- O GitHub lançou a disponibilidade geral do Copilot Fusion em 28 de outubro de 2026 para o Visual Studio Code, Copilot CLI, IDEs JetBrains e o aplicativo de desktop do GitHub Copilot.
- O sistema combina a coordenação de vários modelos em tempo de execução derivada do Project HydraFusion com algoritmos de seleção automática de modelos ajustados.
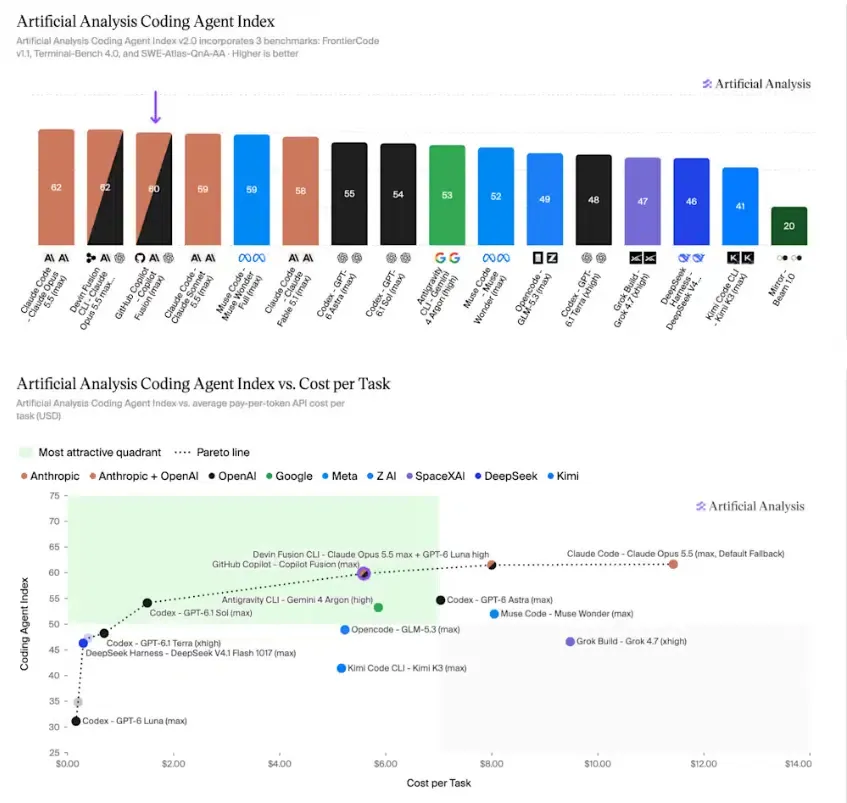
- Em avaliações independentes realizadas pela Artificial Analysis, o Fusion Max alcançou uma pontuação composta de 60 no Coding Agent Index v2.0, ficando atrás do Claude Code com Opus 5.5 Max por dois pontos, enquanto reduziu os custos das tarefas em aproximadamente 51%.
As equipes de desenvolvimento de software que utilizam assistentes de codificação de IA operavam historicamente sob um paradigma de seleção manual. Os programadores escolhiam um único modelo — como GPT-4o, Claude Sonnet ou um modelo de raciocínio da série o1 — a partir de um menu suspenso na IDE e mantinham essa seleção durante toda a sessão de codificação. Embora eficaz para solicitações isoladas, esse padrão introduz concessões operacionais. Os desenvolvedores frequentemente selecionam modelos de fronteira premium e de alta latência para o planejamento arquitetural complexo e, em seguida, esquecem de retornar aos modelos leves ao realizar tarefas rotineiras, como gerar testes unitários ou escrever documentação básica.
Essa abordagem manual pode inflar os gastos corporativos com APIs e consumir tokens de contexto de forma ineficiente. Para solucionar essas concessões de fluxo de trabalho, o GitHub desenvolveu o Copilot Fusion, conforme detalhado no anúncio oficial do GitHub. Em vez de tratar a codificação por IA como uma interação com um modelo estático único, o Fusion atua como um coordenador de tempo de execução. Os desenvolvedores determinam um nível geral de esforço de raciocínio e o sistema seleciona autonomamente o modelo subjacente mais adequado (ou a combinação de modelos) para cada etapa de uma tarefa.

A mudança estratégica representada pelo lançamento do GitHub Lança o Copilot Fusion concentra-se na economia em nível de tarefa, em vez do dimensionamento de parâmetros brutos. De acordo com avaliações de benchmark publicadas pela Artificial Analysis, o Copilot Fusion Max, testado via Copilot CLI no Coding Agent Index v2.0, concluiu atribuições de codificação de benchmark a um custo médio de $5,59 por tarefa, em comparação com $11,42 para o Claude Code executando o Claude Opus 5.5 da Anthropic em sua configuração máxima. A configuração avaliada consumiu aproximadamente 7,2 milhões de tokens por tarefa — cerca de metade do volume de tokens da configuração autônoma do Opus — concluindo as tarefas em cerca de 40% menos tempo.
O desempenho variou entre os componentes individuais de benchmark: o Fusion Max liderou o Terminal-Bench 4.0 com uma pontuação de 71, mas obteve 51 no FrontierCode (atrás dos 56 do Claude Code) e 57 no SWE-Atlas-QnA-AA. Além disso, embora a liderança da Microsoft tenha citado avaliações internas do DeepSWE apontando potenciais reduções de custos de até 77%, esse número representa um cenário máximo separado relatado pela empresa, e não uma média de benchmark independente. Esses resultados confirmam que a orquestração dinâmica de vários modelos pode diminuir significativamente as despesas de desenvolvimento para fluxos de trabalho suportados, embora a economia real dependa da combinação específica de tarefas, requisitos de revisão e padrões de uso empresarial.
Padrões Arquiteturais: Topologias de Execução Simples, em Cascata e por Crítica
O Copilot Fusion não opera como um modelo fundamental independente. Em vez disso, funciona como um plano de controle inteligente incorporado ao cliente do desenvolvedor. Quando um usuário envia uma instrução que envolve raciocínio, geração de código, depuração ou uso de ferramentas, o Fusion avalia os sinais de intenção de entrada em relação à integridade do sistema em tempo real, disponibilidade e complexidade semântica.
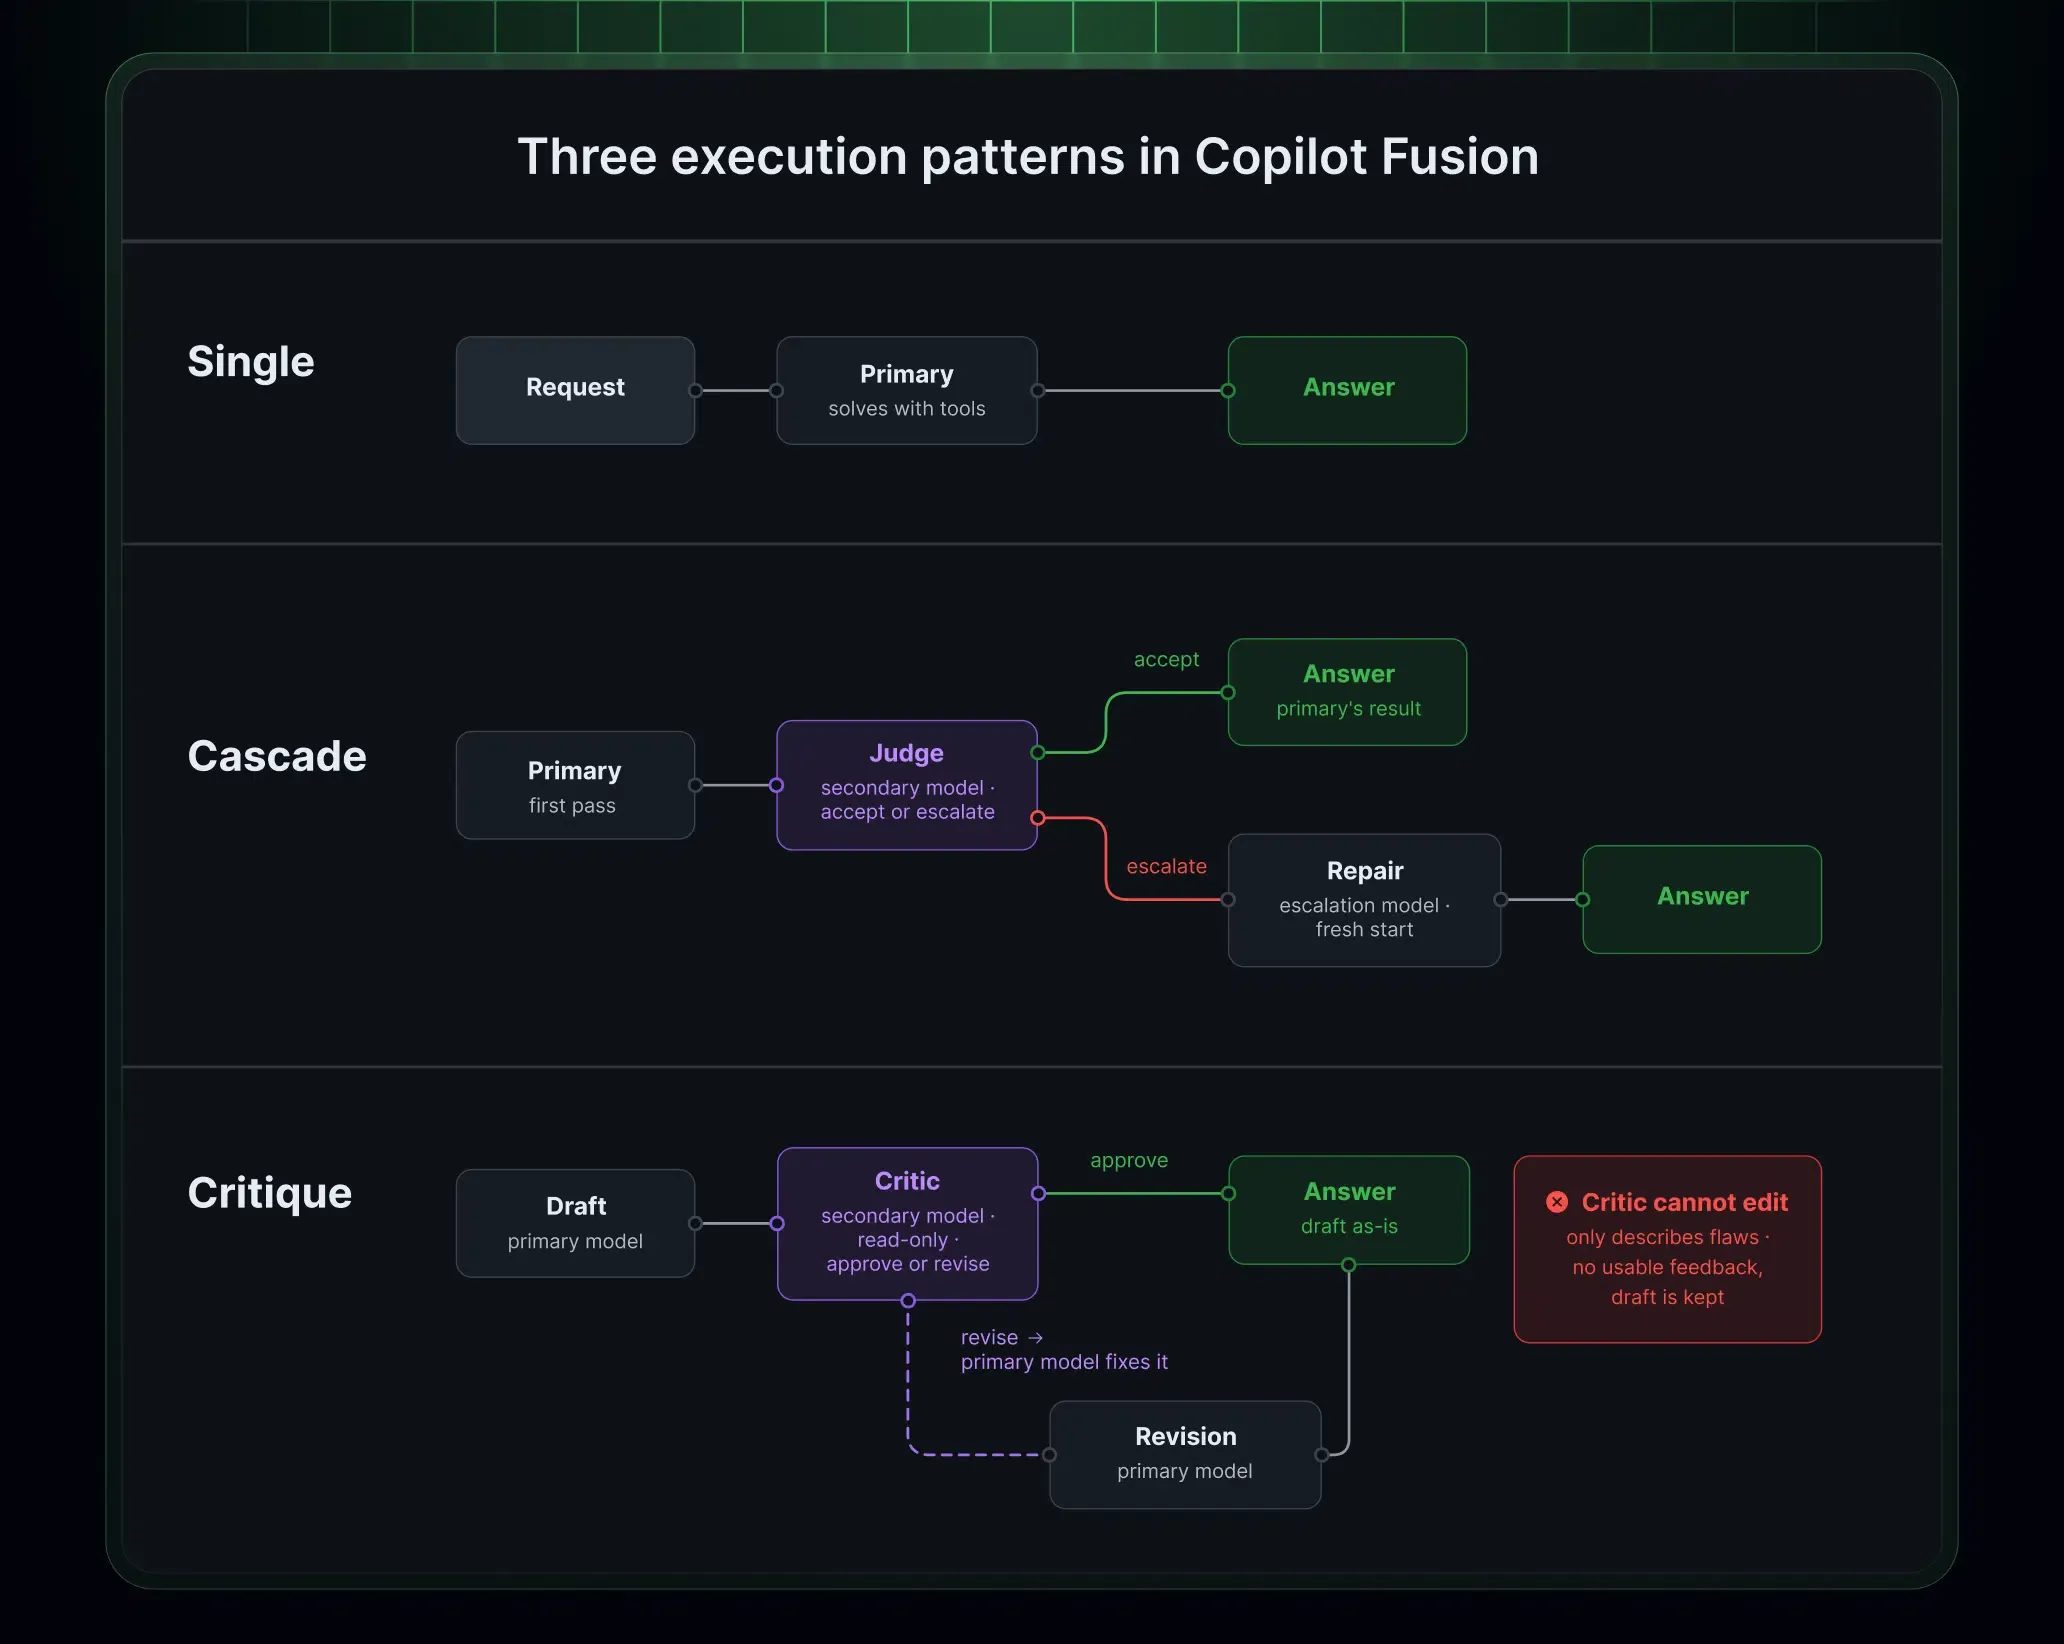
Dependendo das características da tarefa e do nível de esforço escolhido, o sistema seleciona dinamicamente um entre três padrões de execução:
- Padrão Simples (Single): Um único modelo recebe o prompt e conclui a tarefa diretamente, adicionando taxa de revisão zero. Esse padrão atende à geração de código direta, consultas sintáticas e refatoração básica.
- Padrão em Cascata (Cascade): Um modelo leve elabora uma solução inicial. Um segundo modelo de julgamento inspeciona o código proposto e determina se aceita o resultado ou se encaminha a tarefa para um modelo mais capaz para uma verificação aprimorada.
- Padrão por Crítica (Critique): Um modelo principal elabora uma resposta inicial enquanto um ou mais modelos revisores avaliam independentemente o código em paralelo. O orquestrador agrega seus comentários e o modelo principal revisa o código de acordo antes de retornar o resultado final ao usuário.
[Padrão Simples]
  Prompt ──> Modelo Principal ──> Execução Simples ──> Saída de Código Final

[Padrão em Cascata]
  Prompt ──> Modelo Leve ──> Rascunho Inicial ──> Modelo Juiz ──[Aceitar]──> Saída de Código Final
                                                    └──[Encaminhar]──> Modelo Mais Forte ──> Saída Final

[Padrão por Crítica]
  Prompt ──> Modelo Gerador ──> Rascunho Inicial ──┬─> Modelo Revisor A ──┐
                                                 └─> Modelo Revisor B ──┴─> Agregador de Feedback ──> Revisão Final
Essas topologias de execução introduzem distinções comerciais entre velocidade de execução, rigor de verificação e custo computacional. Em vez de codificar rigidamente os prompts para padrões específicos, o GitHub mapeia esses fluxos de trabalho em níveis de esforço selecionáveis:
- Fusion Standard: Equilibra custo, qualidade e latência para a codificação do dia a dia. A implementação atual normalmente seleciona um modelo por tarefa.
- Fusion High: Prioriza capacidade superior e raciocínio mais profundo para tarefas de codificação substanciais, considerando a eficiência de tokens. A orquestração de vários modelos pode ser usada quando necessário.
- Fusion Max: Prioriza a capacidade de nível de fronteira para as tarefas mais exigentes, com etapas adicionais de revisão ou escalonamento selecionadas dinamicamente onde forem úteis.
- Fusion Fast: Um nível de esforço especializado e não selecionável pelo usuário, utilizado em cenários de chat em linha do Visual Studio Code sensíveis à latência compatíveis.
O gerenciamento dos limites de contexto em fluxos de trabalho dinâmicos requer um tratamento de memória especializado. O Copilot Fusion não possui uma janela de contexto unificada própria. Em vez disso, cada etapa de execução opera estritamente dentro dos limites de contexto do modelo específico que executa essa subtarefa. A capacidade de contexto exibida na IDE reflete o limite mais conservador entre os modelos participantes. Além disso, para maximizar a eficiência do cache de prompts, o Fusion retém o tópico de conversação principal em um único modelo principal sempre que possível, passando apenas as janelas de contexto necessárias e isoladas para os modelos revisores auxiliares.
Governança Corporativa e Integração de Modelos Locais em Frotas de Desenvolvedores
A implementação da orquestração autônoma de modelos em grandes organizações de engenharia corporativa introduz considerações de governança, conformidade e orçamento. Quando um sistema de IA seleciona dinamicamente entre modelos da Anthropic, OpenAI e outros provedores, os administradores devem garantir que a residência de dados organizacionais e as regras de segurança permaneçam intactas.
Os administradores corporativos podem gerenciar os modelos elegíveis para o Copilot Fusion por meio de políticas de modelos suportadas do GitHub Copilot e configurações gerenciadas pela empresa, conforme documentado no manual administrativo do Copilot Fusion. Os administradores podem visualizar a lista de modelos disponíveis para o Fusion, definir níveis de esforço padrão para assentos de desenvolvedores e desativar modelos específicos para o Fusion sem desativá-los em toda a empresa. O Fusion respeita as restrições aplicáveis de assinatura, organização, residência de dados, conformidade com FedRAMP e modelos de avaliação. Esses controles regem a elegibilidade de modelos dentro do sistema, mas não substituem os processos próprios de revisão de conformidade, governança de dados ou validação de segurança da organização.
A tabela abaixo descreve como diferentes arquiteturas de execução equilibram superfícies de execução, mecanismos de revisão e perfis de gastos com tokens:
| Padrão de Execução | Invocação Principal | Mecanismo de Revisão | Perfil de Custo de Tokens | Ideal Para |
|---|---|---|---|---|
| Modo Simples (Single) | Um modelo dedicado | Nenhum | Preços padrão de modelo base | Edições de código simples e dúvidas de sintaxe |
| Modo Cascata (Cascade) | Modelo de rascunho eficiente | Inspeção do modelo juiz e escalonamento | Baixo a moderado (escalonamento condicional) | Correções de bugs bem delimitadas e modificações estruturadas |
| Modo Crítica (Critique) | Gerador principal | Modelos revisores independentes em paralelo | Mais alto (várias chamadas simultâneas de modelo) | Lógica arquitetural complexa e código sensível à segurança |
| Híbrido com Modelo Local | Modelo local no dispositivo compatível | Seleção de modelos coordenada pela nuvem | Consumo reduzido de tokens em nuvem em etapas locais | Inferência elegível no dispositivo com roteamento coordenado pela nuvem |
O GitHub introduziu o roteamento compatível com modelos locais como uma visualização experimental opcional, conforme anunciado no Changelog do GitHub sobre seleção de modelos locais. Com um modelo local compatível configurado, o Copilot Fusion Standard pode selecionar a inferência no dispositivo para tarefas elegíveis, reduzindo o uso de modelos em nuvem nessas etapas. Em sistemas Windows com hardware compatível, os desenvolvedores podem instalar e executar o MAI Code 1.1 Flash por meio do gerenciamento do Windows ML no aplicativo Copilot, Copilot CLI ou Visual Studio Code. Usuários multiplataforma no Windows, macOS e Linux podem configurar modelos locais como o Qwen3.8 Flash Next no Copilot CLI usando provedores de modelos locais como o Ollama, inicializando a CLI com a flag --experimental.
No entanto, o Copilot Fusion ainda depende de decisões de roteamento baseadas na nuvem, e as tarefas podem usar modelos de nuvem quando apropriado. O suporte a modelos locais, portanto, não torna o Copilot Fusion um ambiente de codificação totalmente offline; os desenvolvedores que exigem segurança em ambiente isolado (air-gapped) devem avaliar ferramentas dedicadas offline.
Checklist de Engenharia: Adoção da Orquestração Multi-Modelo em Produção
A integração da orquestração de tempo de execução multi-modelo nos fluxos de trabalho de desenvolvimento de software requer ajustes nos hábitos dos desenvolvedores, configurações de IDE e operações financeiras corporativas. A liderança de engenharia deve estabelecer protocolos operacionais claros para capitalizar as eficiências de tokens, evitando armadilhas no fluxo de trabalho.
Checklist de Implementação para Desenvolvedores
- Inspecionar Diffs do Workspace Antes de Commits: Descartar um rascunho de IA não reverte automaticamente as modificações de arquivos do workspace; os desenvolvedores devem revisar todas as edições de arquivos não confirmadas antes de enviar o código.
- Adequar Níveis de Esforço à Complexidade da Tarefa: Reserve o Fusion Max para lógica algorítmica complexa e auditoria de segurança, utilizando o Fusion Standard para a codificação diária para evitar o consumo desnecessário de créditos de IA.
- Auditar Progresso de Fluxos Multi-Modelo: Observe os indicadores de progresso da IDE para inspecionar quais modelos específicos contribuem para os blocos de código gerados, garantindo transparência nas etapas de execução.
- Configurar Modelos Locais Compatíveis: Para tarefas elegíveis no Fusion Standard, configure modelos locais compatíveis, como o MAI Code 1.1 Flash no Windows ou o Qwen3.8 Flash Next via Ollama, habilitando configurações experimentais quando necessário.
Checklist de Governança Corporativa e FinOps
- Configurar Políticas de Modelos Corporativos: Especifique quais modelos são elegíveis para o roteamento do Fusion no painel corporativo, alinhando a lista de modelos aos requisitos de conformidade corporativa e residência de dados.
- Auditar Créditos de IA Baseados em Uso: Acompanhe o consumo de créditos em nível de equipe entre os níveis de esforço, contabilizando o fato de que a execução de vários modelos no Fusion High e Max pode consumir mais créditos por tarefa do que as execuções de modelo único.
- Considerar Janelas de Faturamento Promocional: Fatore o desconto promocional de 30% do GitHub nos custos de modelos para assinantes pagos do Copilot até 30 de novembro de 2026, ao realizar benchmarks de despesas operacionais.
- Estabelecer Etapas de Revisão Humana de Código: Mantenha revisões de código por pares obrigatórias para todas as pull requests geradas por agentes, garantindo que os ciclos automatizados de crítica complementem, em vez de substituir, a supervisão da engenharia humana.
Perguntas Frequentes (FAQ)
Como o GitHub calcula o faturamento quando o Copilot Fusion chama vários modelos?
O que acontece se o Copilot Fusion descartar um rascunho de código intermediário?
Os administradores corporativos podem restringir quais modelos o Copilot Fusion seleciona?
Principais Conclusões para Equipes de Engenharia
O lançamento do GitHub Copilot Fusion confirma que depender de um modelo de IA único e monolítico para tarefas complexas de engenharia de software introduz concessões operacionais desnecessárias. Os fluxos de trabalho de desenvolvimento modernos abrangem diversas demandas cognitivas, que vão desde a conclusão instantânea de sintaxe até raciocínios complexos entre repositórios. Forçar uma arquitetura de modelo única a lidar com todo esse espectro pode levar a gastos crescentes com modelos ou a uma qualidade de execução comprometida.
Resultados de benchmarks independentes sugerem que a orquestração de vários modelos pode entregar desempenho de codificação competitivo a custos de modelos mais baixos para certas cargas de trabalho. Os resultados reais dependerão da complexidade da tarefa, do comportamento de orquestração, dos modelos selecionados e dos padrões de uso da organização. Ao desacoplar a delegação de tarefas das escolhas manuais do desenvolvedor, a orquestração de modelos em tempo de execução estabelece um caminho operacional pragmático. À medida que as organizações de engenharia de software escalam agentes de codificação automatizados, o principal diferencial competitivo não será o acesso a qualquer modelo fundamental individual, mas a governança, a confiabilidade e o rigor arquitetural da camada de orquestração que os conecta.
Referências
-
GitHub: Route and Orchestrate Models with GitHub Copilot Fusion — Notas de lançamento oficiais e visão geral dos recursos do GitHub Universe 2026.
-
GitHub: Copilot Fusion Now Supports Selection of Local Models — Anúncio oficial detalhando a inferência no dispositivo para tarefas elegíveis com roteamento de modelo local.
-
Documentação do GitHub: Sobre os Conceitos e Configuração do GitHub Copilot Fusion — Documentação técnica oficial detalhando padrões de execução, níveis de esforço e regras de faturamento.
-
Documentação do GitHub: Configurando Modelos Disponíveis para o Copilot Fusion — Orientação administrativa para gerenciamento de políticas de modelos corporativos e configurações padrão.
-
Artificial Analysis: Avaliação de Benchmark do GitHub Copilot Fusion — Análise independente medindo custos de tarefas, eficiência de tokens e pontuações do Coding Agent Index.
-
The New Stack: GitHub Debuts Copilot Fusion Multi-Model System — Relatório técnico sobre a integração do Project HydraFusion e a implementação de clientes corporativos.
-
VentureBeat: GitHub Copilot Fusion Mixes Models for Cost Efficiency — Entrevista técnica com a liderança de produtos do GitHub cobrindo arquiteturas de roteamento em tempo de execução.
Share this article



