Anthropic Sonnet 5.5 стала на 30% быстрее? Компания Anthropic официально выпустила Claude Sonnet 5.5, в которой заявлено повышение скорости генерации вывода более чем на 30% и снижение стоимости выполнения одной задачи до 30%. Поскольку платформы на базе генеративного искусственного интеллекта переходят от экспериментальных прототипов к высокопроизводительным рабочим системам, команды разработчиков сталкиваются с растущей необходимостью контролировать потребление токенов и задержки исполнения. Ранее архитекторы корпоративных систем полагались на то, что для получения высочайшего качества написания кода требуется использование самых мощных и дорогих моделей. Сегодня, благодаря тому что оптимизированные модели среднего уровня способны решать сложные инженерные задачи за меньшее количество шагов и вызовов инструментов, фундаментальная экономика инструментов автоматизации разработки смещается в сторону эффективности исполнения.
Производственная экономика: почему стоимость решения задачи важнее цены токена
Краткий обзор
- Anthropic выпустила Claude Sonnet 5.5 28 сентября 2026 года, обеспечив увеличение скорости генерации вывода более чем на 30% и снижение стоимости выполнения одной задачи до 30%.
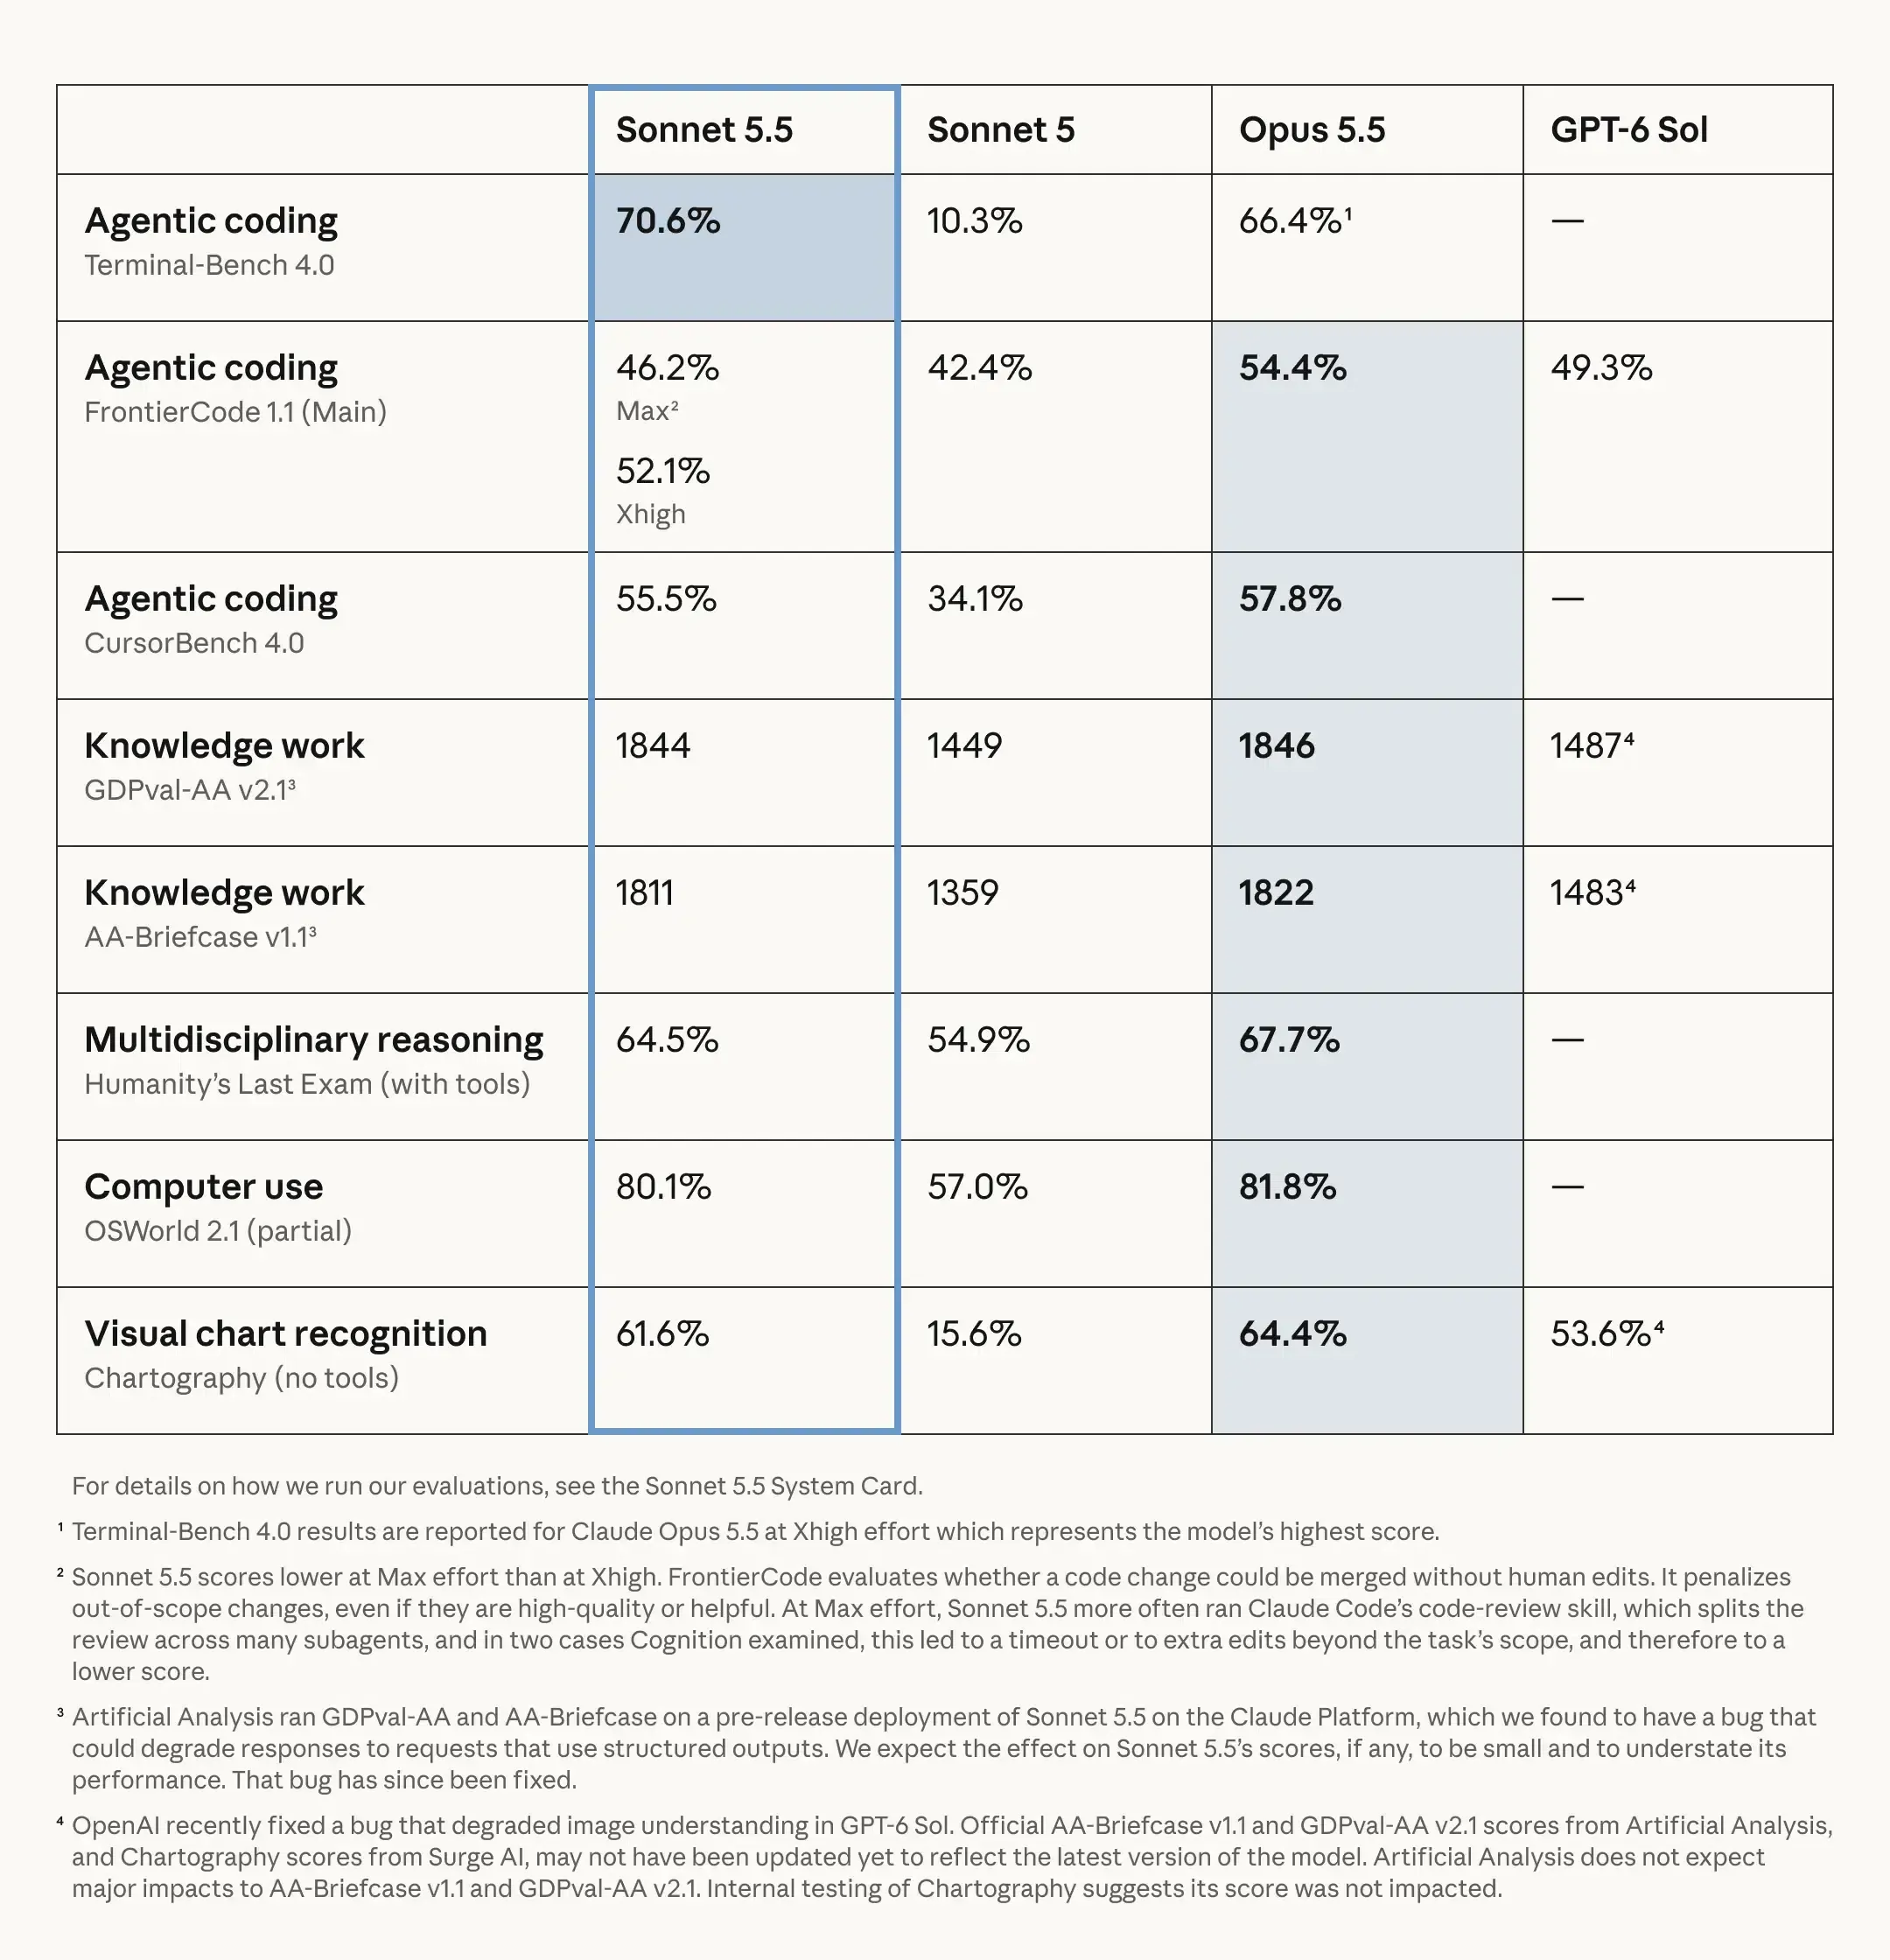
- В тестировании кодинга на базе агентов Terminal-Bench 4.0 модель Sonnet 5.5 показала результат 70,6%, превзойдя флагманскую модель Claude Opus 5.5 (66,4%) и Sonnet 5 (10,3%).
- Цены на токены API остаются неизменными: $2 за миллион входных токенов и $10 за миллион выходных токенов, а снижение затрат достигается за счет меньшего количества шагов исполнения и пакетных вызовов инструментов.
Коммерческая целесообразность развертывания автономных программных агентов ранее сталкивалась с серьезными экономическими ограничениями. Использование многошаговых инструментов разработчика, которые анализируют кодовые базы, выполняют команды оболочки и итеративно исправляют модульные тесты, потребляет огромное количество токенов. Хотя передовые модели демонстрируют впечатляющую глубину рассуждений, их высокая стоимость токенов и значительные задержки генерации делают непрерывное автономное выполнение дорогостоящим для масштабируемых ИТ-компаний.
При оценке инфраструктуры разработки заявленная цена API часто скрывает истинную стоимость выполнения работы. Модель с низкой ценой за токен, которая циклически выполняет десятки повторяющихся вызовов инструментов и исправлений, в конечном итоге обходится значительно дороже, чем модель, решающая задачи за меньшее количество шагов. Эта динамика подробно рассматривается в отраслевых отчетах о Sonnet 5.5, где подчеркивается, как стоимость выполнения задачи отвязывается от номинальной стоимости токенов.
Anthropic спроектировала Claude Sonnet 5.5 так, чтобы напрямую устранить эти эксплуатационные узкие места. Сохраняя базовые тарифы API на уровне $2 за миллион входных токенов и $10 за миллион выходных, модель достигает до 30% снижения чистых затрат на выполнение задач, требуя значительно меньше этапов логического вывода. Опубликованные отчеты клиентов Anthropic подчеркивают заметный прирост эффективности в рабочих процессах:
- Box сообщила, что Sonnet 5.5 работала в 2,4 раза быстрее, используя на 12% меньше токенов при перепроверке исходных документов и выявлении регрессий кода.
- Zendesk отметила, что заявки в службу поддержки обрабатывались на 20% быстрее с меньшим количеством ошибок в автоматизированных решениях по сравнению с существующими производственными моделями.
- Slack продемонстрировала, что модель превзошла Sonnet 5 при оценке ботов в автономном режиме без изменения промптов, потребляя примерно на 14% меньше выходных токенов.
- Lovable обнаружила, что Sonnet 5.5 требовала примерно на треть меньше вызовов инструментов и вдвое меньше выполнений команд оболочки во время автоматизированных сборок приложений.
- Base44 подтвердила, что модель завершала полные сборки приложений в среднем за 3,6 итерации по сравнению с 7,7 итерациями у Opus 5.
Эти результаты иллюстрируют, как эффективность исполнения фундаментально влияет на продуктивность разработчиков. Сокращая количество неудачных вызовов инструментов и устраняя избыточные итерации, модели среднего уровня создают устойчивую основу для непрерывной автоматизации на уровне предприятия.
Технический анализ: бенчмарки кодинга и масштабирование субагентов
Появление моделей среднего уровня, превосходящих флагманы по определенным техническим бенчмаркам, отражает сдвиг в методологии обучения моделей. Ранние законы масштабирования предполагали, что количество параметров является главным фактором интеллекта модели. Однако сложные агентные задачи — такие как навигация в терминальной среде и редактирование крупных репозиториев — критически зависят от управления контекстом, дисциплины использования инструментов и контроля области видимости.
Флагманские модели, такие как Opus 5.5, обладают огромным потенциалом рассуждения, преуспевая в решении сложных, неоднозначных архитектурных задач. Тем не менее, чрезмерная глубина рассуждений может создавать излишнюю нагрузку при выполнении четко определенных задач. Например, в тестах FrontierCode компания Anthropic отметила, что Sonnet 5.5 при настройке Max effort набрала меньше баллов, чем при Xhigh, так как чаще обращалась к навыку проверки кода Claude Code. Это приводило к распределению проверок между несколькими субагентами, что в ряде случаев вызывало таймауты или выход за рамки редактирования, штрафуемый системой бенчмаркинга. В то же время Sonnet 5.5 при стандартных настройках идеально подходит для выполнения ограниченных и четко очерченных задач: она быстро анализирует структуру репозитория, оценивает предложенные изменения и работает строго в заданных границах файлов.
Паритет бенчмарков: Terminal-Bench, CursorBench и GDPval-AA
Опубликованные Anthropic оценки показывают, что Sonnet 5.5 сравнивается с топовыми моделями или превосходит их в повседневных технических задачах. В Terminal-Bench 4.0, оценивающем многошаговое решение задач в командной строке, Sonnet 5.5 набрала 70,6%, обойдя Opus 5.5 (66,4%) и Sonnet 5 (10,3%). В CursorBench 4.0, основанном на реальных сессиях разработчиков в Cursor, Sonnet 5.5 достигла 55,5%, лишь немного уступив Opus 5.5 (57,8%). Кроме того, в тесте GDPval-AA v2.1, охватывающем реальные профессиональные задачи по 44 направлениям, Sonnet 5.5 получила рейтинг Elo 1844, практически сравнявшись с результатом Opus 5.5 (1846).
Чтобы понять, как оптимизированные модели повышают автономность исполнения, рассмотрим различия в рабочих процессах:
[Монолитный флагманский агентный цикл]
  Промпт пользователя ──> Тяжелая цепь рассуждений ──> Множество вызовов инструментов (высокий расход токенов) ──> Риск чрезмерного редактирования и таймаутов

[Оптимизированный агентный цикл среднего уровня]
  Промпт пользователя ──> Определение намерений ──> Пакетные вызовы инструментов ──> Меньше шагов исполнения ──> Краткое и точное исправление
Этот оптимизированный цикл исполнения сокращает вероятность смещения контекста и лишних сетевых запросов. Anthropic сообщает о более чем 30%-ном ускорении генерации вывода и сокращении количества шагов по сравнению с Sonnet 5. Модель группирует вызовы инструментов, минимизируя сетевые задержки между средой выполнения агента и хост-системами.
Sonnet 5.5 также внедряет инфраструктуру безопасности первого уровня в категорию моделей среднего звена. Это первый вариант Sonnet, оснащенный средствами защиты, аналогичными Opus 5.5. Задачи с высоким риском обнаружения уязвимостей автоматически перенаправляются на более ранние архитектуры, а авторизованные специалисты получают многоуровневые права доступа через программу кибер-верификации. Система также включает классификаторы безопасности, предназначенные для предотвращения масштабного извлечения логики и сохранения конфиденциальности данных внутри учетной записи.
Архитектурная стратегия: распределение нагрузки между передовыми и средними моделями
Поскольку базовые модели ИИ разделяются на механизмы глубокого рассуждения и модели оперативной реализации, инженерным руководителям необходимо переосмыслить распределение моделей на разных этапах жизненного цикла разработки ПО. Использование одной флагманской модели во всем конвейере разработки вносит избыточные задержки и затраты. Вместо этого современная инфраструктура все чаще опирается на динамическую маршрутизацию моделей, назначая их исходя из структурной сложности задач.
При проектировании рабочих процессов команды должны взвешивать компромисс между глубоким концептуальным мышлением и высокоскоростным решением задач. Флагманские модели остаются незаменимыми для архитектурного планирования, однако модели среднего уровня справляются с большинством повседневных задач написания кода с превосходной оперативностью.
Следующая матрица решений описывает техническое соответствие по уровням моделей:
| Категория рабочей нагрузки | Основная модель | Стоимость | Задержка | Оптимально для |
|---|---|---|---|---|
| Обычные исправления багов и проверка PR | Claude Sonnet 5.5 | Низкая ($2 / $10 за 1 млн токенов) | Быстрая (на 30%+ быстрее) | Повседневные задачи и CI/CD проверки |
| Архитектура кодовой базы и миграции | Claude Opus 5.5 | Высокая ($4 / $20 за 1 млн токенов) | Адаптивные циклы глубокого мышления | Сложный, неоднозначный рефакторинг |
| Интерактивное прототипирование и UI | Claude Sonnet 5.5 | Низкая ($2 / $10 за 1 млн токенов) | Быстрая, отзывчивая итерация | Проектирование флоу и верстка фронтенда |
| Продвинутые исследования безопасности | Claude с верифицированным доступом | Зависит от модели и уровня доступа | Многошаговая тщательная верификация | Авторизованные исследования по программам безопасности |
Anthropic структурирует возможности кибербезопасности с помощью многоуровневых мер защиты. В то время как повседневное устранение уязвимостей выполняется в штатном режиме на Sonnet 5.5, более рискованные задачи автоматически передаются на более ранние архитектуры. Для авторизованных экспертов, проводящих сложные исследования, доступ к расширенным возможностям Sonnet 5.5, Opus 5.5 и моделей Mythos регулируется через программу кибер-верификации.
Устанавливая правила динамической маршрутизации, инженерные организации могут перенаправлять рутинные ревью PR, генерацию тестов и локализацию ошибок на Sonnet 5.5. Это позволяет сохранить мощности уровня Opus для высокосложного архитектурного рефакторинга, обеспечивая предсказуемость бюджетов без ущерба для надежности кода.
Интеграционные чек-листы: внедрение Sonnet 5.5 в CI/CD
При внедрении высокопроизводительных и экономичных моделей вроде Sonnet 5.5 в производственные конвейеры команды должны выстраивать строгие принципы управления. Максимизация экономии требует согласования параметров API со сложностью задач и предотвращения бесконтрольного «агентского дрейфа».
Чек-лист для разработчиков
- Настройка уровней усилий (Effort Levels): Используйте нативные настройки модели — по умолчанию «Medium» в приложениях Claude и «High» в платформе — чтобы сбалансировать глубину рассуждений и расход токенов.
- Использование кеширования промптов (Prompt Caching): Применяйте кеширование для статических системных промптов и карт репозиториев, чтобы получить скидку 90% на токены чтения ($0,20 за миллион токенов).
- Развертывание пакетной обработки: Маршрутизируйте некритичные по времени оценки, аудиты кода и миграции через пакетные API, чтобы добиться 50% скидки на стандартные затраты.
- Интеграция систем защиты: Установите программные прерыватели, которые автоматически завершают или перенаправляют запросы, если циклы инструментов превышают заданные лимиты итераций.
Чек-лист для инфраструктуры
- Переоценка экономики подписки: Рассчитайте маржинальные затраты на вычисления на одного активного разработчика, чтобы определить, позволяют ли высокоскоростные модели предлагать более высокие квоты использования.
- Мониторинг коэффициентов итераций: Отслеживайте среднее количество вызовов инструментов для решения задач; сокращение итераций напрямую повышает удовлетворенность разработчиков.
- Настройка обработки данных: Для регулируемых корпоративных клиентов с требованиями локализации данных настраивайте эндпоинты с обработкой только в США (доступно при 1,1x тарификации).
- Верификация политики удержания данных: Подтвердите статус отсутствия удержания данных (zero data retention) с поставщиком API для соответствия корпоративным стандартам, учитывая, что специализированные функции (например, кеширование промптов) могут иметь свои условия.
Используя этот структурированный подход, инженерные организации могут преобразовать алгоритмическую скорость и эффективность в стабильный рост производительности разработки.
Часто задаваемые вопросы (FAQ)
Почему Sonnet 5.5 стоит меньше за задачу, если цена за токен такая же, как у Sonnet 5?
Может ли Claude Sonnet 5.5 заменить Opus 5.5 в инженерных задачах?
Как кеширование промптов влияет на расходы в агентских сценариях?
Ключевые выводы для инженерных команд
Релиз Claude Sonnet 5.5 отражает эволюцию отрасли от неограниченного наращивания параметров к операционной эффективности. Высокопроизводительным платформам разработки не всегда требуются вычислительные мощности флагманских моделей на каждом этапе. Когда модель среднего уровня надежно решает задачи по кодингу за меньшее количество итераций, автоматизация разработки становится значительно выгоднее при массовом внедрении.
Использование этих преимуществ требует дисциплинированной архитектуры: динамической маршрутизации задач, строгого соблюдения границ использования инструментов и систематического кеширования промптов. Поскольку разработчики моделей продолжают оптимизировать токеновую эффективность наряду с базовыми навыками рассуждения, инженерные команды, проектирующие модульные конвейеры с контролем затрат, сохранят наиболее устойчивые и масштабируемые рабочие процессы.
Ссылки
-
Anthropic. Представляем Claude Sonnet 5.5.
-
Anthropic. Claude Sonnet 5.5: Системная карта.
-
Anthropic. Ценообразование и локализация данных Claude API.
-
Anthropic. Коммерческие условия предоставления услуг и политика хранения данных.
-
VentureBeat. Anthropic запускает Claude Sonnet 5.5 со снижением затрат на 30%.
-
TechCrunch. Anthropic выпускает Sonnet 5.5 как более быстрый и дешевый инструмент для работы.
-
9to5Mac. Обновление Claude от Anthropic: новая модель Sonnet 5.5.
Share this article



